Apéndice. Estructura geométrica de la probabilidad y de la inferencia en el modelo de regresión
Índice
- 1. El espacio de las variables aleatorias
- 2. Copias idénticas e independientes: la moneda
- 3. La matriz de copias: filas, columnas y vectores de \(\mathbb R^n\)
- 4. Los dos espacios y el puente entre ellos
- 5. En \(\mathbb R^n\): dos subespacios, una base y tres triángulos
- 6. Evaluar sobre la muestra aleatoria
- 7. La familia ortogonal y lo que da sin normalidad
- 8. Qué añade la normalidad: de ortogonal a independiente
- 9. La \(t\)
- 10. La \(F\)
- 11. Las piezas y dónde opera cada una
- 12. Mapa de las lecciones
- 13. Notación
Alcance. Este documento es la columna vertebral formal de las lecciones 9 a 14 del curso: reúne, con demostraciones, lo que esas lecciones enuncian y leen. De la probabilidad toma solo lo que el curso usa, y lo construye desde un único ingrediente, el producto escalar \(\langle X,Y\rangle_P=\mathrm E(XY)\) de la lección 9: la esperanza y la esperanza condicional como proyecciones, la probabilidad como esperanza de la indicadora, la independencia como ortogonalidad, y la existencia de copias idénticas e independientes; no trata la aditividad numerable, las distribuciones ni los teoremas límite. De la inferencia trata la del modelo de regresión lineal: insesgadez, varianza y varianza mínima de los coeficientes, la insesgadez de \(\mathfrak s^2\), y las distribuciones \(t_{n-k}\) y \(F_{q,n-k}\) de los contrastes, con el intervalo de confianza y el valor \(p\). Todo descansa en una regla que se mantiene de principio a fin: \(\mathbb R^n\), donde viven los datos, y el espacio de las variables aleatorias, donde viven los estimadores, son dos espacios distintos, y lo único que los comunica es evaluar una fórmula de datos sobre la muestra. Las secciones 1 a 4 preparan los dos espacios y el puente; la 5 es álgebra de \(\mathbb R^n\); la 6 evalúa; las 7 a 10 obtienen los resultados, primero sin normalidad y después con ella; las 11 a 13 recogen las piezas, el mapa de las lecciones y la notación. Lo que se admite sin demostrar se dice cada vez, y se lista al final de la sección 11.
1. El espacio de las variables aleatorias
1.1. Funciones sobre \(\Omega\)
Una variable aleatoria es una función definida sobre un conjunto \(\Omega\) de sucesos elementales (lección 9): a cada \(\omega\) le asigna un número. Es la misma noción de función del curso de matemáticas, con otro dominio: allí el dominio era un intervalo de la recta real y aquí es \(\Omega\). En el ejemplo de la sección 2, \(\Omega\) será de hecho un intervalo, \([0,1]\), de modo que las variables aleatorias se dibujan como las funciones de siempre; pero nada de lo que sigue depende de ello. Las operaciones entre variables aleatorias se hacen punto a punto: \(X+Y\) es la función que en \(\omega\) vale \(X(\omega)+Y(\omega)\), \(XY\) la que vale \(X(\omega)Y(\omega)\), y una igualdad \(X=Y\) entre variables aleatorias significa \(X(\omega)=Y(\omega)\) para todo \(\omega\). La constante \(\mathit1\) es la función que vale \(1\) en todo \(\Omega\), y \(\mathit0\) la que vale \(0\).
Lo que convierte ese conjunto de funciones en un espacio con geometría es el producto escalar de la lección 9, \[ \langle X,Y\rangle_P=\mathrm E(XY), \] del que en todo este documento solo se usan sus propiedades: es bilineal, simétrico y positivo (\(\langle X,X\rangle_P\ge0\)), y \(\Vert\mathit1\Vert_P=1\). No hace falta saber cómo se calcula; con esas propiedades, las demostraciones de la lección 3 (Pitágoras, Cauchy–Schwarz, proyección sobre un subespacio) valen palabra por palabra, y de ellas se sirve el curso. La única diferencia con \(\mathbb R^n\) es que la positividad no es estricta: \(\Vert X\Vert_P=0\) no obliga a que \(X\) sea la función \(\mathit0\), sino solo a que lo sea salvo en un conjunto de probabilidad cero (``casi seguro'', lección 9). El espacio es semieuclídeo, y eso no estorba a ninguno de los argumentos que siguen.1
1.2. La esperanza: las dos caras
La recta de las constantes, \(\mathcal L(\mathit1)\), es un subespacio de dimensión uno, y proyectar sobre ella es lo mismo que en \(\mathbb R^n\) proyectar sobre \(\mathcal L(\boldsymbol 1)\) para obtener el vector de medias. La proyección de \(X\) sobre \(\mathcal L(\mathit1)\) es \(\langle X,\mathit1\rangle_P\,\mathit1\) (porque \(\Vert\mathit1\Vert_P=1\)). Son las dos caras de la esperanza de la lección 9: el número \(\mathrm E(X)=\langle X,\mathit1\rangle_P\), el valor esperado, es el escalar por el que hay que multiplicar \(\mathit1\) para acercarse a \(X\) cuanto permite la recta de las constantes; y la variable aleatoria constante \(\mathrm E(X)\,\mathit1\) es la proyección misma. La diferencia \(X-\mathrm E(X)\,\mathit1\) es la variable centrada, ortogonal a \(\mathit1\), y Pitágoras da \(\Vert X\Vert_P^2=\mathrm E(X)^2+\Vert X-\mathrm E(X)\,\mathit1\Vert_P^2\): la varianza es la longitud al cuadrado de la parte centrada.
1.3. Condicionar es proyectar
Las funciones de una variable aleatoria \(X\) (todas las \(f(X)\)) forman un subespacio que contiene a \(\mathcal L(\mathit1)\), porque las constantes son funciones de \(X\); con varias variables, el subespacio de sus funciones es mayor aún. La esperanza condicional \(E[Y\mid X]\) es la proyección de \(Y\) sobre ese subespacio (lección 9), y como toda proyección queda caracterizada por la ortogonalidad del resto:
\begin{equation}\label{eq:cond} E[Y\mid X]\ \text{es función de }X,\qquad\text{y}\qquad \big\langle Y-E[Y\mid X],\,h(X)\big\rangle_P=0\ \text{ para toda función }h . \end{equation}Que esa proyección exista se admite, como lo admite el curso: el subespacio no tiene dimensión finita, y la lección 3 solo construyó proyecciones sobre subespacios con base finita. En el otro extremo, condicionar a nada es proyectar sobre \(\mathcal L(\mathit1)\), y la esperanza condicional es la constante \(\mathrm E(Y)\,\mathit1\). En todos los casos la esperanza condicional es una variable aleatoria, no un número; el número aparece solo al proyectar sobre las constantes.
De \eqref{eq:cond} y de las propiedades del producto escalar salen las tres reglas que el curso usa desde la lección 11, y que allí se enuncian:
- Linealidad. \(E[aY+bZ\mid X]=a\,E[Y\mid X]+b\,E[Z\mid X]\): la proyección es lineal (lección 3).
- Lo que es función de \(X\) sale fuera (el Lema de la lección 11): \(E[g(X)\,Z\mid X]=g(X)\,E[Z\mid X]\). Hay que comprobar que \(g(X)\,E[Z\mid X]\) cumple \eqref{eq:cond} para \(g(X)Z\). Es función de \(X\); y el resto, \(g(X)Z-g(X)E[Z\mid X]=g(X)\big(Z-E[Z\mid X]\big)\), es ortogonal a toda \(h(X)\), porque \[ \big\langle g(X)\big(Z-E[Z\mid X]\big),\,h(X)\big\rangle_P=\big\langle Z-E[Z\mid X],\,g(X)h(X)\big\rangle_P=0 , \] al ser \(g(X)h(X)\) una función de \(X\). Como la proyección es única (salvo casi seguro, que es la unicidad que un espacio semieuclídeo permite), es esa.
- Esperanzas iteradas. \(\mathrm E\big(E[Y\mid X]\big)=\mathrm E(Y)\). Es proyectar en dos pasos sobre subespacios anidados, \(\mathcal L(\mathit1)\subset\{\text{funciones de }X\}\): como \(\mathit1\) es función de \(X\), \eqref{eq:cond} da \(\langle Y-E[Y\mid X],\mathit1\rangle_P=0\), es decir, \(\langle Y,\mathit1\rangle_P=\langle E[Y\mid X],\mathit1\rangle_P\). La proyección de \(Y\) sobre la recta de las constantes se obtiene proyectando primero sobre las funciones de \(X\) y después sobre la recta. Es la misma figura del Pitágoras anidado de la lección 13, con la recta de las constantes en el papel del subespacio restringido.
La varianza condicional es la longitud al cuadrado del resto, medida con la esperanza condicional: \(Var[Y\mid X]=E\big[(Y-E[Y\mid X])^2\mid X\big]\), una variable aleatoria. Y Pitágoras en el triángulo que la lección 9 dibuja, de vértices \(Y\), \(E[Y\mid X]\) y \(\mathrm E(Y)\,\mathit1\), da la descomposición de la varianza: la hipotenusa \(Y-\mathrm E(Y)\,\mathit1\) se parte en los catetos \(Y-E[Y\mid X]\) y \(E[Y\mid X]-\mathrm E(Y)\,\mathit1\), ortogonales por \eqref{eq:cond} (el segundo es función de \(X\)), luego \[ \mathrm{Var}(Y)=\mathrm E\big(Var[Y\mid X]\big)+\mathrm{Var}\big(E[Y\mid X]\big), \] donde el primer sumando es \(\Vert Y-E[Y\mid X]\Vert_P^2\) escrito con esperanzas iteradas.
1.4. La probabilidad: la esperanza de la indicadora
Un suceso es un subconjunto \(A\) de \(\Omega\), y su indicadora \(\mathbb 1_A\) es la variable aleatoria que vale \(1\) en los \(\omega\) de \(A\) y \(0\) fuera. Como cualquier variable aleatoria, es un vector del espacio, y tiene esperanza. Esa esperanza es la probabilidad del suceso: \[ \mathrm P(A)=\mathrm E(\mathbb 1_A)=\langle\mathbb 1_A,\mathit1\rangle_P . \] Es una definición, y de ella y de las propiedades del producto escalar salen las propiedades de la probabilidad que suelen presentarse como axiomas. Todo descansa en identidades entre indicadoras que se comprueban \(\omega\) a \(\omega\): \(\mathbb 1_A\mathbb 1_A=\mathbb 1_A\), \(\mathbb 1_A\mathbb 1_B=\mathbb 1_{A\cap B}\), \(\mathbb 1_{A^c}=\mathit1-\mathbb 1_A\), y \(\mathbb 1_{A\cup B}=\mathbb 1_A+\mathbb 1_B\) cuando \(A\) y \(B\) son disjuntos.
- No negativa, y es una longitud. Como \(\mathbb 1_A\mathbb 1_A=\mathbb 1_A\), \(\Vert\mathbb 1_A\Vert_P^2=\langle\mathbb 1_A,\mathbb 1_A\rangle_P=\langle\mathbb 1_A,\mathit1\rangle_P=\mathrm P(A)\). La probabilidad de un suceso es la longitud al cuadrado de su indicadora, y por tanto \(\mathrm P(A)\ge0\).
- El total vale uno. \(\mathbb 1_\Omega=\mathit1\) y \(\mathrm P(\Omega)=\Vert\mathit1\Vert_P^2=1\).
- Aditiva. Si \(A\) y \(B\) son disjuntos, \(\mathrm P(A\cup B)=\langle\mathbb 1_A+\mathbb 1_B,\mathit1\rangle_P=\mathrm P(A)+\mathrm P(B)\), por linealidad.2
- Complementario y monotonía. \(\mathrm P(A^c)=\langle\mathit1-\mathbb 1_A,\mathit1\rangle_P=1-\mathrm P(A)\); y si \(A\subset B\), \(\mathbb 1_B-\mathbb 1_A\) es la indicadora de \(B\setminus A\), luego \(\mathrm P(B)-\mathrm P(A)\ge0\).
- Intersección. \(\mathrm P(A\cap B)=\langle\mathbb 1_{A\cap B},\mathit1\rangle_P=\langle\mathbb 1_A\mathbb 1_B,\mathit1\rangle_P=\langle\mathbb 1_A,\mathbb 1_B\rangle_P\): la probabilidad de la intersección es el producto escalar de las dos indicadoras.
- Probabilidad cero. \(\mathrm P(A)=0\) es \(\Vert\mathbb 1_A\Vert_P=0\) sin que \(\mathbb 1_A\) sea \(\mathit0\): es el ``casi seguro'' de la lección 9, y la razón de que el espacio sea semieuclídeo.
Condicionar una probabilidad es lo mismo hecho con la indicadora: \(P[A\mid X]=E[\mathbb 1_A\mid X]\), la proyección de \(\mathbb 1_A\) sobre las funciones de \(X\), su ``sombra'' (lección 12). Es una variable aleatoria, no un número; el número \(\mathrm P(A)\) se recupera por esperanzas iteradas. Y hereda de la linealidad las reglas de una probabilidad: para sucesos disjuntos, \(P[A\cup B\mid X]=P[A\mid X]+P[B\mid X]\); y \(P[\Omega\mid X]=E[\mathit1\mid X]=\mathit1\), porque \(\mathit1\) ya es función de \(X\) y su proyección es ella misma. Es lo que la lección 12 usa para hablar de la distribución de una perturbación condicionada a los regresores: una sombra por cada suceso \(\{U_i\le u\}\).
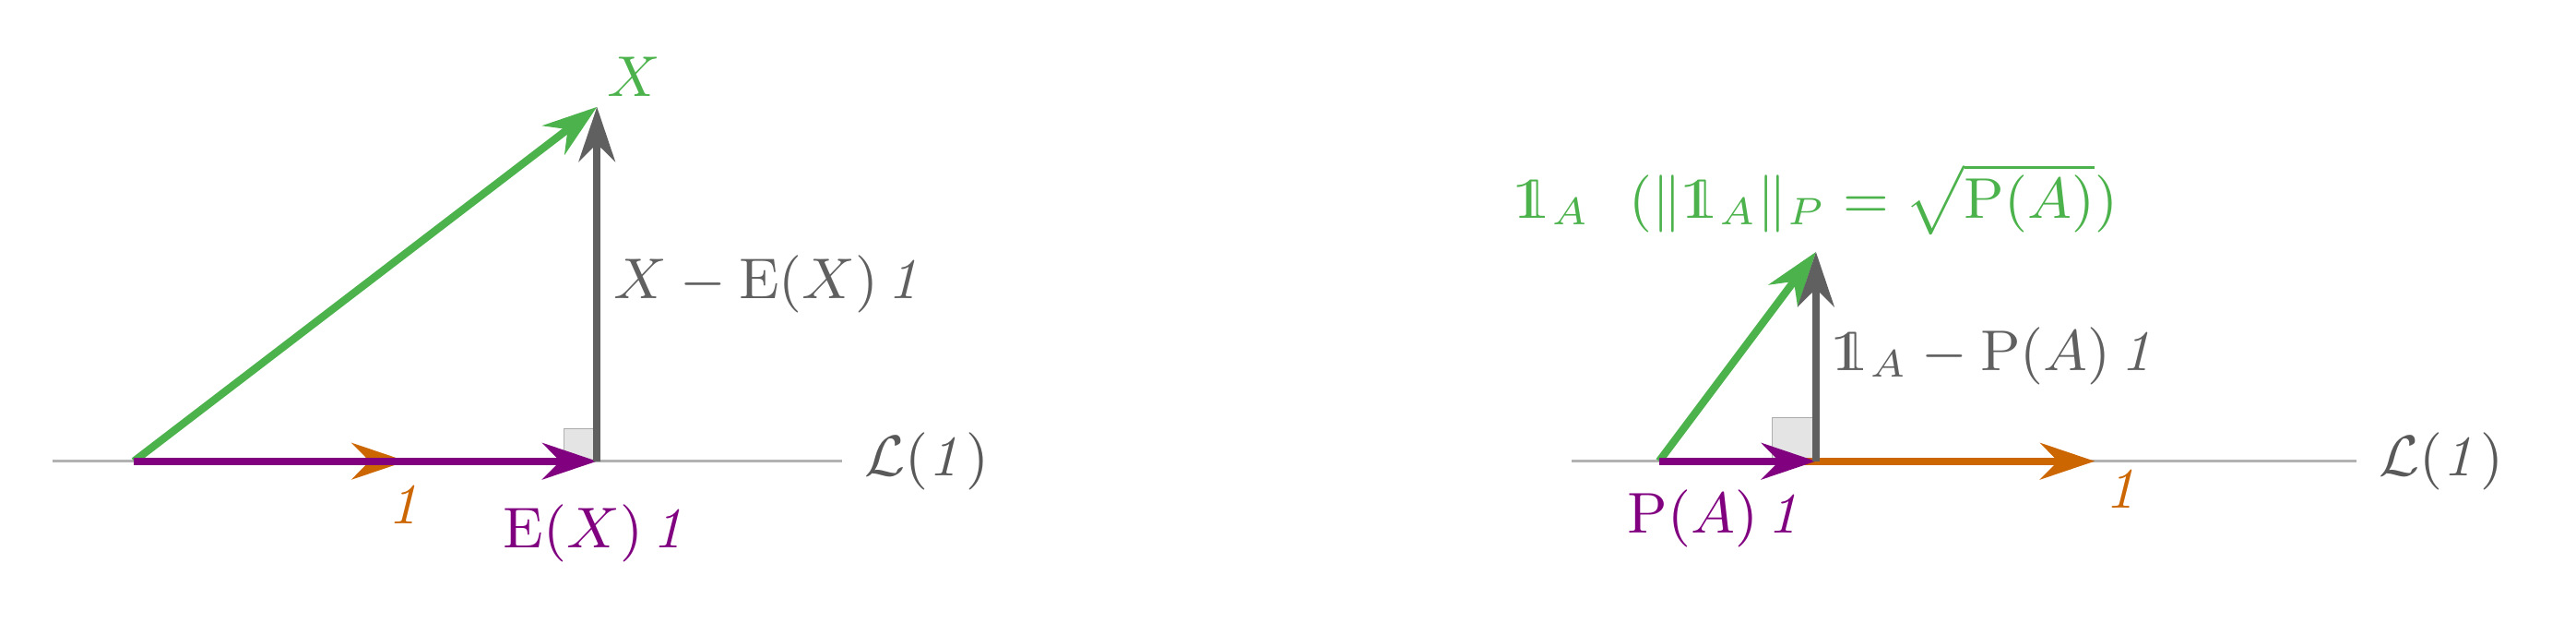
Figura 1: Las dos caras de la esperanza y la probabilidad como proyección, con las variables aleatorias dibujadas como vectores. Izquierda: la proyección de \(X\) sobre la recta de las constantes es \(\mathrm E(X)\,\mathit1\); el número \(\mathrm E(X)\) es el escalar por el que se multiplica \(\mathit1\); la parte centrada \(X-\mathrm E(X)\,\mathit1\) es ortogonal a \(\mathit1\) y su longitud es la desviación típica. Derecha: lo mismo para una indicadora: su proyección es \(\mathrm P(A)\,\mathit1\) y su longitud es \(\sqrt{\mathrm P(A)}\). Un dibujo así no dice dónde vale qué la función; dice cómo se sitúa respecto de las constantes, que es lo único que usa el argumento.
1.5. Independencia: sucesos, variables y escuadra
Dos sucesos son independientes cuando \(\mathrm P(A\cap B)=\mathrm P(A)\,\mathrm P(B)\). Con lo anterior, eso es \[ \langle\mathbb 1_A,\mathbb 1_B\rangle_P=\langle\mathbb 1_A,\mathit1\rangle_P\,\langle\mathbb 1_B,\mathit1\rangle_P , \] y desarrollando el producto escalar de las indicadoras centradas, \[ \big\langle\mathbb 1_A-\mathrm P(A)\,\mathit1,\;\mathbb 1_B-\mathrm P(B)\,\mathit1\big\rangle_P=\langle\mathbb 1_A,\mathbb 1_B\rangle_P-\mathrm P(A)\,\mathrm P(B), \] se obtiene la lectura geométrica: dos sucesos son independientes exactamente cuando sus indicadoras centradas son ortogonales.
De los sucesos a las variables aleatorias. Dos variables \(X\) e \(Y\) son independientes cuando lo son todos los sucesos \(\{X\in A\}\) y \(\{Y\in B\}\) que cada una define. Para una variable con un número finito de valores, las funciones \(f(X)\) son exactamente las combinaciones lineales de las indicadoras \(\mathbb 1_{\{X=a\}}\), así que ``todos los sucesos de \(X\) son independientes de todos los de \(Y\)'' equivale a ``toda función centrada de \(X\) es ortogonal a toda función de \(Y\)''. Es la caracterización que el curso usa (apéndice de la lección 11), y que para variables cualesquiera enunciamos sin demostrar:
Independencia como ortogonalidad. \(X\) e \(Y\) son independientes si y solo si \(\big\langle f(X)-\mathrm E\big(f(X)\big)\,\mathit1,\;g(Y)\big\rangle_P=0\) para todas las funciones \(f\) y \(g\).
Dicho con subespacios: las funciones de \(X\) forman un subespacio y las de \(Y\) otro; los dos contienen la recta \(\mathcal L(\mathit1)\), así que no pueden ser perpendiculares del todo; la independencia dice que, quitada esa recta común, lo que queda de cada uno es perpendicular a todo el otro. Los dos subespacios están a escuadra sobre la recta de las constantes. La ortogonalidad de \(X-\mathrm E(X)\,\mathit1\) e \(Y-\mathrm E(Y)\,\mathit1\) (covarianza nula, incorrelación) es solo una parte de esa condición, la de las funciones lineales; para variables con dos valores coincide con la independencia, y en general no. Y la noción se extiende a familias: una familia de variables aleatorias es independiente cuando, para cualquier partición de la familia en dos grupos, los subespacios de funciones de uno y otro están a escuadra; es decir, cuando cada variable centrada, y cada función centrada de cualquier grupo, es ortogonal a todas las funciones del grupo complementario.
Hay una tercera forma de decirlo, con proyecciones, y es la que usa la lección 12: \(U\) es independiente de \(X\) si y solo si toda función de \(U\) tiene sombra constante sobre las funciones de \(X\), \(E[f(U)\mid X]=\mathrm E\big(f(U)\big)\,\mathit1\) para toda \(f\). Es la escuadra dicha de otro modo. Si la parte centrada \(f(U)-\mathrm E(f(U))\,\mathit1\) es ortogonal a toda función de \(X\), entonces \(\mathrm E(f(U))\,\mathit1\), que es función de \(X\), cumple \eqref{eq:cond} para \(f(U)\) y es su proyección; y al revés, si la proyección es una constante \(c\,\mathit1\), el resto \(f(U)-c\,\mathit1\) es ortogonal a toda \(h(X)\), en particular a \(\mathit1\), lo que fuerza \(c=\mathrm E(f(U))\) y deja la parte centrada ortogonal a todas las funciones de \(X\). Con \(f\) la indicadora de \(\{u\le t\}\) se obtiene la lectura de la lección 12: la distribución condicionada de \(U\) no depende de \(X\), \(P[U\le t\mid X]=\mathrm P(U\le t)\,\mathit1\) para todo \(t\).
2. Copias idénticas e independientes: la moneda
La lección 9 dijo que interpretamos los \(n\) datos como la realización de \(n\) copias idénticas e independientes de una variable aleatoria, y la lección 11 lo convirtió en el marco de la muestra aleatoria. ¿Cabe en un mismo \(\Omega\) un número ilimitado de variables aleatorias con la misma distribución e independientes entre sí? La respuesta es sí, y se ve con la moneda.
2.1. El espacio \([0,1]\) y las monedas
Tomemos \(\Omega=[0,1]\). En este ejemplo el producto escalar es concreto: las variables aleatorias que manejaremos son constantes a trozos, y \(\langle X,Y\rangle_P\) es la suma, trozo a trozo, del producto de sus valores por la longitud del trozo. Cumple las propiedades de la sección 1.1 (bilineal, simétrico, positivo), y \(\Vert\mathit1\Vert_P=1\) porque el intervalo mide \(1\); con él, la definición de la sección 1.4 da \(\mathrm P(A)=\langle\mathbb 1_A,\mathit1\rangle_P=\) longitud de \(A\), por ejemplo \(\mathrm P([a,b])=b-a\). ``Probabilidad = longitud'' no es una segunda definición: es lo que la primera da en este espacio. La moneda que sale cara (\(1\)) o cruz (\(0\)) con la misma probabilidad es la función que vale \(0\) en la primera mitad del intervalo y \(1\) en la segunda; la segunda moneda divide cada mitad en dos y vuelve a alternar; la tercera hace lo mismo con los octavos; y así indefinidamente. Hay una manera de decirlo de una vez: escribiendo \(\omega\) en base dos, \(\omega=0{,}a_1a_2a_3\ldots\), la moneda \(n\)-ésima es la cifra \(n\)-ésima, \[ X_n(\omega)=a_n . \]
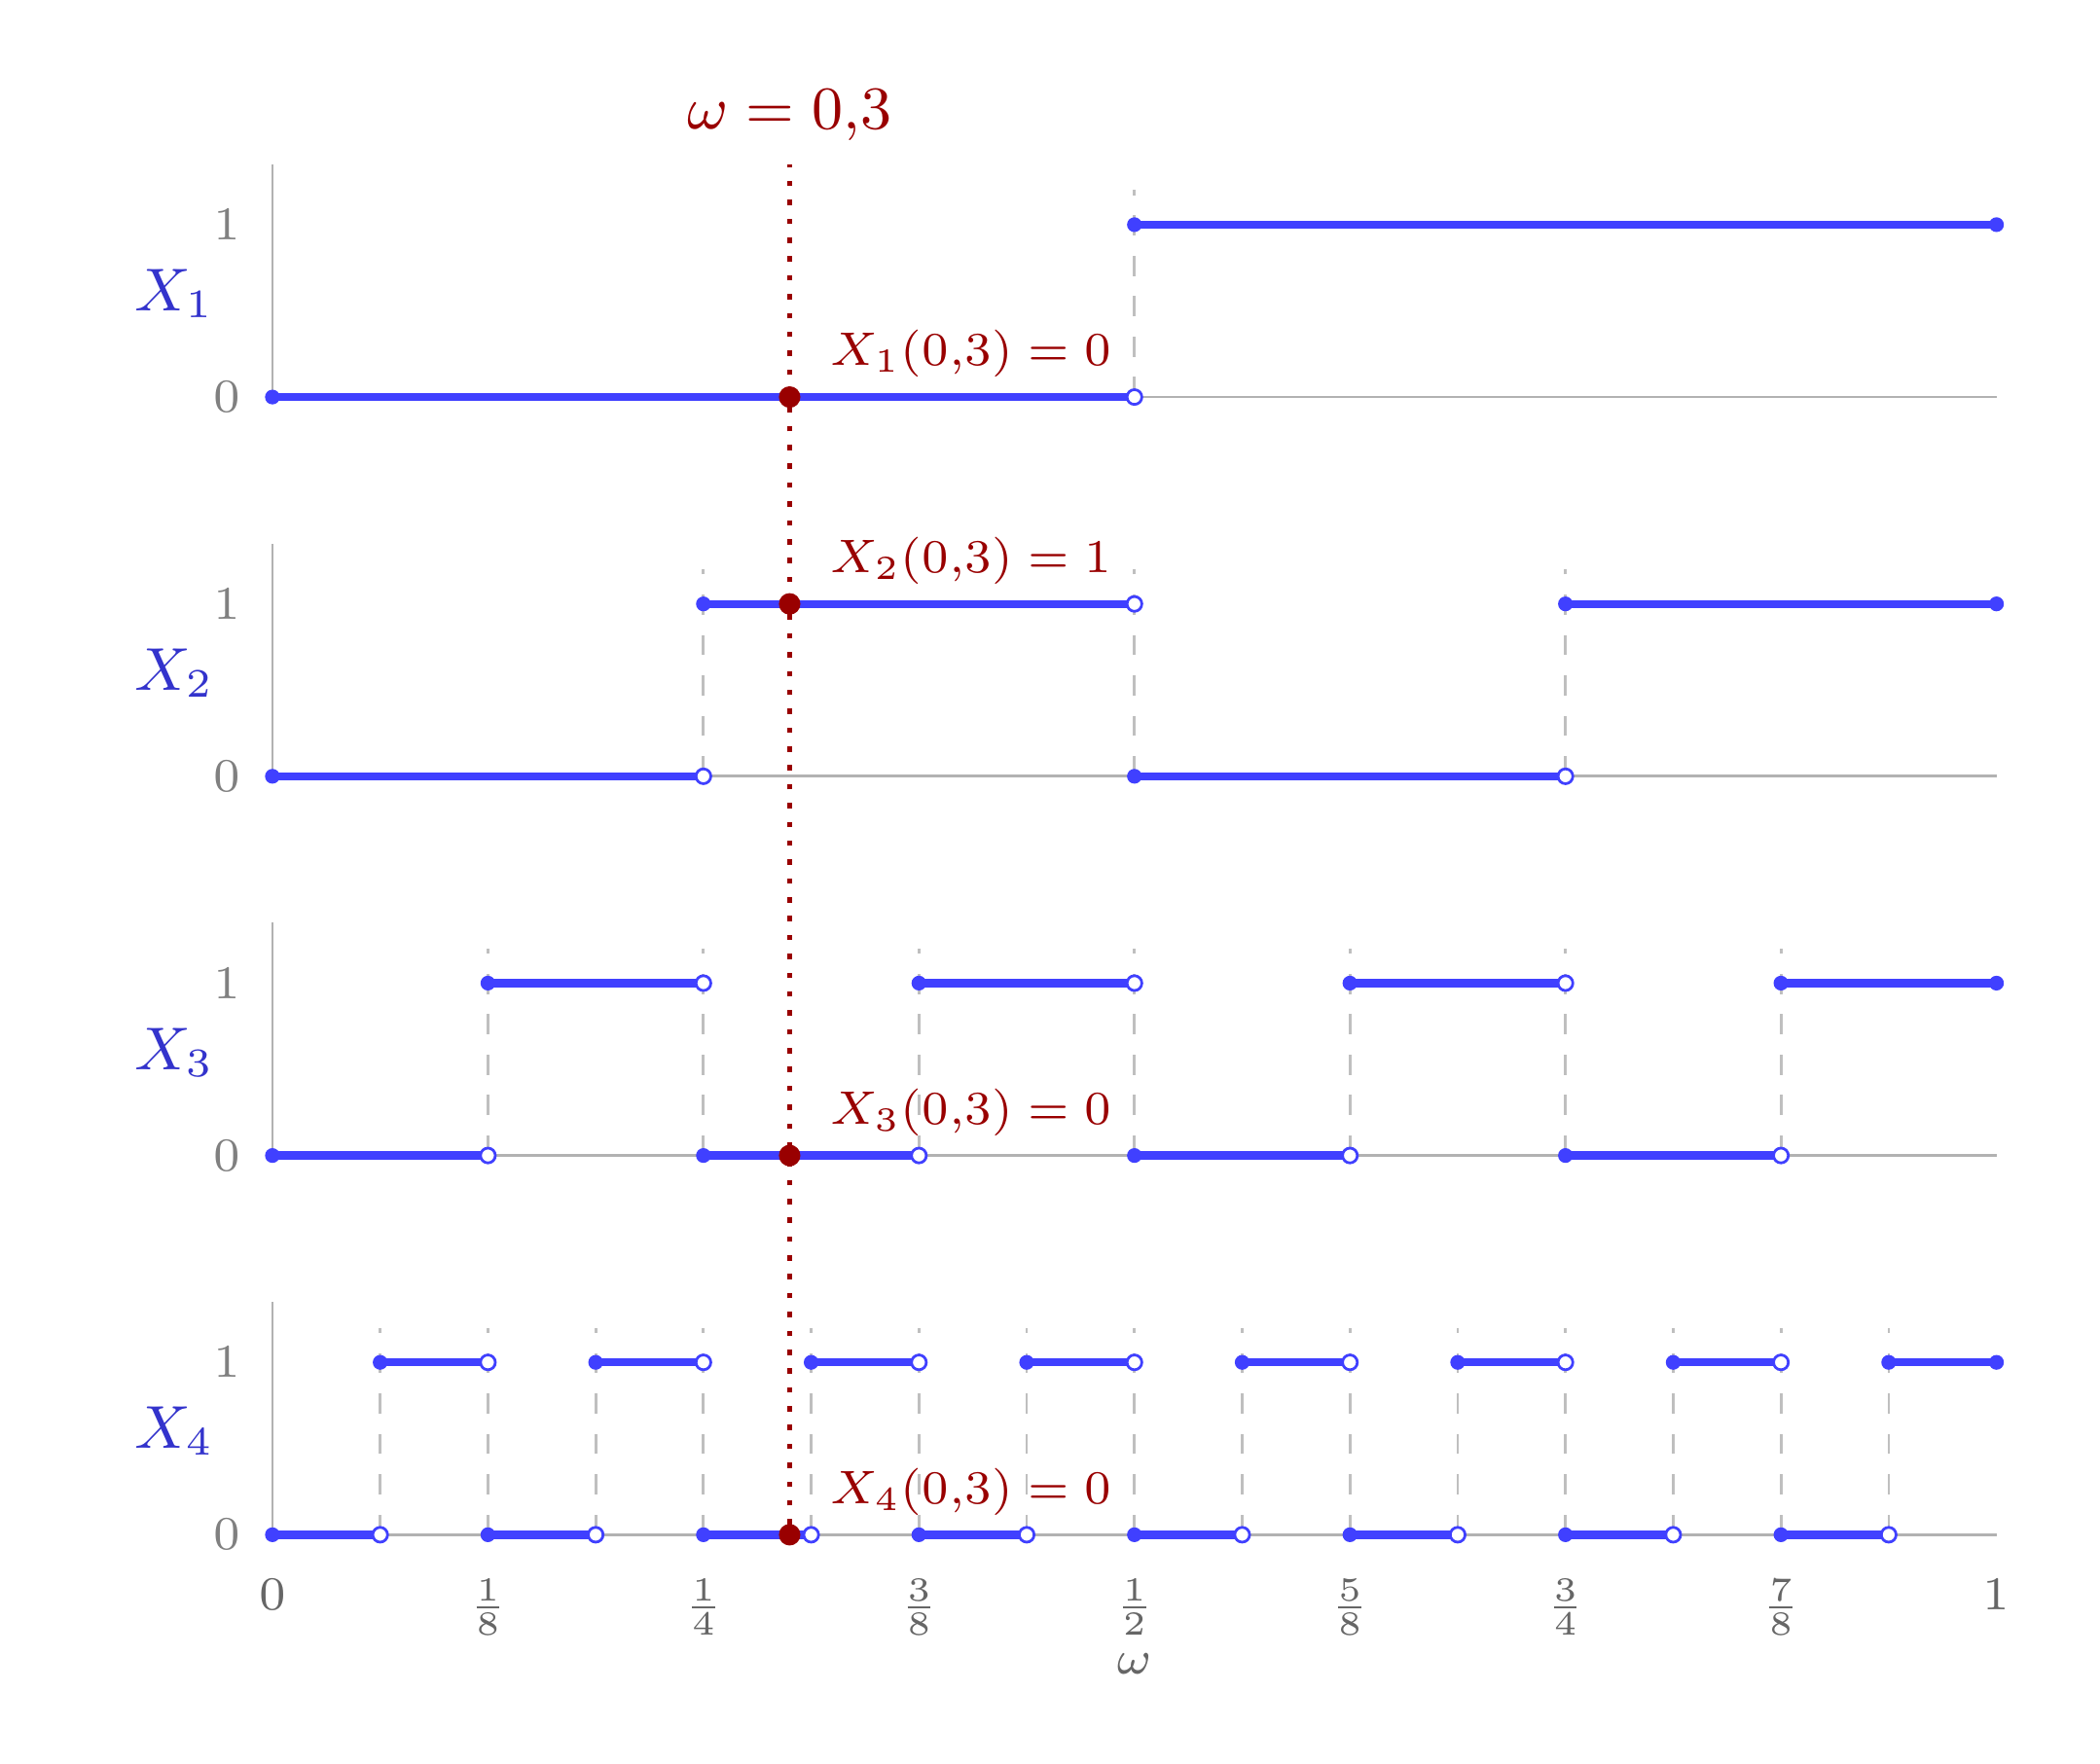
Figura 2: Las cuatro primeras monedas como funciones sobre \(\Omega=[0,1]\) (la figura del apéndice de la lección 11, con una moneda más). Cada una vale \(0\) en los intervalos impares de longitud \(2^{-n}\) y \(1\) en los pares. La línea de puntos es el suceso elemental \(\omega=0{,}3\), que en base dos empieza \(0{,}0100\ldots\): cruz, cara, cruz, cruz. Un \(\omega\) es una tirada infinita. Es la única figura del documento que dibuja dónde vale qué una variable aleatoria, y muestra por qué no se insiste en ello: cada fila es más apretada que la anterior, y pocas más abajo la función ya no se lee. Por eso las demás figuras dibujan las variables aleatorias como vectores.
Dos comprobaciones. Idéntica distribución: el suceso \(\{X_n=0\}\) es una unión de intervalos de longitud total \(\tfrac12\), para todo \(n\). Independencia de todas a la vez: fijados \(n\) resultados \((a_1,\ldots,a_n)\), el suceso \(\{X_1=a_1,\ldots,X_n=a_n\}\) es el conjunto de los \(\omega\) cuyas \(n\) primeras cifras son esas, un intervalo de longitud \(2^{-n}\), luego \(\mathrm P(X_1=a_1,\ldots,X_n=a_n)=2^{-n}=\mathrm P(X_1=a_1)\cdots\mathrm P(X_n=a_n)\). Y \(X_1\) y \(X_2\) no son la misma función: en \(\omega=0{,}3\) la primera vale \(0\) y la segunda \(1\). Dos copias independientes suelen asignar valores distintos al mismo suceso elemental.
En el lenguaje de la sección anterior: las monedas centradas, \(X_i-\tfrac12\mathit1\), son ortogonales dos a dos (el producto escalar se calcula intervalo a intervalo y da cero, porque dentro de cada intervalo donde \(X_i\) es constante, \(X_j\) vale \(0\) en una mitad y \(1\) en la otra); las funciones de \(X_i\) son el plano \(a\,\mathit1+b\,X_i\), y los planos de dos monedas distintas están a escuadra sobre la recta de las constantes. Para la independencia de todas a la vez hace falta más que la ortogonalidad dos a dos, y también se cumple: cada \(X_n\) centrada es ortogonal a todas las funciones de \((X_1,\ldots,X_{n-1})\), que son constantes en cada intervalo de longitud \(2^{-(n-1)}\). Que esa comprobación, cada moneda frente a las anteriores, baste para la independencia de la familia entera (con cualquier partición en dos grupos) es un hecho que se admite.
Leída al revés, la construcción dice algo más. Un \(\omega\) es una sucesión infinita de cifras binarias, es decir, el resultado de lanzar la moneda infinitas veces. Elegir un suceso elemental al azar en \([0,1]\) es lanzar la moneda sin parar. El espacio de sucesos que parecía demasiado pequeño para una muestra contiene todas las muestras posibles de todos los tamaños.
2.2. Más allá de la moneda
La construcción da mucho más, y lo enunciamos sin demostrar. Si \(F\) es la función de distribución de una variable cualquiera \(Y\) y \(U\) es uniforme en \([0,1]\), entonces \(F^{-1}(U)\) tiene la distribución de \(Y\). Y en \([0,1]\) hay infinitas uniformes independientes: basta repartir las cifras binarias de \(\omega\) en infinitas listas infinitas y leer cada lista como un número de \([0,1]\). Aplicando \(F^{-1}\) a cada uno se obtienen infinitas copias idénticas e independientes de \(Y\). Así que ``\(n\) copias idénticas e independientes de \(Y\)'' no es un supuesto sobre el mundo, sino una construcción: dado cualquier \(Y\), existe un \(\Omega\) en el que caben tantas copias como se quiera. Lo que sí es un supuesto es que nuestros datos sean una realización de esas copias: el muestreo aleatorio de la lección 11.3
3. La matriz de copias: filas, columnas y vectores de \(\mathbb R^n\)
La figura de las monedas admite una lectura que organiza todo lo que sigue. Imagínela prolongada hacia abajo indefinidamente, una fila por copia: \(X_1,X_2,X_3,\ldots\). Es una matriz con infinitas filas, una por variable aleatoria, y una columna por cada \(\omega\) de \(\Omega\). En esa matriz:
- Una muestra de tamaño \(n\) es elegir \(n\) filas. Cada fila es una variable aleatoria entera, una función sobre \(\Omega\); la lista \((X_1,\ldots,X_n)\) son \(n\) filas, y no es un vector de nada: es \(n\) funciones.
- Fijar un \(\omega\) es elegir una columna. La columna contiene el valor de todas las copias en ese suceso elemental: una tirada infinita de la moneda, un resultado completo del experimento.
- \(n\) filas y una columna a la vez dan un vector de \(\mathbb R^n\): \(\big(X_1(\omega),\ldots,X_n(\omega)\big)\), la realización de la muestra en \(\omega\). Ese es el único lugar donde una muestra se convierte en un punto de \(\mathbb R^n\), y por tanto el único lugar donde la geometría euclídea del curso se aplica a ella.
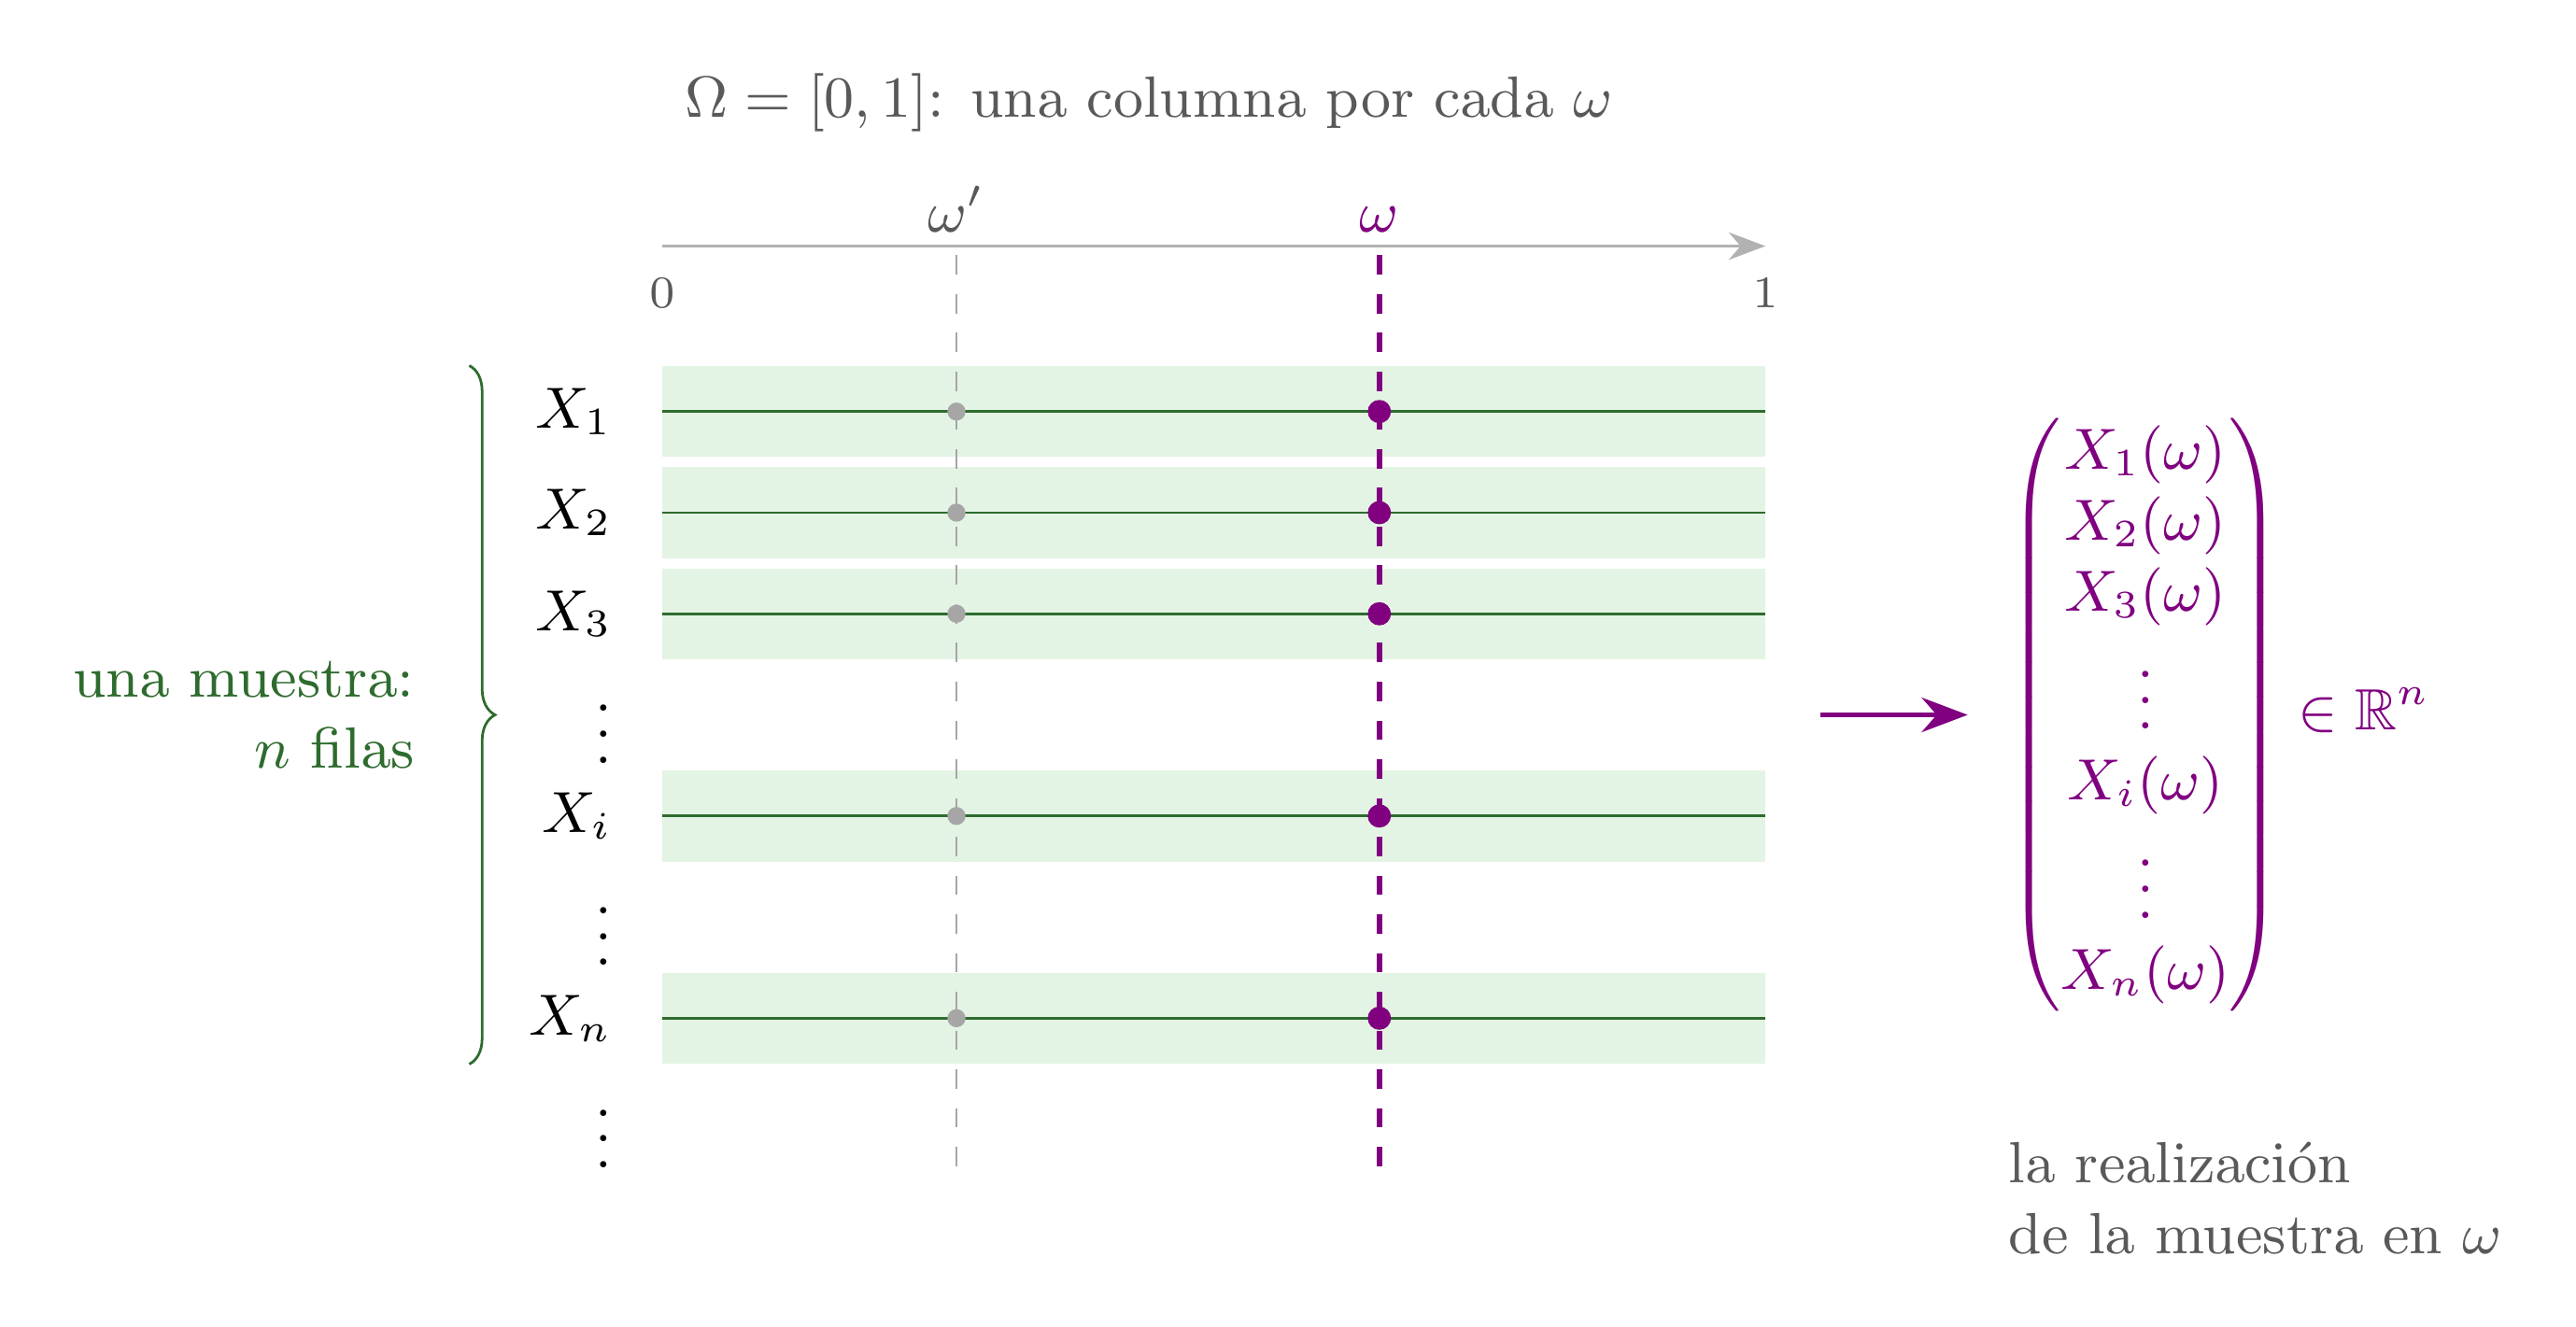
Figura 3: La matriz de copias. Cada fila es una copia de la variable, una función sobre \(\Omega\); la matriz continúa hacia abajo indefinidamente. Elegir \(n\) filas es tomar una muestra; elegir una columna es fijar un \(\omega\); las dos cosas a la vez dan el vector \(\big(X_1(\omega),\ldots,X_n(\omega)\big)\) de \(\mathbb R^n\). Los datos observados son una columna; una simulación Monte Carlo recorre otras columnas, \(\omega',\omega'',\ldots\), con las mismas filas.
Tres consecuencias. Primera: los datos observados son una columna, la que ocurrió; una tabla de Gretl es \(\big(X_1(\omega),\ldots,X_n(\omega)\big)\) para ese \(\omega\) y nada más. Segunda: una simulación Monte Carlo (prácticas de las sesiones 16, 21 y 22) es recorrer columnas con las mismas \(n\) filas: cada réplica es otro \(\omega\), y el histograma de un estadístico a lo largo de las réplicas es su distribución vista columna a columna. Tercera: en el modelo de regresión cada fila es una observación completa, \((Y_i,X_{i2},\ldots,X_{ik})\), copia de la variable vectorial que describe a un individuo (lección 11), y la columna \(\omega\) da la tabla de datos entera, con sus \(n\) filas y sus \(k\) columnas de variables.
4. Los dos espacios y el puente entre ellos
4.1. Regla del juego
Hay, pues, dos espacios con producto escalar, y nada de lo que se diga en uno se traslada al otro sin pasar por una fórmula evaluada.
- \(\mathbb R^n\), el espacio de los datos: vectores en negrita minúscula (\(\boldsymbol y\), \(\boldsymbol x_2\), \(\boldsymbol u\)), producto escalar euclídeo \(\langle\cdot,\cdot\rangle_e\), proyecciones, bases, Pitágoras (lecciones 2 a 10). Aquí viven los datos observados y, para cada \(\omega\), las columnas de la matriz de copias.
- El espacio de las variables aleatorias: funciones de \(\omega\) en mayúscula (\(Y_i\), \(U_i\), \(\hat\beta_2\)), producto escalar \(\langle Z,W\rangle_P=\mathrm E(ZW)\), norma \(\Vert Z\Vert_P\), ortogonalidad, proyecciones (esperanza condicional) (lección 9 y sección 1). Aquí viven las filas de la matriz, los estimadores y sus propiedades.
Los dos comparten el esquema geométrico de la lección 3, porque ambos tienen un producto escalar, pero son espacios distintos y aquí se mantienen separados a propósito. En particular, una lista de variables aleatorias, como \((U_1,\ldots,U_n)\), no es un vector de ninguno de los dos: no tiene producto escalar euclídeo (sus componentes no son números, son filas) ni es una variable aleatoria (es \(n\) de ellas). Lo único que se puede hacer con ella es (i) tomar una fórmula de \(\mathbb R^n\) y evaluarla sobre la lista, lo que da una variable aleatoria (lección 11), o (ii) mirar cada componente como un elemento del espacio de las variables aleatorias.
4.2. Los estadísticos
Lo primero da los estadísticos. Una operación con las componentes de un vector de datos, al sustituir esas componentes por las filas de una muestra, crea una variable aleatoria nueva: un estadístico (lección 11). Su distribución depende de la de las variables del muestreo, y se simplifica cuando son copias idénticas e independientes. Por ejemplo, la media muestral \(\overline X=\frac1n\sum_{i=1}^nX_i\): como la esperanza es lineal y todas las \(X_i\) tienen la misma esperanza \(\mu\), \(\mathrm E(\overline X)=\frac1n\,n\mu=\mu\), y la media muestral es un estimador insesgado. Por la misma linealidad, las variables centradas \(X_i-\overline X\) tienen esperanza cero. Pero esperanza cero no es ser la variable aleatoria cero: \(X_i-\overline X\) toma valores distintos de cero en sucesos de probabilidad positiva, y \(\mathrm E(X_i-\overline X)=0\) es una afirmación probabilística, no una identidad.
4.3. El puente
El puente entre los dos espacios es otra cosa, y conviene decir exactamente qué transfiere y qué no. Si una fórmula \(f(x_1,\ldots,x_n)=g(x_1,\ldots,x_n)\) es una identidad de \(\mathbb R^n\), es decir, se cumple para todas las listas de números, entonces para cada \(\omega\) la columna \(X_1(\omega),\ldots,X_n(\omega)\) es una de esas listas, y \(f(X_1(\omega),\ldots,X_n(\omega))=g(X_1(\omega),\ldots,X_n(\omega))\). Como ocurre para todo \(\omega\), los dos estadísticos \(f(X_1,\ldots,X_n)\) y \(g(X_1,\ldots,X_n)\) son la misma función de \(\omega\): una igualdad entre variables aleatorias, en todo punto. No interviene la probabilidad; es composición de funciones. Es lo que hace la lección 11 en ``Dos propiedades de los pesos'': \(\sum_{i=1}^nW_i=\mathit0\) y \(\sum_{i=1}^nW_iX_i=\mathit1\) son identidades algebraicas, válidas para cualquier elección de \(n\) números, y por eso siguen siendo ciertas al sustituir \(x_i\) por \(X_i\).
El ejemplo de la media muestral muestra la diferencia. Lo que es identidad de \(\mathbb R^n\) es \(\sum_{i=1}^n(x_i-\bar x)=0\) para toda lista; el puente da, por tanto, \(\sum_{i=1}^n(X_i-\overline X)=\mathit0\): la suma de las variables centradas es la variable aleatoria cero, en todo \(\omega\). El puente no dice, ni podría decir, que cada \(X_i-\overline X\) sea la variable cero, porque \(x_i-\bar x=0\) no es una identidad: falla para casi todas las listas. En este documento el puente se usa solo con identidades de \(\mathbb R^n\) enunciadas en la sección 5; todo lo probabilístico se obtiene después con el Lema de la lección 11 y la ley de las esperanzas iteradas.4
Dos convenciones tipográficas. Como en las lecciones, la esperanza no condicional se escribe en redonda, \(\mathrm E(\cdot)\), y la condicional en cursiva, \(E[\,\cdot\mid\boldsymbol X]\); ninguna de las dos se confunde con la letra caligráfica \(\mathcal E\) que nombra un subespacio. Y los índices se reparten así: \(i\) e \(i'\) para observaciones (\(1,\ldots,n\)), \(j\) y \(l\) para vectores de una base, \(m\) para el regresor cuyo coeficiente se contrasta; los demás regresores se nombran sin índice.
5. En \(\mathbb R^n\): dos subespacios, una base y tres triángulos
5.1. Los dos subespacios
\(\mathcal L(\boldsymbol 1)^\perp\) es el subespacio de los vectores de media cero, de dimensión \(n-1\) (lección 4). Dentro de él distinguimos dos subespacios complementarios:
\begin{equation}\label{eq:descomposicion} \mathcal L(\boldsymbol 1)^\perp=\mathcal E\oplus\mathcal R,\qquad \mathcal E\perp\mathcal R,\qquad \dim\mathcal E=k-1,\quad \dim\mathcal R=n-k . \end{equation}\(\mathcal E\) es el subespacio de los regresores en desviaciones, \(\mathcal L(\boldsymbol x_2-\boldsymbol{\mathop{\overline x}}_2,\ldots,\boldsymbol x_k-\boldsymbol{\mathop{\overline x}}_k)\), donde vive el cateto explicado (lección 13); \(\mathcal R\) es su complemento ortogonal dentro de \(\mathcal L(\boldsymbol 1)^\perp\), donde vive el residuo. Que \(\dim\mathcal E=k-1\) exige regresores linealmente independientes (supuesto 2 del modelo, lección 10). Las iniciales son las de \(\mathrm{SEC}\) y \(\mathrm{SRC}\).
5.2. Una base adaptada
Tomemos una base ortonormal \(\boldsymbol b_1,\ldots,\boldsymbol b_{n-1}\) de \(\mathcal L(\boldsymbol 1)^\perp\) adaptada a \eqref{eq:descomposicion}: los \(k-1\) primeros vectores en \(\mathcal E\) y los \(n-k\) restantes en \(\mathcal R\). Se construye por una regla fija a partir de los vectores de datos: los \(k-1\) primeros, ortogonalizando los regresores en desviaciones (práctica D de la sesión 14); los \(n-k\) restantes, completando hasta una base ortonormal de \(\mathcal L(\boldsymbol 1)^\perp\) con la misma operación aplicada, por ejemplo, a los vectores de la base canónica de \(\mathbb R^n\) que sigan siendo linealmente independientes de los anteriores. Lo que importa es que la regla sea fija: así cada componente \(b_{ji}\) es una fórmula de los regresores, que es lo que la sección 6 necesita. Que la base sea ortonormal y esté en \(\mathcal L(\boldsymbol 1)^\perp\) son tres identidades entre sus componentes:
\begin{equation}\label{eq:base} \Vert\boldsymbol b_j\Vert_e^2=\sum_{i=1}^nb_{ji}^2=1,\qquad \langle\boldsymbol b_j,\boldsymbol b_l\rangle_e=\sum_{i=1}^nb_{ji}b_{li}=0\ (j\neq l),\qquad \langle\boldsymbol b_j,\boldsymbol 1\rangle_e=\sum_{i=1}^nb_{ji}=0 . \end{equation}Las coordenadas de un vector \(\boldsymbol v\) de \(\mathcal L(\boldsymbol 1)^\perp\) en esa base son los números
\begin{equation}\label{eq:coord} c_j=\langle\boldsymbol v,\boldsymbol b_j\rangle_e=\sum_{i=1}^nb_{ji}\,v_i,\qquad j=1,\ldots,n-1, \end{equation}y Pitágoras generalizado dice
\begin{equation}\label{eq:pitagoras} \Vert\boldsymbol v\Vert_e^2=\sum_{j=1}^{n-1}\langle\boldsymbol v,\boldsymbol b_j\rangle_e^2=\sum_{j=1}^{n-1}c_j^2=\sum_{\mathcal E}c_j^2+\sum_{\mathcal R}c_j^2 , \end{equation}la longitud al cuadrado es la suma de los cuadrados de las proyecciones sobre los vectores de la base, donde \(\sum_{\mathcal E}\) abrevia la suma sobre los vectores de la base que están en \(\mathcal E\) (los índices \(j=1,\ldots,k-1\)) y \(\sum_{\mathcal R}\) la suma sobre los que están en \(\mathcal R\) (\(j=k,\ldots,n-1\)). Usaremos esa abreviatura en todo el documento: el número de sumandos de cada una es la dimensión del subespacio.
Hay un hecho de \(\mathbb R^n\) que se usará varias veces. Si un vector está en \(\mathcal E\), es combinación lineal de \(\boldsymbol b_1,\ldots,\boldsymbol b_{k-1}\), y su coordenada sobre cualquier \(\boldsymbol b_j\) de \(\mathcal R\) es
\begin{equation}\label{eq:coord-nula} \langle a_1\boldsymbol b_1+\cdots+a_{k-1}\boldsymbol b_{k-1},\boldsymbol b_j\rangle_e=a_1\langle\boldsymbol b_1,\boldsymbol b_j\rangle_e+\cdots+a_{k-1}\langle\boldsymbol b_{k-1},\boldsymbol b_j\rangle_e=0, \end{equation}por la segunda identidad de \eqref{eq:base}. Un vector de \(\mathcal E\) no tiene coordenadas en \(\mathcal R\), y recíprocamente. Y en una base ortonormal adaptada, proyectar sobre \(\mathcal E\) es quedarse con las coordenadas de \(\mathcal E\) y anular las de \(\mathcal R\) (lección 10).
5.3. Primer triángulo: el ajuste
Sea \(\boldsymbol y\) un vector de datos y su ajuste MCO sobre \(\boldsymbol 1,\boldsymbol x_2,\ldots,\boldsymbol x_k\), los mismos regresores con los que se ha construido la base. La lección 10 dio el triángulo: el vector de datos en desviaciones, \(\boldsymbol v=\boldsymbol y-\boldsymbol{\mathop{\overline y}}\), es la hipotenusa; el ajuste en desviaciones, \(\boldsymbol{\mathop{\widehat y}}-\boldsymbol{\mathop{\overline y}}\), es la proyección de \(\boldsymbol v\) sobre \(\mathcal E\) (porque \(\mathcal L(\boldsymbol 1,\boldsymbol x_2,\ldots,\boldsymbol x_k)=\mathcal L(\boldsymbol 1)\oplus\mathcal E\) con las dos partes ortogonales, y proyectar sobre la suma es proyectar sobre cada parte y sumar, lección 13); y el residuo, \(\boldsymbol{\mathop{\widehat e}}=\boldsymbol v-(\boldsymbol{\mathop{\widehat y}}-\boldsymbol{\mathop{\overline y}})\), es la componente de \(\boldsymbol v\) en \(\mathcal R\). Con las coordenadas \(c_j\) de \(\boldsymbol v\), las tres sumas de cuadrados de la lección 8 son las dos mitades de \eqref{eq:pitagoras} y su suma:
\begin{equation}\label{eq:sumas} \mathrm{STC}=\Vert\boldsymbol v\Vert_e^2=\sum_{\mathcal E}c_j^2+\sum_{\mathcal R}c_j^2,\qquad \mathrm{SEC}=\Vert\boldsymbol{\mathop{\widehat y}}-\boldsymbol{\mathop{\overline y}}\Vert_e^2=\sum_{\mathcal E}c_j^2,\qquad \mathrm{SRC}=\Vert\boldsymbol{\mathop{\widehat e}}\Vert_e^2=\sum_{\mathcal R}c_j^2 . \end{equation}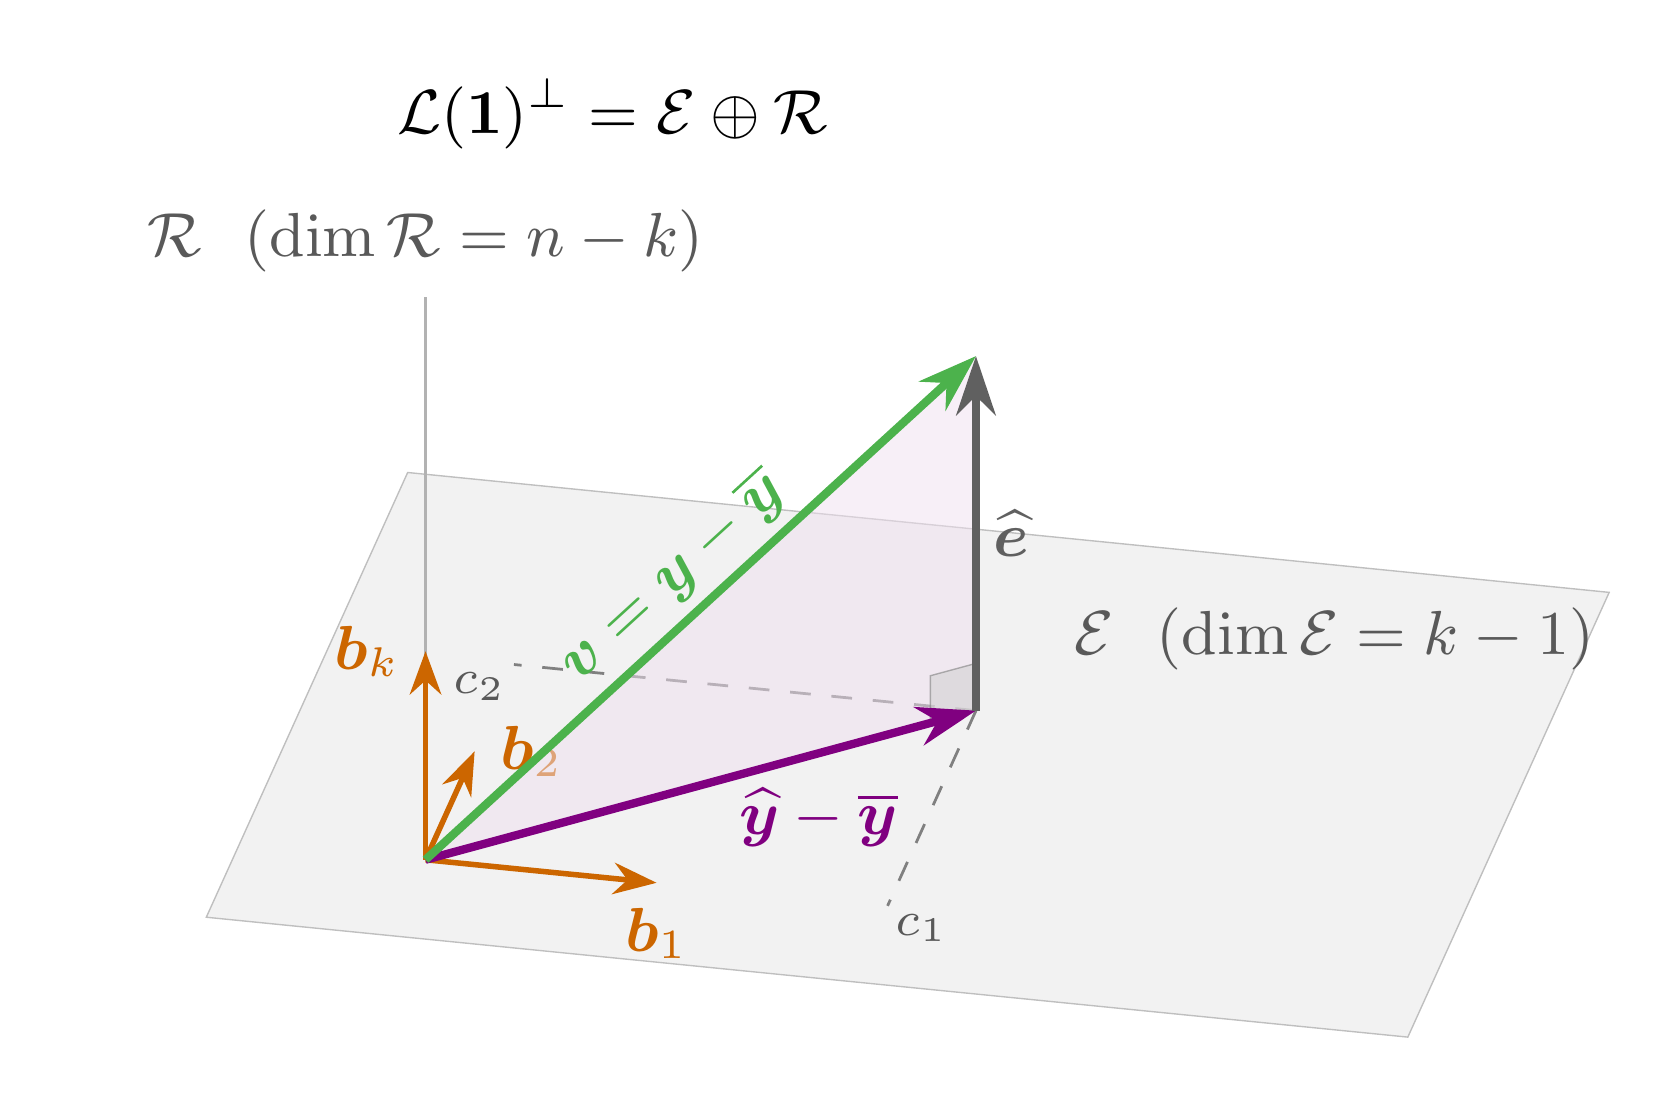
Figura 4: Los dos subespacios de \(\mathcal L(\boldsymbol 1)^\perp\), la base adaptada y el primer triángulo. El plano representa \(\mathcal E\) (de dimensión \(k-1\)) y la vertical \(\mathcal R\) (de dimensión \(n-k\)); \(\boldsymbol b_1,\boldsymbol b_2\) son vectores de la base en \(\mathcal E\) y \(\boldsymbol b_k\) en \(\mathcal R\). El vector de datos en desviaciones \(\boldsymbol v\), de longitud \(\Vert\boldsymbol v\Vert_e=\sqrt{\sum_{\mathcal E}c_j^2+\sum_{\mathcal R}c_j^2}\), se descompone en su proyección sobre \(\mathcal E\), el ajuste en desviaciones, de longitud \(\Vert\boldsymbol{\mathop{\widehat y}}-\boldsymbol{\mathop{\overline y}}\Vert_e=\sqrt{\sum_{\mathcal E}c_j^2}\), y su componente en \(\mathcal R\), el residuo, de longitud \(\Vert\boldsymbol{\mathop{\widehat e}}\Vert_e=\sqrt{\sum_{\mathcal R}c_j^2}\). Todo son vectores de datos: ninguna variable aleatoria.
5.4. Segundo triángulo: un coeficiente
Para el coeficiente del regresor \(m\) elegimos la base adaptada con una condición más: su primer vector apunta en la dirección de la parte propia \(\tilde{\boldsymbol x}_m\) (lección 14), el residuo de \(\boldsymbol x_m\) sobre \(\boldsymbol 1\) y los demás regresores, \[ \boldsymbol b_1=\frac{\tilde{\boldsymbol x}_m}{\Vert\tilde{\boldsymbol x}_m\Vert_e}\in\mathcal E , \] que está en \(\mathcal E\) (es combinación de los regresores en desviaciones) y es ortogonal a \(\boldsymbol 1\) y a cada uno de los demás regresores. Su longitud sale de Pitágoras en la regresión auxiliar: \(\boldsymbol x_m-\boldsymbol{\mathop{\overline x}}_m\) se parte en su proyección sobre los demás regresores en desviaciones y \(\tilde{\boldsymbol x}_m\), luego \(\Vert\tilde{\boldsymbol x}_m\Vert_e^2=\Vert\boldsymbol x_m-\boldsymbol{\mathop{\overline x}}_m\Vert_e^2\,(1-R_m^2)\), con \(R_m^2\) el \(R^2\) de esa regresión auxiliar; \(1/(1-R_m^2)\) es el factor de inflación de la varianza de la lección 14.
El coeficiente y la parte propia. Como \(\boldsymbol x_m\) es la suma de su proyección sobre \(\boldsymbol 1\) y los demás regresores y de \(\tilde{\boldsymbol x}_m\), el subespacio \(\mathcal L(\boldsymbol 1,\boldsymbol x_2,\ldots,\boldsymbol x_k)\) está generado también por \(\boldsymbol 1\), los demás regresores y \(\tilde{\boldsymbol x}_m\), y en esa familia \(\tilde{\boldsymbol x}_m\) es ortogonal a todos los otros generadores. Escribamos el ajuste como \(\boldsymbol{\mathop{\widehat y}}=c\,\tilde{\boldsymbol x}_m+\boldsymbol v\), con \(\boldsymbol v\) en el subespacio generado por \(\boldsymbol 1\) y los demás regresores. El residuo \(\boldsymbol y-\boldsymbol{\mathop{\widehat y}}\) es ortogonal a \(\tilde{\boldsymbol x}_m\) (lección 10), luego \(\langle\boldsymbol y,\tilde{\boldsymbol x}_m\rangle_e=c\,\Vert\tilde{\boldsymbol x}_m\Vert_e^2+\langle\boldsymbol v,\tilde{\boldsymbol x}_m\rangle_e=c\,\Vert\tilde{\boldsymbol x}_m\Vert_e^2\), y \(c=\langle\boldsymbol y,\tilde{\boldsymbol x}_m\rangle_e/\Vert\tilde{\boldsymbol x}_m\Vert_e^2\): el argumento de la familia ortogonal de la lección 10, aplicado al único generador que es ortogonal a los demás. Y \(c=\hat\beta_m\): en \(\boldsymbol{\mathop{\widehat y}}=\sum_i\hat\beta_i\boldsymbol x_i\), sustituir la descomposición de \(\boldsymbol x_m\) deja \(\hat\beta_m\tilde{\boldsymbol x}_m\) como único término en \(\tilde{\boldsymbol x}_m\) y el resto en el subespacio de los demás generadores; como las coordenadas respecto de una base son únicas, \(c=\hat\beta_m\). Es el teorema de Frisch–Waugh–Lovell: \(\hat\beta_m\) es el coeficiente de la regresión de \(\boldsymbol y\) sobre la parte propia de \(\boldsymbol x_m\), la fórmula de la lección 7 con \(\tilde{\boldsymbol x}_m\) en el papel del regresor en desviaciones. Los manuales lo demuestran con matrices; aquí ha bastado la familia ortogonal. Con el vector de pesos \(\boldsymbol w=\tilde{\boldsymbol x}_m/\Vert\tilde{\boldsymbol x}_m\Vert_e^2\), \(\hat\beta_m=\langle\boldsymbol w,\boldsymbol y\rangle_e\). Como \(\tilde{\boldsymbol x}_m=\Vert\tilde{\boldsymbol x}_m\Vert_e\,\boldsymbol b_1\),
\begin{equation}\label{eq:pesos} \boldsymbol w=\frac{\boldsymbol b_1}{\Vert\tilde{\boldsymbol x}_m\Vert_e},\qquad\text{luego}\qquad \hat\beta_m=\frac{\langle\boldsymbol b_1,\boldsymbol y\rangle_e}{\Vert\tilde{\boldsymbol x}_m\Vert_e} . \end{equation}El producto escalar \(\langle\boldsymbol b_1,\boldsymbol y\rangle_e\) se parece a la primera coordenada de \(\boldsymbol y\), pero \(\boldsymbol y\) no está en \(\mathcal L(\boldsymbol 1)^\perp\) y la base es de ese subespacio; la coordenada que hace falta es la del vector de datos en desviaciones, \(c_1=\langle\boldsymbol b_1,\boldsymbol y-\boldsymbol{\mathop{\overline y}}\rangle_e\). Las dos coinciden porque \(\boldsymbol b_1\) es ortogonal a \(\boldsymbol 1\) (tercera identidad de \eqref{eq:base}), así que la componente de \(\boldsymbol y\) en la dirección de \(\boldsymbol 1\), su media, no cuenta en el producto escalar con \(\boldsymbol b_1\) (lección 10): \[ \langle\boldsymbol b_1,\boldsymbol y\rangle_e=\langle\boldsymbol b_1,\boldsymbol y-\boldsymbol{\mathop{\overline y}}\rangle_e+\mu_{\boldsymbol y}\langle\boldsymbol b_1,\boldsymbol 1\rangle_e=c_1+0 . \] Por tanto
\begin{equation}\label{eq:beta-coord} \hat\beta_m=\frac{c_1}{\Vert\tilde{\boldsymbol x}_m\Vert_e}: \end{equation}la primera coordenada del vector de datos en desviaciones dividida por la longitud de la parte propia. El error estándar es \(\mathrm{ee}(\hat\beta_m)=\mathfrak s/\Vert\tilde{\boldsymbol x}_m\Vert_e\) con \(\mathfrak s^2=\mathrm{SRC}/(n-k)\) (lección 14), y la longitud de la parte propia se cancela en el cociente:
\begin{equation}\label{eq:t-datos} \frac{\hat\beta_m}{\mathrm{ee}(\hat\beta_m)}=\frac{c_1}{\mathfrak s} =\frac{c_1}{\sqrt{\sum_{\mathcal R}c_j^2\big/\dim\mathcal R}} . \end{equation}El estadístico \(t\) es, en \(\mathbb R^n\), la coordenada sobre la parte propia dividida por la media cuadrática de las coordenadas de \(\mathcal R\). Con \(k=2\), \(\mathcal E\) es la recta de \(\boldsymbol b_1\) y \(c_1^2=\mathrm{SEC}\), de modo que \eqref{eq:t-datos} al cuadrado es \(t^2=(n-k)\,\mathrm{SEC}/\mathrm{SRC}\), la identidad que vertebra la lección 12; y como \(R^2=\mathrm{SEC}/\mathrm{STC}\) y \(\mathrm{STC}=\mathrm{SEC}+\mathrm{SRC}\), también \(t^2=(n-k)\,R^2/(1-R^2)\).
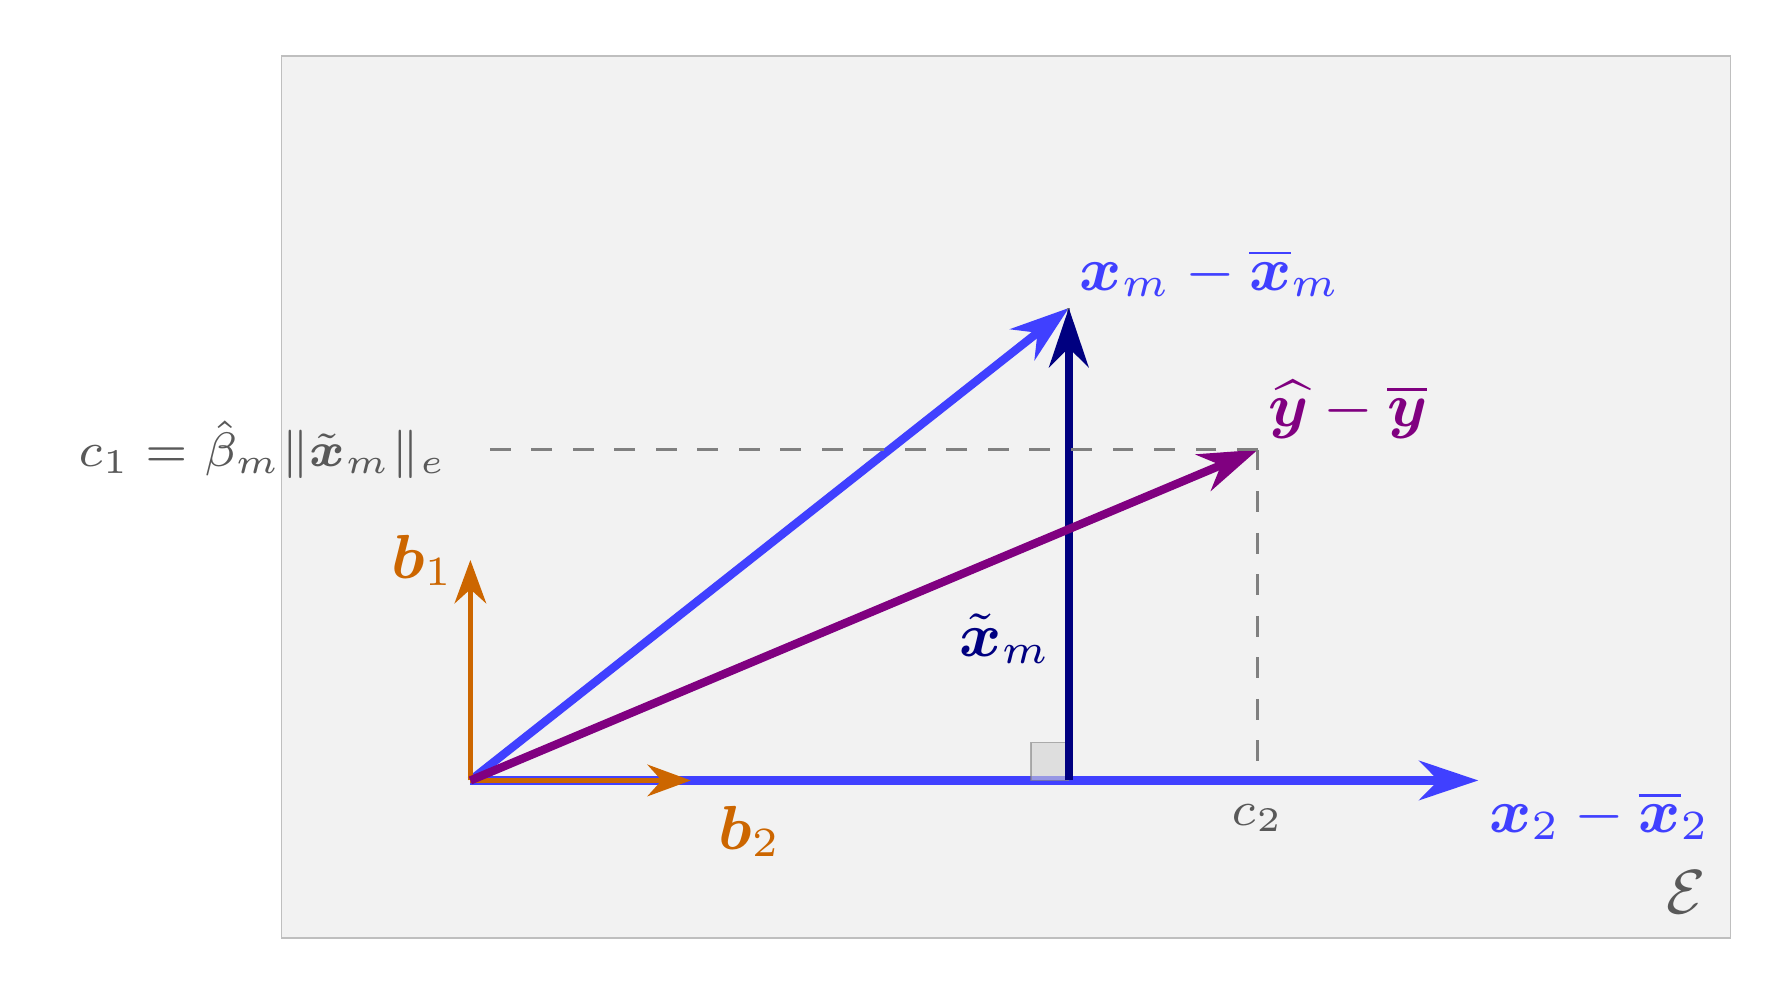
Figura 5: El plano \(\mathcal E\) visto de frente, con \(k=3\): dos regresores en desviaciones, no ortogonales entre sí. La parte propia \(\tilde{\boldsymbol x}_m\) es la componente de \(\boldsymbol x_m-\boldsymbol{\mathop{\overline x}}_m\) ortogonal al otro regresor; está dibujada desplazada, como residuo, desde la proyección hasta la punta, pero como vector parte del origen, en la dirección de \(\boldsymbol b_1\), que es su dirección normalizada; \(\boldsymbol b_2\) es la dirección del otro regresor. La coordenada del ajuste en desviaciones sobre \(\boldsymbol b_1\) es \(c_1=\hat\beta_m\Vert\tilde{\boldsymbol x}_m\Vert_e\), de donde \eqref{eq:beta-coord}.
5.5. Tercer triángulo: restricciones
Para \(q\) restricciones lineales homogéneas sobre \(\beta_2,\ldots,\beta_k\) (coeficientes nulos o combinaciones lineales nulas, las de la lección 13)5, el modelo restringido tiene su propio subespacio de regresores en desviaciones, \(\mathcal E_r\subset\mathcal E\), de dimensión \(k-1-q\). Partimos \(\mathcal E\) como antes partimos \(\mathcal L(\boldsymbol 1)^\perp\):
\begin{equation}\label{eq:descomposicion-r} \mathcal E=\mathcal E_r\oplus\mathcal Q,\qquad \mathcal E_r\perp\mathcal Q,\qquad \dim\mathcal Q=q , \end{equation}donde \(\mathcal Q\) son las \(q\) direcciones de \(\mathcal E\) que las restricciones suprimen. La base adaptada se afina: los \(k-1-q\) primeros vectores en \(\mathcal E_r\), los \(q\) siguientes (índices \(j=k-q,\ldots,k-1\)) en \(\mathcal Q\), los \(n-k\) últimos en \(\mathcal R\). La constante no se restringe, así que el modelo restringido sigue conteniendo a \(\boldsymbol 1\) y todo puede hacerse en desviaciones: el ajuste restringido en desviaciones, \(\boldsymbol{\mathop{\widehat y}}_r-\boldsymbol{\mathop{\overline y}}\), es la proyección de \(\boldsymbol v\) sobre \(\mathcal E_r\). Como \(\mathcal E=\mathcal E_r\oplus\mathcal Q\), proyectar sobre \(\mathcal E\) es proyectar sobre \(\mathcal E_r\) y sobre \(\mathcal Q\) y sumar (en la base adaptada, quedarse con unas coordenadas u otras), luego \(\boldsymbol{\mathop{\widehat y}}-\boldsymbol{\mathop{\widehat y}}_r\) es la proyección de \(\boldsymbol v\) sobre \(\mathcal Q\), y por el Pitágoras anidado de la lección 13, para cualquier vector de datos,
\begin{equation}\label{eq:anidado} \mathrm{SRC}_r-\mathrm{SRC}=\sum_{\mathcal Q}c_j^2,\qquad \mathrm{SRC}=\sum_{\mathcal R}c_j^2 : \end{equation}lo que el modelo restringido deja de explicar vive en las \(q\) direcciones suprimidas. Y el estadístico de la lección 13 es, en \(\mathbb R^n\),
\begin{equation}\label{eq:F-datos} F=\frac{(\mathrm{SRC}_r-\mathrm{SRC})/q}{\mathrm{SRC}/(n-k)}=\frac{\sum_{\mathcal Q}c_j^2\big/\dim\mathcal Q}{\sum_{\mathcal R}c_j^2\big/\dim\mathcal R} : \end{equation}el cociente entre las medias cuadráticas de las coordenadas de \(\mathcal Q\) y de \(\mathcal R\). El \(F\) de significación conjunta es el caso \(\mathcal E_r=\{\boldsymbol 0\}\), \(\mathcal Q=\mathcal E\), \(q=k-1\); dividiendo entonces numerador y denominador por \(\mathrm{STC}\) se obtiene \(F=\frac{n-k}{k-1}\,\frac{R^2}{1-R^2}\), la identidad de la lección 13.
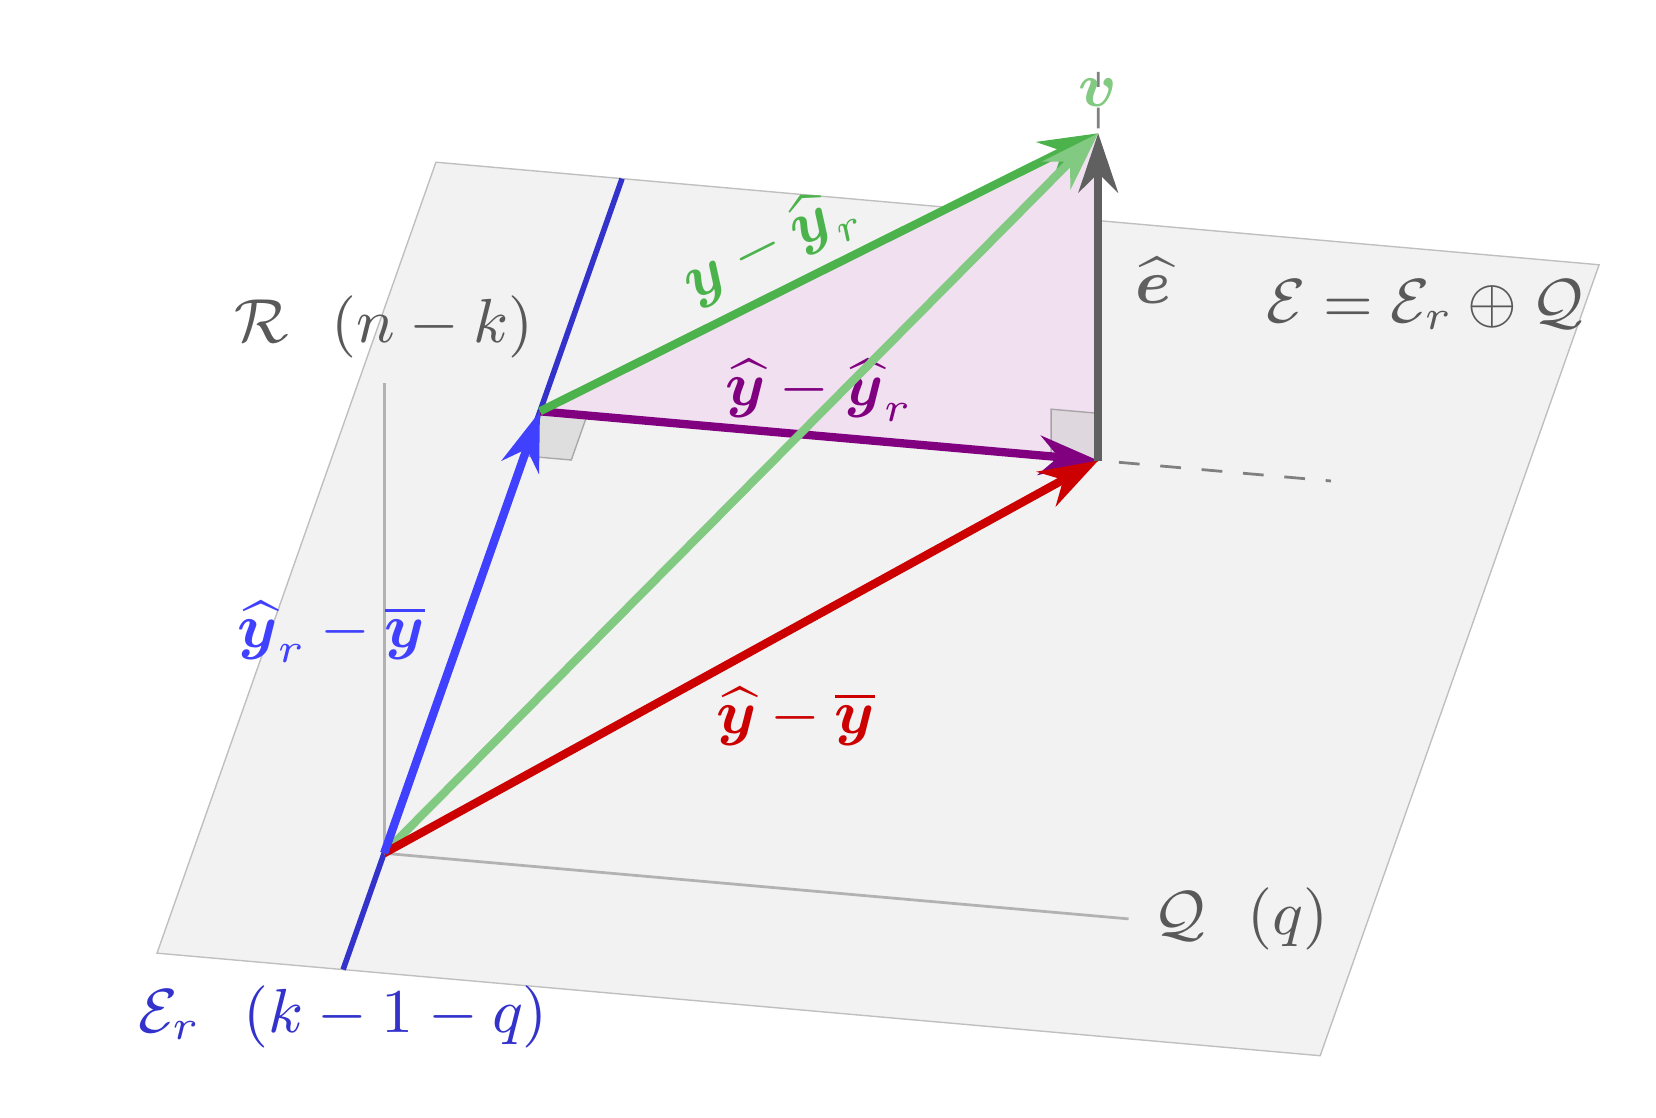
Figura 6: El tercer triángulo. Los tres ejes parten del origen: dentro de \(\mathcal E\), la recta azul es \(\mathcal E_r\) y la perpendicular a ella dentro del plano es \(\mathcal Q\); la vertical es \(\mathcal R\). El ajuste restringido en desviaciones es la proyección de \(\boldsymbol v\) sobre \(\mathcal E_r\). El triángulo está dibujado desplazado, con el vértice en la punta de \(\boldsymbol{\mathop{\widehat y}}_r-\boldsymbol{\mathop{\overline y}}\): sus lados son vectores que en realidad parten del origen, y las líneas a guiones son los ejes \(\mathcal Q\) y \(\mathcal R\) trasladados en paralelo hasta él. Lo que el modelo completo añade, \(\boldsymbol{\mathop{\widehat y}}-\boldsymbol{\mathop{\widehat y}}_r\), vive en \(\mathcal Q\) y tiene longitud \(\Vert\boldsymbol{\mathop{\widehat y}}-\boldsymbol{\mathop{\widehat y}}_r\Vert_e=\sqrt{\sum_{\mathcal Q}c_j^2}=\sqrt{\mathrm{SRC}_r-\mathrm{SRC}}\); el residuo vive en \(\mathcal R\) y tiene longitud \(\Vert\boldsymbol{\mathop{\widehat e}}\Vert_e=\sqrt{\sum_{\mathcal R}c_j^2}=\sqrt{\mathrm{SRC}}\); la hipotenusa es el residuo restringido, de longitud \(\Vert\boldsymbol y-\boldsymbol{\mathop{\widehat y}}_r\Vert_e=\sqrt{\mathrm{SRC}_r}\). Es la figura del Pitágoras anidado de la lección 13 con los subespacios nombrados.
Todo lo anterior es álgebra de \(\mathbb R^n\): vale para cualquier vector de datos \(\boldsymbol y\) y cualquier muestra de regresores linealmente independientes. No hay probabilidad.
6. Evaluar sobre la muestra aleatoria
6.1. Lo que suponemos y de dónde sale
El modelo es \(Y_i=\beta_1\,\mathit1+\beta_2X_{i2}+\cdots+\beta_kX_{ik}+U_i\), con los supuestos de la lección 11 condicionando en la muestra aleatoria de regresores \(\boldsymbol X\): \[ E[U_i\mid\boldsymbol X]=\mathit0,\qquad E[U_i^2\mid\boldsymbol X]=\sigma^2\,\mathit1,\qquad E[U_iU_{i'}\mid\boldsymbol X]=\mathit0\ (i\neq i'). \] Las esperanzas condicionales son variables aleatorias (funciones de \(\boldsymbol X\)); los números salen por la ley de las esperanzas iteradas: \(\mathrm E(U_iU_{i'})=\mathrm E\big(E[U_iU_{i'}\mid\boldsymbol X]\big)=0\), \(\mathrm E(U_i^2)=\sigma^2\). Dicho con el producto escalar de la lección 9: las \(n\) perturbaciones son una familia ortogonal de variables aleatorias, todas de longitud \(\Vert U_i\Vert_P=\sigma\). La normalidad no se supone todavía.
De dónde salen los tres supuestos. No se imponen a la muestra: se deducen del modelo poblacional y del muestreo aleatorio, como hace la lección 11 en una nota al pie, y con las piezas de la sección 1 el argumento cabe en un párrafo. Escribamos \(X_i\) por la fila \(i\) de regresores, \((X_{i2},\ldots,X_{ik})\), y \(X_{-i}\) por las copias distintas de la \(i\). Por definición de la perturbación (lección 9), \(E[U_i\mid X_i]=\mathit0\): \(U_i\) es ortogonal a toda función de \(X_i\). Por el muestreo aleatorio, la copia \((X_i,U_i)\) es independiente de \(X_{-i}\): sus espacios de funciones están a escuadra, es decir, toda función centrada de \((X_i,U_i)\) es ortogonal a toda función de \(X_{-i}\). Toda función de \(\boldsymbol X\) es combinación lineal de productos \(a(X_i)\,b(X_{-i})\) o límite de tales combinaciones (lo segundo es el único paso que, como en la lección 11, se admite sin demostración), y para cada producto, \[ \big\langle U_i,\,a(X_i)\,b(X_{-i})\big\rangle_P=\big\langle U_i\,a(X_i),\,b(X_{-i})\big\rangle_P=0 , \] porque \(U_ia(X_i)\) es una función de la copia \(i\) y está centrada (\(\mathrm E(U_ia(X_i))=\mathrm E\big(E[U_i\mid X_i]\,a(X_i)\big)=0\), por el Lema y las esperanzas iteradas), luego es ortogonal a \(b(X_{-i})\). Así \(U_i\) es ortogonal a toda función de \(\boldsymbol X\), que por \eqref{eq:cond} es \(E[U_i\mid\boldsymbol X]=\mathit0\). El segundo supuesto sale igual, con \(U_i^2-\sigma^2\,\mathit1\) en el lugar de \(U_i\) y la homocedasticidad poblacional \(E[U_i^2\mid X_i]=\sigma^2\,\mathit1\) en el lugar de \(E[U_i\mid X_i]=\mathit0\). Y el tercero, con \(i\neq i'\): \(\langle U_iU_{i'},\,a(X_i)b(X_{-i})\rangle_P=\langle U_ia(X_i),\,U_{i'}b(X_{-i})\rangle_P=0\), porque el primer factor es una función centrada de la copia \(i\) y el segundo una función de las demás copias.
6.2. La base evaluada
Las componentes \(b_{ji}\) de la base y la longitud \(\Vert\tilde{\boldsymbol x}_m\Vert_e\) son fórmulas de los regresores; sobre \(\boldsymbol X\) dan variables aleatorias \(B_{ji}\) y \(L_m\), funciones de \(\boldsymbol X\) (como los pesos \(W_i\) de las lecciones 11 y 14; de hecho, por \eqref{eq:pesos}, las componentes del vector de pesos son \(w_i=b_{1i}/\Vert\tilde{\boldsymbol x}_m\Vert_e\), y evaluadas sobre \(\boldsymbol X\) dan los pesos de la lección 14, \(W_i=B_{1i}/L_m\)). Las tres identidades \eqref{eq:base}, válidas para cualquier valor de los regresores, pasan por el puente y son igualdades entre variables aleatorias:
\begin{equation}\label{eq:base-va} \sum_{i=1}^nB_{ji}^2=\mathit1,\qquad \sum_{i=1}^nB_{ji}B_{li}=\mathit0\ (j\neq l),\qquad \sum_{i=1}^nB_{ji}=\mathit0 . \end{equation}6.3. Las coordenadas del ruido: la familia \(\{C_j\}\)
La fórmula de las coordenadas, \eqref{eq:coord}, es una suma de productos de números. Sustituyamos los números por las variables del muestreo: en el lugar de \(v_i\), la perturbación centrada \(U_i-\overline U\) (una variable aleatoria, como vimos en la sección 4), y en el lugar de \(b_{ji}\), la variable aleatoria \(B_{ji}\). Productos y sumas de variables aleatorias son variables aleatorias, así que la fórmula define \(n-1\) estadísticos nuevos, \[ C_j=\sum_{i=1}^nB_{ji}\,(U_i-\overline U),\qquad j=1,\ldots,n-1 , \] que se simplifican con la tercera identidad de \eqref{eq:base-va}: \(\overline U\) es la misma variable aleatoria en todos los sumandos, sale factor común, y lo que la multiplica es \(\sum_iB_{ji}=\mathit0\), que es el producto escalar \(\langle\boldsymbol b_j,\boldsymbol 1\rangle_e=0\) evaluado sobre la muestra,
\begin{equation}\label{eq:C} C_j=\sum_{i=1}^nB_{ji}\,U_i-\overline U\sum_{i=1}^nB_{ji}=\sum_{i=1}^nB_{ji}\,U_i . \end{equation}Las \(C_j\) son sumas ponderadas de las perturbaciones sin centrar, con pesos \(B_{ji}\) que son funciones de \(\boldsymbol X\): la misma estructura que \(\hat\beta_2-\beta_2\,\mathit1=\sum_{i=1}^nW_iU_i\) en la lección 11. \(C_j\) no es la coordenada de nada: es una variable aleatoria, la que a cada \(\omega\) le asigna la coordenada \(j\)-ésima, en la base realizada, del punto de \(\mathbb R^n\) realizado por las perturbaciones centradas. Llamamos a \(C_j\) la coordenada del ruido sobre \(\boldsymbol b_j\), evaluada sobre la muestra.
6.4. Las coordenadas de la parte sistemática: \(D_j\)
Al restar la media muestral en el modelo, \[ Y_i-\overline Y=\underbrace{\beta_2(X_{i2}-\overline X_2)+\cdots+\beta_k(X_{ik}-\overline X_k)}_{S_i}+(U_i-\overline U),\qquad i=1,\ldots,n , \] donde \(S_i\) es la componente \(i\)-ésima de la parte sistemática en desviaciones, una función de los regresores. En \(\mathbb R^n\), para cada realización, la lista \((S_1,\ldots,S_n)\) es el vector \(\boldsymbol s=\beta_2(\boldsymbol x_2-\boldsymbol{\mathop{\overline x}}_2)+\cdots+\beta_k(\boldsymbol x_k-\boldsymbol{\mathop{\overline x}}_k)\), un vector de \(\mathcal E\). Evaluemos la fórmula de las coordenadas, \eqref{eq:coord}, sobre la lista \((Y_i-\overline Y)_i\). Como \(Y_i-\overline Y=S_i+(U_i-\overline U)\), la suma se parte en dos:
\begin{equation}\label{eq:D+C} \sum_{i=1}^nB_{ji}(Y_i-\overline Y)=\underbrace{\sum_{i=1}^nB_{ji}S_i}_{D_j}+\underbrace{\sum_{i=1}^nB_{ji}(U_i-\overline U)}_{C_j},\qquad j=1,\ldots,n-1 . \end{equation}El segundo sumando es la \(C_j\) de \eqref{eq:C}. El primero, \(D_j\), es la misma fórmula \eqref{eq:coord} evaluada sobre los \(S_i\): la coordenada de la parte sistemática sobre \(\boldsymbol b_j\), evaluada sobre la muestra; es una variable aleatoria que es función solo de los regresores (y de los números \(\beta\)), porque tanto los \(S_i\) como los \(B_{ji}\) lo son. Y aquí interviene \eqref{eq:coord-nula}: para cada realización, \(D_j(\omega)=\langle\boldsymbol s,\boldsymbol b_j\rangle_e\) es la coordenada de un vector de \(\mathcal E\) sobre \(\boldsymbol b_j\), que es cero para todo \(\boldsymbol b_j\) de \(\mathcal R\), sea cual sea la realización. Por tanto
\begin{equation}\label{eq:casos} \sum_{i=1}^nB_{ji}(Y_i-\overline Y)=\begin{cases}D_j+C_j & \boldsymbol b_j\in\mathcal E,\\[2pt] C_j & \boldsymbol b_j\in\mathcal R:\end{cases} \end{equation}sobre las direcciones de \(\mathcal R\), la coordenada de la parte sistemática es nula y solo queda la del ruido; sobre las direcciones de \(\mathcal E\), la coordenada es la suma de la de la parte sistemática y la del ruido.
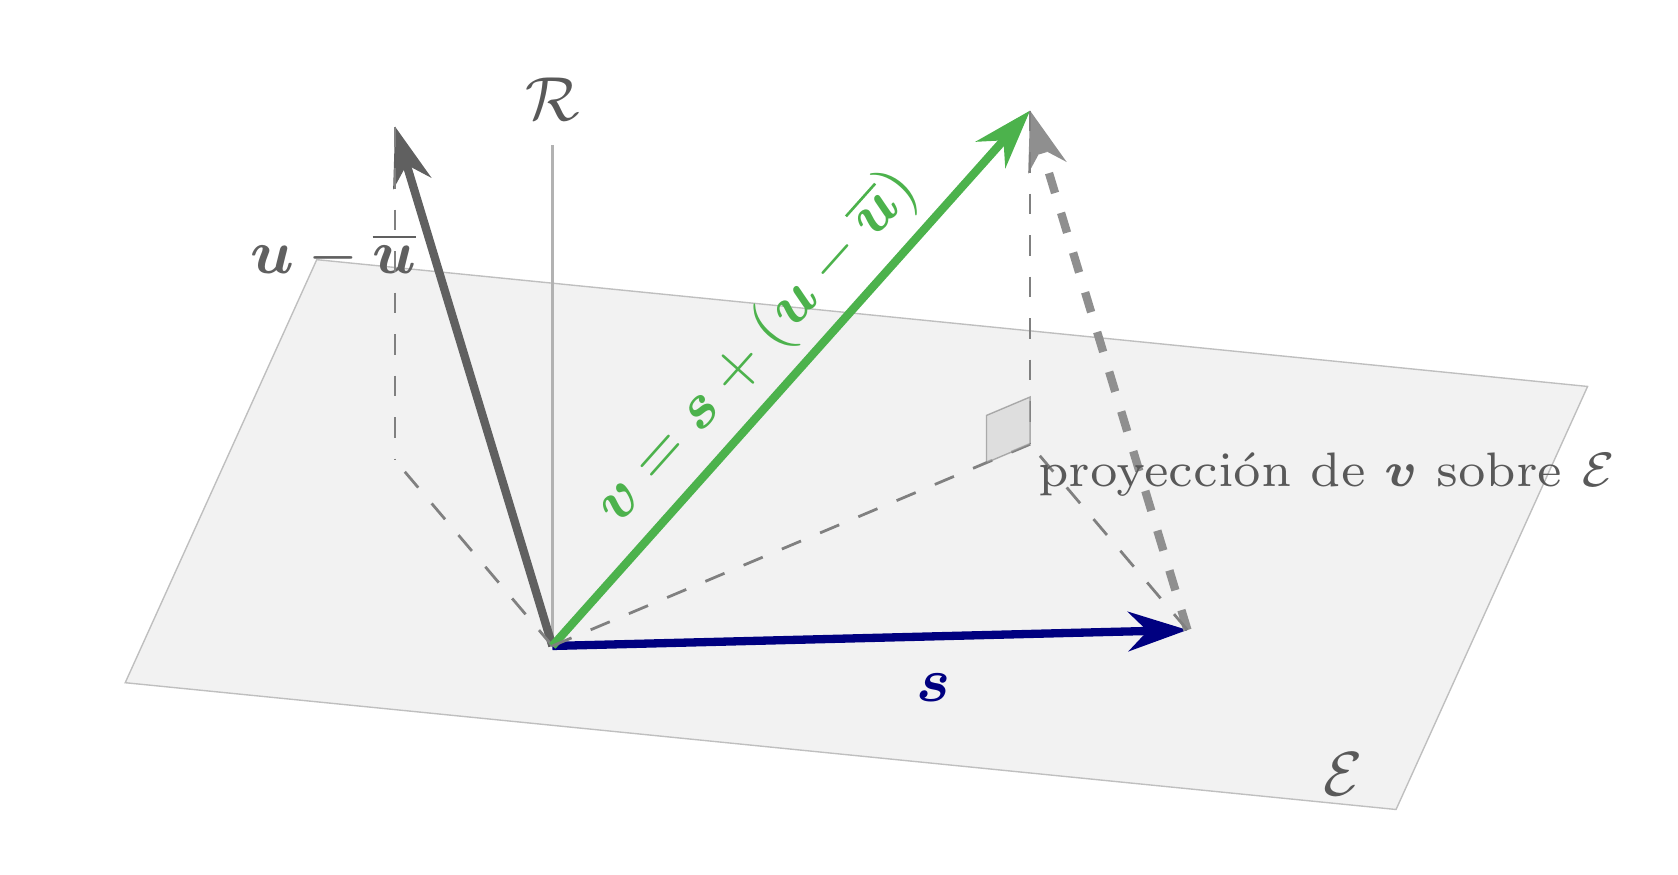
Figura 7: Una realización \(\omega\), dibujada en \(\mathbb R^n\). Los tres vectores parten del origen: \(\boldsymbol s\) es la realización de \((S_1,\ldots,S_n)\) y está en \(\mathcal E\); \(\boldsymbol u-\boldsymbol{\mathop{\overline u}}\) es la realización de las perturbaciones centradas, con componente en \(\mathcal E\) (su proyección, en línea de puntos) y en \(\mathcal R\); \(\boldsymbol v\) es su suma, y la copia a guiones de \(\boldsymbol u-\boldsymbol{\mathop{\overline u}}\) trasladada a la punta de \(\boldsymbol s\) solo muestra la regla del paralelogramo. La proyección de \(\boldsymbol v\) sobre \(\mathcal E\) es \(\boldsymbol s\) más la proyección del ruido; su componente en \(\mathcal R\) es solo la del ruido, porque \(\boldsymbol s\) no tiene. Por eso las coordenadas de \(\boldsymbol v\) sobre los vectores de la base de \(\mathcal R\) son \(c_j\) y sobre los de \(\mathcal E\) son \(d_j+c_j\), donde \(d_j\) y \(c_j\) son los valores en \(\omega\) de \(D_j\) y \(C_j\). Bajo \(H_0\colon\beta_2=\cdots=\beta_k=0\), \(\boldsymbol s=\boldsymbol 0\) y \(\boldsymbol v\) es el ruido centrado.
Dos casos particulares de \(D_j\) que necesitaremos:
- Bajo una hipótesis nula. Si \(H_0\) son las \(q\) restricciones del tercer triángulo, entonces bajo \(H_0\) el vector \(\boldsymbol s\) está en \(\mathcal E_r\), y por \eqref{eq:coord-nula} aplicado a la partición de \(\mathcal E\), \(D_j=\mathit0\) también para todo \(\boldsymbol b_j\) de \(\mathcal Q\). Para \(H_0\colon\beta_2=\cdots=\beta_k=0\), \(\boldsymbol s=\boldsymbol 0\) y \(D_j=\mathit0\) para todo \(j\). El recíproco necesita la independencia lineal de los regresores: \(\boldsymbol s\) es una combinación lineal de vectores linealmente independientes, y solo es el vector nulo si todos sus coeficientes son cero; si los regresores fuesen linealmente dependientes, habría coeficientes no nulos con \(\boldsymbol s=\boldsymbol 0\), y \(H_0\) falsa sería indistinguible de \(H_0\) cierta.
- Sobre la parte propia. Con la base del segundo triángulo, \(D_1(\omega)=\langle\boldsymbol s,\tilde{\boldsymbol x}_m\rangle_e/\Vert\tilde{\boldsymbol x}_m\Vert_e\). Como \(\tilde{\boldsymbol x}_m\) es ortogonal a \(\boldsymbol 1\) y a los demás regresores, de los \(k-1\) sumandos de \(\boldsymbol s\) solo sobrevive el de \(\boldsymbol x_m\), y \(\langle\boldsymbol x_m-\boldsymbol{\mathop{\overline x}}_m,\tilde{\boldsymbol x}_m\rangle_e=\langle\boldsymbol x_m,\tilde{\boldsymbol x}_m\rangle_e=\Vert\tilde{\boldsymbol x}_m\Vert_e^2\) (lección 14). Luego \(D_1=\beta_m\,L_m\).
6.5. Los tres triángulos evaluados
Las identidades \eqref{eq:sumas}, \eqref{eq:beta-coord} y \eqref{eq:anidado} pasan por el puente con las coordenadas \eqref{eq:casos}. Las sumas de cuadrados de la lección 8, ahora variables aleatorias (las fórmulas evaluadas sobre la muestra, no los números de una tabla), son
\begin{equation}\label{eq:sumas-va} \mathrm{SEC}=\sum_{\mathcal E}(D_j+C_j)^2,\qquad \mathrm{SRC}=\sum_{\mathcal R}C_j^2,\qquad \mathrm{SRC}_r-\mathrm{SRC}=\sum_{\mathcal Q}(D_j+C_j)^2\ \ \big(=\sum_{\mathcal Q}C_j^2\ \text{bajo }H_0\big). \end{equation}\(\mathrm{SRC}\) no ve la parte sistemática, con o sin hipótesis sobre los \(\beta\): la parte sistemática vive en \(\mathcal E\) y el residuo en \(\mathcal R\). Y el coeficiente, por \eqref{eq:beta-coord} y \(D_1=\beta_mL_m\),
\begin{equation}\label{eq:beta-va} \hat\beta_m=\frac{D_1+C_1}{L_m}=\beta_m\,\mathit1+\frac{C_1}{L_m}, \end{equation}que es la descomposición \(\hat\beta_m=\beta_m\,\mathit1+\sum_iW_iU_i\) de la lección 14, con \(\sum_iW_iU_i=C_1/L_m\).
6.6. Fijar \(\omega\): de vuelta a \(\mathbb R^n\)
Conviene cerrar la sección con la síntesis de lo hecho. Las fórmulas de la sección 5 son fórmulas de \(\mathbb R^n\) y solo tienen lectura en \(\mathbb R^n\): operan con las componentes de vectores de datos. En esta sección se han reutilizado esas mismas expresiones, escritas como sumas de componentes, sustituyendo los números por las variables aleatorias de la muestra; el resultado, \(B_{ji}\), \(C_j\), \(D_j\), \(\mathrm{SRC}\), \(\hat\beta_m\), son estadísticos, y ya no estamos en \(\mathbb R^n\) sino en el espacio de las variables aleatorias. El camino de vuelta es fijar un resultado \(\omega\): evaluar la muestra en \(\omega\) arroja una lista de números, un vector de \(\mathbb R^n\), y cada estadístico toma en \(\omega\) el valor que su fórmula da en ese vector, con la base realizada. En ese punto todas las identidades de la sección 5 se cumplen con igualdad; es lo que muestra la figura 4. Los datos observados son una de esas realizaciones, una columna de la matriz de copias de la sección 3: los números de una tabla de Gretl, el \(F=251{,}5\) de la lección 13 por ejemplo, son los valores de los estadísticos en ese \(\omega\). Las secciones que siguen no hablan de ese valor, sino de qué valores tomaría cada estadístico sobre el conjunto de los \(\omega\), y es ahí, y solo ahí, donde entra la probabilidad.
7. La familia ortogonal y lo que da sin normalidad
7.1. Ortogonalidad de las \(C_j\)
La geometría de las \(C_j\) es la del espacio de las variables aleatorias, y se calcula como la varianza de \(\hat\beta_2\) en la lección 11. Para \(j\) y \(l\) cualesquiera, \[ E[C_jC_l\mid\boldsymbol X]=\sum_{i=1}^n\sum_{i'=1}^nB_{ji}B_{li'}\,E[U_iU_{i'}\mid\boldsymbol X] =\sigma^2\sum_{i=1}^nB_{ji}B_{li} =\begin{cases}\sigma^2\,\mathit1 & j=l,\\ \mathit0 & j\neq l,\end{cases} \] donde el primer paso es el Lema de la lección 11 (las \(B\) son funciones de \(\boldsymbol X\) y salen fuera), el segundo usa homocedasticidad e incorrelación, y el tercero las identidades \eqref{eq:base-va}: la suma \(\sum_iB_{ji}B_{li}\) es el producto escalar \(\langle\boldsymbol b_j,\boldsymbol b_l\rangle_e\) evaluado sobre la muestra, y vale \(\mathit1\) o \(\mathit0\) según la base sea ortonormal. Es el único punto en que la geometría de \(\mathbb R^n\) entra en esta cuenta, y entra como suma de componentes, no como producto escalar: lo que se evalúa es la fórmula. También \(E[C_j\mid\boldsymbol X]=\sum_iB_{ji}\,E[U_i\mid\boldsymbol X]=\mathit0\). Tomando esperanzas: \[ \langle C_j,C_l\rangle_P=\mathrm E(C_jC_l)=\begin{cases}\sigma^2 & j=l,\\ 0 & j\neq l.\end{cases} \]
Resultado 1. Con los supuestos de la lección 11, y para cualquier base ortonormal de \(\mathcal L(\boldsymbol 1)^\perp\) construida con los regresores, las \(n-1\) coordenadas del ruido \(C_1,\ldots,C_{n-1}\) forman una familia ortogonal de variables aleatorias centradas, todas de la misma longitud \(\Vert C_j\Vert_P=\sigma\). No depende de los \(\beta\) ni de ninguna hipótesis nula.
Ese es el contenido de la frase que las lecciones abrevian como ``el ruido reparte su longitud por igual entre las dimensiones''. No habla de longitudes en \(\mathbb R^n\); habla de longitudes de variables aleatorias, y la igualdad entre direcciones es que los \(n-1\) elementos de la familia miden lo mismo.
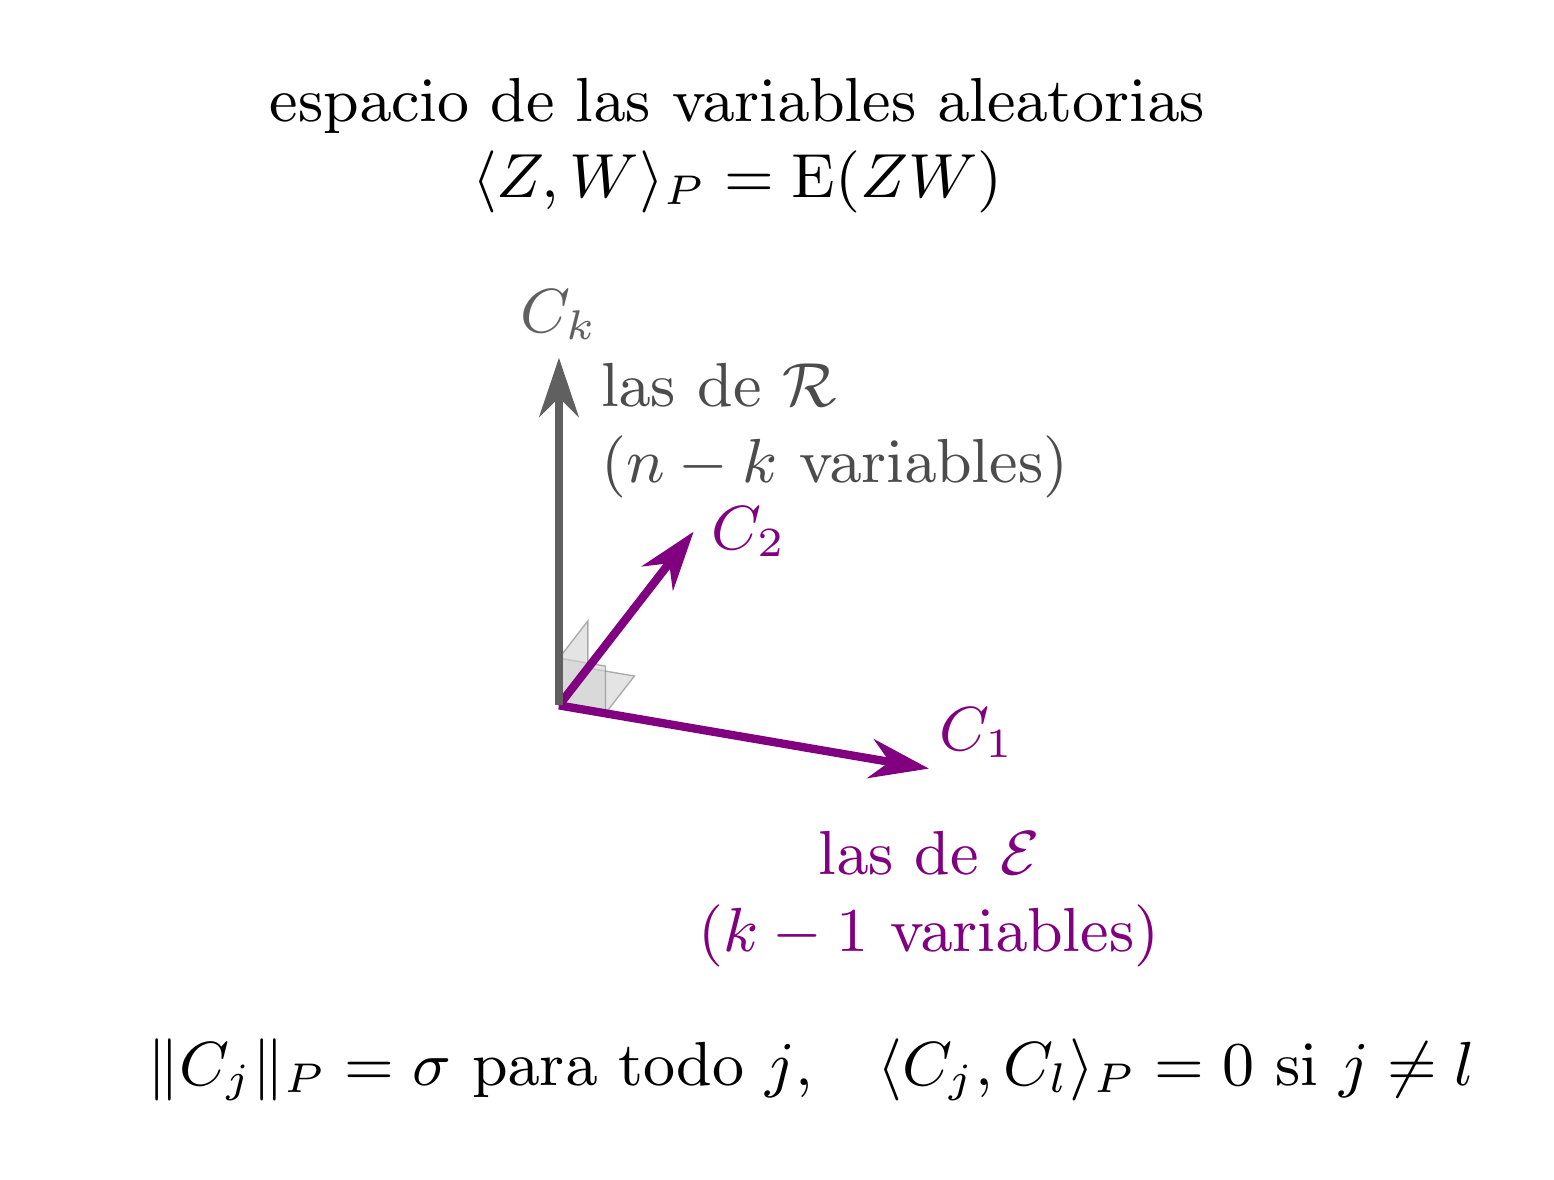
Figura 8: El Resultado 1 en el otro espacio. Las \(C_j\) son elementos del espacio de las variables aleatorias, con el producto escalar \(\langle Z,W\rangle_P=\mathrm E(ZW)\) de la lección 9: una familia ortogonal cuyos \(n-1\) miembros miden lo mismo, \(\sigma\). Las \(k-1\) de \(\mathcal E\) y las \(n-k\) de \(\mathcal R\) se distinguen solo por el vector de la base al que corresponden. Aquí no hay datos ni vectores de \(\mathbb R^n\): la figura es un esquema de tres de las \(n-1\) variables.
Primer corolario: insesgadez y varianza de \(\hat\beta_m\). De \eqref{eq:beta-va}, \(\hat\beta_m=\beta_m\,\mathit1+C_1/L_m\) con \(L_m\) función de \(\boldsymbol X\). Por el Lema y el Resultado 1, \[ E[\hat\beta_m\mid\boldsymbol X]=\beta_m\,\mathit1+\frac{E[C_1\mid\boldsymbol X]}{L_m}=\beta_m\,\mathit1,\qquad Var[\hat\beta_m\mid\boldsymbol X]=\frac{E[C_1^2\mid\boldsymbol X]}{L_m^2}=\frac{\sigma^2}{L_m^2}: \] la insesgadez y la varianza de la lección 11 (con \(k=2\), \(\tilde{\boldsymbol x}_2=\boldsymbol x_2-\boldsymbol{\mathop{\overline x}}_2\) y \(L_2^2=\sum_i(X_i-\overline X)^2\)) y de la lección 14 (la varianza es \(\sigma^2\) por unidad de longitud al cuadrado de la parte propia, evaluada sobre la muestra). Tomando esperanzas, \(\mathrm E(\hat\beta_m)=\beta_m\).
7.2. Esperanzas de las sumas de cuadrados
De \eqref{eq:sumas-va} y el Resultado 1 salen las esperanzas condicionales. Para \(\mathrm{SRC}\), sin hipótesis nula: \[ E[\mathrm{SRC}\mid\boldsymbol X]=\sum_{\mathcal R}E[C_j^2\mid\boldsymbol X]=\dim\mathcal R\;\sigma^2\,\mathit1=(n-k)\,\sigma^2\,\mathit1 . \] Es la insesgadez de \(\mathfrak s^2=\mathrm{SRC}/(n-k)\) que la lección 11 enunció, y se ve por qué no depende de los \(\beta\): el residuo solo contiene las coordenadas del ruido en \(\mathcal R\). Un caso particular conocido: sin regresores (\(k=1\), solo la constante), \(\mathcal R\) es todo \(\mathcal L(\boldsymbol 1)^\perp\), de dimensión \(n-1\), el residuo es el vector en desviaciones y \(\mathrm{SRC}=\sum_i(U_i-\overline U)^2\) tiene esperanza \((n-1)\sigma^2\): de ahí el divisor \(n-1\) de la varianza muestral insesgada. Es el mismo mecanismo. Y de ahí también el sesgo del estimador ``natural'' de la lección 11, \(\mathrm{SRC}/n\): \(E[\mathrm{SRC}/n\mid\boldsymbol X]=\frac{n-k}{n}\,\sigma^2\,\mathit1\), menor que \(\sigma^2\,\mathit1\). Para \(\mathrm{SEC}\), cada sumando lleva \(D_j\); como \(D_j\) es función de \(\boldsymbol X\), sale fuera de la esperanza condicional (Lema), y como \(E[C_j\mid\boldsymbol X]=\mathit0\), el término cruzado desaparece: \[ E[(D_j+C_j)^2\mid\boldsymbol X]=D_j^2+2D_j\,E[C_j\mid\boldsymbol X]+E[C_j^2\mid\boldsymbol X]=D_j^2+\sigma^2\,\mathit1 , \] y sumando sobre \(\mathcal E\) (o sobre \(\mathcal Q\)),
\begin{equation}\label{eq:esperanzas} E[\mathrm{SEC}\mid\boldsymbol X]=\dim\mathcal E\;\sigma^2\,\mathit1+\sum_{\mathcal E}D_j^2,\qquad E[\mathrm{SRC}_r-\mathrm{SRC}\mid\boldsymbol X]=\dim\mathcal Q\;\sigma^2\,\mathit1+\sum_{\mathcal Q}D_j^2 . \end{equation}El sumando añadido es, para cada realización, la longitud al cuadrado de \(\boldsymbol s\) (o de su componente en \(\mathcal Q\)), por Pitágoras en \(\mathbb R^n\) evaluado sobre la muestra: no es negativo, y es nulo exactamente bajo la hipótesis nula correspondiente.
Resultado 2. Sin normalidad: dividiendo cada suma de cuadrados por la dimensión del subespacio donde vive, el denominador de \(F\) tiene siempre esperanza \(\sigma^2\), y el numerador tiene esperanza \(\sigma^2\) bajo \(H_0\) y \(\sigma^2\) más algo positivo fuera de \(H_0\), tanto mayor cuanto más larga sea la parte de \(\boldsymbol s\) que \(H_0\) suprime en relación con el ruido. Por eso \(F\) ronda \(1\) cuando \(H_0\) es cierta y un \(F\) mucho mayor que \(1\) habla contra \(H_0\).
7.3. Gauss–Markov: ningún estimador lineal insesgado tiene menos varianza
La lección 11 enuncia sin demostrar que \(\hat\beta_m\) tiene la menor varianza entre los estimadores lineales e insesgados (MCO es BLUE), y remite a una maquinaria matricial que el curso no desarrolla. Con las piezas de este documento no hace falta: es una identidad de \(\mathbb R^n\), el puente y el Resultado 1.
En \(\mathbb R^n\). Un estimador lineal es \(\langle\boldsymbol c,\boldsymbol y\rangle_e=\sum_ic_iy_i\) con un vector de pesos \(\boldsymbol c\) construido con los regresores. Evaluado sobre el modelo da \(\sum_iC_iY_i=\beta_1\sum_iC_i+\sum_{j}\beta_j\sum_iC_iX_{ij}+\sum_iC_iU_i\), y por el Lema, \(E[\sum_iC_iY_i\mid\boldsymbol X]=\beta_1\sum_iC_i+\sum_j\beta_j\sum_iC_iX_{ij}\). Que eso valga \(\beta_m\,\mathit1\) para todos los valores de los parámetros, que es lo que la insesgadez exige, fuerza cada coeficiente: \(\sum_iC_i=\mathit0\), y \(\sum_iC_iX_{ij}\) igual a \(\mathit1\) si \(j=m\) y a \(\mathit0\) si no, en cada realización. Son las dos condiciones de ``Dos propiedades de los pesos'' de la lección 11, escritas en \(\mathbb R^n\): \[ \langle\boldsymbol c,\boldsymbol 1\rangle_e=0,\qquad \langle\boldsymbol c,\boldsymbol x_j\rangle_e=\begin{cases}1 & j=m,\\ 0 & j\neq m,\end{cases}\qquad j=2,\ldots,k . \] Los pesos MCO, \(\boldsymbol w=\tilde{\boldsymbol x}_m/\Vert\tilde{\boldsymbol x}_m\Vert_e^2\), las cumplen: \(\tilde{\boldsymbol x}_m\) es ortogonal a \(\boldsymbol 1\) y a los demás regresores, y \(\langle\boldsymbol x_m,\tilde{\boldsymbol x}_m\rangle_e=\Vert\tilde{\boldsymbol x}_m\Vert_e^2\) (lección 14). Luego la diferencia \(\boldsymbol c-\boldsymbol w\) es ortogonal a \(\boldsymbol 1\) y a todos los regresores, y en particular a \(\tilde{\boldsymbol x}_m\), que es combinación de ellos: es ortogonal a \(\boldsymbol w\). Pitágoras:
\begin{equation}\label{eq:GM} \Vert\boldsymbol c\Vert_e^2=\Vert\boldsymbol w\Vert_e^2+\Vert\boldsymbol c-\boldsymbol w\Vert_e^2\ \ge\ \Vert\boldsymbol w\Vert_e^2 , \end{equation}con igualdad solo si \(\boldsymbol c=\boldsymbol w\). Es una identidad entre números, válida para todo vector de pesos que cumpla las dos condiciones.
Evaluado sobre la muestra. Los pesos pasan a ser \(C_i\) y \(W_i\), funciones de \(\boldsymbol X\); el estimador es \(\beta_m\,\mathit1+\sum_iC_iU_i\); y la cuenta del Resultado 1 (Lema, homocedasticidad, incorrelación) da \(Var\big[\sum_iC_iU_i\mid\boldsymbol X\big]=\sigma^2\sum_iC_i^2\). La identidad \eqref{eq:GM} pasa por el puente, \(\sum_iC_i^2=\sum_iW_i^2+\sum_i(C_i-W_i)^2\), y como \(\sum_iW_i^2=1/L_m^2\), \[ Var\Big[\sum_iC_iY_i\,\Big|\,\boldsymbol X\Big]=\sigma^2\sum_iC_i^2\ \ge\ \sigma^2\sum_iW_i^2=\frac{\sigma^2}{L_m^2}=Var[\hat\beta_m\mid\boldsymbol X] , \] con igualdad solo si \(C_i=W_i\) para todo \(i\).
Resultado 2 bis (Gauss–Markov). Con los supuestos de la lección 11, y sin normalidad, \(\hat\beta_m\) tiene la menor varianza condicional entre los estimadores lineales e insesgados de \(\beta_m\). Es Pitágoras en \(\mathbb R^n\), evaluado sobre la muestra, más el Resultado 1.
Hasta aquí no se ha usado la normalidad, y los Resultados 1, 2 y 2 bis son todo lo que el curso dice de los estimadores sin ella: insesgadez, varianza, varianza mínima, y la justificación de \(F\) como estadístico de contraste. Lo que no dan es ninguna distribución: para eso hay que saber cómo se reparte la probabilidad entre los valores de cada \(C_j\), y cómo se relacionan unas con otras más allá de la ortogonalidad.
8. Qué añade la normalidad: de ortogonal a independiente
Recordemos la sección 1.5: dos variables aleatorias son independientes cuando sus espacios de funciones están a escuadra sobre la recta de las constantes, y una familia lo es cuando, para cualquier partición en dos grupos, los espacios de funciones de uno y otro están a escuadra. De ahí sale lo que necesitamos:
Si dos estadísticos son funciones de dos subfamilias disjuntas de una familia independiente, los dos estadísticos son independientes. Tómese la partición ``primera subfamilia frente a todo lo demás'': el primer estadístico es función del primer grupo y el segundo, función del complementario, que contiene a la segunda subfamilia; los dos espacios están a escuadra, y por la caracterización de 1.5 los estadísticos son independientes.
La ortogonalidad \(\langle C_j,C_l\rangle_P=0\) del Resultado 1 es solo la parte lineal de la escuadra: dice que \(C_j\perp C_l\), no que \(C_j^2\) sea ortogonal a \(C_l^2-\mathrm E(C_l^2)\,\mathit1\), que es lo que haría falta para que las sumas de cuadrados de dos grupos fuesen independientes. Lo que convierte la ortogonalidad en escuadra es la normalidad, y conviene ver dónde entra exactamente. Hasta aquí, de las perturbaciones solo se ha usado que, dadas \(\boldsymbol X\), son una familia ortogonal de la misma longitud \(\sigma\) (incorrelación y homocedasticidad): es la lectura geométrica débil, y basta para los Resultados 1 y 2. Lo fuerte es el supuesto de la lección 12, y no hay que añadir nada más: la distribución de cada \(U_i\) condicionada a sus regresores es \(N(0,\sigma^2)\), es decir, todas las sombras de \(U_i\) sobre las funciones de \(X_i\) son constantes, que por la sección 1.5 es que \(U_i\) es independiente de \(X_i\) con distribución \(N(0,\sigma^2)\). Con el muestreo aleatorio (las copias \((X_i,U_i)\) independientes entre sí, sección 2), eso da que, dadas \(\boldsymbol X\), las \(U_1,\ldots,U_n\) son una familia a escuadra (independientes entre sí e independientes de los regresores) con la misma distribución \(N(0,\sigma^2)\).6 La escuadra aparece así dos veces, como hipótesis sobre las \(U_i\) y como conclusión sobre las \(C_j\); lo que hace la normalidad es que el cambio de base, un giro en \(\mathbb R^n\) evaluado sobre la muestra, conserve la escuadra y la distribución. Es una propiedad de la distribución normal que enunciamos sin demostrar:
Propiedad de la normal. Si \(U_1,\ldots,U_n\) son, condicionando en \(\boldsymbol X\), variables \(N(0,\sigma^2)\) independientes, y \(C_1,\ldots,C_{n-1}\) son sumas ponderadas \(C_j=\sum_iB_{ji}U_i\) con pesos función de \(\boldsymbol X\) que cumplen las identidades \eqref{eq:base-va}, entonces, condicionando en \(\boldsymbol X\), las \(C_j\) son variables \(N(0,\sigma^2)\) independientes: la familia ortogonal es, además, una familia a escuadra.7
Es la propiedad que las lecciones 12 y 13 llaman isotropía, formulada sin vectores aleatorios:
Resultado 3 (isotropía). Con normalidad, para cualquier base ortonormal de \(\mathcal L(\boldsymbol 1)^\perp\) construida con los regresores, las coordenadas del ruido evaluadas sobre la muestra, \(C_1,\ldots,C_{n-1}\), son, condicionando en \(\boldsymbol X\), variables aleatorias independientes con la misma distribución \(N(0,\sigma^2)\). Es una propiedad de la familia \(\{C_j\}\), no de un vector.
Un corolario que las lecciones usan: bajo \(H_0\colon\beta_2=\cdots=\beta_k=0\), \(R^2\) evaluado sobre la muestra es \(\sum_{\mathcal E}C_j^2\big/\sum_{j=1}^{n-1}C_j^2\), y como las \(n-1\) variables son independientes con la misma distribución, los \(n-1\) cocientes \(C_j^2\big/\sum_lC_l^2\) tienen todos la misma esperanza; como suman \(\mathit1\), cada uno tiene esperanza \(1/(n-1)\), y sumando los \(k-1\) de \(\mathcal E\), \(\mathrm E(R^2)=\dim\mathcal E/(n-1)=(k-1)/(n-1)\): el \(R^2\) que regala el azar (lección 13). Aquí sí hace falta más que la ortogonalidad: la esperanza de un cociente no se calcula sumando esperanzas, y lo que la fija es que los \(n-1\) sumandos sean intercambiables.
9. La \(t\)
Tres distribuciones, por definición. Una variable \(\chi^2_m\) es, por definición, una suma de \(m\) cuadrados de variables \(N(0,1)\) independientes. Una \(t_m\) es un cociente \(Z/\sqrt{Q/m}\) con \(Z\sim N(0,1)\), \(Q\sim\chi^2_m\), y \(Z\) y \(Q\) independientes. Una \(F_{q,m}\) es un cociente \((Q_1/q)/(Q_2/m)\) de dos \(\chi^2\) independientes, con \(q\) y \(m\) grados de libertad, cada una dividida por los suyos. Las tres están tabuladas; lo que hay que demostrar es que los estadísticos del curso tienen, condicionando en \(\boldsymbol X\), exactamente esa forma.
La distribución de \(\hat\beta_m\). Por \eqref{eq:beta-va} y el Resultado 3, dada \(\boldsymbol X\), \(\hat\beta_m=\beta_m\,\mathit1+C_1/L_m\) es \(\beta_m\) más una \(N(0,\sigma^2)\) dividida por \(L_m\), función de \(\boldsymbol X\): es decir, \(N(\beta_m,\sigma^2/L_m^2)\), la distribución que la lección 12 enuncia (``una combinación lineal de normales independientes es normal'' es lo que la propiedad de la normal dice de \(C_1\)). Si \(\sigma\) fuese conocida, \((\hat\beta_m-\beta_m\,\mathit1)/(\sigma/L_m)=C_1/\sigma\) sería una \(N(0,1)\); como no lo es, se sustituye por \(\mathfrak s\), y aparece la \(t\).
Juntemos las piezas. De \eqref{eq:beta-va}, \(\hat\beta_m-\beta_m\,\mathit1=C_1/L_m\), y el error estándar evaluado sobre la muestra es \(\mathfrak s/L_m\) con \(\mathfrak s^2=\mathrm{SRC}/(n-k)=\sum_{\mathcal R}C_j^2/\dim\mathcal R\). Es \eqref{eq:t-datos} evaluada sobre la muestra, con el parámetro restado y \(L_m\) cancelada: \[ \frac{\hat\beta_m-\beta_m\,\mathit1}{\mathrm{ee}(\hat\beta_m)}=\frac{C_1/\sigma}{\sqrt{\dfrac{\sum_{\mathcal R}(C_j/\sigma)^2}{\dim\mathcal R}}} . \] Condicionando en \(\boldsymbol X\) y con el Resultado 3: el numerador \(C_1/\sigma\) es \(N(0,1)\); el denominador es la raíz de una suma de \(\dim\mathcal R=n-k\) cuadrados de variables \(N(0,1)\) independientes, una \(\chi^2_{n-k}\), dividida por \(n-k\); y numerador y denominador son independientes, porque el primero es función de \(C_1\) y el segundo de las \(C_j\) de \(\mathcal R\), dos subfamilias disjuntas de una familia a escuadra. Es la definición de la \(t_{n-k}\): cociente de una \(N(0,1)\) y la raíz de una \(\chi^2_{n-k}/(n-k)\) independiente de ella. La distribución obtenida es la misma para cualquier valor de \(\boldsymbol X\), y por eso es también la distribución sin condicionar: la probabilidad de cada suceso \(\{T\le t\}\) se recupera por esperanzas iteradas de su sombra (sección 1.4), y la sombra es constante. Los grados de libertad son \(\dim\mathcal R\): las coordenadas del ruido que entran en el residuo.
Del contraste al intervalo. Sea \(t_c\) el valor que deja probabilidad \(\alpha/2\) en cada cola de la \(t_{n-k}\), y \(T\) el cociente anterior. El suceso \(\{|T|\le t_c\}\) es el suceso \(\{|\hat\beta_m-\beta_m\,\mathit1|\le t_c\,\mathrm{ee}(\hat\beta_m)\}\), y su probabilidad, condicionada a \(\boldsymbol X\) o no, es \(1-\alpha\). Despejado, es el intervalo de confianza de la lección 12, \(\hat\beta_m\pm t_c\,\mathrm{ee}(\hat\beta_m)\), y \(1-\alpha\) es su cobertura: la fracción de columnas de la matriz de copias en las que el intervalo contiene a \(\beta_m\), que la práctica C de la sesión 18 mide recorriendo columnas. El valor \(p\) de un contraste es \(\mathrm P(|t_{n-k}|\ge|t|)\), con \(t\) el valor observado: la probabilidad, bajo \(H_0\), de una columna con un cociente al menos tan grande como el de la columna que ocurrió.
Con un solo regresor (\(k=2\), \(\mathcal E=\mathcal L(\boldsymbol b_1)\)) el mismo cociente es el ángulo de la lección 12: \(\cos\theta\) es la fórmula \(c_1/\sqrt{\sum_{j=1}^{n-1}c_j^2}\) evaluada sobre la muestra, \(C_1\big/\sqrt{\sum_{j=1}^{n-1}C_j^2}\), y su distribución bajo \(H_0\) no depende de cuál sea la dirección de \(\boldsymbol b_1\), porque todas las \(C_j\) tienen la misma; solo depende de \(n-1\), el tamaño de la familia, y de ahí que el valor crítico dependa de \(n-k\).
10. La \(F\)
Bajo \(H_0\) (las \(q\) restricciones), \eqref{eq:sumas-va} da el numerador sin parte sistemática, y \eqref{eq:F-datos} evaluada sobre la muestra es \[ F=\frac{\sum_{\mathcal Q}(C_j/\sigma)^2\big/\dim\mathcal Q}{\sum_{\mathcal R}(C_j/\sigma)^2\big/\dim\mathcal R} . \] Numerador y denominador son sumas de cuadrados de dos subfamilias disjuntas (las \(C_j\) de \(\mathcal Q\) y las de \(\mathcal R\)) de una familia a escuadra de variables \(N(0,1)\): una \(\chi^2_q\) y una \(\chi^2_{n-k}\) independientes, divididas por sus grados de libertad. Es la definición de la \(F_{q,\,n-k}\), y de nuevo no depende de \(\boldsymbol X\). El \(F\) de significación conjunta es el caso \(\mathcal Q=\mathcal E\), \(q=k-1\). Si \(H_0\) es falsa, las coordenadas de \(\mathcal Q\) llevan sumadas las \(D_j\) de la parte sistemática (Resultado 2) y el numerador tiende a ser mayor: es la razón por la que valores grandes de \(F\) hablan contra \(H_0\).
Con \(q=1\) y \(H_0\colon\beta_m=0\), el subespacio restringido es el de los demás regresores en desviaciones y \(\mathcal Q=\mathcal L(\boldsymbol b_1)\), la dirección de la parte propia del segundo triángulo: el numerador es \((C_1/\sigma)^2\) y \(F\) es el cuadrado del cociente de la sección 9. Así \(F=t^2\) como identidad entre estadísticos (es \eqref{eq:F-datos} frente a \eqref{eq:t-datos} en \(\mathbb R^n\)), la \(F_{1,n-k}\) es la distribución del cuadrado de una \(t_{n-k}\), y los valores críticos cumplen \(F_c=t_c^2\): las dos reglas rechazan en los mismos casos (lección 13).
11. Las piezas y dónde opera cada una
| Pieza | Espacio | Qué usa | Qué da |
|---|---|---|---|
| Producto escalar \(\langle\cdot,\cdot\rangle_P\) por sus propiedades; esperanza como proyección; \(\mathrm P(A)=\langle\mathbb 1_A,\mathit1\rangle_P\) | v.a. | Lección 9 | Propiedades de la probabilidad; independencia = indicadoras centradas ortogonales; escuadra |
| Condicionar = proyectar sobre las funciones de \(X\), \eqref{eq:cond} | v.a. | Ortogonalidad del resto | Linealidad, Lema, esperanzas iteradas, varianza condicional; \(P[A\mid X]\); independencia = sombras constantes |
| Copias i.i.d. en \(\Omega=[0,1]\) (la moneda) | v.a. | Probabilidad = longitud | Infinitas copias idénticas e independientes en un mismo \(\Omega\); una construcción, no un supuesto |
| La matriz de copias | de las v.a. a \(\mathbb R^n\) | Nada | \(n\) filas = muestra; columna = \(\omega\); ambas = vector de \(\mathbb R^n\); datos = una columna; Monte Carlo = otras columnas |
| \(\mathcal L(\boldsymbol 1)^\perp=\mathcal E\oplus\mathcal R\) y base adaptada \eqref{eq:base} | \(\mathbb R^n\) | Regresores linealmente independientes | Identidades válidas para toda muestra; \(\dim\mathcal E=k-1\), \(\dim\mathcal R=n-k\) |
| Coordenadas \eqref{eq:coord}, Pitágoras \eqref{eq:pitagoras}, \eqref{eq:coord-nula} | \(\mathbb R^n\) | Ortonormalidad | \(\mathrm{SEC}\), \(\mathrm{SRC}\), \(\mathrm{SRC}_r-\mathrm{SRC}\) como sumas de coordenadas por subespacio |
| Parte propia, \eqref{eq:beta-coord}–\eqref{eq:t-datos} | \(\mathbb R^n\) | FWL (lección 14), \(\boldsymbol b_1\perp\boldsymbol 1\) | \(t\) = coordenada sobre \(\tilde{\boldsymbol x}_m\) / media cuadrática de las de \(\mathcal R\) |
| El puente | de \(\mathbb R^n\) a las v.a. | Solo identidades | \eqref{eq:base-va}, \(C_j\), \(D_j\), \eqref{eq:casos}, \eqref{eq:sumas-va}, \eqref{eq:beta-va} |
| Los tres supuestos de la lección 11 | v.a. | Modelo poblacional, escuadra entre copias, Lema | \(E[U_i\mid\boldsymbol X]=\mathit0\), \(E[U_i^2\mid\boldsymbol X]=\sigma^2\mathit1\), \(E[U_iU_{i'}\mid\boldsymbol X]=\mathit0\) |
| \(D_j=\mathit0\) en \(\mathcal R\) (y en \(\mathcal Q\) bajo \(H_0\)) | \(\mathbb R^n\), evaluado | \eqref{eq:coord-nula}; \(H_0\) para \(\mathcal Q\) | \(\mathrm{SRC}\) sin parte sistemática; numerador de \(F\) sin ella bajo \(H_0\) |
| Resultado 1: familia ortogonal | v.a. | Lema, \(E[U_i\mid\boldsymbol X]=\mathit0\), homocedasticidad, incorrelación | \(\langle C_j,C_l\rangle_P=\sigma^2\delta_{jl}\) |
| Resultado 2: esperanzas \eqref{eq:esperanzas} | v.a. | Resultado 1, Lema | Insesgadez de \(\mathfrak s^2\); \(F\) ronda \(1\) bajo \(H_0\) y crece fuera |
| Resultado 2 bis: Gauss–Markov, \eqref{eq:GM} | \(\mathbb R^n\), evaluado | Pitágoras, puente, Resultado 1 | \(\hat\beta_m\) de varianza mínima entre los lineales insesgados, sin normalidad |
| Propiedad de la normal | v.a. (vía densidad en \(\mathbb R^n\)) | Las \(U_i\) dadas \(\boldsymbol X\) a escuadra y con la misma \(N(0,\sigma^2)\) (supuesto de la lección 12 + copias independientes) | Resultado 3: las \(C_j\) a escuadra y con la misma \(N(0,\sigma^2)\); el giro conserva la escuadra |
| Subfamilias disjuntas | v.a. | Escuadra (sección 1.5) | Numerador y denominador independientes; \(t_{n-k}\), \(F_{q,n-k}\) |
| Fijar \(\omega\) | de las v.a. a \(\mathbb R^n\) | Nada | Cada estadístico toma el valor de su fórmula en el punto realizado; los datos observados son un \(\omega\) |
Demostrado con material del curso: todo lo de \(\mathbb R^n\), incluidas las tres identidades de las lecciones 12, 13 y 14 (la del \(t^2\) con los catetos, la del \(F\) con el \(R^2\) y la del factor de inflación de la varianza); las reglas del condicionamiento y las de la probabilidad a partir del producto escalar; los tres supuestos de la lección 11 a partir del modelo poblacional y el muestreo aleatorio; el puente; los Resultados 1, 2 y 2 bis (Gauss–Markov); y que, si la familia es a escuadra, los dos estadísticos tienen por definición las distribuciones \(t_{n-k}\) y \(F_{q,n-k}\). Enunciado sin demostrar: la existencia de la proyección sobre las funciones de \(X\) (y su unicidad salvo casi seguro); la caracterización de la independencia por funciones, y que la independencia de cada copia frente a las anteriores dé la de la familia; que toda función de \(\boldsymbol X\) se aproxime por combinaciones de productos \(a(X_i)b(X_{-i})\) (secciones 6.1 y 8); la construcción de copias de cualquier distribución; y la propiedad de la normal, con su razón en nota al pie. Es el único lugar donde el supuesto de normalidad trabaja, y por eso sin él la \(t_{n-k}\) y la \(F_{q,n-k}\) dejan de ser las distribuciones exactas de los estadísticos, mientras que el Resultado 2 (y con él la lectura ``\(F\) ronda \(1\) bajo \(H_0\)'') sigue en pie.
Y el retorno a los datos. Lo que la sección 5 garantiza para toda realización es lo que permite leer una tabla de resultados con las fórmulas de las lecciones 8, 10, 13 y 14 sin probabilidad alguna: \(\mathrm{STC}=\mathrm{SEC}+\mathrm{SRC}\), \(\hat\beta_m=\langle\tilde{\boldsymbol x}_m,\boldsymbol y\rangle_e/\Vert\tilde{\boldsymbol x}_m\Vert_e^2\), \(F=(\mathrm{SRC}_r-\mathrm{SRC})/q\big/\mathrm{SRC}/(n-k)\) son identidades en los números observados. Lo que las secciones 7 y 8 añaden es qué parte de esos números sería ruido si el modelo fuese cierto, y con qué distribución: la que se consulta en la tabla de la \(t_{n-k}\) o de la \(F_{q,n-k}\) para decidir si datos como estos serían raros bajo \(H_0\).
12. Mapa de las lecciones
Qué sección sostiene qué pasaje del curso. Las lecciones enuncian y leen; aquí está la demostración o la definición.
| Lección | Pasaje | Sección de este documento |
|---|---|---|
| 9 | Variable aleatoria como función; \(\langle X,Y\rangle_P\) y sus propiedades; semiproducto escalar | 1.1 |
| 9 | Las dos caras de la esperanza; la esperanza condicional como proyección; descomposición de la varianza | 1.2, 1.3 |
| 9 | «\(n\) copias idénticas e independientes»; los datos como realización | 2, 3 |
| 11 | El marco de la muestra aleatoria; estimador frente a estimación | 3, 4.2, 6.6 |
| 11 | «La misma fórmula, aplicada a variables aleatorias»; «Dos propiedades de los pesos» | 4.3 |
| 11 | Los tres supuestos condicionando en \(\boldsymbol X\) a partir del muestreo aleatorio | 6.1 |
| 11 | El Lema («lo que es función de \(\boldsymbol X\) sale fuera») y las esperanzas iteradas | 1.3 |
| 11 | Insesgadez y varianza de \(\hat\beta_2\); con \(k\) regresores, de cada \(\hat\beta_m\) | 6.5, 7.1 |
| 11 | \(\mathfrak s^2=\mathrm{SRC}/(n-k)\) insesgado; el sesgo de \(\mathrm{SRC}/n\); el divisor \(n-1\) de la varianza muestral | 7.2 |
| 11 | Gauss–Markov (MCO es BLUE) | 7.3 |
| 11 | Apéndice de la moneda; independencia como «a escuadra» | 2, 1.5 |
| 12 | Distribución condicionada; sombras constantes; probabilidad como esperanza de la indicadora | 1.4, 1.5 |
| 12 | «La normalidad hace el ruido isótropo» | 8 (Resultado 3) |
| 12 | La distribución de \(\hat\beta_m\) bajo normalidad; la \(t_{n-k}\); el intervalo de confianza y su cobertura; el valor \(p\); la distribución del ángulo | 9 |
| 12 | \(t^2=(n-k)\,\mathrm{SEC}/\mathrm{SRC}\) y \(t^2=(n-k)R^2/(1-R^2)\) | 5.4 |
| 12 | «Dos direcciones al azar son casi ortogonales» | 8 (corolario del \(R^2\)) |
| 13 | «El ruido reparte su longitud por igual entre las dimensiones»; \(F\) ronda \(1\) bajo \(H_0\) | 7 (Resultados 1 y 2) |
| 13 | El \(R^2\) que regala el azar, \((k-1)/(n-1)\) | 8 (corolario) |
| 13 | Pitágoras anidado; \(F=\frac{n-k}{k-1}\frac{R^2}{1-R^2}\); la \(F_{q,n-k}\) de \(q\) restricciones; \(F=t^2\) y \(F_c=t_c^2\) | 5.5, 10 |
| 14 | Parte propia; \(\Vert\tilde{\boldsymbol x}_j\Vert_e^2=\Vert\boldsymbol x_j-\boldsymbol{\mathop{\overline x}}_j\Vert_e^2(1-R_j^2)\) y el VIF; \(\hat\beta_j\) como coeficiente sobre la parte propia (Frisch–Waugh–Lovell); \(\mathrm{ee}(\hat\beta_j)=\mathfrak s/\Vert\tilde{\boldsymbol x}_j\Vert_e\); insesgadez y varianza de cada \(\hat\beta_j\) | 5.4, 6.5, 7.1 |
| S14-D | Ortogonalizar: la base adaptada | 5.2 |
| S16-A, S18-C, S21-C, S22-A | Monte Carlo: recorrer columnas de la matriz de copias; la cobertura del intervalo | 3, 9 |
| S16-C | Perturbaciones no normales: qué se conserva y qué no | 7, 8 |
13. Notación
| Símbolo | Significado |
|---|---|
| \(\boldsymbol y\), \(\boldsymbol x_j\), \(\boldsymbol u\), \(\boldsymbol b_j\) | Vectores de datos, en \(\mathbb R^n\) (negrita minúscula) |
| \(\boldsymbol{\mathsf X}\) | Matriz de datos de los regresores (lección 10) |
| \(Y_i\), \(U_i\), \(X_{ij}\), \(C_j\), \(\hat\beta_m\) | Variables aleatorias (mayúscula): funciones sobre \(\Omega\) |
| \(\boldsymbol X\) | La muestra aleatoria de regresores: la lista de las \(n\) copias (lección 11); no es un vector de \(\mathbb R^n\) |
| \(\mathit1\), \(\mathit0\) | Las variables aleatorias constantes \(1\) y \(0\) |
| \(\mathbb 1_A\) | La indicadora del suceso \(A\) |
| \(\langle\cdot,\cdot\rangle_e\), \(\Vert\cdot\Vert_e\) | Producto escalar euclídeo y norma en \(\mathbb R^n\) (lección 2) |
| \(\langle\cdot,\cdot\rangle_s=\frac1n\langle\cdot,\cdot\rangle_e\) | Producto escalar estadístico (lección 4); \(\langle\cdot,\cdot\rangle_{n-k}\), el de la cuasivarianza (lección 11) |
| \(\langle Z,W\rangle_P=\mathrm E(ZW)\), \(\Vert Z\Vert_P\) | Producto escalar y norma de las variables aleatorias (lección 9) |
| \(\mathrm E(Z)\) | Valor esperado: un número, \(\langle Z,\mathit1\rangle_P\) |
| \(E[Z\mid X]\), \(Var[Z\mid X]\), \(P[A\mid X]\) | Esperanza, varianza y probabilidad condicionales: variables aleatorias, proyecciones sobre las funciones de \(X\) |
| \(\mathcal L(\cdot)\) | Subespacio generado por los vectores indicados; \(\mathcal L(\boldsymbol 1)^\perp\), los vectores de media cero |
| \(\mathcal E\), \(\mathcal R\) | Subespacio de los regresores en desviaciones y su complemento ortogonal en \(\mathcal L(\boldsymbol 1)^\perp\) (sección 5.1) |
| \(\mathcal E_r\), \(\mathcal Q\) | Subespacio del modelo restringido y las \(q\) direcciones suprimidas (sección 5.5) |
| \(\sum_{\mathcal E}\), \(\sum_{\mathcal R}\), \(\sum_{\mathcal Q}\) | Suma sobre los vectores de la base que están en ese subespacio |
| \(\tilde{\boldsymbol x}_m\), \(L_m\) | Parte propia del regresor \(m\) (lección 14) y su longitud evaluada sobre la muestra |
| \(c_j\), \(C_j\), \(D_j\) | Coordenada \(j\)-ésima de un vector de datos; coordenada del ruido y de la parte sistemática, evaluadas sobre la muestra |
| \(S_i\), \(\boldsymbol s\) | Parte sistemática en desviaciones: componente \(i\)-ésima, y su realización |
| \(i\), \(i'\); \(j\), \(l\); \(m\) | Índices de observación; de vectores de la base; del regresor contrastado |
Notas al pie de página:
La relación entre un espacio euclídeo y uno semieuclídeo, y lo que comparten, es un asunto aparte que este documento no aborda: aquí los dos mundos se mantienen separados a propósito.
Solo para uniones finitas, que es lo que este documento necesita. La aditividad para uniones infinitas es otro axioma, y no se trata aquí.
Para profundizar: Williams, D. (1991), Probability with Martingales, cap. 4; Wooldridge, J. M. (2020), apéndice B.1. En lo que sigue, las perturbaciones normales del modelo no se construyen: sus propiedades se enuncian donde hacen falta.
Con la salvedad de la lección 11: la construcción de la base exige regresores linealmente independientes, y las identidades valen en el suceso en que la base está definida, igual que los pesos \(W_i\) exigen \(\sum_{i=1}^n(X_i-\overline X)^2\neq\mathit0\).
Una restricción no homogénea, como \(\beta_2+\beta_3=1\), se reduce a este caso restando de \(\boldsymbol y\) la parte conocida, como hace la lección 13 con el ajuste restringido.
El paso de ``cada \(U_i\) independiente de \(X_i\), y las copias independientes entre sí'' a ``la familia \((U_1,\ldots,U_n)\) independiente y a escuadra con \(\boldsymbol X\)'' es del mismo tipo que el de la sección 6.1, y se admite igual.
La razón, para quien quiera verla: la densidad conjunta de \(n\) normales independientes de media cero y varianza \(\sigma^2\), como función sobre \(\mathbb R^n\), es \((2\pi\sigma^2)^{-n/2}e^{-\Vert\boldsymbol u\Vert_e^2/2\sigma^2}\), y depende del punto solo por su longitud euclídea. Las identidades \eqref{eq:base} dicen que pasar de \(\boldsymbol u\) a sus coordenadas en la base (completada con \(\boldsymbol 1/\sqrt n\)) es un giro de ejes, que conserva longitudes y volúmenes; la densidad de las coordenadas es por tanto la misma función, que se factoriza en un producto de densidades normales, una por coordenada. Y una densidad conjunta que es producto de marginales es la de variables independientes. Sin normalidad el argumento falla: la densidad de \(n\) uniformes independientes, por ejemplo, no depende solo de la longitud (llena un cubo), y las coordenadas en una base girada no son independientes.