Sesión 14 (C) — La importancia del R² ajustado
Índice
- Descripción de la práctica
- Actividad 1 - Los datos
- Actividad 2 - Modelo 1: la recta
- Actividad 3 - Modelo 2: la parábola
- Actividad 4 - Modelo 3: la cúbica
- Actividad 5 - Los tres modelos, uno al lado del otro
- Actividad 6 - Extrapolar los tres modelos
- Actividad 7 - Una variable explicativa, tres regresores
- Preguntas de interpretación para la clase
- Código completo de la práctica
- Respuestas
Descripción de la práctica
Las prácticas A y B de esta sesión mostraron que añadir un regresor nunca empeora el \(R^2\), y que el \(R^2\) ajustado corrige ese defecto penalizando la complejidad. Podría pensarse, entonces, que basta con elegir el \(\bar R^2\) más alto para encontrar ``el mejor modelo''. Veámoslo con un conjunto de datos (posiblemente ficticios) minúsculo: el peso y la edad de 8 niños. Ajustaremos tres modelos alternativos.
Objetivo
- Ajustar tres modelos polinómicos anidados (grado 1, 2 y 3) sobre la misma variable explicativa, edad.
- Comparar los modelos en función del ajuste medido por \(\bar R^2\).
- Extrapolar los modelos más allá del rango muestral para observar las predicciones.
- Distinguir con precisión variable explicativa (la edad) de regresores (edad, edad al cuadrado, edad al cubo): tres regresores distintos al servicio de una sola variable explicativa.
- Comparar la elección de modelo que sugiere \(\bar R^2\) con la que sugiere extrapolar fuera de la muestra.
Comandos nuevos de esta práctica. Además de nulldata, setobs, setinfo, print --byobs, ols, gnuplot y los accesores $coeff, $rsq, $nobs y $ncoeff (sesión 11 y prácticas A y B de hoy), aparecen:
matrix medad = {7;7;8;...}- una matriz escrita a mano. El punto y coma separa filas, así que esto es un vector columna de 8 números (práctica A de la sesión 11).
series edad = medadcopia sus componentes en una serie. edad^2- eleva al cuadrado cada componente (sesión 7).
gnuplot ... --fit=quadratic- en lugar de la recta, superpone a la nube el ajuste de una parábola;
--fit=cubic, el de una cúbica. loop e=13..20- repite el bloque hasta
endloopconetomando los valores enteros de 13 a 20 (sesión 11; la mecánica del bucle se explica en la sesión 16).
Actividad 1 - Los datos
Introducimos a mano los datos de peso (kg) y edad (años) de los 8 niños.
Conjunto vacío de 8 observaciones de sección cruzada. Las dos matrices contienen, escritas a mano, las edades y los pesos; las dos series las convierten en variables del conjunto de datos; setinfo las etiqueta y print --byobs las muestra en una tabla con una fila por niño.
en línea de comandos:
nulldata 8 --preserve
setobs 1 1 --cross-section

matrix medad = {7;7;8;10;10;11;12;14}
matrix mpeso = {39;40;42;49;51;54;56;58}
series edad = medad
series peso = mpeso

setinfo peso -d "Peso (kg)" -n "Peso (kg)"
setinfo edad -d "Edad (anios)" -n "Edad (anios)"

print edad peso --byobs
          edad         peso

1            7           39
2            7           40
3            8           42
4           10           49
5           10           51
6           11           54
7           12           56
8           14           58
Con solo 8 observaciones, este ejemplo no pretende describir el crecimiento infantil: es, deliberadamente, un caso de laboratorio para poner a prueba nuestra confianza en \(R^2\) y \(\bar R^2\).
Actividad 2 - Modelo 1: la recta
ols estima la recta y gnuplot la dibuja sobre la nube de puntos, guardando el gráfico en un fichero con --output.
en línea de comandos:
ols peso const edad
Modelo 1: MCO, usando las observaciones 1-8
Variable dependiente: peso

             coeficiente   Desv. típica   Estadístico t   valor p
  ----------------------------------------------------------------
  const       19,6910        2,81320          6,999       0,0004   ***
  edad         2,93003       0,277361        10,56        4,23e-05 ***

Media de la vble. dep.  48,62500   D.T. de la vble. dep.   7,443837
Suma de cuad. residuos  19,79009   D.T. de la regresión    1,816135
R-cuadrado              0,948978   R-cuadrado corregido    0,940475
F(1, 6)                 111,5968   Valor p (de F)          0,000042
Log-verosimilitud      -14,97447   Criterio de Akaike      33,94893
Criterio de Schwarz     34,10782   Crit. de Hannan-Quinn   32,87733
gnuplot peso edad --output="peso_edad_lineal.png"
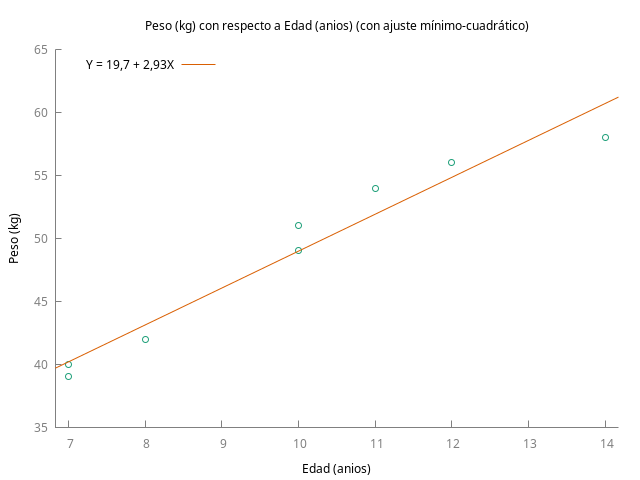
Anote \(R^2\) y \(\bar R^2\) de este primer modelo.
Actividad 3 - Modelo 2: la parábola
Añadimos edad al cuadrado como segundo regresor.
series edad2 = edad^2 crea el regresor nuevo elevando al cuadrado cada edad. ols lo añade a la lista, y gnuplot con --fit=quadratic superpone a la nube el ajuste de una parábola en lugar de la recta.
en línea de comandos:
series edad2 = edad^2
ols peso const edad edad2
Modelo 2: MCO, usando las observaciones 1-8
Variable dependiente: peso

             coeficiente   Desv. típica   Estadístico t   valor p
  ---------------------------------------------------------------
  const       -5,11497      7,70083          -0,6642      0,5360
  edad         8,06835      1,56383           5,159       0,0036  ***
  edad2       -0,252102     0,0762703        -3,305       0,0213  **

Media de la vble. dep.  48,62500   D.T. de la vble. dep.   7,443837
Suma de cuad. residuos  6,213342   D.T. de la regresión    1,114750
R-cuadrado              0,983981   R-cuadrado corregido    0,977573
F(2, 5)                 153,5654   Valor p (de F)          0,000032
Log-verosimilitud      -10,34054   Criterio de Akaike      26,68108
Criterio de Schwarz     26,91940   Crit. de Hannan-Quinn   25,07367
gnuplot peso edad --fit=quadratic --output="peso_edad_cuadratico.png"
(Si su versión de Gretl no admite la opción --fit=quadratic en gnuplot, genere el gráfico desde el menú Gráfico X-Y y seleccione, en el diálogo, un ajuste cuadrático.)
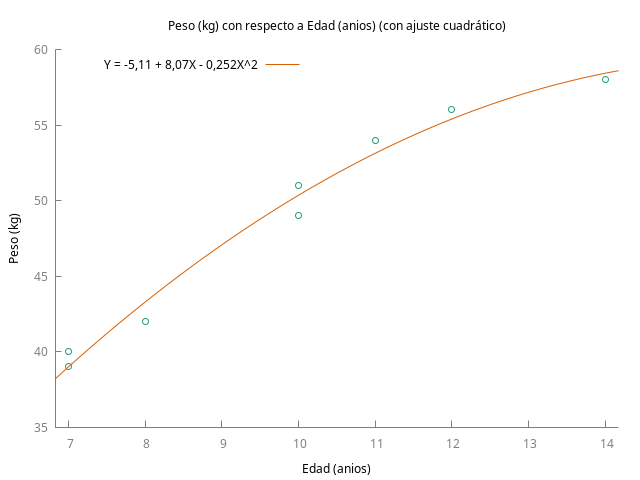
Compare \(R^2\) y \(\bar R^2\) con los del Modelo 1. ¿Tiene sentido la comparación mirando ambos estadísticos? ¿O realmente solo es lícito comparar el ajuste con uno de ellos? ¿Con cuál?
Actividad 4 - Modelo 3: la cúbica
Añadimos, además, edad al cubo.
Igual que en la Actividad 3: edad^3 es el tercer regresor y --fit=cubic dibuja la cúbica ajustada.
en línea de comandos:
series edad3 = edad^3
ols peso const edad edad2 edad3
Modelo 3: MCO, usando las observaciones 1-8
Variable dependiente: peso

             coeficiente   Desv. típica   Estadístico t   valor p
  ---------------------------------------------------------------
  const       81,7714       42,9543           1,904       0,1297
  edad       -18,5964       13,1093          -1,419       0,2290
  edad2        2,37778       1,28868          1,845       0,1388
  edad3       -0,0836541     0,0409478       -2,043       0,1106

Media de la vble. dep.  48,62500   D.T. de la vble. dep.   7,443837
Suma de cuad. residuos  3,040678   D.T. de la regresión    0,871877
R-cuadrado              0,992161   R-cuadrado corregido    0,986281
F(3, 4)                 168,7493   Valor p (de F)          0,000115
Log-verosimilitud      -7,482065   Criterio de Akaike      22,96413
Criterio de Schwarz     23,28190   Crit. de Hannan-Quinn   20,82092

Sin considerar la constante, el valor p más alto fue el de la variable 2 (edad)
gnuplot peso edad --fit=cubic --output="peso_edad_cubico.png"
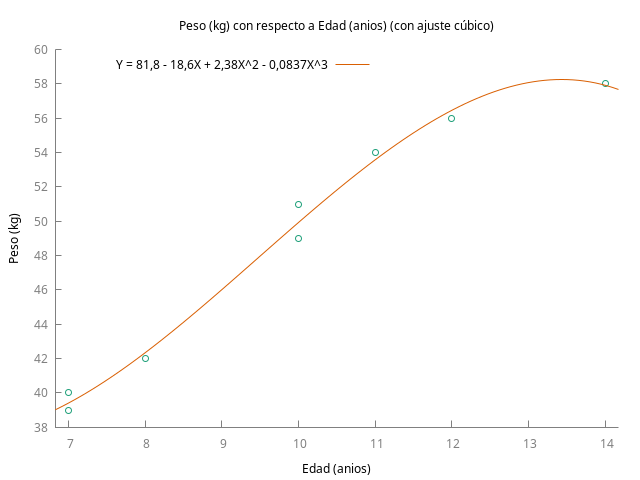
Antes de continuar: mire con atención el tramo final de esta última curva, hacia las edades más altas de la muestra (13-14 años). ¿Ve algo que le llame la atención?
Actividad 5 - Los tres modelos, uno al lado del otro
Tres ols con --quiet; tras cada uno, un escalar con \(\bar R^2\) calculado como en la práctica B (actividad 5 (html)) ($rsq, $nobs, $ncoeff) y un printf con los dos índices.
en línea de comandos:
ols peso const edad --quiet
scalar Rbarsq1 = 1 - (1-$rsq)*($nobs-1)/($nobs-$ncoeff)
printf "Modelo 1 (recta):    R2 = %.4f   R2 ajustado = %.4f\n", $rsq, Rbarsq1

ols peso const edad edad2 --quiet
scalar Rbarsq2 = 1 - (1-$rsq)*($nobs-1)/($nobs-$ncoeff)
printf "Modelo 2 (parabola): R2 = %.4f   R2 ajustado = %.4f\n", $rsq, Rbarsq2

ols peso const edad edad2 edad3 --quiet
scalar Rbarsq3 = 1 - (1-$rsq)*($nobs-1)/($nobs-$ncoeff)
printf "Modelo 3 (cubica):   R2 = %.4f   R2 ajustado = %.4f\n", $rsq, Rbarsq3
Modelo 1 (recta):    R2 = 0,9490   R2 ajustado = 0,9405
Modelo 2 (parabola): R2 = 0,9840   R2 ajustado = 0,9776
Modelo 3 (cubica):   R2 = 0,9922   R2 ajustado = 0,9863
Tanto \(R^2\) como \(\bar R^2\) crecen sin excepción del Modelo 1 al Modelo 3. Si solo consideráramos esta tabla, la conclusión sería inmediata: ``el Modelo 3 es el mejor''. La Actividad 6 pone a prueba esa conclusión.
Actividad 6 - Extrapolar los tres modelos
Vamos a predecir el peso a edades fuera del rango observado (7 a 14 años). Y lo haremos con los tres modelos a la vez, no solo con el ``ganador'': si extrapoláramos únicamente el Modelo 3 podríamos formarnos una idea equivocada sobre los otros dos. Además, llegaremos hasta los 20 años, porque el problema que buscamos no aparece al mismo tiempo en todos.
El bloque tiene tres partes. Primero estima los tres modelos con --quiet y guarda sus coeficientes en escalares con $coeff(nombre): cuatro para la cúbica (b1 a b4), dos para la recta (r1, r2) y tres para la parábola (p1 a p3). Después imprime una cabecera y, con loop e=13..20, una fila por edad de 13 a 20 años: en cada vuelta e es la edad y los tres números son los tres polinomios evaluados en ella (%3d es un entero en tres caracteres; la barra invertida \ continúa la instrucción en la línea siguiente). Por último imprime la edad en la que cada modelo alcanza su máximo, que se obtiene anulando la derivada: \(-p_2/(2p_3)\) para la parábola y la raíz de una ecuación de segundo grado para la cúbica.
en línea de comandos:
ols peso const edad edad2 edad3 --quiet
scalar b1 = $coeff(const)
scalar b2 = $coeff(edad)
scalar b3 = $coeff(edad2)
scalar b4 = $coeff(edad3)

ols peso const edad --quiet
scalar r1 = $coeff(const)
scalar r2 = $coeff(edad)

ols peso const edad edad2 --quiet
scalar p1 = $coeff(const)
scalar p2 = $coeff(edad)
scalar p3 = $coeff(edad2)

printf "edad    Modelo 1     Modelo 2     Modelo 3\n"
printf "        (recta)     (parabola)    (cubica)\n"
printf "--------------------------------------------\n"
loop e=13..20 --quiet
    printf "%3d   %9.2f    %9.2f   %9.2f\n", e, \
           r1 + r2*e, \
           p1 + p2*e + p3*e^2, \
           b1 + b2*e + b3*e^2 + b4*e^3
endloop

printf "\nEdad a la que cada modelo alcanza su maximo:\n"
printf "  Modelo 1 (recta)    : nunca, siempre crece\n"
printf "  Modelo 2 (parabola) : %.1f anios\n", -p2/(2*p3)
printf "  Modelo 3 (cubica)   : %.1f anios\n", (-2*b3 - sqrt(4*b3^2 - 12*b2*b4))/(6*b4)
edad    Modelo 1     Modelo 2     Modelo 3
        (recta)     (parabola)    (cubica)
--------------------------------------------
 13       57,78        57,17       58,08
 14       60,71        58,43       57,92
 15       63,64        59,19       55,49
 16       66,57        59,44       50,29
 17       69,50        59,19       41,82
 18       72,43        58,43       29,57
 19       75,36        57,17       13,04
 20       78,29        55,41       -8,28

Edad a la que cada modelo alcanza su maximo:
  Modelo 1 (recta)    : nunca, siempre crece
  Modelo 2 (parabola) : 16,0 anios
  Modelo 3 (cubica)   : 13,4 anios
La tabla se lee de izquierda a derecha.
El Modelo 3, el de mayor \(R^2\) y mayor \(\bar R^2\) de los tres, da predicciones inaceptables enseguida: a los 15 años predice \(55{,}49\) kg, a los 17 baja a \(41{,}82\), y a los 20 da un peso negativo. Ningún estadístico de bondad de ajuste refleja este comportamiento.
La columna de en medio muestra algo más. El Modelo 2, la parábola, tiene el mismo defecto: su máximo está en los \(16{,}0\) años, y a partir de ahí también predice pérdida de peso (\(59{,}44\) kg a los 16, \(58{,}43\) a los 18, \(55{,}41\) a los 20). Lo que ocurre es que lo hace más tarde y más despacio, de modo que si solo hubiéramos extrapolado a 15, 16 y 17 años, como sería natural hacer, la parábola habría parecido adecuada.
Y el Modelo 1, la recta, es el único que no tiene máximo. También es el de menor \(\bar R^2\) de los tres.
Ordenando los tres puntos de giro:
| modelo | máximo | \(\bar R^2\) |
|---|---|---|
| recta (grado 1) | nunca | el más bajo |
| parábola (grado 2) | 16,0 años | intermedio |
| cúbica (grado 3) | 13,4 años | el más alto |
Cuanto mayor es el grado, y mayor el \(\bar R^2\), antes aparece la predicción absurda. Esa es la conclusión de la práctica: aquí el orden de los modelos según \(\bar R^2\) es el orden inverso de su credibilidad.
De hecho, para descartar el Modelo 3 ni siquiera hace falta salir de la muestra: su máximo (13,4 años) cae dentro del rango de edades observado, que llega hasta los 14. El descenso dentro de la muestra es pequeño (de \(58{,}08\) kg a los 13 a \(57{,}92\) a los 14, apenas 0,16 kg) y por eso en el gráfico de la Actividad 4 se aprecia como un aplanamiento más que como una caída; pero existe y carece de fundamento.
Actividad 7 - Una variable explicativa, tres regresores
En los tres modelos de esta práctica hay una única variable explicativa: la edad. Sin embargo, el número de regresores crece de uno (Modelo 1: edad) a tres (Modelo 3: edad, edad2, edad3). Recordando la distinción de la lección 6: un regresor es cada vector que multiplica a un coeficiente \(\hat\beta_j\) del modelo; una variable explicativa es el concepto económico o sustantivo que puede entrar en el modelo a través de uno o varios regresores a la vez: aquí, la propia edad y sus potencias, todas ellas funciones de la misma variable explicativa original.
Preguntas de interpretación para la clase
- ¿Por qué \(R^2\) y \(\bar R^2\) crecen sin excepción del Modelo 1 al Modelo 3, si ya sabemos (lección 8, y prácticas A y B de esta sesión) que \(R^2\) nunca puede bajar al añadir un regresor?
- Si tuviera que elegir uno de los tres modelos únicamente en función de \(\bar R^2\), ¿cuál elegiría? ¿Sigue eligiendo el mismo tras ver la Actividad 6?
- ¿Qué le dice este ejercicio sobre la costumbre de comparar modelos solo mirando una tabla de estadísticos, sin generar ningún gráfico?
- ¿Por qué edad, edad² y edad³ cuentan como tres regresores distintos, si los tres provienen de una única variable medida (la edad)?
- ¿Diría que este problema (predicciones absurdas fuera del rango muestral) es exclusivo de los polinomios, o podría aparecer con cualquier modelo, lineal o no, si se extrapola lo suficiente fuera del rango de los datos con que fue estimado?
Para profundizar:
- Véanse las lecciones 8 y 10 (lección 8, lección 10) para la advertencia general sobre qué certifica (y qué no) un buen ajuste, y para la distinción entre regresor y variable explicativa.
- Wooldridge, J. M. (2020). Introductory Econometrics, cap. 6, sección 6.2 (formas funcionales polinómicas y sus límites).
Código completo de la práctica
| Enlace al guión: | S14-Prct-C-peso-edad.inp |
Respuestas
- ¿Por qué crecen \(R^2\) y \(\bar R^2\) sin excepción aquí, si \(\bar R^2\) en general puede bajar? La propiedad de la lección 8 (``\(R^2\) nunca baja'') es universal: se cumple siempre. La de \(\bar R^2\) (``puede bajar'') es solo una posibilidad, no una certeza: baja únicamente cuando el regresor añadido aporta muy poco a la reducción de SRC. En este ejemplo concreto, con solo 8 observaciones y una relación no lineal genuina entre peso y edad, cada potencia adicional de la edad reduce sustancialmente los residuos, lo suficiente como para que también \(\bar R^2\) suba. Que \(\bar R^2\) suba aquí no contradice que en otros casos (como ocurrió con
radialen la práctica B de esta sesión, actividad 5 (html)) pueda bajar: ambos comportamientos son compatibles con la misma fórmula. - ¿Qué modelo elegiría solo con \(\bar R^2\), y después de la Actividad 6? Mirando únicamente la tabla de la Actividad 5, la elección ``mecánica'' sería el Modelo 3, por tener el \(\bar R^2\) más alto. Sin embargo, tras la Actividad 6, esa elección se revela problemática: un modelo que predice pérdida de peso con la edad, para niños en pleno crecimiento, no es creíble. Ahora bien, la Actividad 6 muestra algo más grave que eso: el Modelo 2 tampoco es aceptable. Su parábola también gira, a los 16,0 años, y también predice pérdida de peso a partir de ahí; solo lo hace más tarde que la cúbica, lo suficiente para pasar inadvertido si se extrapola poco. El único de los tres sin punto de giro es el Modelo 1, que es precisamente el de menor \(\bar R^2\). Dicho de otro modo: en este ejemplo, el orden de los modelos según \(\bar R^2\) es el orden inverso de su credibilidad, y la elección razonable, la recta, es la que el criterio mecánico coloca en último lugar.
- Lección sobre comparar solo con estadísticos, sin gráficos. Este ejercicio ilustra, con un caso extremo pero claro, por qué ningún estadístico de resumen (ni \(R^2\), ni \(\bar R^2\), ni ningún otro número aislado) puede sustituir a la inspección visual del ajuste. Los números pueden mejorar de forma monótona mientras el modelo se vuelve, al mismo tiempo, cada vez menos razonable; solo el gráfico (o, como aquí, poner a prueba el modelo fuera de la muestra) revela ese deterioro cualitativo que ningún estadístico agregado captura por sí solo.
- ¿Por qué edad, edad² y edad³ son tres regresores distintos de una sola variable? Porque un regresor, en el sentido técnico fijado en la lección 6, es cada vector concreto que multiplica a un coeficiente en la combinación lineal ajustada; edad, edad² y edad³ son tres vectores distintos de \(\mathbb{R}^8\) (no son proporcionales entre sí), así que cuentan como tres regresores independientes a efectos del cálculo de \(\boldsymbol{\mathop{\widehat{\beta}}}\), aunque los tres se calculen a partir de una sola magnitud medida (la edad) y respondan, en conjunto, a una única pregunta sustantiva: ``¿cómo varía el peso con la edad?''.
- ¿Es esto exclusivo de los polinomios? No: cualquier modelo, lineal o no en sus parámetros, puede producir predicciones absurdas si se extrapola suficientemente lejos del rango de datos con el que fue estimado. Los polinomios de grado alto son especialmente propensos a este problema porque su comportamiento fuera del rango muestral puede cambiar de forma muy brusca (curvaturas que crecen rápidamente hacia arriba o hacia abajo), pero el principio general, ``un modelo ajustado a un rango de datos no garantiza nada fuera de ese rango'', es válido para cualquier forma funcional, lineal o logarítmica incluida. Tampoco es exclusivo de modelos poco razonables; un modelo adecuado a un rango muestral, puede funcionar de manera insatisfactoria fuera del rango en el que se estimó. Por otra parte, la extrapolación a valores irreales tampoco tiene sentido (por ejemplo, piense si tiene sentido interpretar el valor estimado para la constante en el modelo del precio de la vivienda de la práctica A de hoy, actividad 2 (html))… sería lo mismo que preguntarse qué precio tiene una vivienda cuya superficie es cero).