Lección 7. Estimación MCO sin matrices: dos ortogonalidades, dos coeficientes
Author: Marcos Bujosa
Hoy resolvemos el sistema de dos ortogonalidades planteado en la lección anterior: de él surgen las fórmulas de $\hat\beta_2$ y $\hat\beta_1$. La pendiente resulta ser la covarianza dividida por la varianza —o, equivalentemente, la correlación reescalada—. Por ahora sin matrices de por medio.
``Imponer perpendicularidad, dos veces, y despejar: así nace la recta de mínimos cuadrados.''
De dónde venimos: un plano, un problema sin resolver
En la lección 6 planteamos la regresión simple como una proyección sobre el plano de todas las combinaciones lineales de $\boldsymbol{1}$ y $\boldsymbol{x}$, es decir, sobre $\mathcal{L}(\boldsymbol{1},\boldsymbol{x})$: $$ \boldsymbol{y} \quad=\quad \hat\beta_1\boldsymbol{1} + \hat\beta_2\boldsymbol{x} + \boldsymbol{\mathop{\widehat{e}}} \quad=\quad \boldsymbol{\mathop{\widehat{y}}} + \boldsymbol{\mathop{\widehat{e}}}. $$
- $\boldsymbol{\mathop{\widehat{e}}}$ debe ser ortogonal a todo el plano.
- Eso equivale a ser ortogonal a cada uno de sus generadores:
En la lección 6 nos quedamos ahí: dos condiciones, ningún coeficiente despejado.
Hoy resolvemos ese sistema. Sin matrices: dos ecuaciones, dos incógnitas ($\hat\beta_1$, $\hat\beta_2$).
Primera condición: el residuo tiene media cero
Recordemos: $\quad\boldsymbol{\mathop{\widehat{e}}}\quad=\quad\boldsymbol{y}-\boldsymbol{\mathop{\widehat{y}}}\quad=\quad\boldsymbol{y}-\hat\beta_1 \boldsymbol{1}-\hat\beta_2\boldsymbol{x}$.
De la primera condición, $\langle\boldsymbol{\mathop{\widehat{e}}} , \boldsymbol{1}\rangle_s=0$: $$ \langle\boldsymbol{\mathop{\widehat{e}}} , \boldsymbol{1}\rangle_s \;=\; \Big\langle\big(\boldsymbol{y}-\hat\beta_1\boldsymbol{1}-\hat\beta_2\boldsymbol{x}\big) , \boldsymbol{1}\Big\rangle_s \;=\; \mu_{\boldsymbol{y}} - \hat\beta_1 - \hat\beta_2\mu_{\boldsymbol{x}} \;=\; 0. $$
Despejando $$ \boxed{\hat\beta_1 = \mu_{\boldsymbol{y}} - \hat\beta_2\mu_{\boldsymbol{x}}.} $$
El intercepto (la constante) es función de la pendiente (aún falta una ecuación más).
Segunda condición: el residuo ortogonal a $\boldsymbol{x}$
De la segunda condición, $\langle\boldsymbol{\mathop{\widehat{e}}} , \boldsymbol{x}\rangle_s=0$: $$ \langle\boldsymbol{\mathop{\widehat{e}}} , \boldsymbol{x}\rangle_s \;=\; \Big\langle\big(\boldsymbol{y}-\hat\beta_1\boldsymbol{1}-\hat\beta_2\boldsymbol{x}\big) , \boldsymbol{x}\Big\rangle_s \;=\; \langle\boldsymbol{y},\boldsymbol{x}\rangle_s - \hat\beta_1\,\mu_{\boldsymbol{x}} - \hat\beta_2\,\mu_{\boldsymbol{x}^2} \;=\; 0. $$
Sustituyendo $\hat\beta_1=\mu_{\boldsymbol{y}}-\hat\beta_2\mu_{\boldsymbol{x}}$ (transparencia anterior) y agrupando: $$ \langle\boldsymbol{y},\boldsymbol{x}\rangle_s - \mu_{\boldsymbol{x}}\mu_{\boldsymbol{y}} \;=\; \hat\beta_2\big(\mu_{\boldsymbol{x}^2}-\mu_{\boldsymbol{x}}^2\big). $$
Como $\langle\boldsymbol{x},\boldsymbol{y}\rangle_s=\mu_{\boldsymbol{x}\odot\boldsymbol{y}}$ (media del producto componente a componente): $$ \underbrace{\mu_{\boldsymbol{x}\odot\boldsymbol{y}} - \mu_{\boldsymbol{x}}\mu_{\boldsymbol{y}}}_{\sigma_{\boldsymbol{x}\boldsymbol{y}}} \;=\; \hat\beta_2\big(\underbrace{\mu_{\boldsymbol{x}^2}-\mu_{\boldsymbol{x}}^2}_{\sigma_{\boldsymbol{x}}^2}\big); $$
donde aparecen las ``fórmulas de cálculo'' de covarianza y varianza. Así: $$ \boxed{\sigma_{\boldsymbol{x}\boldsymbol{y}} = \hat\beta_2\,\sigma_{\boldsymbol{x}}^2.} $$
$\hat\beta_2$: covarianza sobre varianza
Despejando de $\sigma_{\boldsymbol{x}\boldsymbol{y}} = \hat\beta_2\,\sigma_{\boldsymbol{x}}^2$: $$ \boxed{\;\hat\beta_2 \;=\; \frac{\sigma_{\boldsymbol{x}\boldsymbol{y}}}{\sigma_{\boldsymbol{x}}^2}\;.} $$
Y recordando $\rho_{\boldsymbol{x}\boldsymbol{y}}=\dfrac{\sigma_{\boldsymbol{x}\boldsymbol{y}}}{\sigma_{\boldsymbol{x}}\sigma_{\boldsymbol{y}}}$ (lección 5): $$ \hat\beta_2 \;=\; \rho_{\boldsymbol{x}\boldsymbol{y}}\frac{\sigma_{\boldsymbol{y}}}{\sigma_{\boldsymbol{x}}}. $$
La pendiente MCO es la correlación, reescalada por el ratio de las desviaciones típicas: su signo es el de $\rho_{\boldsymbol{x}\boldsymbol{y}}$.
Vía alternativa: generadores ortogonales
Recordemos (lección 6): $\mathcal{L}(\boldsymbol{1},\boldsymbol{x}) = \mathcal{L}\big(\boldsymbol{1},\,\boldsymbol{x}-\mu_{\boldsymbol{x}}\boldsymbol{1}\big)$.
Y ahora sí: $\boldsymbol{1}\perp(\boldsymbol{x}-\mu_{\boldsymbol{x}}\boldsymbol{1})$, porque $\Big\langle(\boldsymbol{x}-\mu_{\boldsymbol{x}}\boldsymbol{1})\,,\,\boldsymbol{1}\Big\rangle_s = \mu_{\boldsymbol{x}} - \mu_{\boldsymbol{x}} = 0$.
Con generadores ortogonales, la proyección se descompone en dos componentes ortogonales, uno por generador; cada coeficiente es la razón que resulta de proyectar sobre esa dirección por separado (Cauchy–Schwarz, lección 3: $\alpha=\frac{\langle\boldsymbol{a},\boldsymbol{b}\rangle}{\langle\boldsymbol{a},\boldsymbol{a}\rangle}=\frac{\langle\boldsymbol{a},\boldsymbol{b}\rangle}{\|\boldsymbol{a}\|^2}$): $$ c_1 = \frac{\langle\boldsymbol{y} \,,\, \boldsymbol{1}\rangle_s}{\|\boldsymbol{1}\|_s^2} = \mu_{\boldsymbol{y}}, \qquad c_2 = \frac{\Big\langle\boldsymbol{y} , (\boldsymbol{x}-\mu_{\boldsymbol{x}}\boldsymbol{1})\Big\rangle_s}{\|\boldsymbol{x}-\mu_{\boldsymbol{x}}\boldsymbol{1}\|_s^2} = \frac{\sigma_{\boldsymbol{x}\boldsymbol{y}}}{\sigma_{\boldsymbol{x}}^2} = \hat\beta_2. $$
Sin resolver ningún sistema: dos proyecciones independientes, sobre dos direcciones perpendiculares.
$\hat\beta_1$ y el lugar de las medias
De $\hat\beta_1=\mu_{\boldsymbol{y}}-\hat\beta_2\mu_{\boldsymbol{x}}$, reordenando: $$ \mu_{\boldsymbol{y}} = \hat\beta_1 + \hat\beta_2\mu_{\boldsymbol{x}}. $$
Así, evaluando la recta ajustada $\hat y = \hat\beta_1+\hat\beta_2 x$ en el punto $x=\mu_{\boldsymbol{x}}$, el resultado es $\mu_{\boldsymbol{y}}$
La recta ajustada pasa exactamente por el punto de las medias $(\mu_{\boldsymbol{x}},\mu_{\boldsymbol{y}})$.
Además (primera condición): $\mu_{\boldsymbol{\mathop{\widehat{y}}}}=\mu_{\boldsymbol{y}}$, el ajuste preserva la media.
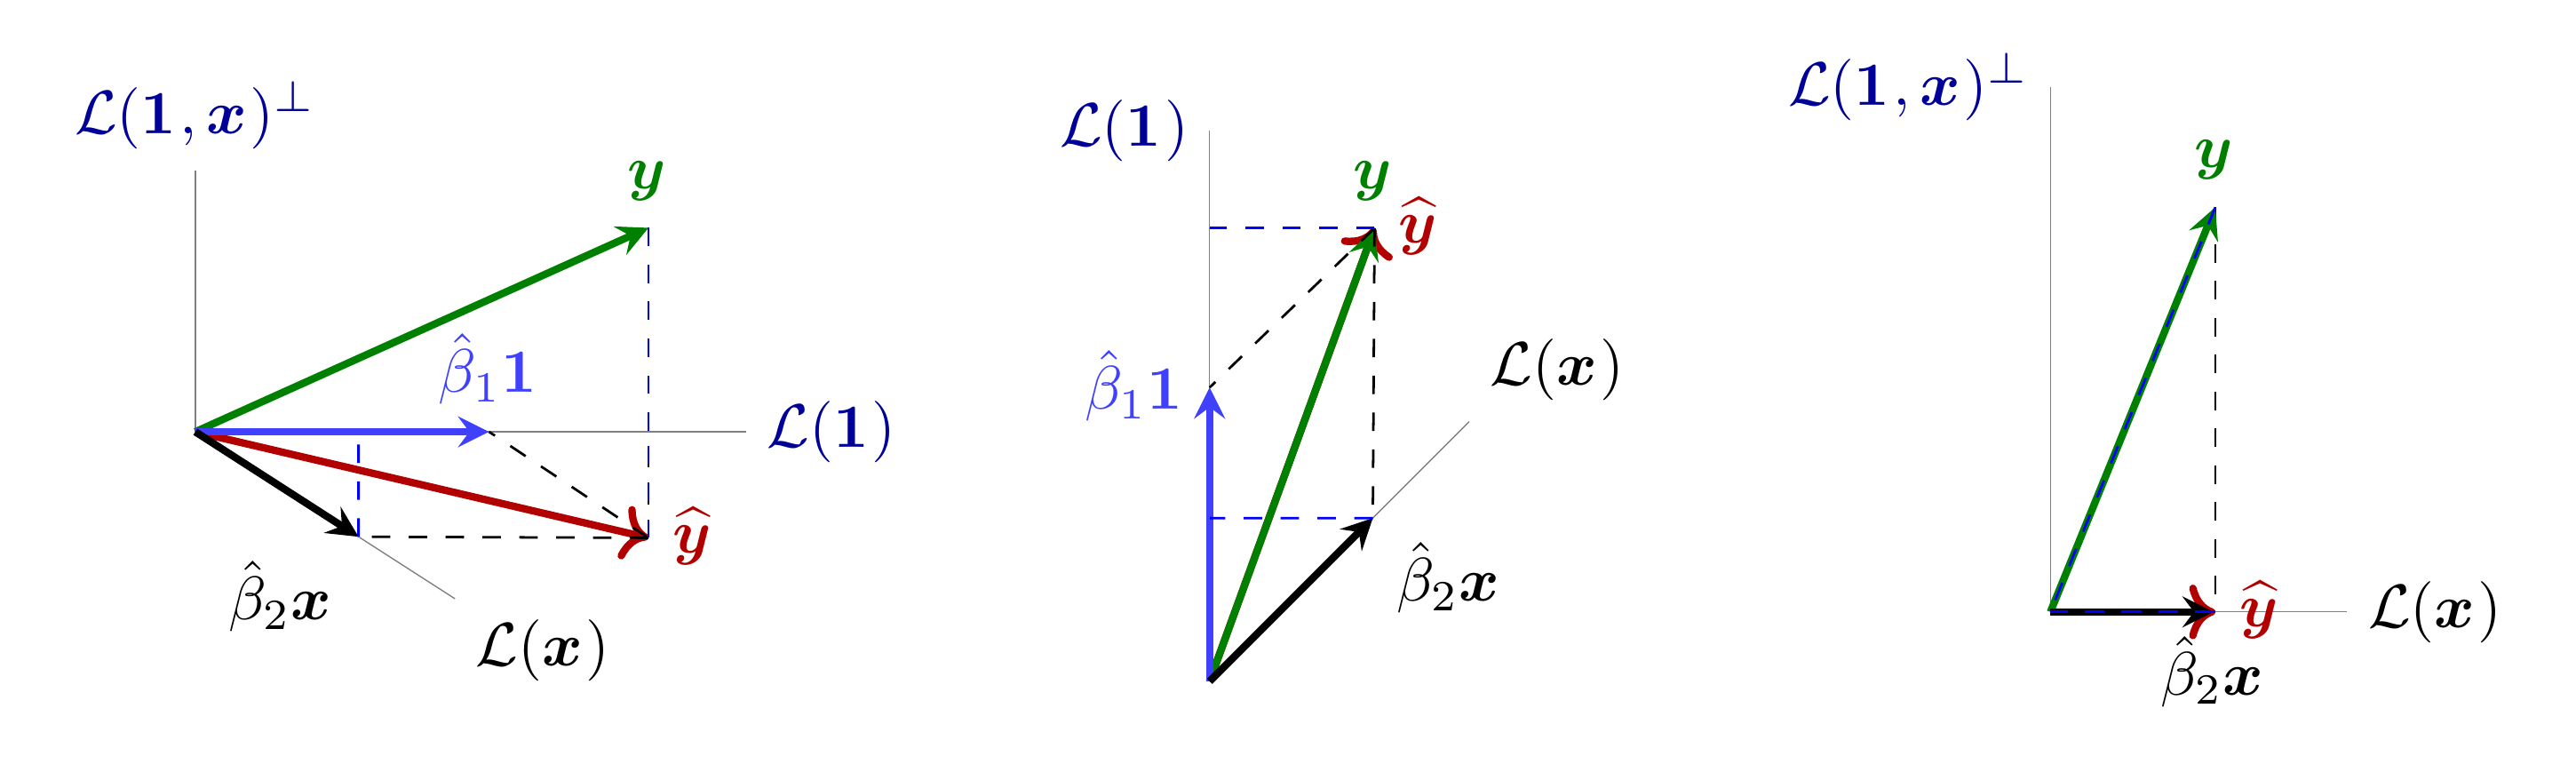
Tres cantidades que coinciden: $\mu_{\boldsymbol{y}}=\mu_{\boldsymbol{\mathop{\widehat{y}}}}=\hat\beta_1+\hat\beta_2\mu_{\boldsymbol{x}}$ (versión interactiva).
Y hay más, los vectores en desviaciones de $\boldsymbol{\mathop{\widehat{y}}}$ y $\hat\beta_2\boldsymbol{x}$ son iguales: $$ \boldsymbol{\mathop{\widehat{y}}} - \mu_{\boldsymbol{\mathop{\widehat{y}}}}\boldsymbol{1} \;=\; \big(\hat\beta_1\boldsymbol{1}+\hat\beta_2\boldsymbol{x}\big) - \big(\hat\beta_1+\hat\beta_2\mu_{\boldsymbol{x}}\big)\boldsymbol{1} \;=\; \hat\beta_2\boldsymbol{x}-\hat\beta_2\mu_{\boldsymbol{x}}\boldsymbol{1} \;=\; \hat\beta_2\big(\boldsymbol{x}-\mu_{\boldsymbol{x}}\boldsymbol{1}\big). $$
De ahí que $\sigma_{\boldsymbol{\mathop{\widehat{y}}}}=\sigma_{\hat\beta_2\boldsymbol{x}}$. Y también que $\boldsymbol{y}$ forme el mismo ángulo con $\boldsymbol{\mathop{\widehat{y}}}$ que con $\hat\beta_2\boldsymbol{x}$.
Ejemplo numérico completo
Como en la actividad 3 (html) del laboratorio ($\boldsymbol{y}=2+3\boldsymbol{x}+\boldsymbol{u}$), pero con $n=5$, calculable a mano:
| $x_i$ | $u_i$ | $y_i=2+3x_i+u_i$ | $\hat y_i=\hat\beta_1+\hat\beta_2x_i$ |
|---|---|---|---|
| 1 | 1 | 6 | 5 |
| 2 | -2 | 6 | 8 |
| 3 | 0 | 11 | 11 |
| 4 | 2 | 16 | 14 |
| 5 | -1 | 16 | 17 |
¡Recuperamos exactamente $\beta_1=2$, $\beta_2=3$! (No es lo habitual: $\boldsymbol{u}$ se eligió ortogonal a los regresores.)
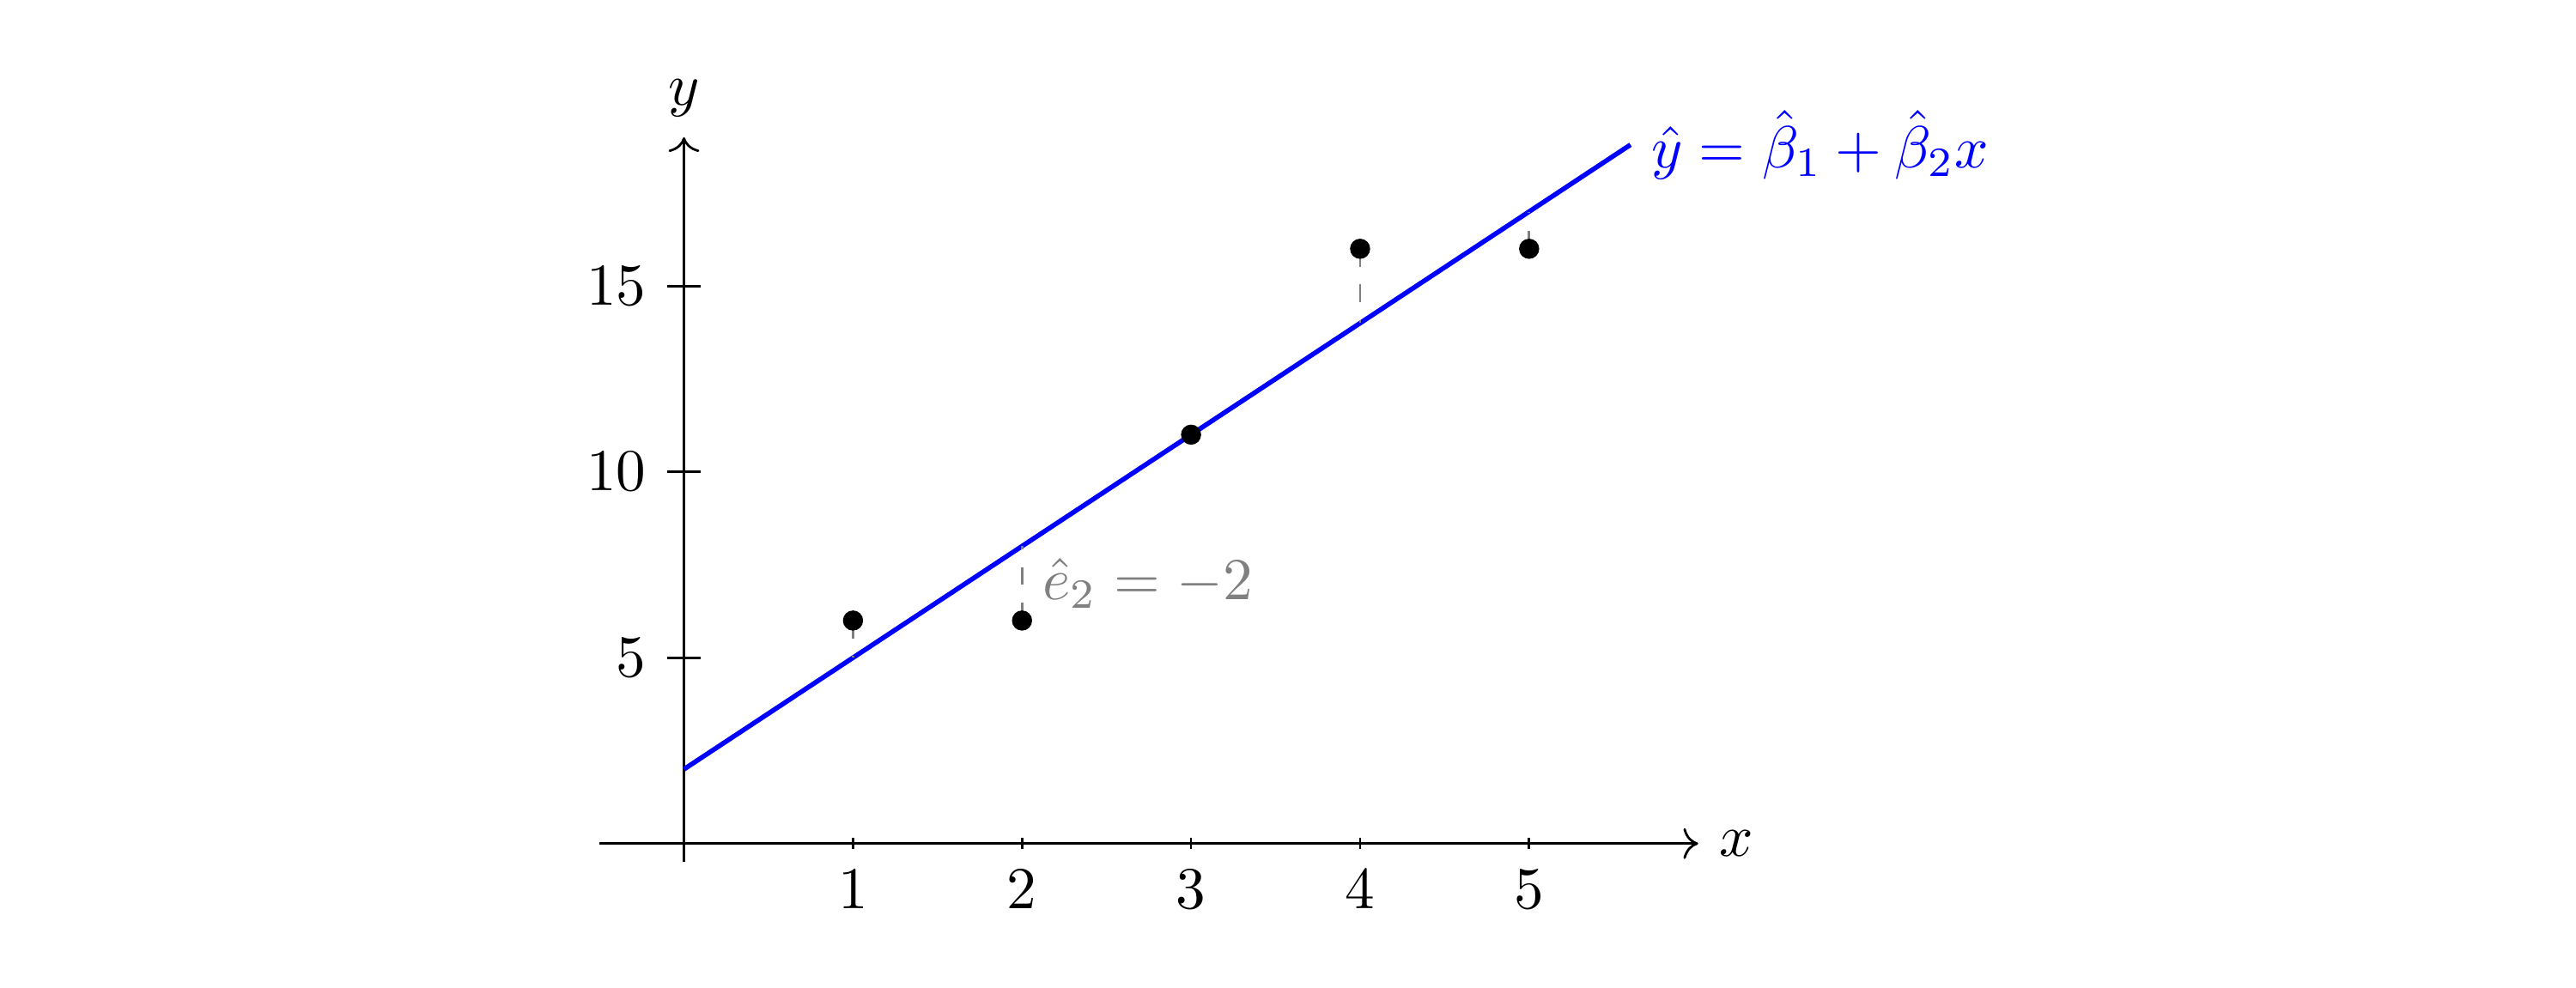
Versión interactiva: cuaderno 2 en MyBinder, parte 3 (qué le exigimos a $\boldsymbol{u}$ para recuperar los coeficientes).
Recapitulación y guiño a la sesión siguiente
| Condición de ortogonalidad | Consecuencia |
|---|---|
| $\langle\boldsymbol{\mathop{\widehat{e}}} , \boldsymbol{1}\rangle_s=0$ | $\hat\beta_1=\mu_{\boldsymbol{y}}-\hat\beta_2\mu_{\boldsymbol{x}}$;\; $\mu_{\boldsymbol{\mathop{\widehat{y}}}}=\mu_{\boldsymbol{y}}$ |
| $\langle\boldsymbol{\mathop{\widehat{e}}} , \boldsymbol{x}\rangle_s=0$ | $\hat\beta_2=\sigma_{\boldsymbol{x}\boldsymbol{y}}/\sigma_{\boldsymbol{x}}^2 = \rho_{\boldsymbol{x}\boldsymbol{y}}\,\sigma_{\boldsymbol{y}}/\sigma_{\boldsymbol{x}}$ |
Nótese el caso límite $\hat\beta_2=0$: entonces $\hat\beta_1=\mu_{\boldsymbol{y}}$, y recuperamos exactamente el ajuste de la lección 4 —la media—. La regresión simple generaliza aquella proyección sobre una recta añadiendo una segunda dirección; no la sustituye.
Dos ortogonalidades, dos coeficientes. Nada de matrices; solo Pitágoras y bilinealidad, aplicados dos veces.
Próxima sesión — Lección 8: las mismas dos ortogonalidades, combinadas con el teorema de Pitágoras, dan $\sigma^2_{\boldsymbol{y}}=\sigma^2_{\boldsymbol{\mathop{\widehat{y}}}}+\sigma^2_{\boldsymbol{\mathop{\widehat{e}}}}$. De ahí saldrá el $R^2=\cos^2\theta$: ¿cómo de bueno es nuestro ajuste?