Lección 8. Bondad de ajuste: de Pitágoras a $R^2$
Author: Marcos Bujosa
Las dos ortogonalidades de la lección 7, vistas bajo Pitágoras, descomponen la varianza de $\boldsymbol{y}$ en la del ajuste más la del error. El cociente es el cuadrado del coseno del ángulo entre datos y ajuste, ambos en desviaciones: $R^2$.
``Un triángulo rectángulo escondido en cada regresión.''
De dónde venimos: dos ortogonalidades, una identidad guardada
En la lección 7 resolvimos las dos condiciones de ortogonalidad de la regresión lineal simple: $$ \langle\boldsymbol{\mathop{\widehat{e}}} , \boldsymbol{1}\rangle_s=0, \qquad \langle\boldsymbol{\mathop{\widehat{e}}} , \boldsymbol{x}\rangle_s=0, $$
Que nos condujeron al hallazgo de dos identidades. Por una parte: $$ \mu_{\boldsymbol{y}}=\mu_{\boldsymbol{\mathop{\widehat{y}}}}. $$
Y por otra: $$ \boldsymbol{\mathop{\widehat{y}}} - \mu_{\boldsymbol{\mathop{\widehat{y}}}}\boldsymbol{1} \;=\; \hat\beta_2\big(\boldsymbol{x}-\mu_{\boldsymbol{x}}\boldsymbol{1}\big). $$
Hoy juntamos estas piezas con una herramienta conocida: el teorema de Pitágoras (lección 3).
El triángulo rectángulo de la bondad de ajuste
Restando $\boldsymbol{\mathop{\overline{y}}}$ a ambos lados de $\;\boldsymbol{y}=\boldsymbol{\mathop{\widehat{y}}}+\boldsymbol{\mathop{\widehat{e}}}\;$ tenemos: $$ \boldsymbol{y}-\boldsymbol{\mathop{\overline{y}}} \;=\; \big(\boldsymbol{\mathop{\widehat{y}}}-\boldsymbol{\mathop{\overline{y}}}\big) + \boldsymbol{\mathop{\widehat{e}}}, \qquad \text{ con } \; \boldsymbol{\mathop{\widehat{e}}}\perp\mathcal{L}(\boldsymbol{\mathop{\widehat{y}}},\boldsymbol{\mathop{\overline{y}}}) \; \text{ así,} $$ $(\boldsymbol{y}-\boldsymbol{\mathop{\overline{y}}})$ es la hipotenusa de un triángulo rectángulo cuyos catetos son $\boldsymbol{\mathop{\widehat{e}}}$ y $(\boldsymbol{\mathop{\widehat{y}}}-\boldsymbol{\mathop{\overline{y}}})$.
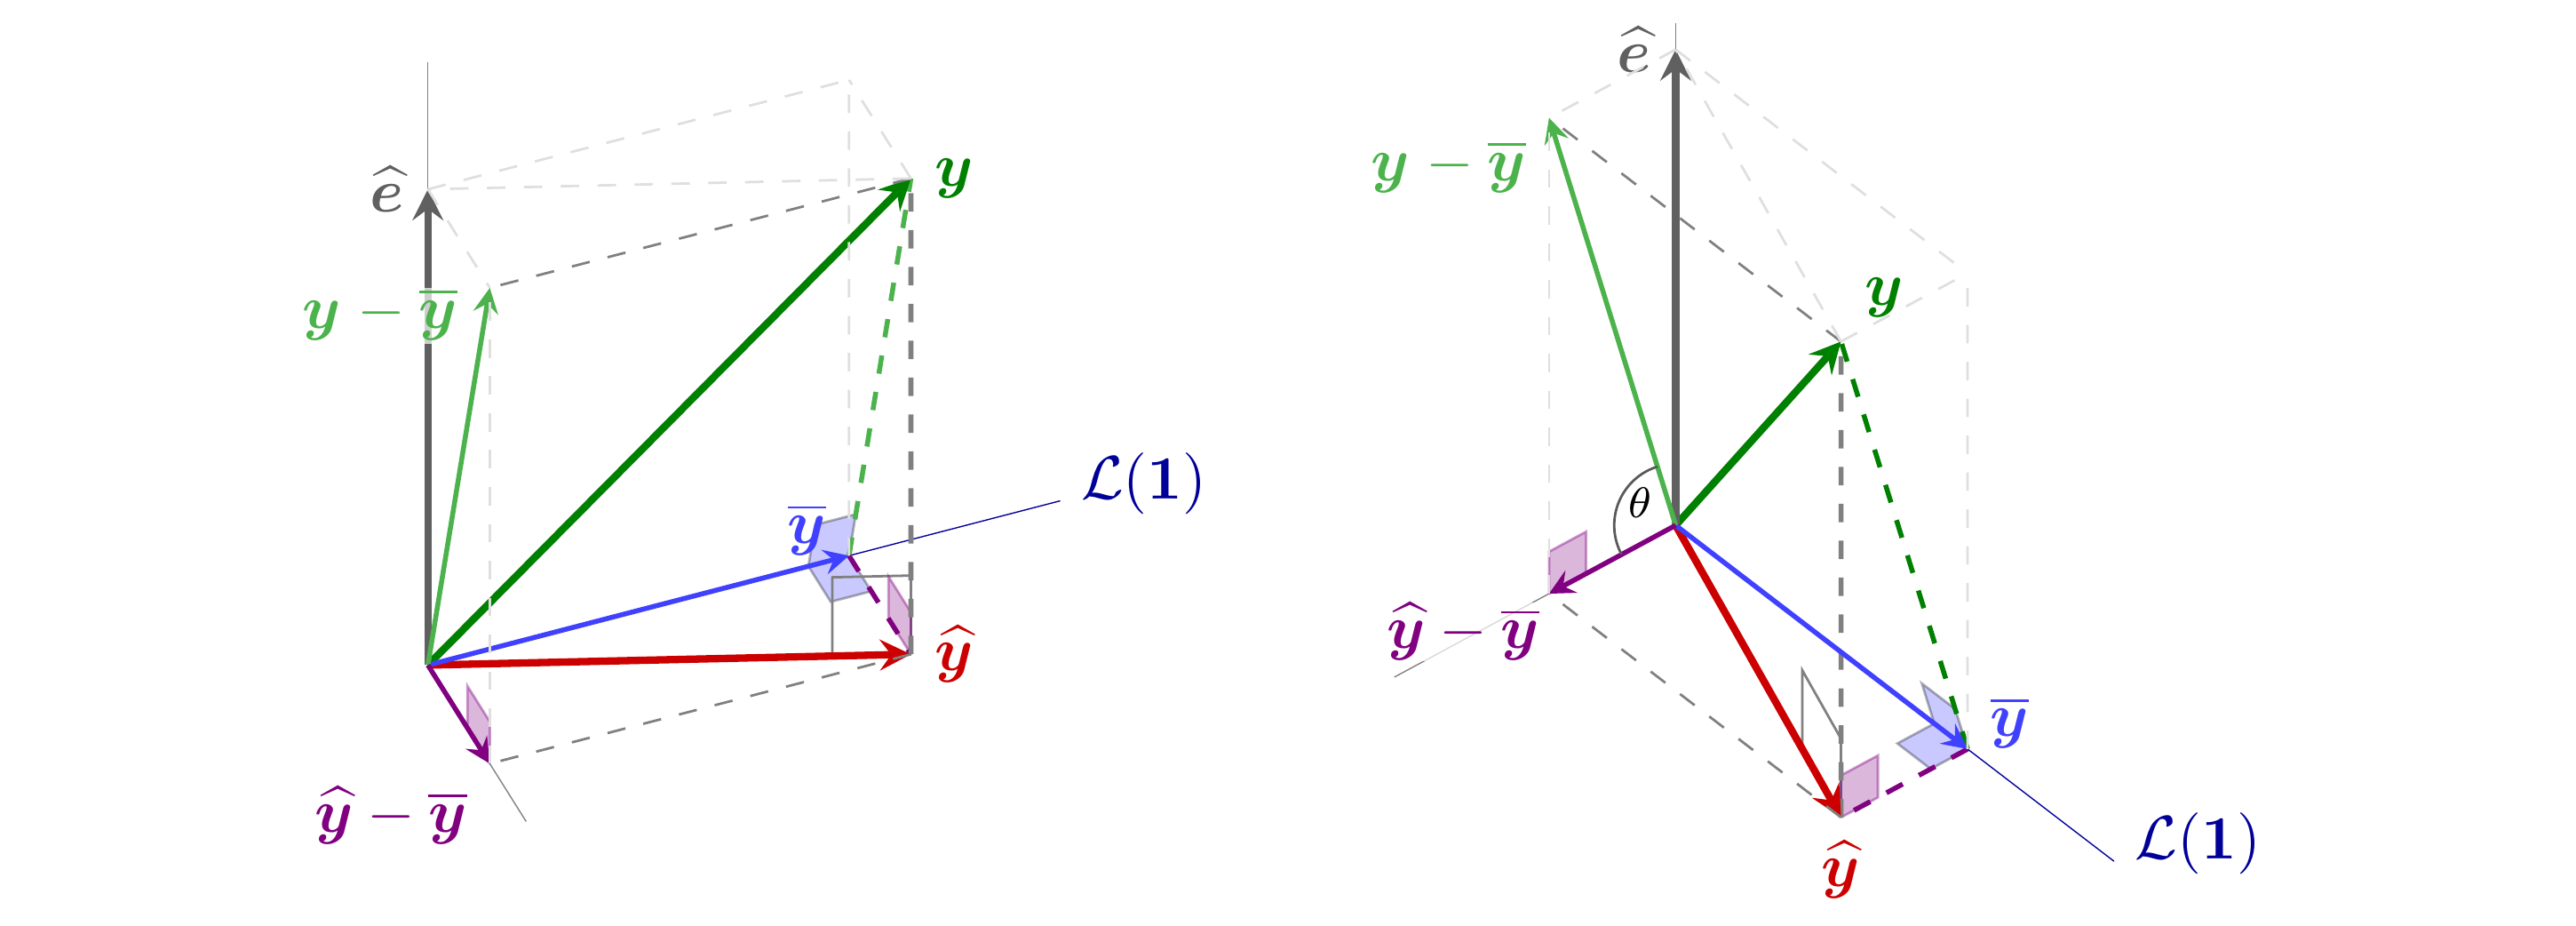
Versión interactiva: cuaderno 3 en MyBinder, parte 1 (el triángulo, rotable).
Pitágoras: la varianza se descompone
Aplicando el teorema de Pitágoras (lección 3) sobre $\;\boldsymbol{y}-\boldsymbol{\mathop{\overline{y}}}=(\boldsymbol{\mathop{\widehat{y}}}-\boldsymbol{\mathop{\overline{y}}})+\boldsymbol{\mathop{\widehat{e}}}$, tenemos: $$ \|\boldsymbol{y}-\boldsymbol{\mathop{\overline{y}}}\|_s^2 \;=\; \|\boldsymbol{\mathop{\widehat{y}}}-\boldsymbol{\mathop{\overline{y}}}\|_s^2 \;+\; \|\boldsymbol{\mathop{\widehat{e}}}\|_s^2. $$
donde hemos usado que $\boldsymbol{\mathop{\overline{y}}}=\mu_{\boldsymbol{y}}\boldsymbol{1}=\mu_{\boldsymbol{\mathop{\widehat{y}}}}\boldsymbol{1}=\boldsymbol{\mathop{\overline{\widehat{y}}}}\quad$ (pues $\mu_{\boldsymbol{y}}=\mu_{\boldsymbol{\mathop{\widehat{y}}}}$).
Y multiplicando por $n$ (es decir, volviendo a la norma euclidea usual en $\mathbb{R}^n$) tenemos: $$ \underbrace{\textstyle\sum_i(y_i-\mu_{\boldsymbol{y}})^2}_{\text{STC}} \;=\; \underbrace{\textstyle\sum_i(\hat y_i-\mu_{\boldsymbol{y}})^2}_{\text{SEC}} \;+\; \underbrace{\textstyle\sum_i \hat e_i^2}_{\text{SRC}}; $$ que es una expresión habitual en los manuales de econometría (o programas econométricos como Gretl) donde: STC = Suma Total de Cuadrados, SEC = Suma Explicada de Cuadrados y SRC = Suma Residual de Cuadrados.
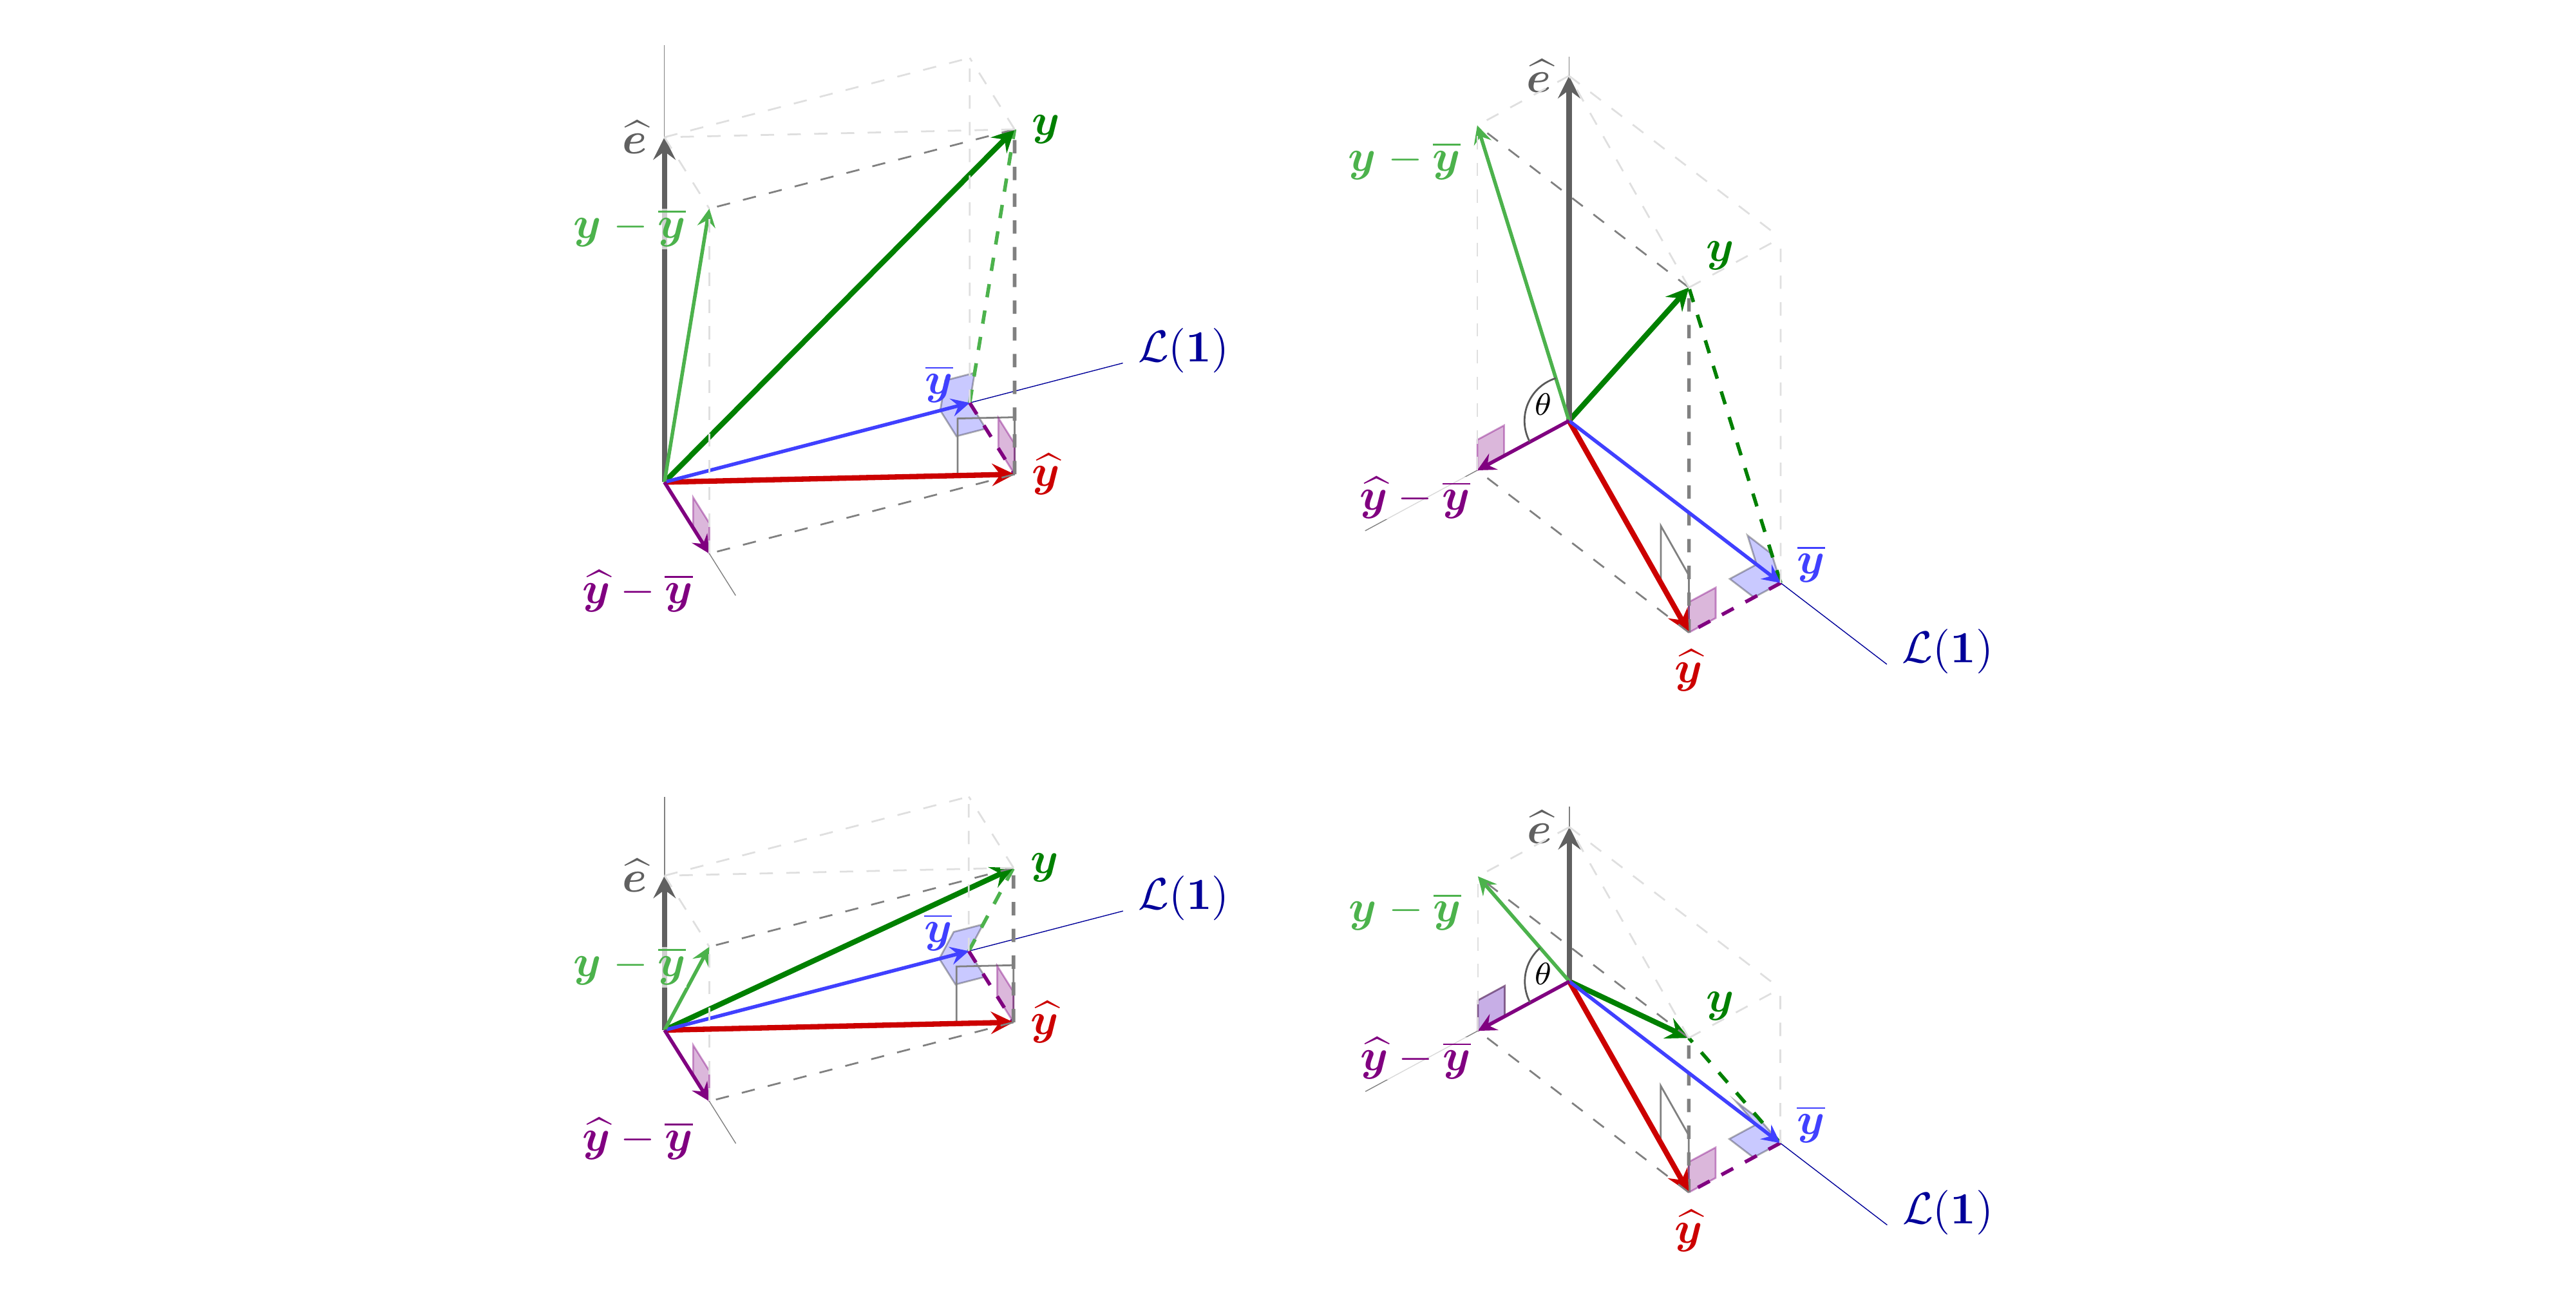
¿Qué ajuste es mejor: el de arriba o el de abajo?
Mismo $\boldsymbol{\mathop{\widehat{y}}}$ y mismo $\boldsymbol{\mathop{\overline{y}}}$ arriba y abajo; solo cambia $\boldsymbol{\mathop{\widehat{e}}}$. Para comparar $\boldsymbol{y}$ con $\boldsymbol{\mathop{\widehat{y}}}$ basta mirar lo que no comparten.
El coeficiente de determinación $R^2$
El coeficiente de determinación es el cociente entre las normas al cuadrado del ajuste y de los datos, ambos en desviaciones: $$ R^2 \;=\; \frac{\|\boldsymbol{\mathop{\widehat{y}}}-\boldsymbol{\mathop{\overline{y}}}\|_s^2}{\|\boldsymbol{y}-\boldsymbol{\mathop{\overline{y}}}\|_s^2} \;=\; \frac{\sigma_{\boldsymbol{\mathop{\widehat{y}}}}^2}{\sigma_{\boldsymbol{y}}^2}. $$
Multiplicando por $n$ numerador y denominador: $\;R^2=\mathrm{SEC}/\mathrm{STC}=1-\mathrm{SRC}/\mathrm{STC}$.
Del triángulo rectángulo, como $\langle\boldsymbol{y}-\boldsymbol{\mathop{\overline{y}}},\boldsymbol{\mathop{\widehat{y}}}-\boldsymbol{\mathop{\overline{y}}}\rangle_s = \|\boldsymbol{\mathop{\widehat{y}}}-\boldsymbol{\mathop{\overline{y}}}\|_s^2\;$ (pues $\boldsymbol{\mathop{\widehat{e}}}\perp\mathcal{L}(\boldsymbol{1},\boldsymbol{x})$): $\quad\cos\theta = \|\boldsymbol{\mathop{\widehat{y}}}-\boldsymbol{\mathop{\overline{y}}}\|_s/\|\boldsymbol{y}-\boldsymbol{\mathop{\overline{y}}}\|_s = \sigma_{\boldsymbol{\mathop{\widehat{y}}}}/\sigma_{\boldsymbol{y}} = \rho_{\boldsymbol{\mathop{\widehat{y}}}\boldsymbol{y}}$.
como todo coseno al cuadrado, $0\leq R^2\leq1$.
Interpretando $R^2$: casos extremos
Con $\boldsymbol{y}=\boldsymbol{\mathop{\widehat{y}}}$:
- $\theta=0^\circ$ ($\boldsymbol{\mathop{\widehat{e}}}=\boldsymbol{0}$): el ajuste coincide con los datos. $R^2=1$.
Con $(\boldsymbol{\mathop{\widehat{y}}}-\boldsymbol{\mathop{\overline{y}}})$ fijo y no nulo, $R^2$ nunca llega a ser $0$: solo se le acerca.
- $\theta\to90^\circ$: si el residuo crece sin límite; $R^2\to0$ (solo $0$ como límite).
¿Y puede $R^2$ ser exactamente $0$?
- Sí — pero en otra situación: cuando el propio ajuste coincide con el vector de medias, $\boldsymbol{\mathop{\widehat{y}}}=\boldsymbol{\mathop{\overline{y}}}$ (cateto nulo, sin residuo infinito). Es decir, cuando $\rho_{\boldsymbol{x}\boldsymbol{y}}=0$.
Ejemplo numérico: STC, SEC, SRC
Retomamos el ejemplo de la lección 7: $\boldsymbol{x}=(1,2,3,4,5)$, $\boldsymbol{y}=(6,6,11,16,16)$, con $\hat\beta_1=2$, $\hat\beta_2=3$.
| $x_i$ | $y_i$ | $\hat y_i=2+3x_i$ | $\hat e_i=y_i-\hat y_i$ |
|---|---|---|---|
| 1 | 6 | 5 | 1 |
| 2 | 6 | 8 | -2 |
| 3 | 11 | 11 | 0 |
| 4 | 16 | 14 | 2 |
| 5 | 16 | 17 | -1 |
$\mu_{\boldsymbol{y}}=\mu_{\boldsymbol{\mathop{\widehat{y}}}}=11$. Entonces: $$ \mathrm{STC}=\textstyle\sum(y_i-11)^2=100, \qquad \mathrm{SEC}=\textstyle\sum(\hat y_i-11)^2=90, \qquad \mathrm{SRC}=\textstyle\sum\hat e_i^2=10. $$
Comprobación: $90+10=100$ ✓. $\quad R^2 = 90/100 = 0{,}9$.
Con $\sigma_{\boldsymbol{x}}^2=2$, $\sigma_{\boldsymbol{y}}^2=20$, $\sigma_{\boldsymbol{x}\boldsymbol{y}}=6$: $\;\rho_{\boldsymbol{x}\boldsymbol{y}}^2=6^2/(2\cdot20)=36/40=0{,}9$. ¡Coincide!
Una advertencia: el nombre suma explicada es engañoso
$\mathrm{STC}=\mathrm{SEC}+\mathrm{SRC}$ es una identidad puramente geométrica sobre vectores de $\mathbb{R}^n$: se cumple siempre, contengan esos vectores lo que contengan.
Primer peligro: un $R^2$ alto NO requiere ninguna relación real entre $\boldsymbol{x}$ e $\boldsymbol{y}$.
Ejemplo célebre (Vigen, Spurious Correlations): consumo de queso per cápita en EE.UU. y personas que mueren enredadas en sus sábanas, $\rho\approx0{,}947$. Nadie propone que el queso mate sofocando a sus víctimas entre las sábanas.
Segundo peligro: aun cuando SÍ existe una relación real, $R^2$ no dice nada sobre su dirección.
Ampliar una vivienda aumenta su precio (relación razonable). Pero si regresamos superficie sobre precio (invirtiendo los papeles), $R^2$ no cambia — y de ahí no se sigue que cuando el precio sube la casa aumenta su tamaño.
Un $R^2$ alto no certifica relación alguna; y cuando la hay, no indica su sentido.
Solo cuando el modelo sea sensato un $R^2$ alto será una buena señal.
En el caso de la regresión simple: $R^2=\rho_{\boldsymbol{x}\boldsymbol{y}}^2$
El ajuste $\boldsymbol{\mathop{\widehat{y}}}=\hat\beta_2\boldsymbol{x}+\hat\beta_1\boldsymbol{1}$ es una traslación y reescalado de $\boldsymbol{x}$. Aplicando las propiedades de traslación y escala de la correlación: $$ \rho_{\boldsymbol{\mathop{\widehat{y}}}\boldsymbol{y}} \;=\; \frac{\hat\beta_2}{|\hat\beta_2|}\;\rho_{\boldsymbol{x}\boldsymbol{y}}. $$
Como $\hat\beta_2$ y $\rho_{\boldsymbol{x}\boldsymbol{y}}$ comparten siempre signo (lección 7): $\;\rho_{\boldsymbol{\mathop{\widehat{y}}}\boldsymbol{y}}=|\rho_{\boldsymbol{x}\boldsymbol{y}}|\geq0$.
No es casualidad: en $\mathcal{L}(\boldsymbol{1},\boldsymbol{x})$ solo hay una dirección perpendicular $\boldsymbol{1}$. Todo vector no constante del plano —incluido $\boldsymbol{\mathop{\widehat{y}}}$— forma con $\boldsymbol{y}$ el mismo ángulo, salvo quizá el signo.
Regresión lineal simple: STC, SEC y SRC con áreas
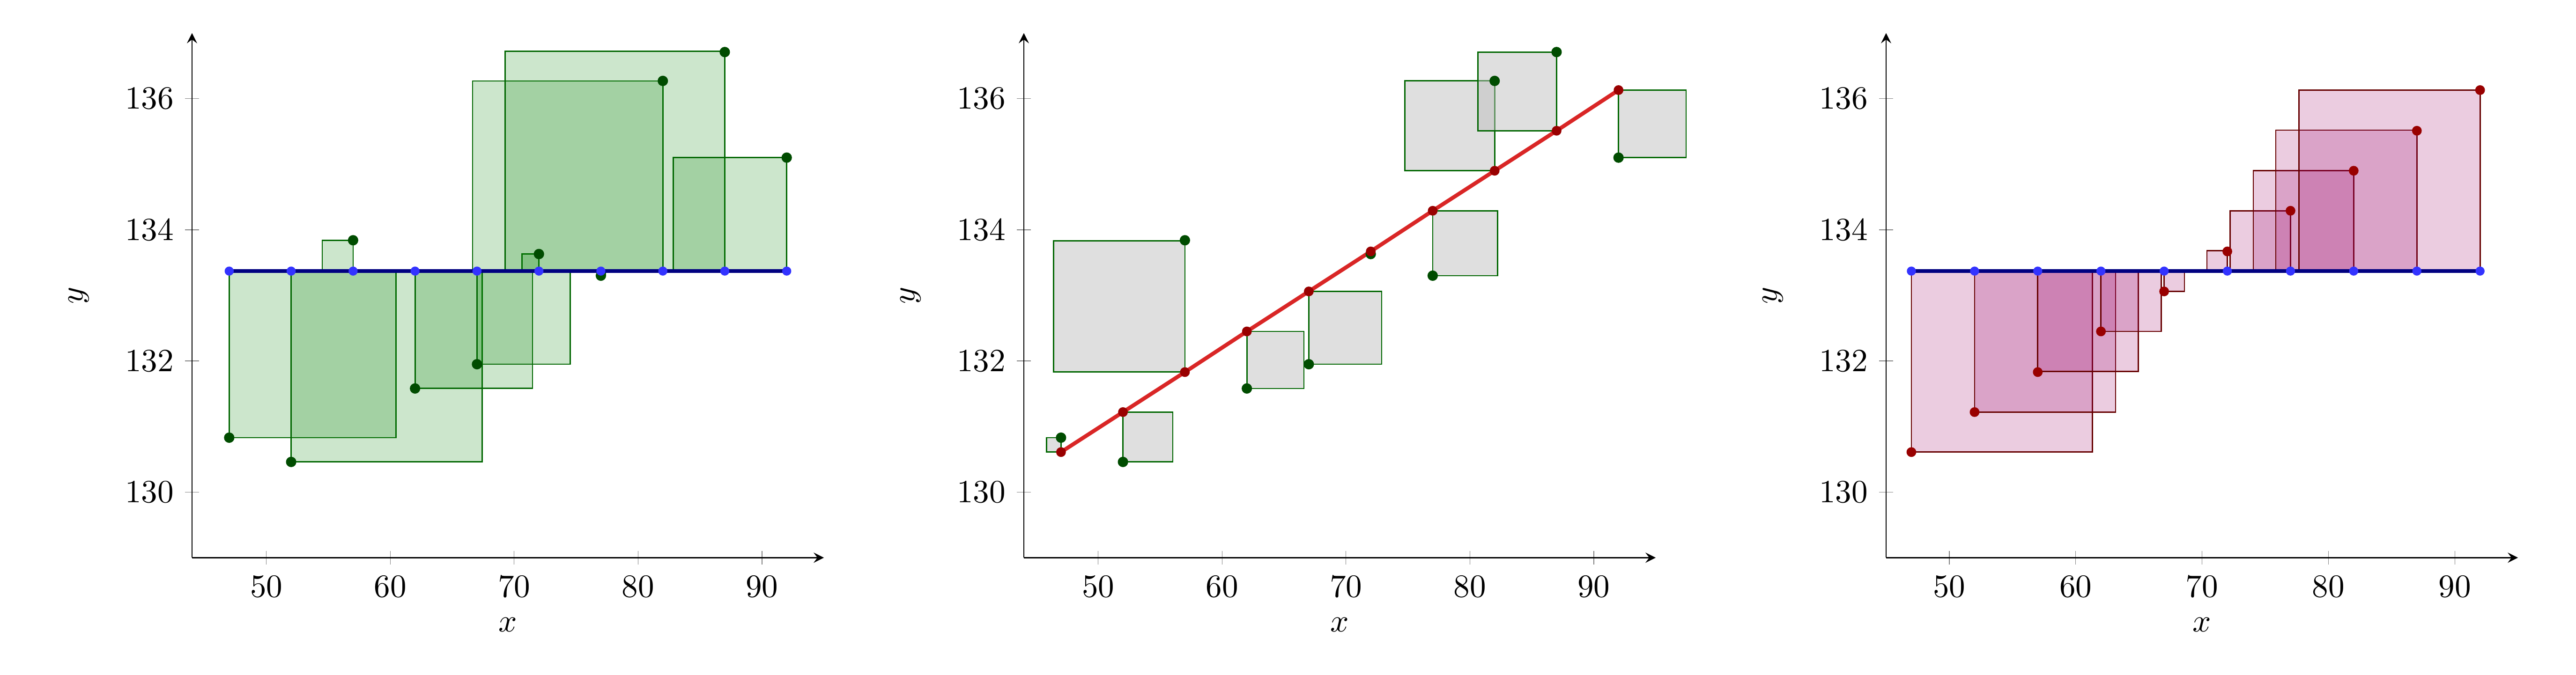
Versión interactiva: cuaderno 3 en MyBinder, parte 2 (las tres áreas, con datos editables).
Es la misma identidad $\mathrm{STC}=\mathrm{SRC}+\mathrm{SEC}$ de la transparencia ``Pitágoras: la varianza se descompone'', ahora vista como suma de áreas, dato a dato.
Recapitulación y guiño a la lección siguiente
| Paso | Resultado |
|---|---|
| Descomposición ortogonal | $(\boldsymbol{y}-\boldsymbol{\mathop{\overline{y}}})=(\boldsymbol{\mathop{\widehat{y}}}-\boldsymbol{\mathop{\overline{y}}})+\boldsymbol{\mathop{\widehat{e}}}$, sumandos ortogonales |
| Pitágoras | $\sigma_{\boldsymbol{y}}^2=\sigma_{\boldsymbol{\mathop{\widehat{y}}}}^2+\sigma_{\boldsymbol{\mathop{\widehat{e}}}}^2\quad$ (STC=SEC+SRC) |
| Definición | $R^2={\sigma_{\boldsymbol{\mathop{\widehat{y}}}}^2}/{\sigma_{\boldsymbol{y}}^2}=\mathrm{SEC}/\mathrm{STC}\;(=\cos^2\theta=\rho_{\boldsymbol{\mathop{\widehat{y}}}\boldsymbol{y}}^2)$ |
| Caso simple (un regresor) | $R^2=\rho_{\boldsymbol{x}\boldsymbol{y}}^2$ |
Más adelante: el mismo argumento —Pitágoras + las dos ortogonalidades de la lección 7— se generalizará a $k$ regresores: solo cambiará la dimensión del subespacio sobre el que proyectamos. Las primeras figuras de esta sesión, al no mostrar $\hat\beta_2\boldsymbol{x}$ explícitamente, valdrán como esquema para el caso general.
Próxima sesión: laboratorio; verificaremos con datos reales que $\sum\hat e_i=0$, $\sum x_i\hat e_i=0$ y que el $R^2$ calculado a mano coincide con el que reporta Gretl.
Lección 9 — El puente: hasta ahora, pura geometría en $\mathbb{R}^n$, sin ningún supuesto probabilístico. La próxima lección teórica da el salto —como analogía, no como demostración— al espacio de las variables aleatorias: la esperanza condicional $E[Y\mid X]$ jugará el papel de $\boldsymbol{\mathop{\widehat{y}}}$.