Lección 9. El puente: de los datos a las variables aleatorias
Author: Marcos Bujosa
``Ninguno de los dioses filosofa ni desea hacerse sabio, porque ya lo es […] Tampoco los ignorantes filosofan ni desean hacerse sabios […] Eros está en el medio de la sabiduría y de la ignorancia.'' (Platón, El Banquete, 203e–204a)
La econometría habita en ese mismo espacio intermedio: entre la ignorancia absoluta y el conocimiento total de la población. Esta lección da el salto desde la geometría de las muestras (lo que vemos) al espacio de las variables aleatorias (el modelo subyacente que queremos inferir).
El puente epistemológico: entre Eros y los datos
``Ninguno de los dioses filosofa ni desea hacerse sabio, porque ya lo es […] Tampoco los ignorantes filosofan ni desean hacerse sabios […] Eros está en el medio de la sabiduría y de la ignorancia.'' — Diotima a Sócrates (Platón, El Banquete)$\mbox{ }$
- El Dios: Conoce toda la población (certeza absoluta). No necesita inferir nada.
- El Ignorante: No tiene datos ($n = 0$). No puede afirmar nada.
- El Econometrista: Como Eros, habita el espacio intermedio. Tiene una muestra imperfecta ($n < N$) y el deseo de inferir la estructura verdadera del mundo.
Hasta ahora: geometría exacta sobre una muestra finita $\boldsymbol{y} \in \mathbb{R}^n$. A partir de hoy: la muestra $\boldsymbol{y}$ se concibe como una realización particular (una ``sombra sensible'') de un modelo abstracto superior: una variable aleatoria $Y$.
Advertencia, desde ya: lo que sigue es una analogía, no una demostración. Y solo es válida para variables aleatorias con esperanza y varianza definidas — no todas la tienen.
Un vector es una función; y una variable aleatoria también
Un vector $\boldsymbol{y}\in\mathbb{R}^n$ (lista ordenada de números —Lección 2) es literalmente una función que asigna un número a cada índice $i\in\{1,\ldots,n\}$.
Una variable aleatoria $Y$ es también una función — pero definida sobre un conjunto $\Omega$ (de ``sucesos elementales''), generalmente más grande y sin una descripción explícita.
| $\mathbb{R}^n$ | Variables aleatorias |
|---|---|
| dominio $\{1,\ldots,n\}$ | dominio $\Omega$ |
| $\boldsymbol{y}(i)=y_i;\quad i\in\{1,\ldots,n\}$ | $Y(\omega)=y;\quad \omega\in\Omega$ |
| vector = lista de $n$ números | v.a. = función sobre $\Omega$ |
Lo que sobrevive al cambio:
La combinación lineal (lección 2) de variables aleatorias $\beta_1\,\mathit{1}+\beta_2X$ sigue siendo una variable aleatoria, exactamente como $\beta_1\boldsymbol{1}+\beta_2\boldsymbol{x}$ era un vector.
Nota: $\mathit{1}$ es la variable aleatoria constante que asigna $1$ a todo suceso elemental de $\Omega$.
El producto escalar de la probabilidad
En $\mathbb{R}^n$: $\;\langle\boldsymbol{x},\boldsymbol{y}\rangle_s=\sum\limits_{j=1}^n\frac{x_jy_j}{n}$.
Con variables aleatorias, el papel de $\langle\cdot,\cdot\rangle_s$ lo juega la esperanza del producto: $$ \langle X,Y\rangle_P \;=\; \mathrm{E}(XY). $$
Advertencia honesta: $\langle\cdot,\cdot\rangle_P$ es solo un semi-producto escalar. $\mathrm{E}(X^2)=\|X\|_P^2=0$ NO implica $X=\mathit{0}$ (podría ser solo cero ``casi seguro''; no lo desarrollaremos).$\mbox{ }$
Nota: $\mathit{0}$ es la variable aleatoria constante que asigna $0$ a todo suceso elemental de $\Omega$.
Pero Pitágoras, Cauchy–Schwarz y la desigualdad triangular (lección 3) solo exigían simetría, linealidad y positividad — no positividad estricta. Así que siguen siendo válidos, sin cambiar una coma.
La esperanza: dos caras de la misma moneda
En $\mathbb{R}^n$, el vector constante uno, $\boldsymbol{1}$, tuvo un papel especial; ahora lo tiene la v.a. cte. $\mathit{1}$.
| $\mathbb{R}^n$ | Variables aleatorias | |
|---|---|---|
| Escalar | $\mu_{\boldsymbol y}=\langle\boldsymbol y,\boldsymbol 1\rangle_s$ | $\mathrm{E}(Y)=\langle Y,\mathit{1}\rangle_P$ |
| Proyección | $\boldsymbol{\mathop{\overline y}}=\mu_{\boldsymbol y}\boldsymbol 1$ (vector constante) | $E[Y\mid \mathit{1}]=\mathrm{E}(Y)\,\mathit{1}$ (función constante) |
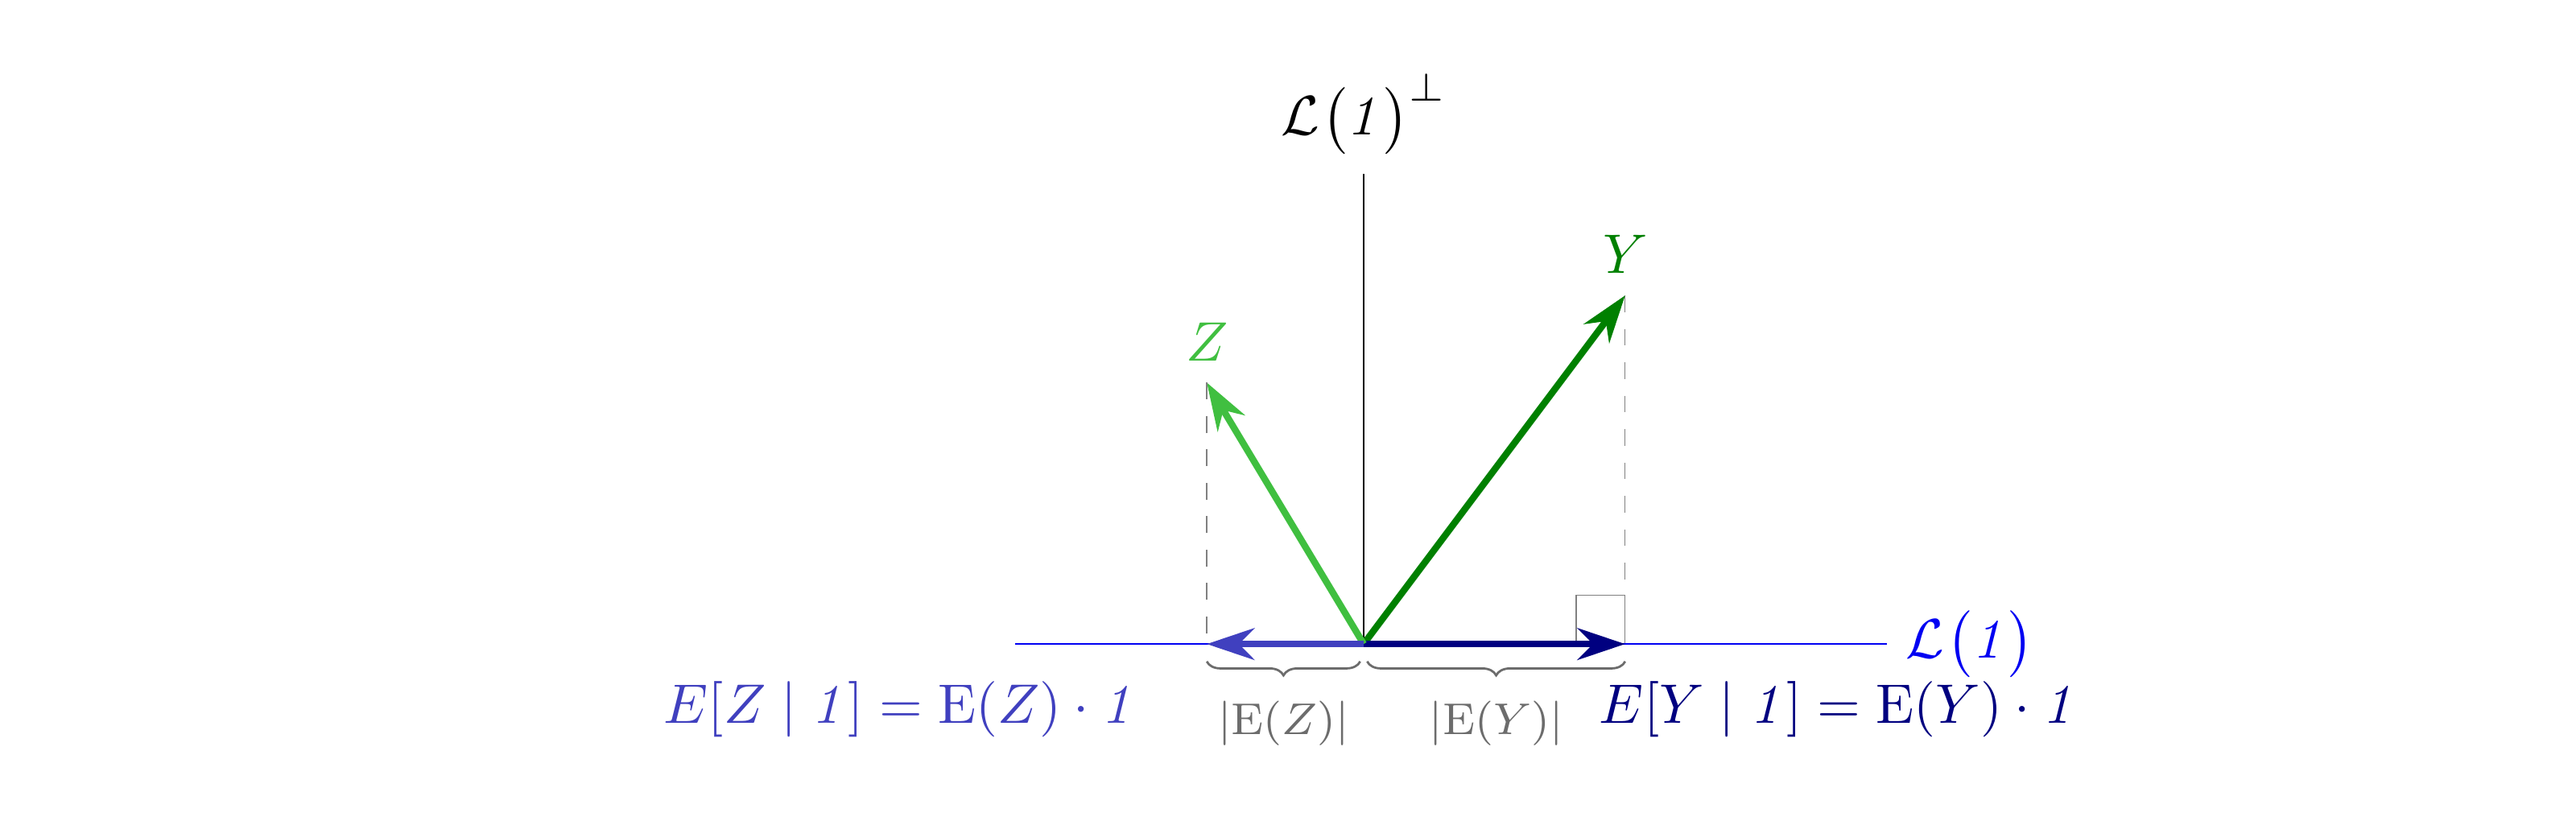
Por Pitágoras (como lección 5): $\quad \mathrm{Var}(Y) = \Big\|Y - E[Y|\mathit{1}]\Big\|_P^2 = \mathrm{E}(Y^2) - (\mathrm{E}(Y))^2$.
Esperanza condicional: proyección sobre un espacio ENORME
La Esperanza Condicional, $E[Y|X]$, es la proyección ortogonal de $Y$ sobre el subespacio generado por las funciones de la variable $X$ (¡Un espacio enorme!).
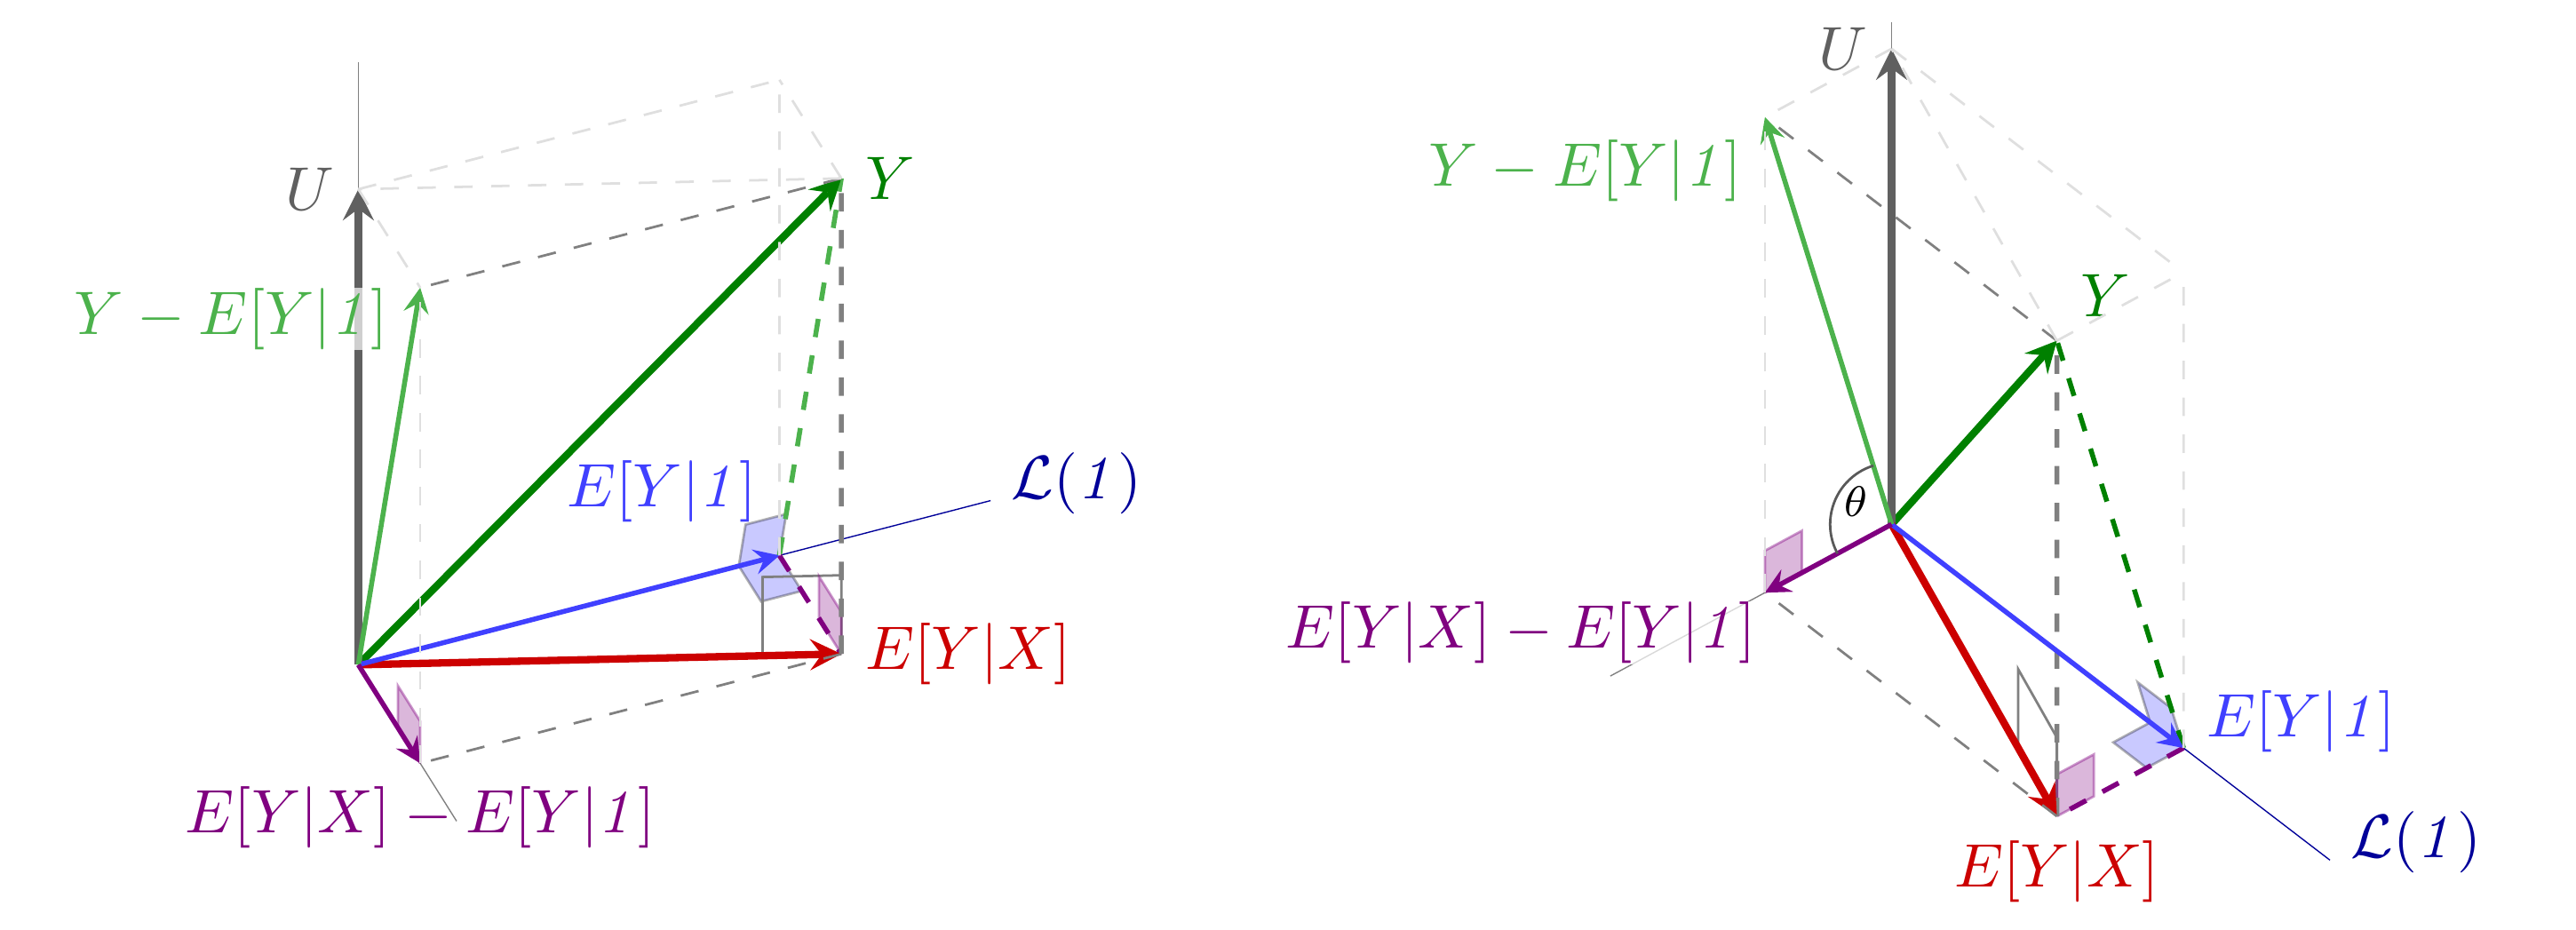
| Descomposición del vector de datos $\boldsymbol{y}$ | Descomposición variable aleatoria $Y$ |
|---|---|
| Vector ajustado: $\boldsymbol{\mathop{\widehat{y}}}$ | Esperanza Condicional: $E[Y\mid X]$ |
| Residuo: $\boldsymbol{\mathop{\widehat{e}}}=\boldsymbol{y}-\boldsymbol{\mathop{\widehat{y}}}$ | Perturbación: $U = Y - E[Y\mid X]$ |
El Modelo Clásico de Regresión Lineal (MCRL)
El MCRL consiste en imponer tres supuestos para que el modelo sea manejable:
- Linealidad de la esperanza condicional: $E[Y|X]$ cae en el plano $\mathcal{L}(\mathit{1},X)$: $$ E[Y|X] = \beta_1\,\mathit{1} + \beta_2 X. $$
La exogeneidad sale gratis: $U = Y - E[Y|X]$ es, por definición, ortogonal a toda función de $X$. Así que aquí $E[U|X]=\mathit{0}$ no es un supuesto: es un corolario.
Por tanto $\;Y=\beta_1\,\mathit{1} + \beta_2 X+U$, con $\mathrm{E}(U)=0$ y $\mathrm{Cov}(U,X) = 0$.
Independencia lineal de los regresores $(\mathrm{Var}(X)\neq0)$: $X$ no es constante con probabilidad 1.
Homocedasticidad (varianza condicional constante): la ``dispersión'' de $U$ no depende de $X$. $$ Var[U | X] = E[U^2|X] = \sigma^2\,\mathit{1} $$
Nomenclatura:
- $Y$ regresando
- $X$ y $\mathit{1}$ regresores
- $U$ perturbación (``otras cosas'').
Parámetros: Nótese que en el modelo no hay ``sombreros''
- $\beta_1$ y $\beta_2$ son parámetros poblacionales desconocidos
(no son los $\hat\beta_1$ y $\hat\beta_2$ de la lección 7).
Cuidado: Esta descomposición ortogonal no implica causalidad
La descomposición $Y = E[Y|X] + U$ es un hecho algebraico (una proyección ortogonal). Siempre existe (si las varianzas de $X$ e $Y$ son finitas).
Que el álgebra permita proyectar $Y$ sobre las funciones de $X$ NO significa que $X$ cause o ``explique'' $Y$.
- Sentido económico razonable: $Consumo = f(Renta) + U$. Tiene sentido pensar que la Renta determina el Consumo, y que $U$ agrupa otros factores (gustos, necesidades).
- Causalidad absurda (pero aceptable algebraicamente): $Superficie = f(Precio) + U$. Podemos proyectar la superficie de una casa sobre su precio. La matemática funcionará perfectamente. Pero asumir que ``variaciones del precio cambian el tamaño de la casa'' es absurdo.
La causalidad NO emana de los datos ni de la geometría. Debe provenir de una Teoría (Económica, Política, Sociológica, etc.) previa.
El salto: método de los momentos
En el modelo poblacional, los verdaderos parámetros $\beta_2$ y $\beta_1$ dependen de la geometría de la población (del producto escalar probabilístico $\langle \cdot, \cdot \rangle_P$): $$ \beta_2 \;=\; \frac{\mathrm{Cov}(X,Y)}{\mathrm{Var}(X)}, \qquad\qquad \beta_1 \;=\; \mathrm{E}(Y)-\beta_2\mathrm{E}(X). $$
Problema: Eros no conoce la población entera; aunque conoce algunos datos.
Solución (El Método de los Momentos): Sustituir los momentos poblacionales desconocidos ($\mathrm{E}(\cdot)$) por sus análogos muestrales ($\frac{1}{n}\sum$, es decir, usando el producto escalar estadístico $\langle \cdot, \cdot \rangle_s$ sobre los datos).
$$ \hat\beta_2 \;=\; \frac{\sigma_{\boldsymbol x\boldsymbol y}}{\sigma_{\boldsymbol x}^2}, \qquad\qquad \hat\beta_1 \;=\; \mu_{\boldsymbol y}-\hat\beta_2\mu_{\boldsymbol x}. $$¡Son las mismas fórmulas que derivamos en la lección 7! Mínimos Cuadrados Ordinarios (MCO) equivale al Método de los Momentos en el Modelo Clásico de Regresión Lineal.
Recapitulación y guiño a la lección siguiente
| $\mathbb{R}^n$ (dato conocido) | Variables aleatorias (a inferir) |
|---|---|
| vector de datos $\boldsymbol y$ | variable aleatoria $Y$ |
| $\mu_{\boldsymbol y}=\langle\boldsymbol y,\boldsymbol1\rangle_s$ | $\mathrm{E}(Y)=\langle Y,\mathit{1}\rangle_P$ |
| $\boldsymbol{\mathop{\overline y}}$ (vector constante) | $E[Y\mid \mathit{1}]$ (función constante) |
| $\boldsymbol{\mathop{\widehat y}}$ (proyección sobre $\mathcal L(\boldsymbol{1},\boldsymbol{x})$) | $E[Y\mid X]$ (proyección sobre las func. de $X$ y $\mathit{1}$) |
| $\boldsymbol{\mathop{\widehat e}}=\boldsymbol y-\boldsymbol{\mathop{\widehat y}}$ | $U=Y-E[Y\mid X]$ |
| $\sigma_{\boldsymbol y}^2=\Vert\boldsymbol y-\mu_{\boldsymbol y}\boldsymbol{1}\Vert_s^2$ | $\mathrm{Var}(Y)=\Vert Y-\mathrm{E}(Y)\,\mathit{1}\Vert_P^2$ |
| $\sigma_{\boldsymbol y}^2=\sigma_{\boldsymbol{\mathop{\widehat y}}}^2+\sigma_{\boldsymbol{\mathop{\widehat e}}}^2$ | $\mathrm{Var}(Y)=\mathrm{Var}(E[Y\mid X])+\mathrm{Var}(U)$ |
| $\hat\beta_1,\hat\beta_2$ (ajuste de una muestra) | $\beta_1,\beta_2$ (parámetros poblacionales, a estimar) |
Próximos pasos:
- Hasta ahora la variable $X$ era un único regresor (Regresión Simple).
- En economía real intervienen múltiples factores a la vez ($X_1, X_2, \dots, X_k$).
- Lección 10 (Regresión Múltiple): Ampliaremos la proyección del plano 2D a subespacios de mayor dimensión. Para manejar tantas condiciones de ortogonalidad, introduciremos una notación muy elegante: las matrices.