Lección 14. Colinealidad: cuando los regresores casi se alinean
Author: Marcos Bujosa
La lección 12 dejó enunciado que el error estándar de un coeficiente es $\mathfrak s/\Vert\tilde{\boldsymbol x}_j\Vert_e$, con $\tilde{\boldsymbol x}_j$ la parte propia del regresor. Hoy definimos esa parte propia, medimos cuánto se acorta cuando un regresor casi cae en el subespacio de los demás y leemos la consecuencia: coeficientes imprecisos e inestables, con un ajuste que no se mueve.
``El subespacio es estable; las coordenadas, no.''
De dónde venimos: el caso nox y lnox
La lección 13 dejó un caso sin explicar: en price sobre rooms, nox y lnox, los dos $t$ de la contaminación eran nulos y el $F$ de excluirlas juntas, $28{,}2$.
Lo que cambia al añadir lnox (hprice2, $n=506$):
Modelo (price sobre rooms y …) |
coef. de nox |
$\mathrm{ee}(\hat\beta_{\text{nox}})$ | $\mathfrak s$ |
|---|---|---|---|
… nox |
$-1884{,}7$ | $253{,}6$ | $6291{,}0$ |
… nox y lnox |
$404{,}2$ | $2198{,}9$ | $6290{,}4$ |
El error estándar se multiplica por $8{,}7$ y $\mathfrak s$ no cambia. La lección 12 enunció $\mathrm{ee}(\hat\beta_j)=\mathfrak s/\Vert\tilde{\boldsymbol x}_j\Vert_e$: lo que se ha acortado es $\tilde{\boldsymbol x}_{\text{nox}}$, la parte propia de nox.
Hoy: qué es $\tilde{\boldsymbol x}_j$, cuánto mide, qué le pasa al coeficiente y qué hacer.
Colinealidad exacta y colinealidad de grado
Exacta (lección 10): un regresor es combinación lineal de los demás. $\boldsymbol{\mathsf X}^\top\boldsymbol{\mathsf X}$ no es invertible; infinitos $\boldsymbol{\mathop{\widehat\beta}}$ dan el mismo ajuste. Ejemplo: temperatura en Celsius y en Fahrenheit.
De grado (hoy): un regresor es casi combinación lineal de los demás. Solución única, pero imprecisa e inestable.
Con dos regresores no constantes: $\rho_{\boldsymbol x_2\boldsymbol x_3}\to\pm1$, vectores en desviaciones casi alineados (lección 3: $\cos\theta\to\pm1$). Con más: alguno casi cae en el subespacio de los otros, y las correlaciones por parejas no bastan para verlo (lección 10).
No es una frontera: es una escala. La pregunta útil no es ``¿hay colinealidad?'' sino ``¿cuánto le cuesta a cada coeficiente?''.
La parte propia de un regresor
Proyectamos $\boldsymbol x_j$ sobre el subespacio de los demás regresores (constante incluida), como en la lección 10. El residuo de esa regresión auxiliar es la parte propia: $$ \boldsymbol x_j=\underbrace{\text{(combinación de los demás)}}_{\text{lo que comparte}}+\underbrace{\tilde{\boldsymbol x}_j}_{\text{lo propio}},\qquad \tilde{\boldsymbol x}_j\perp\text{ todos los demás regresores.} $$
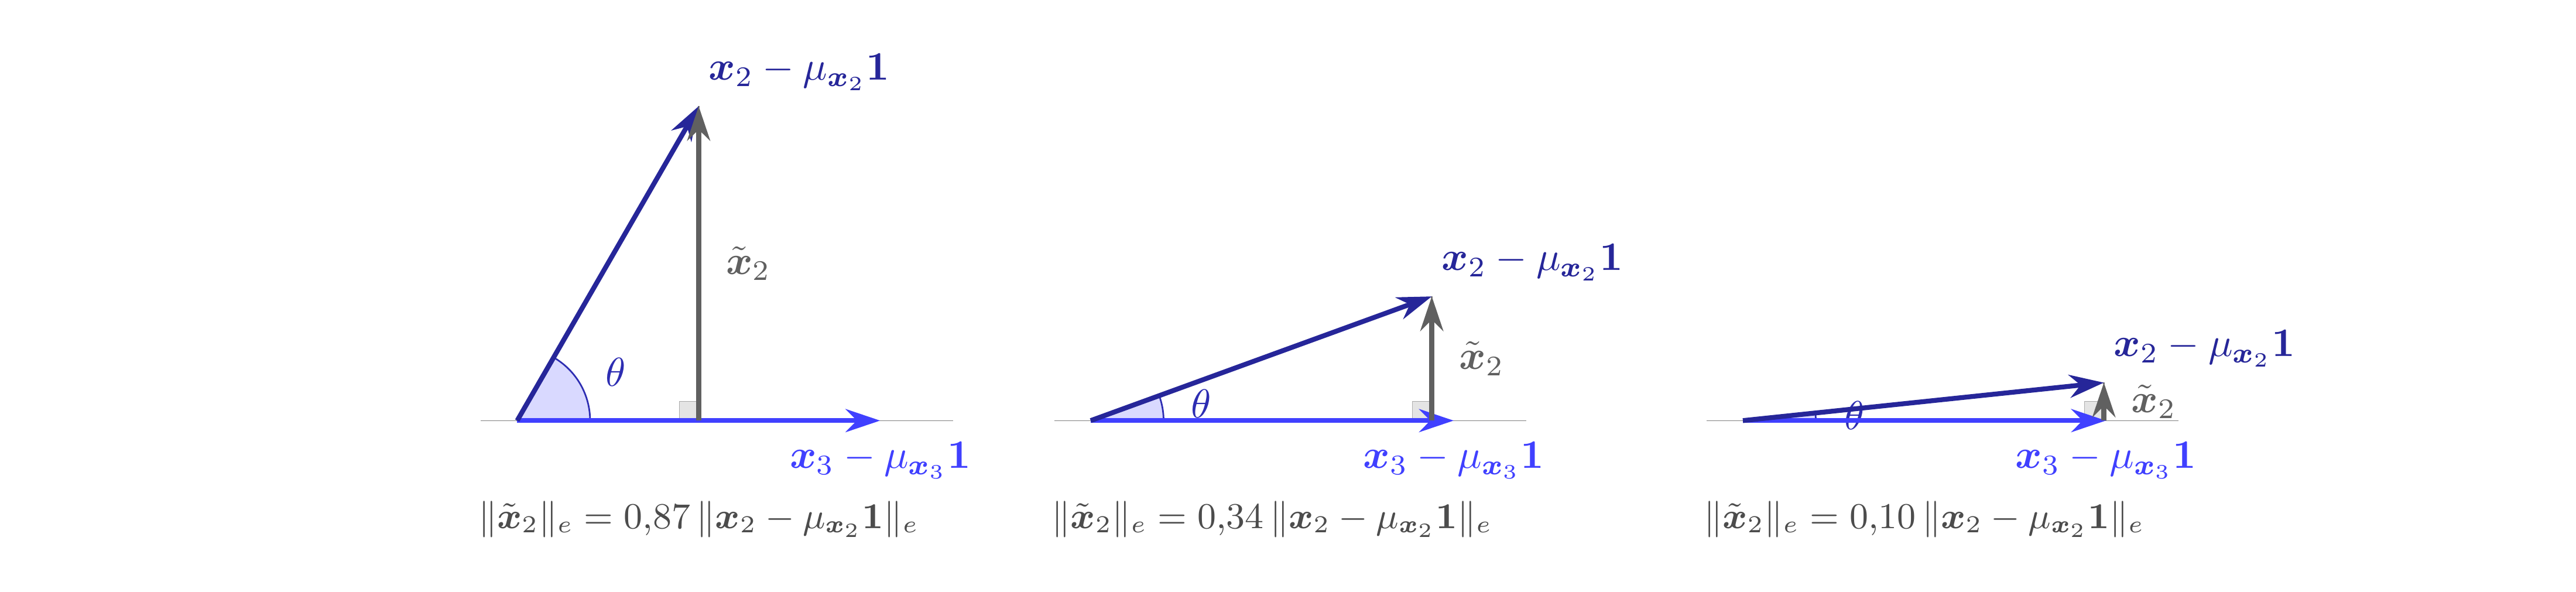
Enunciado en la lección 12 (sigue sin demostrarse): $\;\mathrm{ee}(\hat\beta_j)=\mathfrak s/\Vert\tilde{\boldsymbol x}_j\Vert_e$. Con un solo regresor no constante, $\tilde{\boldsymbol x}_2=\boldsymbol x_2-\mu_{\boldsymbol x_2}\boldsymbol 1$ y se recupera la lección 12.
Cuánto se acorta: el factor de inflación de la varianza
Pitágoras en la regresión auxiliar (lección 8), con $R_j^2$ su coeficiente de determinación: $$ \Vert\boldsymbol x_j-\mu_{\boldsymbol x_j}\boldsymbol 1\Vert_e^2=\mathrm{SEC}_j+\Vert\tilde{\boldsymbol x}_j\Vert_e^2 \;\Longrightarrow\; \boxed{\;\Vert\tilde{\boldsymbol x}_j\Vert_e=\Vert\boldsymbol x_j-\mu_{\boldsymbol x_j}\boldsymbol 1\Vert_e\,\sqrt{1-R_j^2}=\Vert\boldsymbol x_j-\mu_{\boldsymbol x_j}\boldsymbol 1\Vert_e\,\sin\theta_j.\;} $$
Sustituyendo en el error estándar: $$ \mathrm{ee}(\hat\beta_j)=\frac{\mathfrak s}{\Vert\boldsymbol x_j-\mu_{\boldsymbol x_j}\boldsymbol 1\Vert_e}\cdot\frac{1}{\sqrt{1-R_j^2}} =\underbrace{\frac{\mathfrak s}{\Vert\boldsymbol x_j-\mu_{\boldsymbol x_j}\boldsymbol 1\Vert_e}}_{\text{como si estuviera solo}}\cdot\sqrt{\mathrm{VIF}_j}, \qquad \mathrm{VIF}_j=\frac{1}{1-R_j^2}=\frac{1}{\sin^2\theta_j}. $$
Con $k=3$, $R_2^2=\rho_{\boldsymbol x_2\boldsymbol x_3}^2$:
| $\rho_{\boldsymbol x_2\boldsymbol x_3}$ | $\theta$ | $\mathrm{VIF}$ | $\sqrt{\mathrm{VIF}}$ |
|---|---|---|---|
| $0{,}5$ | $60^\circ$ | $1{,}3$ | $1{,}2$ |
| $0{,}9$ | $26^\circ$ | $5{,}3$ | $2{,}3$ |
| $0{,}99$ | $8^\circ$ | $50$ | $7{,}1$ |
| $0{,}999$ | $2{,}6^\circ$ | $500$ | $22$ |
El caso nox y lnox con números
Regresión auxiliar de nox sobre rooms y lnox (hprice2): $R_j^2=0{,}9879$.
| Cantidad | Valor |
|---|---|
| $\Vert\boldsymbol x_{\text{nox}}-\mu_{\text{nox}}\boldsymbol 1\Vert_e$ (longitud en desviaciones) | $26{,}03$ |
| $\sqrt{1-R_j^2}=\sin\theta_j$ | $0{,}1099$ |
| $\Vert\tilde{\boldsymbol x}_{\text{nox}}\Vert_e$ (parte propia) | $2{,}861$ |
| $\mathrm{VIF}=1/(1-R_j^2)$; $\sqrt{\mathrm{VIF}}$ | $82{,}8$; $9{,}10$ |
| $\mathfrak s/\Vert\tilde{\boldsymbol x}_{\text{nox}}\Vert_e=6290{,}37/2{,}861$ | $2198{,}9$ |
Es exactamente el error estándar de la tabla de Gretl. Sin lnox, la parte propia de nox (sobre $\boldsymbol 1$ y rooms) medía $24{,}81$: entrar lnox la divide por $8{,}7$.
En Gretl: comando vif tras estimar, o Análisis -> Colinealidad en la ventana del modelo. Devuelve $82{,}8$ para nox, $82{,}9$ para lnox y $1{,}1$ para rooms.
Por qué oscilan los coeficientes
$\boldsymbol{\mathop{\widehat y}}$ es la proyección sobre el subespacio: estable. $\hat\beta_2,\hat\beta_3$ son sus coordenadas respecto de los generadores: con generadores casi alineados, inestables.
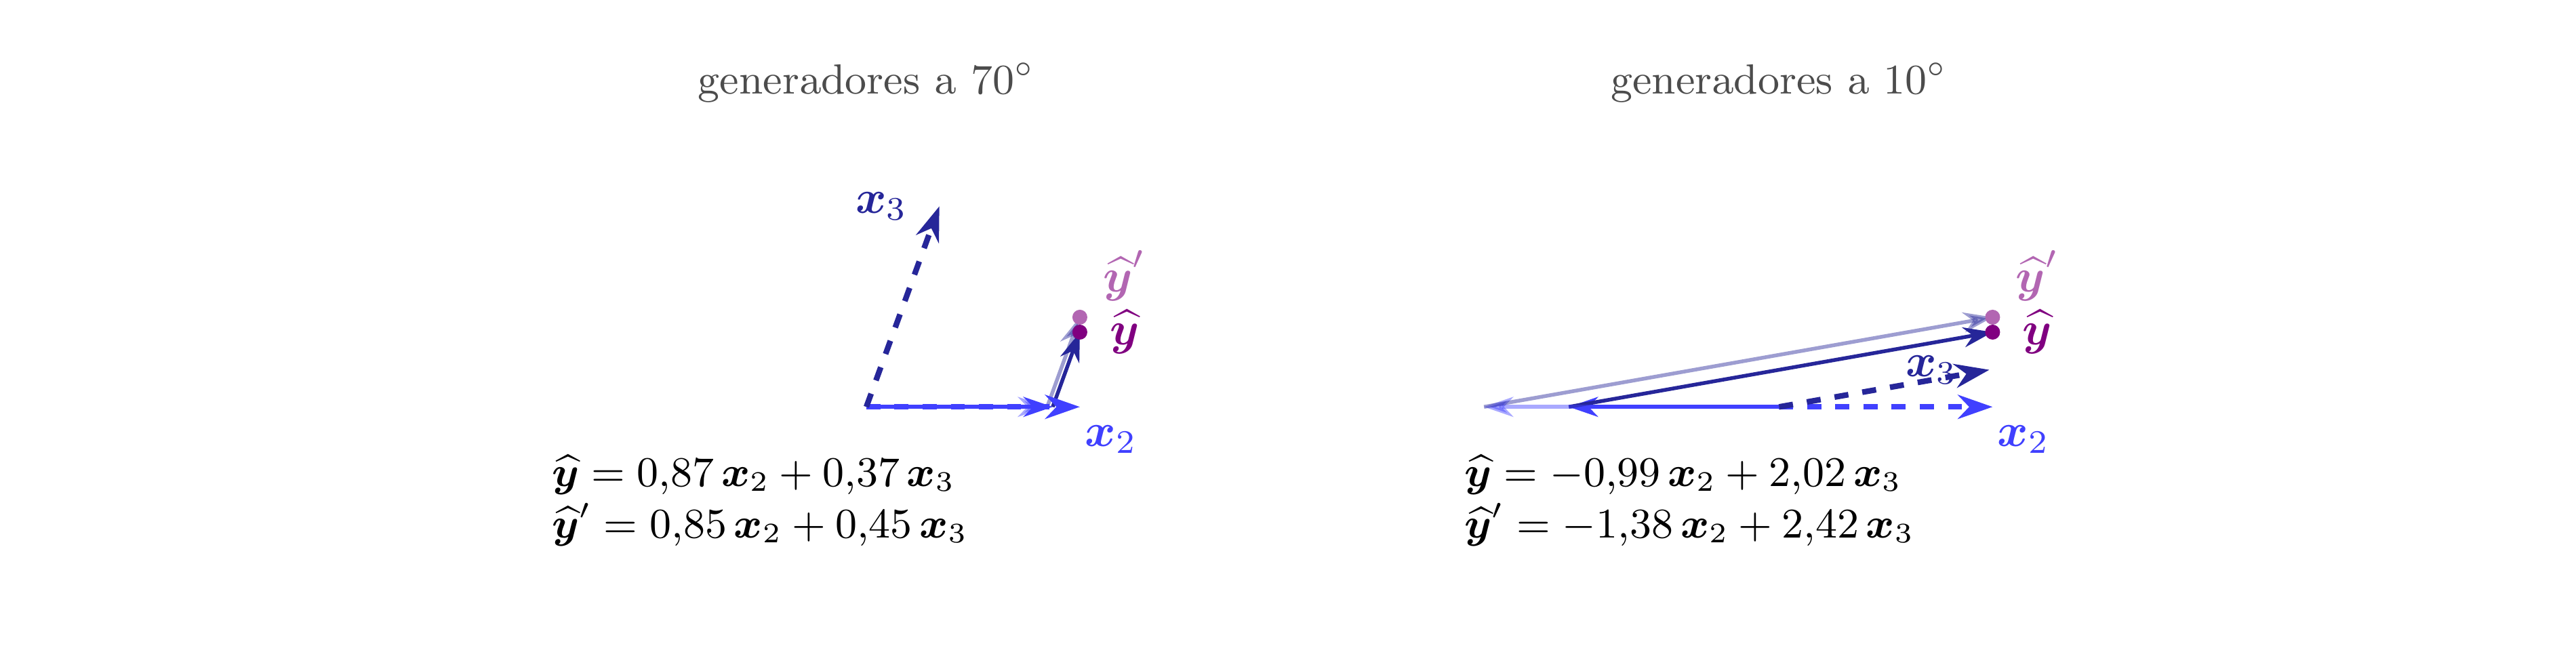
Un desplazamiento de $\boldsymbol{\mathop{\widehat y}}$ perpendicular a $\boldsymbol x_2$ mueve las coordenadas $1/\sin\theta=\sqrt{\mathrm{VIF}}$ veces más, y en sentidos opuestos: $\hat\beta_2$ y $\hat\beta_3$ se compensan. $\mathrm{SRC}$, $R^2$ y $F$ no se enteran.
Síntomas y diagnóstico
- $F$ conjunto alto con $t$ individuales bajos (lección 13), o $R^2$ alto con casi nada significativo.
- Errores estándar que se disparan al añadir un regresor, sin que cambie $\mathfrak s$.
- Coeficientes muy sensibles a quitar unas pocas observaciones o a añadir un regresor.
- Correlaciones altas entre regresores; pero con $k>3$ no bastan: el diagnóstico es el $\mathrm{VIF}_j$ de cada uno.
Una distinción: que un coeficiente cambie al añadir un regresor es normal, es el efecto parcial de la lección 10. Colinealidad es que su error estándar se dispare y que cambie mucho con poca información nueva.
Qué mirar: $\sqrt{\mathrm{VIF}_j}$, el factor por el que se ha multiplicado el error estándar de $\hat\beta_j$. Es una escala, no un veredicto.
Qué es y qué no es
No es una violación de los supuestos: MCO sigue insesgado y BLUE (lección 11) y los contrastes siguen siendo válidos (lección 12). Los errores estándar grandes son correctos: dicen la verdad sobre la muestra.
No estropea el ajuste, el $R^2$ ni la predicción: $\boldsymbol{\mathop{\widehat y}}$ es el mismo.
Es una propiedad de la muestra: falta variación propia. Es la misma enfermedad que tener pocos datos.
Para estimar el efecto de una variable hace falta que esa variable varíe por su cuenta.
Qué hacer y qué no
Más información: más observaciones, o datos en los que los regresores varíen por separado (en un experimento, dosis separadas).
Reformular: si dos variables miden lo mismo, quedarse con una o usar una combinación (nox o lnox: cualquiera de los dos modelos de la lección 13). Si la teoría da una restricción, imponerla y contrastarla con el $F$ (lección 13).
Reconocerlo: si la pregunta exige separar los efectos y la muestra no lo permite, decirlo e informar los intervalos.
Lo que no: eliminar los dos regresores ``porque no son significativos'' (lección 13), ni la eliminación secuencial por valor $p$. Fuera del curso: regresión ridge y componentes principales.
Recapitulación y guiño a las sesiones siguientes
| Pieza | Fórmula | Lectura geométrica |
|---|---|---|
| Parte propia | $\tilde{\boldsymbol x}_j$: residuo de $\boldsymbol x_j$ sobre los demás | lo que $\boldsymbol x_j$ no comparte |
| Su longitud | $\Vert\tilde{\boldsymbol x}_j\Vert_e=\Vert\boldsymbol x_j-\mu_{\boldsymbol x_j}\boldsymbol 1\Vert_e\sin\theta_j$ | cateto perpendicular al subespacio de los demás |
| Error estándar | $\mathfrak s/\Vert\tilde{\boldsymbol x}_j\Vert_e$ (enunciado) | ruido por unidad de longitud propia |
| VIF | $1/(1-R_j^2)=1/\sin^2\theta_j$ | inflación de la varianza; su raíz, del error estándar |
| Coeficientes | coordenadas de $\boldsymbol{\mathop{\widehat y}}$ | inestables si los generadores casi se alinean |
Demostrado: la longitud de la parte propia. Enunciado: el error estándar. Ningún supuesto nuevo, ningún supuesto violado.
Laboratorios: el $F$ con datos reales y simulados; y la colinealidad creciente en Monte Carlo, la regresión auxiliar de nox y el VIF. Lección 16: la trampa de las variables ficticias es colinealidad exacta con $\boldsymbol 1$.