Lección 4. Proyección ortogonal, media y desviación típica
Índice
- 1. De dónde venimos: la proyección ortogonal
- 2. El producto escalar en la estadística
- 3. La media: dos caras de la misma moneda
- 4. Ilustración geométrica de la proyección
- 5. El vector en desviaciones es ortogonal a \(\boldsymbol{1}\)
- 6. Desviación típica: como norma del vector en desviaciones
- 7. Ejemplos numéricos en \(\mathbb{R}^2\)
- 8. Propiedades geométricas
- 9. Recapitulación
- 10. Guiño a la sesión siguiente
- 11. Preguntas de repaso (sesión 5) htmlonly
- 12. Respuestas htmlonly
ἀγεωμέτρητος μηδεὶς εἰσίτω (``Nadie no-geómetra entre'' en el frontispicio de la academia de Platón)
La media aritmética y la desviación típica como objetos geométricos en \(\mathbb{R}^n\). La ortogonalidad como principio de cálculo.
1. De dónde venimos: la proyección ortogonal
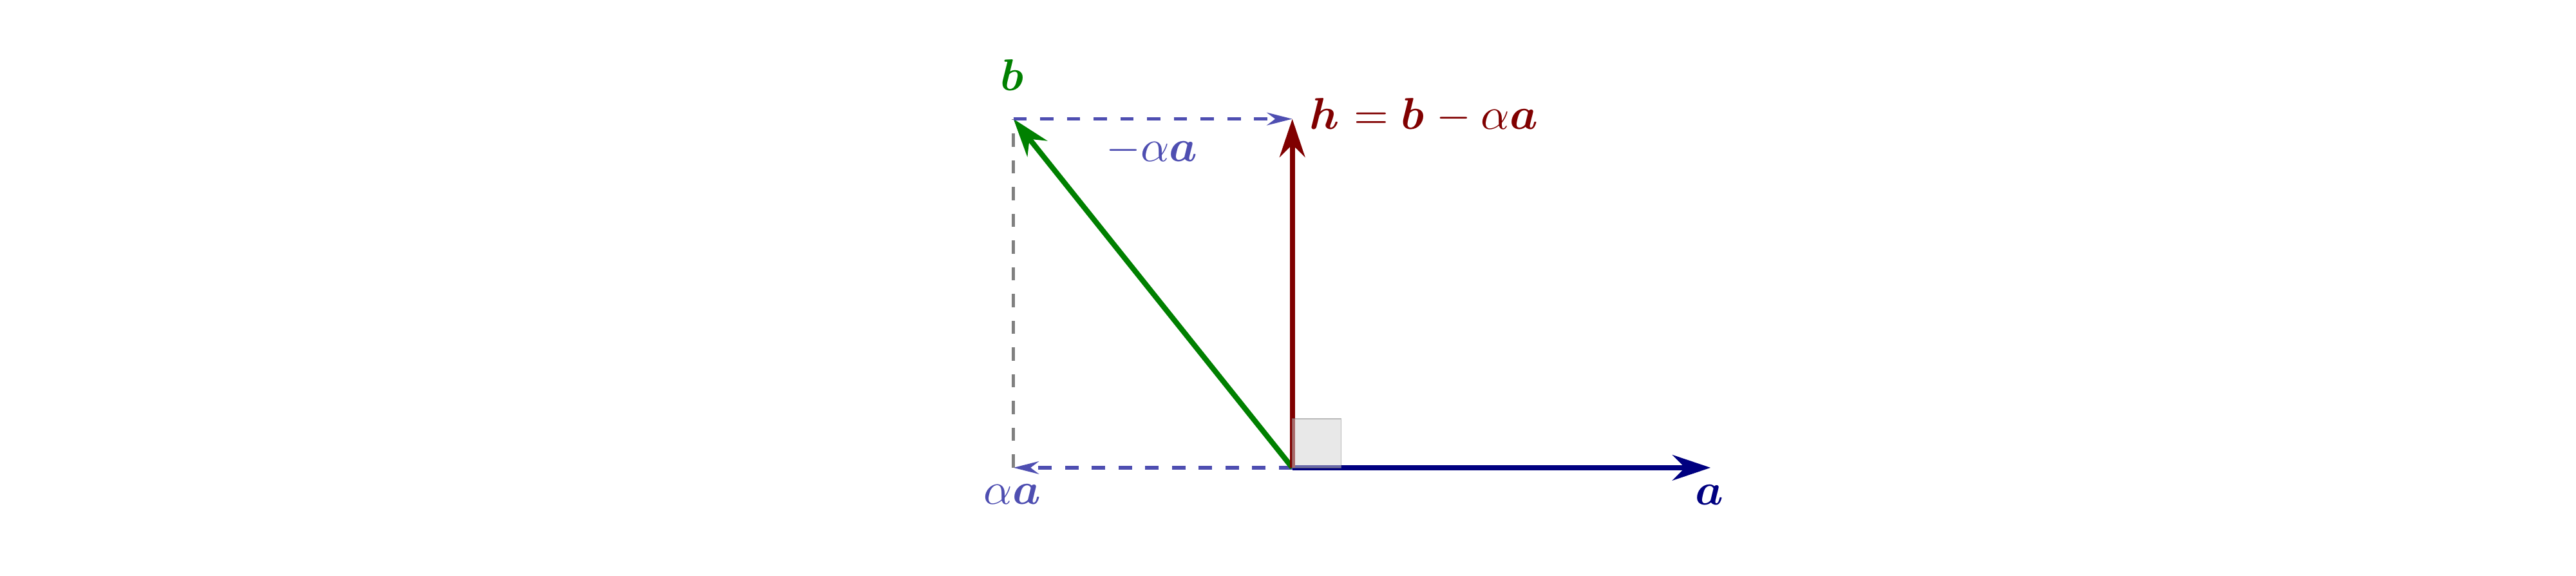
En la lección 3 construimos un vector \(\boldsymbol{h} = \boldsymbol{b} - \alpha\boldsymbol{a}\) ortogonal a \(\boldsymbol{a}\):
 \[
\langle\boldsymbol{a},\,\boldsymbol{h}\rangle = 0
\;\Longrightarrow\;
\alpha = \frac{\langle\boldsymbol{a},\,\boldsymbol{b}\rangle}{\langle\boldsymbol{a},\,\boldsymbol{a}\rangle};
\qquad
\boldsymbol{b} = \underbrace{\alpha\boldsymbol{a}}_{\text{``sombra''}} + \underbrace{\boldsymbol{h}}_{\perp\,\boldsymbol{a}}.
\]
Dijimos que cuando \(\boldsymbol{a} = \boldsymbol{1}\) ``ese \(\alpha\) resultará ser la media''.
El vector \(\alpha\boldsymbol{a}\), que llamamos ``sombra'' de \(\boldsymbol{b}\) sobre \(\boldsymbol{a}\), es lo que ahora
llamaremos proyección ortogonal. Veremos que:
- La media aritmética es fruto de una proyección ortogonal (sobre \(\mathcal{L}(\boldsymbol{1})\)).
- La desviación típica es una norma (distancia).
El principio que une ambos conceptos es la ortogonalidad.
De dónde venimos: la proyección ortogonal
En la lección 3, al demostrar la desigualdad de Cauchy–Schwarz, construimos el vector \(\boldsymbol{h} = \boldsymbol{b} - \alpha\boldsymbol{a}\) eligiendo \(\alpha\) para forzar la ortogonalidad \(\boldsymbol{h} \perp \boldsymbol{a}\). La condición \(\langle\boldsymbol{a},\,\boldsymbol{h}\rangle = 0\) determinaba unívocamente \[ \alpha = \frac{\langle\boldsymbol{a},\,\boldsymbol{b}\rangle}{\langle\boldsymbol{a},\,\boldsymbol{a}\rangle}, \] y el vector \(\alpha\boldsymbol{a}\) era la ``sombra'' de \(\boldsymbol{b}\) sobre la dirección de \(\boldsymbol{a}\). Anunciamos entonces que cuando \(\boldsymbol{a} = \boldsymbol{1}\) (el vector cuyas componentes son todas \(1\)), ese escalar \(\alpha\) resultaría ser la media aritmética de las componentes de \(\boldsymbol{b}\).
El vector \(\alpha\boldsymbol{a}\), con \(\alpha = \frac{\langle\boldsymbol{a},\,\boldsymbol{b}\rangle}{\langle\boldsymbol{a},\,\boldsymbol{a}\rangle}\), que en la lección 3 construimos como ``sombra'' de \(\boldsymbol{b}\) sobre la dirección de \(\boldsymbol{a}\), es lo que a partir de ahora llamaremos proyección ortogonal de \(\boldsymbol{b}\) sobre \(\mathcal{L}(\boldsymbol{a})\) (el conjunto de todos los múltiplos de \(\boldsymbol{a}\); geométricamente, una recta en \(\mathbb{R}^n\) que pasa por el origen). El nombre refleja que el vector diferencia \(\boldsymbol{h} = \boldsymbol{b} - \alpha\boldsymbol{a}\) es ortogonal a \(\boldsymbol{a}\), que es precisamente la condición que usamos para determinar \(\alpha\).
En la lección 3 anunciamos también que ``ajustar por mínimos cuadrados es minimizar la distancia \(\|\boldsymbol{y}-\boldsymbol{\mathop{\widehat{y}}}\|\)''. La proyección ortogonal es, por construcción, el múltiplo de \(\boldsymbol{a}\) más cercano a \(\boldsymbol{b}\), es decir, \(\alpha\boldsymbol{a}\) es el punto de \(\mathcal{L}(\boldsymbol{a})\) el que minimiza \(\|\boldsymbol{b} - \alpha\boldsymbol{a}\|\). No hace falta ningún cálculo adicional: la ortogonalidad es la condición de mínimo.
Hoy cumplimos esa promesa. Pero antes de hacerlo, necesitamos ajustar el producto escalar que usamos: el producto escalar estándar de \(\mathbb{R}^n\) no es el adecuado para trabajar en estadística. Ya anticipamos al final de la lección 2 que existía una ``norma estadística'' con un factor \(\frac{1}{n}\), y que serviría para que el vector \(\boldsymbol{1}\) tuviera norma \(1\). Ahora precisamos esa idea y la elevamos a producto escalar. En cuanto lo ajustemos, todo encajará.
2. El producto escalar en la estadística
Con el producto escalar estándar, \(\|\boldsymbol{1}\|_e^2 = \langle\boldsymbol{1},\boldsymbol{1}\rangle_e = \sum\nolimits_{i=1}^n 1 = n \neq 1\).
Exigencia estadística: la media de un vector constante \(c\) debe ser \(c\). Equivalentemente: \(\|\boldsymbol{1}\|=1\).
La solución: un nuevo producto escalar con factor de corrección \(\frac{1}{n}\): \[ \langle\boldsymbol{x},\boldsymbol{y}\rangle_{s} = \frac{1}{n}\,\langle\boldsymbol{x},\boldsymbol{y}\rangle_{e} = \frac{1}{n}\sum_{i=1}^n x_i y_i. \]
Ahora \(\|\boldsymbol{1}\|_s^2 = \langle\boldsymbol{1},\boldsymbol{1}\rangle_s = \frac{1}{n} n = 1\), como queríamos.
- Hereda las propiedades de producto escalar: simetría, linealidad, definido positivo.
- La norma asociada: \(\|\boldsymbol{x}\|_s = \sqrt{\langle\boldsymbol{x},\boldsymbol{x}\rangle_s} = \sqrt{\frac{1}{n}\sum x_i^2}\).
- La ortogonalidad: \(\boldsymbol{x}\perp\boldsymbol{y} \Leftrightarrow {\langle\boldsymbol{x},\boldsymbol{y}\rangle}_e = 0 \Leftrightarrow {\langle\boldsymbol{x},\boldsymbol{y}\rangle}_s = 0\).
- Por tanto, el Teorema de Pitágoras, Cauchy–Schwarz y la desigualdad triangular de la lección 3 siguen siendo válidos con \(\langle\cdot,\cdot\rangle_s\) y \(\|\cdot\|_s\).
El producto escalar de la estadística
¿Por qué necesitamos un producto escalar distinto? La respuesta viene de una exigencia estadística muy natural, que ya anticipamos al final de la lección 2.
La media aritmética de un vector constante igual a \(c\) debe ser \(c\) (el valor que mejor representa el centro de la distribución de los datos); en particular, la media del vector \(\boldsymbol{1} = (1,1,\ldots,1)\) debe ser \(1\).
Esto se logra empleando un nuevo producto escalar, que aplica un factor de corrección \(1/n\). Con dicho producto escalar, \(\langle\boldsymbol{x},\boldsymbol{y}\rangle_s = \frac{1}{n}\sum x_iy_i\), la norma de \(\boldsymbol{1}\) es efectivamente \(1\):
\[ \|\boldsymbol{1}\|_s^2 = \langle\boldsymbol{1},\boldsymbol{1}\rangle_s = \frac{1}{n}\sum_{i=1}^n 1 = 1 \quad\iff\quad \|\boldsymbol{1}\|_s = 1 \]
Esta norma no solo garantiza que \(\|\boldsymbol{1}\|_s = 1\), además hace que la media aritmética de \(\boldsymbol{y}\) sea el producto escalar (de la estadística) entre \(\boldsymbol{y}\) y \(\boldsymbol{1}\):
\[\langle\boldsymbol{y},\boldsymbol{1}\rangle_s = \frac{1}{n}\sum y_i = \mu_{\boldsymbol{y}}.\]
Una observación importante: la condición de ortogonalidad no cambia. \(\langle\boldsymbol{x},\boldsymbol{y}\rangle_s = 0\) si y solo si \(\langle\boldsymbol{x},\boldsymbol{y}\rangle_e = 0\), porque el factor \(\frac{1}{n} > 0\) nunca se anula. Así que todas las nociones de ortogonalidad que hemos desarrollado en las lecciones 2 y 3 siguen siendo válidas, sin ninguna modificación.
Más en general: las demostraciones del teorema de Pitágoras, la desigualdad de Cauchy–Schwarz y la desigualdad triangular que realizamos en la lección 3 no utilizan ninguna propiedad específica del producto escalar euclídeo \(\langle\boldsymbol{x},\boldsymbol{y}\rangle_e\). Solo utilizan tres propiedades abstractas: simetría (\(\langle\boldsymbol{x},\boldsymbol{y}\rangle = \langle\boldsymbol{y},\boldsymbol{x}\rangle\)), linealidad en cada argumento y positividad (\(\langle\boldsymbol{x},\boldsymbol{x}\rangle \geq 0\), con igualdad solo si \(\boldsymbol{x}=\boldsymbol{0}\)). El producto escalar estadístico \(\langle\boldsymbol{x},\boldsymbol{y}\rangle_s = \frac{1}{n}\langle\boldsymbol{x},\boldsymbol{y}\rangle_e\) hereda las tres propiedades del euclídeo; por tanto, todos los resultados de la lección 3 siguen siendo válidos con este nuevo producto escalar y su norma asociada \(\|\cdot\|_s\), sin necesidad de modificar ninguna demostración.
Nota. En las lecciones 2 y 3 sembramos esta distinción: hablamos de la ``norma euclídea'' \(\sqrt{\langle\boldsymbol{x},\boldsymbol{x}\rangle_e}\) y de la ``norma estadística'' \(\sqrt{\frac{1}{n}\langle\boldsymbol{x},\boldsymbol{x}\rangle_e}\). A partir de ahora, cuando trabajemos con datos estadísticos, usaremos siempre el producto escalar con factor \(\frac{1}{n}\). El factor \(\frac{1}{n}\) que aparece en la varianza, en la covarianza y en la fórmula de la correlación no es una convención arbitraria: es la consecuencia de exigir que \(\|\boldsymbol{1}\|_s = 1\).
3. La media: dos caras de la misma moneda
Primera cara: la media como producto escalar con \(\boldsymbol{1}\). \[ \mu_{\boldsymbol{y}} \;=\; \langle\boldsymbol{y}, \boldsymbol{1}\rangle_s \;=\; \frac{1}{n}\sum_{i=1}^n y_i. \]
Segunda cara: la media como proyección ortogonal sobre \(\mathcal{L}(\boldsymbol{1})\) (los múltiplos de \(\boldsymbol{1}\)).
Buscamos \(\alpha\) tal que \((\boldsymbol{y} - \alpha\boldsymbol{1})\perp\boldsymbol{1}\): \[ \langle\boldsymbol{y} - \alpha\boldsymbol{1},\, \boldsymbol{1}\rangle_s = 0 \;\Longrightarrow\; \langle\boldsymbol{y},\boldsymbol{1}\rangle_s - \alpha\,\langle\boldsymbol{1},\boldsymbol{1}\rangle_s = 0 \;\Longrightarrow\; \alpha = \frac{\langle\boldsymbol{y},\boldsymbol{1}\rangle_s}{\langle\boldsymbol{1},\boldsymbol{1}\rangle_s} = \frac{\mu_{\boldsymbol{y}}}{1} = \mu_{\boldsymbol{y}}. \] (Ambas caras colapsan: \(\alpha = \mu_{\boldsymbol{y}}\).)
Llamaremos vector de medias \(\boldsymbol{\mathop{\overline{y}}} = \mu_{\boldsymbol{y}}\boldsymbol{1}\) al vector constante cuyas componentes son todas iguales a \(\mu_{\boldsymbol{y}}\). El vector de medias \(\boldsymbol{\mathop{\overline{y}}}\) es la proyección ortogonal de \(\boldsymbol{y}\) sobre \(\mathcal{L}(\boldsymbol{1})\).
La media: dos caras de la misma moneda
La media aritmética admite dos lecturas geométricas, y conviene tenerlas claras porque reaparecerán en cada paso del curso.
Primera cara: la media como producto escalar.
Con el producto escalar estadístico, la media de \(\boldsymbol{y}\) es directamente su producto escalar con \(\boldsymbol{1}\): \[ \mu_{\boldsymbol{y}} = \langle\boldsymbol{y}, \boldsymbol{1}\rangle_s = \frac{1}{n}\sum_{i=1}^n y_i \cdot 1 = \frac{1}{n}\sum_{i=1}^n y_i. \] Esta lectura es algebraica: la media es una operación lineal sobre \(\boldsymbol{y}\).
Segunda cara: la media como proyección ortogonal.
Llamamos \(\mathcal{L}(\boldsymbol{1})\) al conjunto de todos los múltiplos de \(\boldsymbol{1}\); geométricamente, es una recta en \(\mathbb{R}^n\) que pasa por el origen. Queremos encontrar el punto de \(\mathcal{L}(\boldsymbol{1})\) más cercano a \(\boldsymbol{y}\), es decir, el escalar \(\alpha\) tal que \(\alpha\boldsymbol{1}\) minimiza la distancia \(\|\boldsymbol{y} - \alpha\boldsymbol{1}\|_s\). Como aprendimos en la lección 3, el punto más cercano de una recta a un vector es la proyección ortogonal: la diferencia \(\boldsymbol{y} - \alpha\boldsymbol{1}\) (que en unas transparencias llamaremos vector en desviaciones) debe ser ortogonal a \(\boldsymbol{1}\).
Imponemos la condición de ortogonalidad: \[ \langle\boldsymbol{y} - \alpha\boldsymbol{1},\, \boldsymbol{1}\rangle_s = 0. \] Usando la linealidad del producto escalar: \[ \langle\boldsymbol{y},\boldsymbol{1}\rangle_s - \alpha\,\langle\boldsymbol{1},\boldsymbol{1}\rangle_s = 0 \;\Longrightarrow\; \alpha = \frac{\langle\boldsymbol{y},\boldsymbol{1}\rangle_s}{\langle\boldsymbol{1},\boldsymbol{1}\rangle_s} = \frac{\mu_{\boldsymbol{y}}}{1} = \mu_{\boldsymbol{y}}. \]
El resultado es el mismo: \(\alpha = \mu_{\boldsymbol{y}}\). Pero la vía geométrica revela por qué la media tiene esa forma: es la única manera de que \(\boldsymbol{y} - \alpha\boldsymbol{1}\) sea ortogonal a \(\boldsymbol{1}\), y esa ortogonalidad es lo que caracteriza al punto más cercano.
Llamamos vector de medias al vector \(\boldsymbol{\mathop{\overline{y}}} = \mu_{\boldsymbol{y}}\boldsymbol{1}\): es la proyección de \(\boldsymbol{y}\) sobre \(\mathcal{L}(\boldsymbol{1})\) y, por tanto, el vector constante más próximo a \(\boldsymbol{y}\); sus componentes son todas iguales a \(\mu_{\boldsymbol{y}}\).
Conviene dar nombre también a lo que queda fuera de la recta. El complemento ortogonal de \(\mathcal{L}(\boldsymbol{1})\), que denotamos \(\mathcal{L}(\boldsymbol{1})^\perp\), es el conjunto de todos los vectores ortogonales a \(\boldsymbol{1}\); es decir —recordando que \(\mu_{\boldsymbol{v}}=\langle\boldsymbol{v},\boldsymbol{1}\rangle_s\)—, el conjunto de vectores de media nula: \(\boldsymbol{v}\in\mathcal{L}(\boldsymbol{1})^\perp \Leftrightarrow \mu_{\boldsymbol{v}}=0\).
La vía analítica, presentada aquí como alternativa.
El mismo resultado se obtiene minimizando directamente \(f(\alpha) = \|\boldsymbol{y} - \alpha\boldsymbol{1}\|_s^2 = \frac{1}{n}\sum_{i=1}^n(y_i - \alpha)^2\). Derivando respecto a \(\alpha\) e igualando a cero:
\begin{equation} \frac{df}{d\alpha} = \frac{1}{n}\sum_{i=1}^n 2(y_i - \alpha)(-1) = 0 \;\Longrightarrow\; \sum_{i=1}^n(y_i - \alpha) = 0 \;\Longrightarrow\; \alpha = \frac{1}{n}\sum_{i=1}^n y_i = \mu_{\boldsymbol{y}}. \label{eq:condicionPrimerOrden} \end{equation}La condición de primer orden nos da un punto crítico, pero no nos dice si se trata de un mínimo o de un máximo. La vía geométrica no tenía esta ambigüedad: la proyección ortogonal es, por construcción, el punto de \(\mathcal{L}(\boldsymbol{1})\) (es decir, el vector constante) más cercano a \(\boldsymbol{y}\), de modo que el carácter mínimo de la solución quedaba garantizado desde el principio. En la vía analítica, en cambio, debemos comprobarlo explícitamente mediante la condición de segundo orden. Calculando la segunda derivada (que vio en cálculo): \[ \frac{d^2f}{d\alpha^2} = \frac{1}{n}\sum_{i=1}^n 2 = 2 > 0. \] La segunda derivada es estrictamente positiva (e independiente de \(\alpha\)), lo que confirma que la función \(f\) es convexa y que el punto crítico encontrado es efectivamente un mínimo global.
El resultado (\ref{eq:condicionPrimerOrden}) coincide con el obtenido por la vía geométrica. Pero nótese que la condición \(\sum_{i=1}^n(y_i - \alpha) = 0\) no es sino \(\langle\boldsymbol{y} - \alpha\boldsymbol{1}, \boldsymbol{1}\rangle_s = 0\) escrita en términos de sumatorios: la condición de primer orden del problema de minimización es la condición de ortogonalidad. Ambas vías son la misma cosa vista desde ángulos distintos. La vía geométrica es más directa, y su lógica se generalizará sin esfuerzo a la regresión múltiple, donde la vía analítica se vuelve considerablemente más engorrosa.
Mensaje central: calcular la media aritmética es, sin saberlo, resolver un problema de proyección ortogonal. Más adelante veremos que la regresión lineal simple es el mismo procedimiento, pero proyectando sobre un plano en lugar de sobre una recta. Y la regresión múltiple, sobre un subespacio de dimensión mayor. La lógica es siempre la misma: imponer ortogonalidad.
Para profundizar:
- Strang, G. Introduction to Linear Algebra (2016), §4.2. El tratamiento de la proyección sobre una recta como caso particular de mínimos cuadrados.
- Bujosa, M. Curso de Álgebra Lineal, capítulo 11: libro online.
4. Ilustración geométrica de la proyección
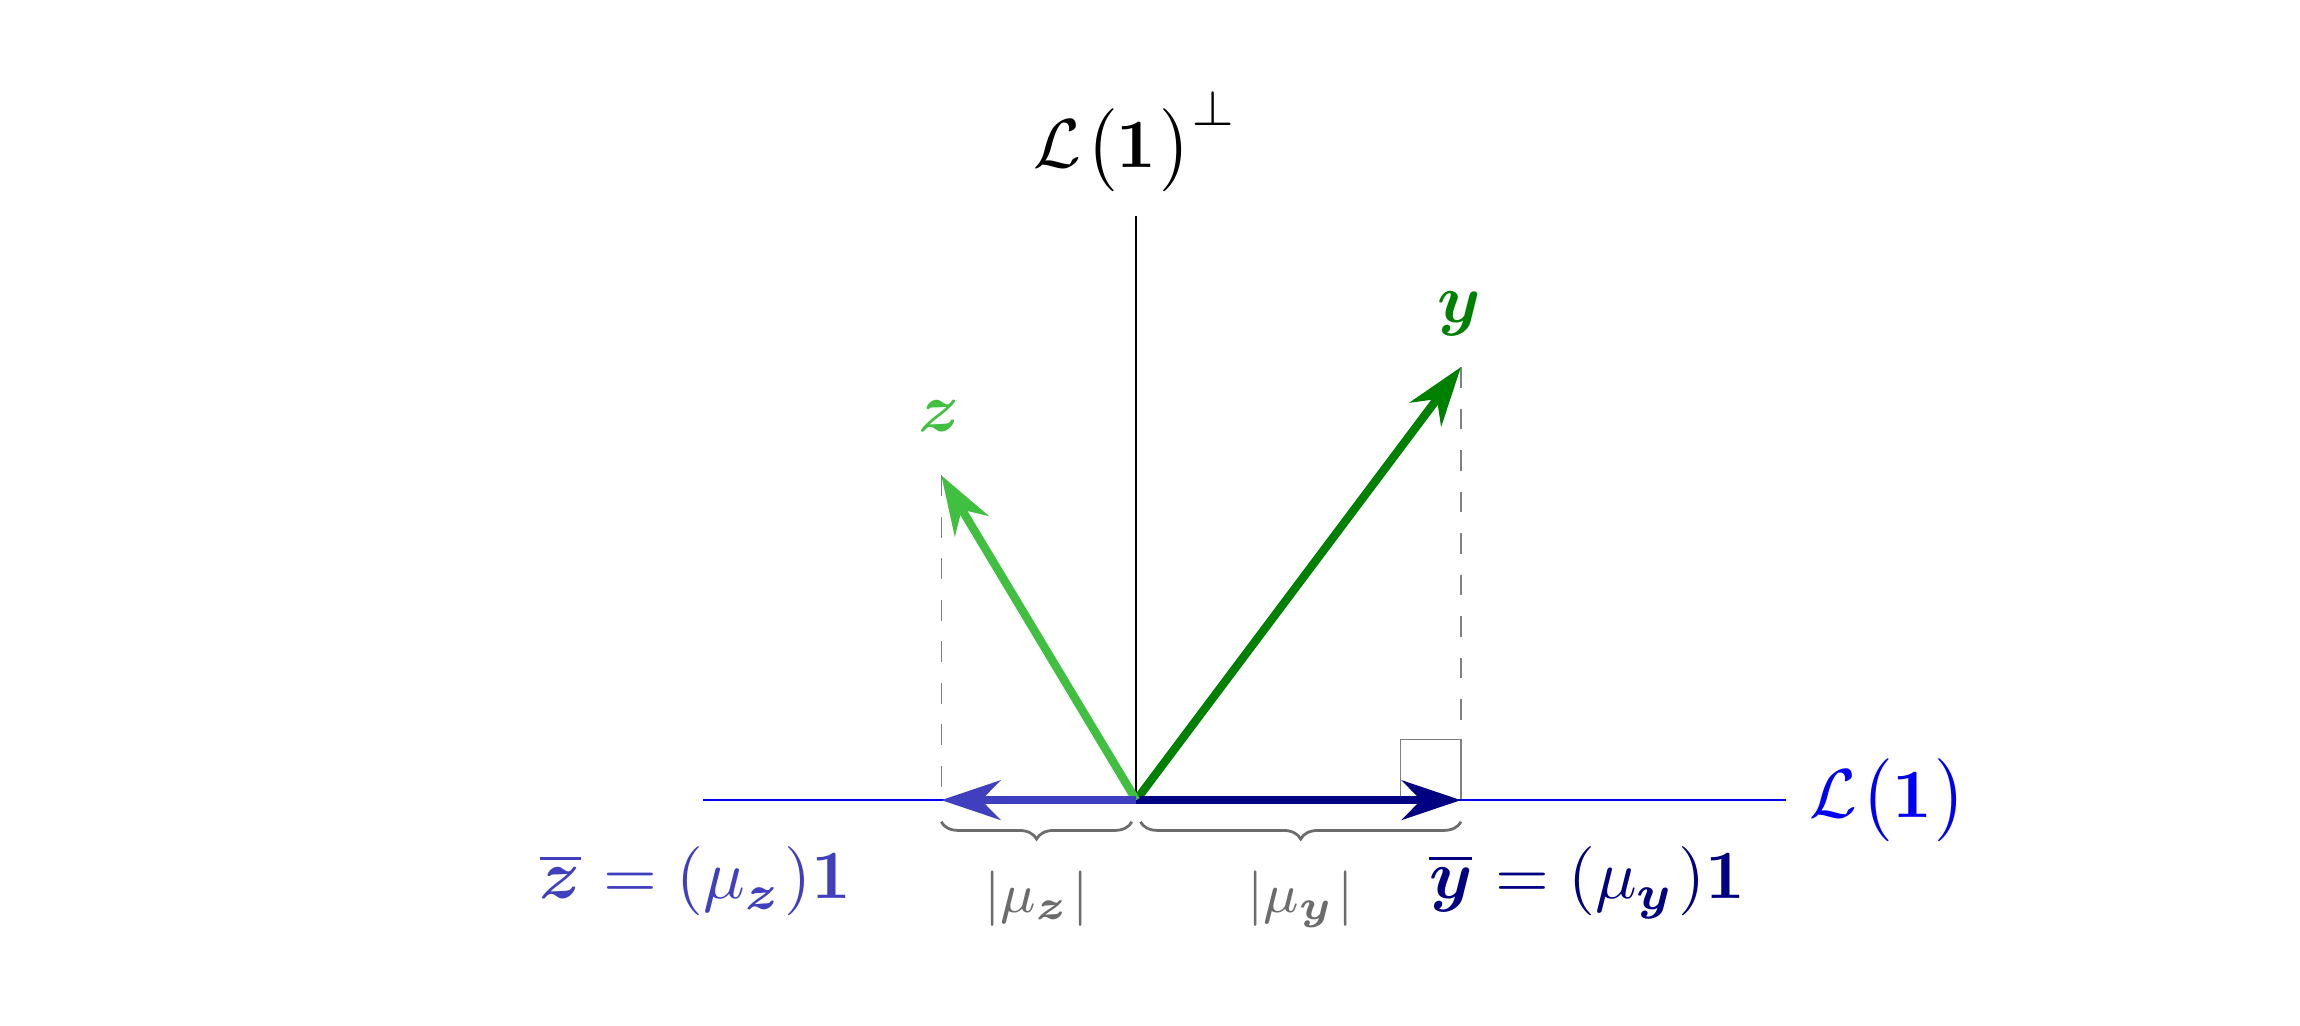
El vector \(\boldsymbol{y}\) (verde oscuro) se proyecta sobre \(\mathcal{L}(\boldsymbol{1})\) (la recta de los vectores constantes, en azul). La ``sombra'' \(\boldsymbol{\mathop{\overline{y}}} = \mu_{\boldsymbol{y}}\boldsymbol{1}\) es su correspondiente vector de medias, cuya longitud es \(|\mu_{\boldsymbol{y}}|\). El vector \(\boldsymbol{z}\) (verde claro) es otro ejemplo con media negativa.
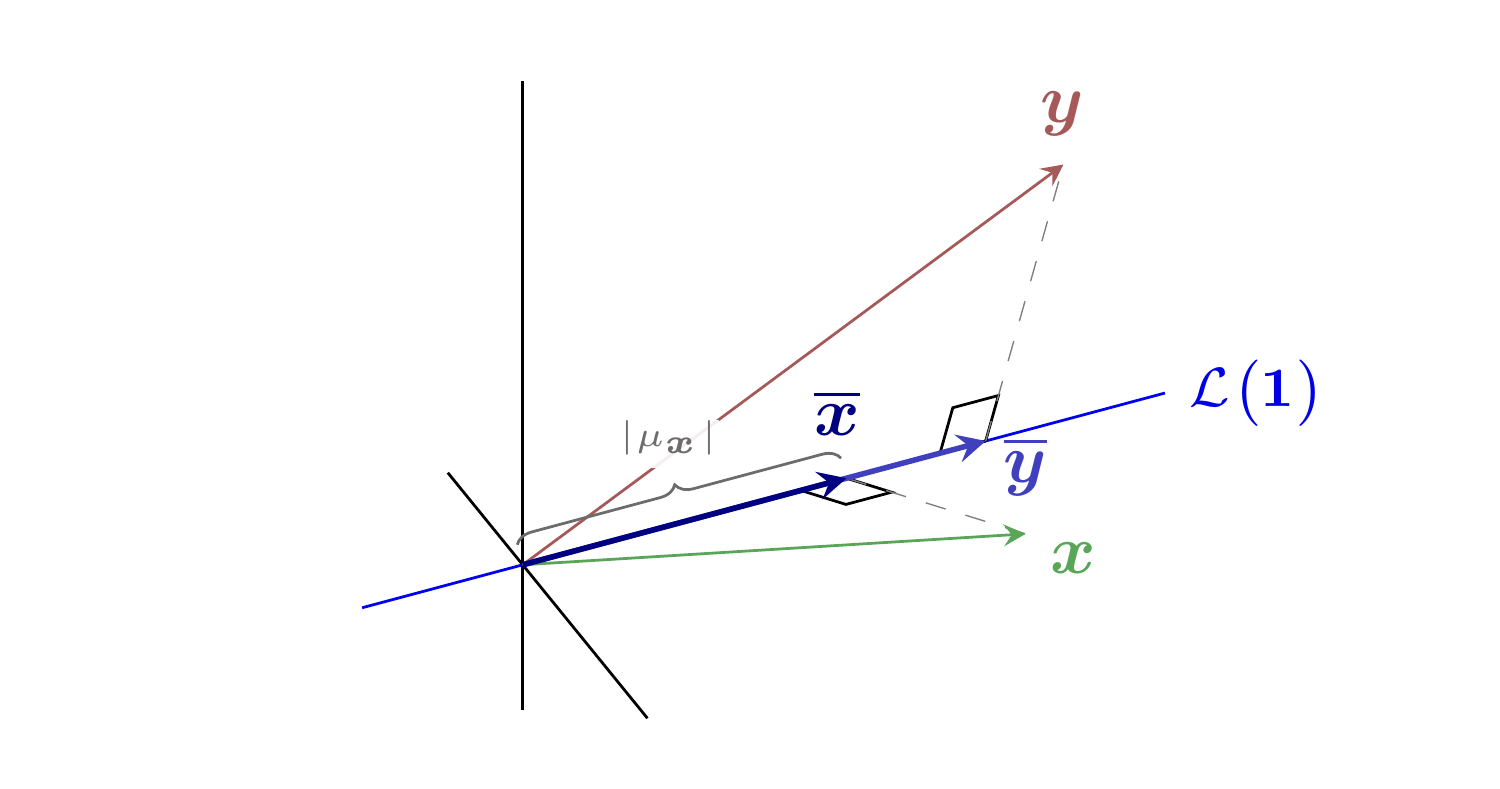
Representación de dos vectores, \(\boldsymbol{y}\) (rojo) y \(\boldsymbol{x}\) (verde claro), y sus proyecciones ortogonales sobre \(\mathcal{L}(\boldsymbol{1})\); es decir, sus correspondientes vectores de medias \(\boldsymbol{\mathop{\overline{y}}}\) y \(\boldsymbol{\mathop{\overline{x}}}\). Los ejes de color negro son perpendiculares a \(\boldsymbol{1}\), es decir, pertenecen al complemento ortogonal \(\mathcal{L}(\boldsymbol{1})^\perp\): el conjunto de todos los vectores perpendiculares a \(\boldsymbol{1}\).
Ilustración geométrica de la proyección
Las figuras anteriores ilustran la geometría de la proyección ortogonal sobre \(\mathcal{L}(\boldsymbol{1})\) en espacios de dimensiones 2 y 3 (donde podemos dibujar).
Primera figura. La recta azul es \(\mathcal{L}(\boldsymbol{1}) = \{(a,a) \mid a \in \mathbb{R}\}\). La recta negra vertical es su complemento ortogonal \(\mathcal{L}(\boldsymbol{1})^\perp\) (el conjunto de vectores perpendiculares a \(\boldsymbol{1}\)). El vector \(\boldsymbol{\mathop{\overline{y}}} = \mu_{\boldsymbol{y}}\boldsymbol{1}\) (azul) es la proyección ortogonal (la ``sombra'') del verde oscuro \(\boldsymbol{y}\). La figura muestra también un vector \(\boldsymbol{z}\) con media negativa: por ello su proyección cae en el lado opuesto del origen.
Segunda figura (representación en un espacio de dimensión mayor). La recta azul es el conjunto de vectores constantes \(\mathcal{L}(\boldsymbol{1})\). El complemento ortogonal \(\mathcal{L}(\boldsymbol{1})^\perp\) es ahora un plano que pasa por el origen y es perpendicular a la recta azul. Los vectores \(\boldsymbol{y}\) (rojo) y \(\boldsymbol{x}\) (verde) tienen proyecciones distintas sobre la recta azul, correspondientes a sus respectivas medias.
Una observación importante sobre los límites de la visualización: en la práctica trabajamos con \(n\) observaciones, así que los vectores de datos viven en \(\mathbb{R}^n\) con \(n\) posiblemente muy grande. No podemos dibujar \(\mathbb{R}^{100}\), pero la geometría es la misma: \(\mathcal{L}(\boldsymbol{1})\) sigue siendo una recta, su complemento ortogonal sigue siendo un subespacio de dimensión \(n-1\)1, y la proyección sigue siendo el vector de medias. Aunque las figuras anteriores son representaciones literales en \(\mathbb{R}^2\) y \(\mathbb{R}^3\), podemos interpretarlas como representaciones esquemáticas de la geometría general.
4.1. Ilustración con la visión estadística
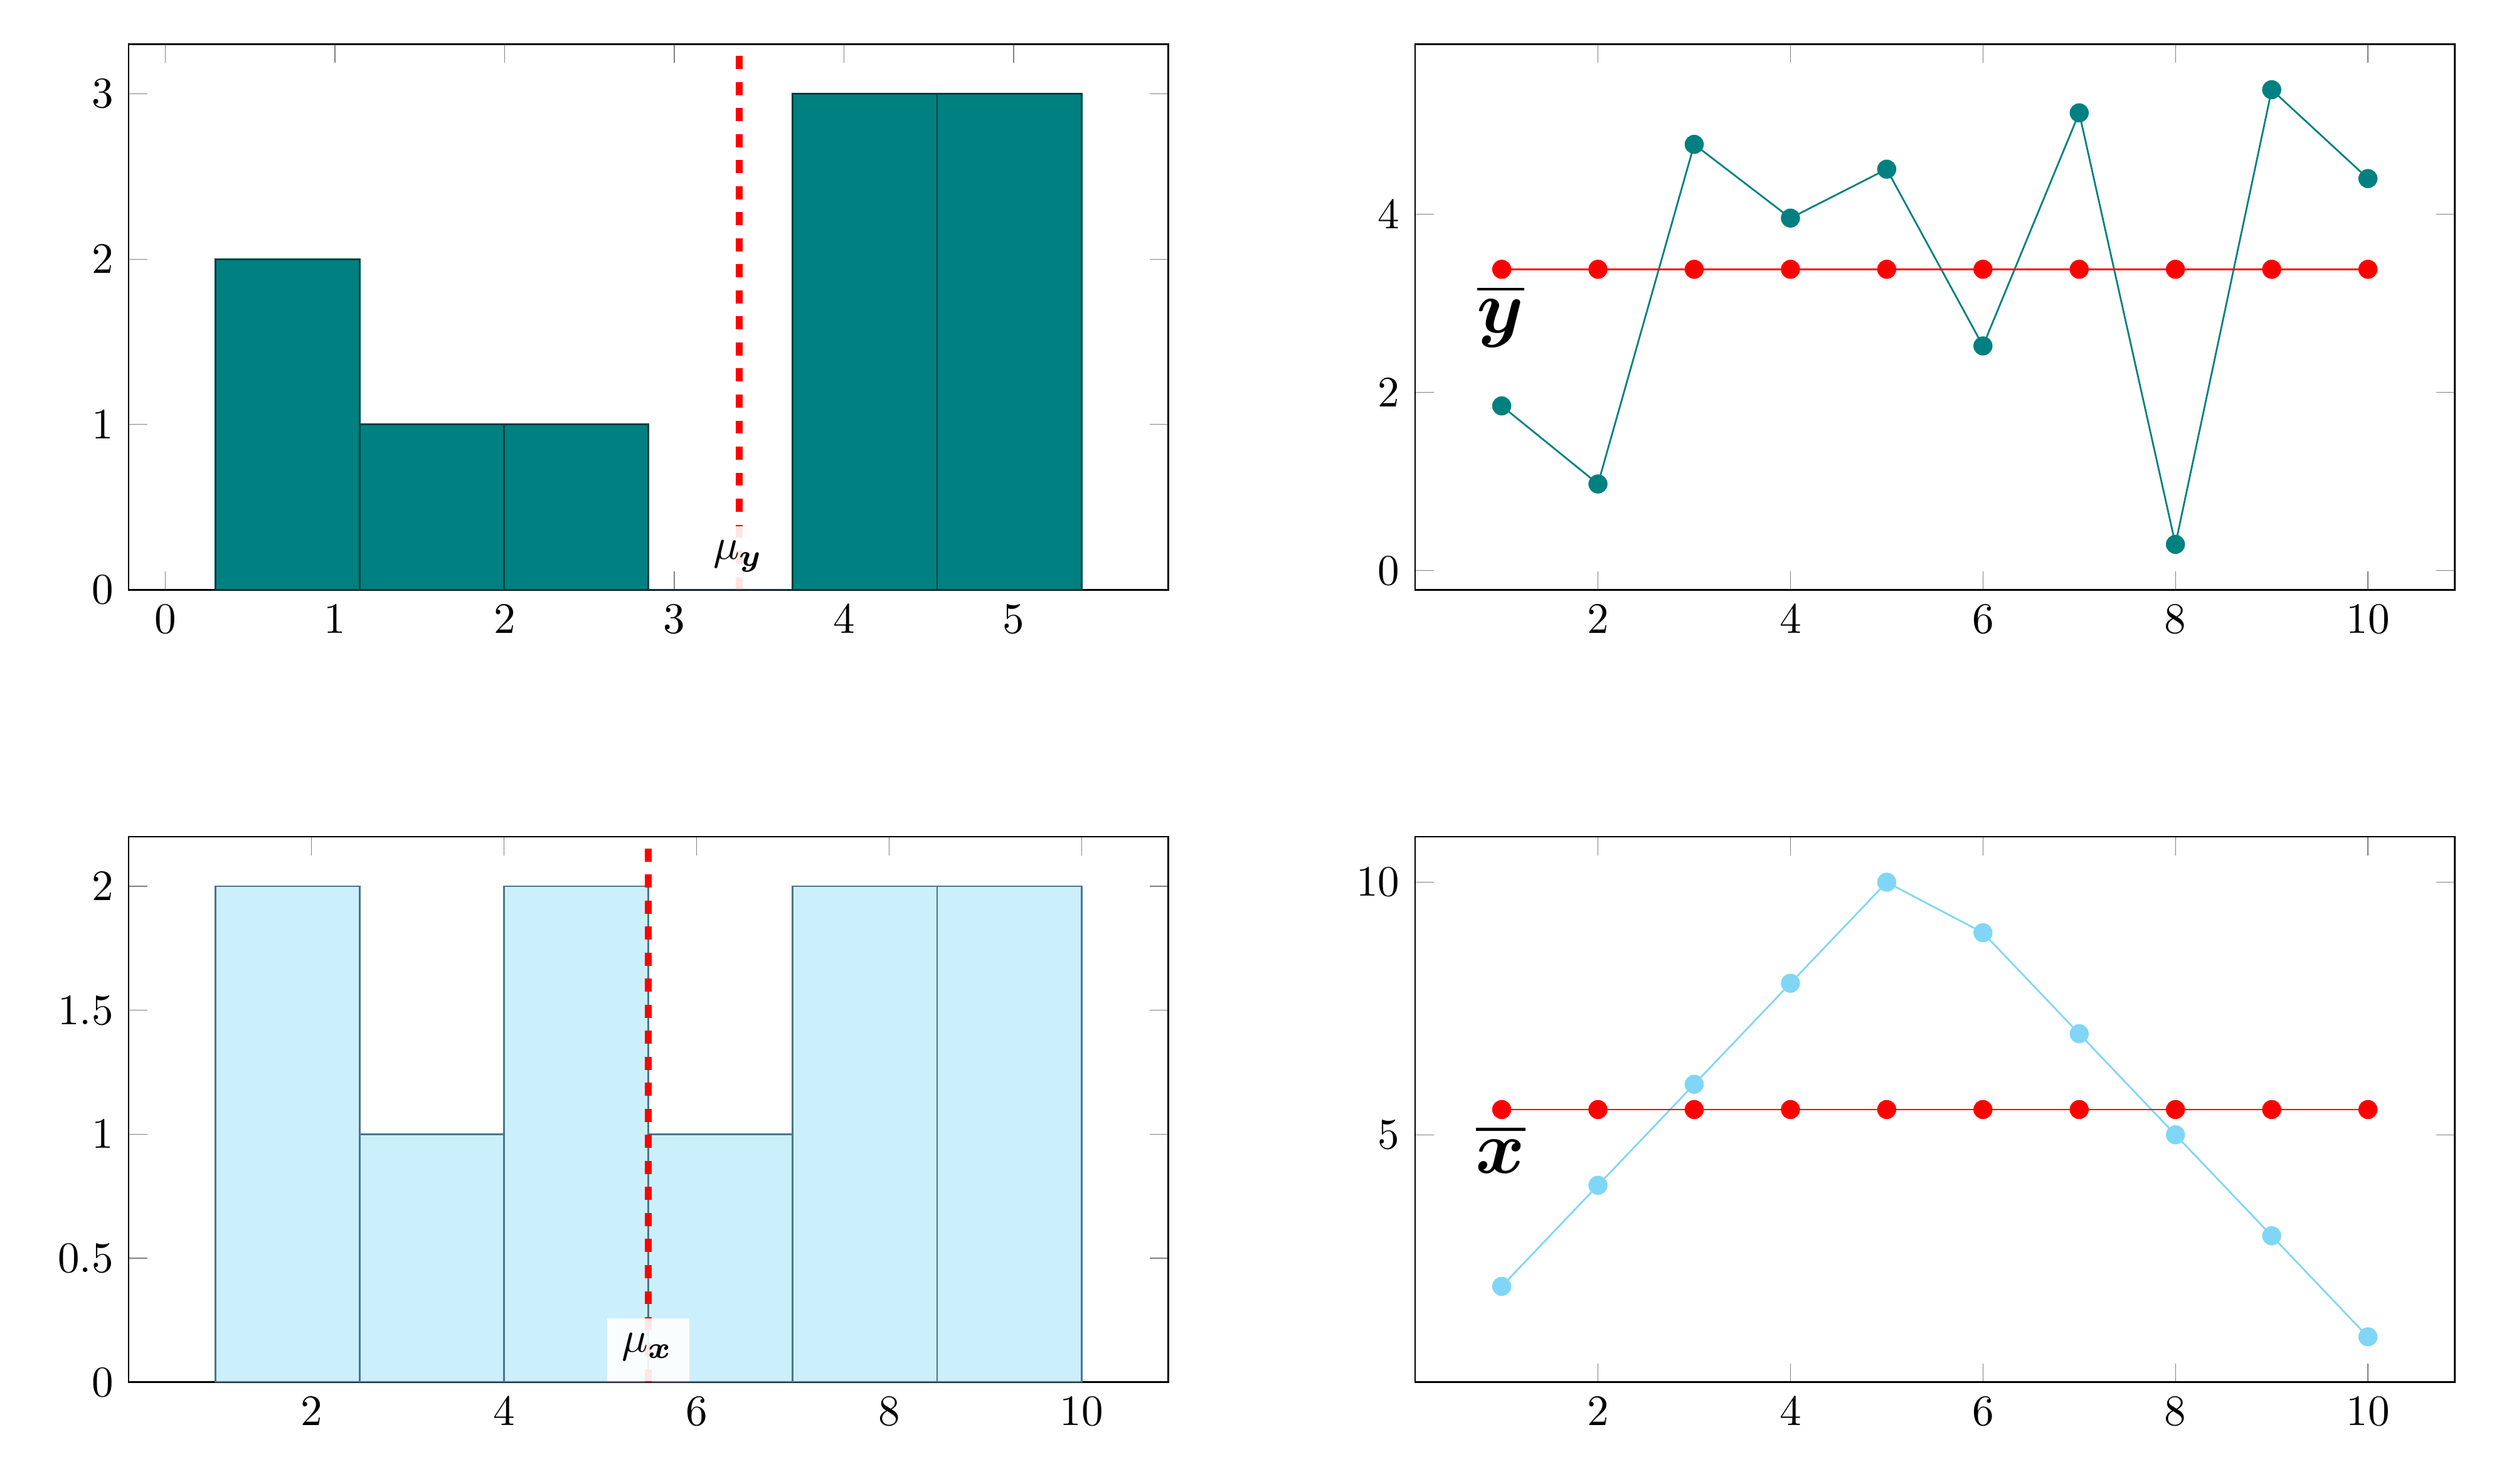
Figura 1: Dos lecturas de la media, lado a lado, con \(n=10\) datos (dos muestras distintas, arriba y abajo). Izquierda: histograma con la media marcada (lectura estadística: el centro de la distribución). Derecha: el mismo vector de datos, componente a componente, junto al vector de medias (constante, en rojo) — la proyección sobre \(\mathcal{L}(\boldsymbol{1})\) (lectura geométrica).
\(\mu_{\boldsymbol{y}}\): un punto en el histograma; \(\quad\boldsymbol{\mathop{\overline{y}}}=\mu_{\boldsymbol{y}}\boldsymbol{1}\) un vector constante en \(\mathbb{R}^n\).
Ilustración con la visión estadística
Una tercera figura, con \(n=10\) datos en cada ejemplo, conecta explícitamente esta lectura geométrica con la lectura de la estadística descriptiva ya familiar para el lector. A la izquierda de cada fila aparece el histograma del vector de datos correspondiente, con la media marcada mediante una línea vertical: la lectura habitual de la media como ``centro'' de la distribución. A la derecha de cada fila aparece el mismo vector de datos, ahora representado componente a componente (el valor de cada \(y_i\) frente a su índice \(i\)), junto al vector de medias \(\boldsymbol{\mathop{\overline{y}}}=\mu_{\boldsymbol{y}}\boldsymbol{1}\), dibujado como una línea horizontal constante a la altura \(\mu_{\boldsymbol{y}}\): la lectura geométrica desarrollada en esta lección, con el vector constante más próximo al vector de datos.
Esta figura hace explícito el mensaje central de esta transparencia: la media \(\mu_{\boldsymbol{y}}\) es un número (que indica el centro de la distribución del histograma); el vector de medias \(\boldsymbol{\mathop{\overline{y}}}\) es un vector, con tantas componentes como datos (la línea horizontal roja de la derecha, con sus \(n=10\) puntos). Son objetos relacionados pero de naturaleza distinta y conviene no confundirlos: la media es un escalar; el vector de medias es el vector resultante de la proyección ortogonal sobre los múltiplos de \(\boldsymbol{1}\).
5. El vector en desviaciones es ortogonal a \(\boldsymbol{1}\)
El vector en desviaciones (respecto a la media) es
\[\boldsymbol{y} - \boldsymbol{\mathop{\overline{y}}} \; = \; \boldsymbol{y} - \mu_{\boldsymbol{y}}\boldsymbol{1}.\]
Por construcción, \((\boldsymbol{y} - \boldsymbol{\mathop{\overline{y}}}) \perp \boldsymbol{1}\), es decir: \[ \langle\boldsymbol{y} - \boldsymbol{\mathop{\overline{y}}},\, \boldsymbol{1}\rangle_s = 0 \;\Longleftrightarrow\; \frac{1}{n}\sum_{i=1}^n (y_i - \mu_{\boldsymbol{y}}) = 0. \]
Por tanto, la media del vector en desviaciones, \(\mu_{(\boldsymbol{y} - \boldsymbol{\mathop{\overline{y}}})}\), es cero.
Esta no es una propiedad que surja a posteriori; esta es la condición de ortogonalidad que caracteriza a la media.
El vector en desviaciones respecto a la media es ortogonal a \(\boldsymbol{1}\)
La condición de ortogonalidad \((\boldsymbol{y} - \boldsymbol{\mathop{\overline{y}}}) \perp \boldsymbol{1}\) tiene una traducción estadística inmediata sobre la media del vector en desviaciones: \[ \langle\boldsymbol{y} - \boldsymbol{\mathop{\overline{y}}},\, \boldsymbol{1}\rangle_s = 0 \;\Longleftrightarrow\; %\frac{1}{n}\sum_{i=1}^n (y_i - \mu_{\boldsymbol{y}}) = 0 %\;\Longleftrightarrow\; \mu_{(\boldsymbol{y} - \boldsymbol{\mathop{\overline{y}}})} = 0, \] donde hemos usado que si \(\mu_{\boldsymbol{v}}\) es la notación para la media de un vector \(\boldsymbol{v}\), entonces la media del vector en desviaciones es \(\mu_{(\boldsymbol{y}-\boldsymbol{\mathop{\overline{y}}})} = \langle\boldsymbol{y}-\boldsymbol{\mathop{\overline{y}}},\boldsymbol{1}\rangle_s\).
Este resultado no es más que un caso particular de la caracterización de \(\mathcal{L}(\boldsymbol{1})^\perp\) como el conjunto de vectores de media cero que vimos más arriba: el vector \(\boldsymbol{y}-\boldsymbol{\mathop{\overline{y}}}\) pertenece a \(\mathcal{L}(\boldsymbol{1})^\perp\) porque, por construcción, es ortogonal a \(\boldsymbol{1}\) y, por tanto, tiene media cero.
La media del vector en desviaciones es cero. En los cursos de estadística descriptiva esto se presenta como una ``propiedad de la media''; aquí vemos que es mucho más que eso: es la condición geométrica que la caracteriza.
Resumiendo:
La estadística descompone el vector de datos \(\boldsymbol{y}\) en dos componentes ortogonales: \[ \boldsymbol{y} = \underbrace{\boldsymbol{\mathop{\overline{y}}}}_{\text{Vector de medias}} + \underbrace{(\boldsymbol{y}-\boldsymbol{\mathop{\overline{y}}})}_{\text{Vector en desviaciones}}, \] donde el vector de medias es un vector constante: \(\boldsymbol{\mathop{\overline{y}}}=\mu_{\boldsymbol{y}}\boldsymbol{1}\); es decir, \(\boldsymbol{\mathop{\overline{y}}}\in\mathcal{L}(\boldsymbol{1})\); y donde la constante \(\mu_{\boldsymbol{y}}\) se denomina media aritmética.
Avance: la regresión lineal simple descompondrá \(\boldsymbol{y}\) en dos componentes ortogonales: \[ \boldsymbol{y} = \underbrace{\boldsymbol{\mathop{\widehat{y}}}}_{\text{Ajuste}} + \underbrace{\boldsymbol{\mathop{\widehat{e}}}}_{\text{Vector de residuos}}, \] donde \(\boldsymbol{\mathop{\widehat{y}}}\in\mathcal{L}(\boldsymbol{1},\boldsymbol{x})\); es decir, \(\boldsymbol{\mathop{\widehat{y}}}\) es una combinación lineal de \(\boldsymbol{1}\) y \(\boldsymbol{x}\). Consecuentemente habrá dos condiciones de ortogonalidad (una por cada regresor).
La regresión lineal múltiple es similar, con tantas condiciones de ortogonalidad como regresores. La lógica será siempre la misma.
Este patrón se repetirá en toda la regresión. Cuando ajustemos una recta de regresión, los residuos serán ortogonales a cada uno de los regresores. Con un regresor (la constante \(\boldsymbol{1}\)), hay una única condición: \(\sum e_i = 0\). Con dos regresores (\(\boldsymbol{1}\) y \(\boldsymbol{x}\)), habrá dos condiciones: \(\sum e_i = 0\) y \(\sum x_i e_i = 0\). Con \(k\) regresores habrá \(k\) condiciones. La lógica es siempre la misma: los errores son ortogonales a cada uno de los regresores.
Esta multiplicidad de condiciones de ortogonalidad es lo que hace que la regresión sea una proyección: el vector de residuos es ortogonal al subespacio generado por los regresores. El caso de la media es el caso más simple: un único regresor (\(\boldsymbol{1}\)), proyección sobre una recta, una sola condición de ortogonalidad.
En el ``avance'' mostrado en la transparencia se emplea, a modo de anticipo, la notación \(\boldsymbol{\mathop{\widehat{y}}}\) y \(\boldsymbol{\mathop{\widehat{e}}}\) con circunflejo (o ``gorro'') que formalizaremos en la lección 6 (regresión lineal simple).
6. Desviación típica: como norma del vector en desviaciones
Definición. La desviación típica de \(\boldsymbol{y}\) es la norma del componente \(\boldsymbol{y} - \boldsymbol{\mathop{\overline{y}}}\) ortogonal a \(\boldsymbol{1}\):
\[ \sigma_{\boldsymbol{y}} = \|\boldsymbol{y} - \boldsymbol{\mathop{\overline{y}}}\|_s = \sqrt{\frac{1}{n}\sum\limits_{i=1}^n(y_i - \mu_{\boldsymbol{y}})^2}. \]
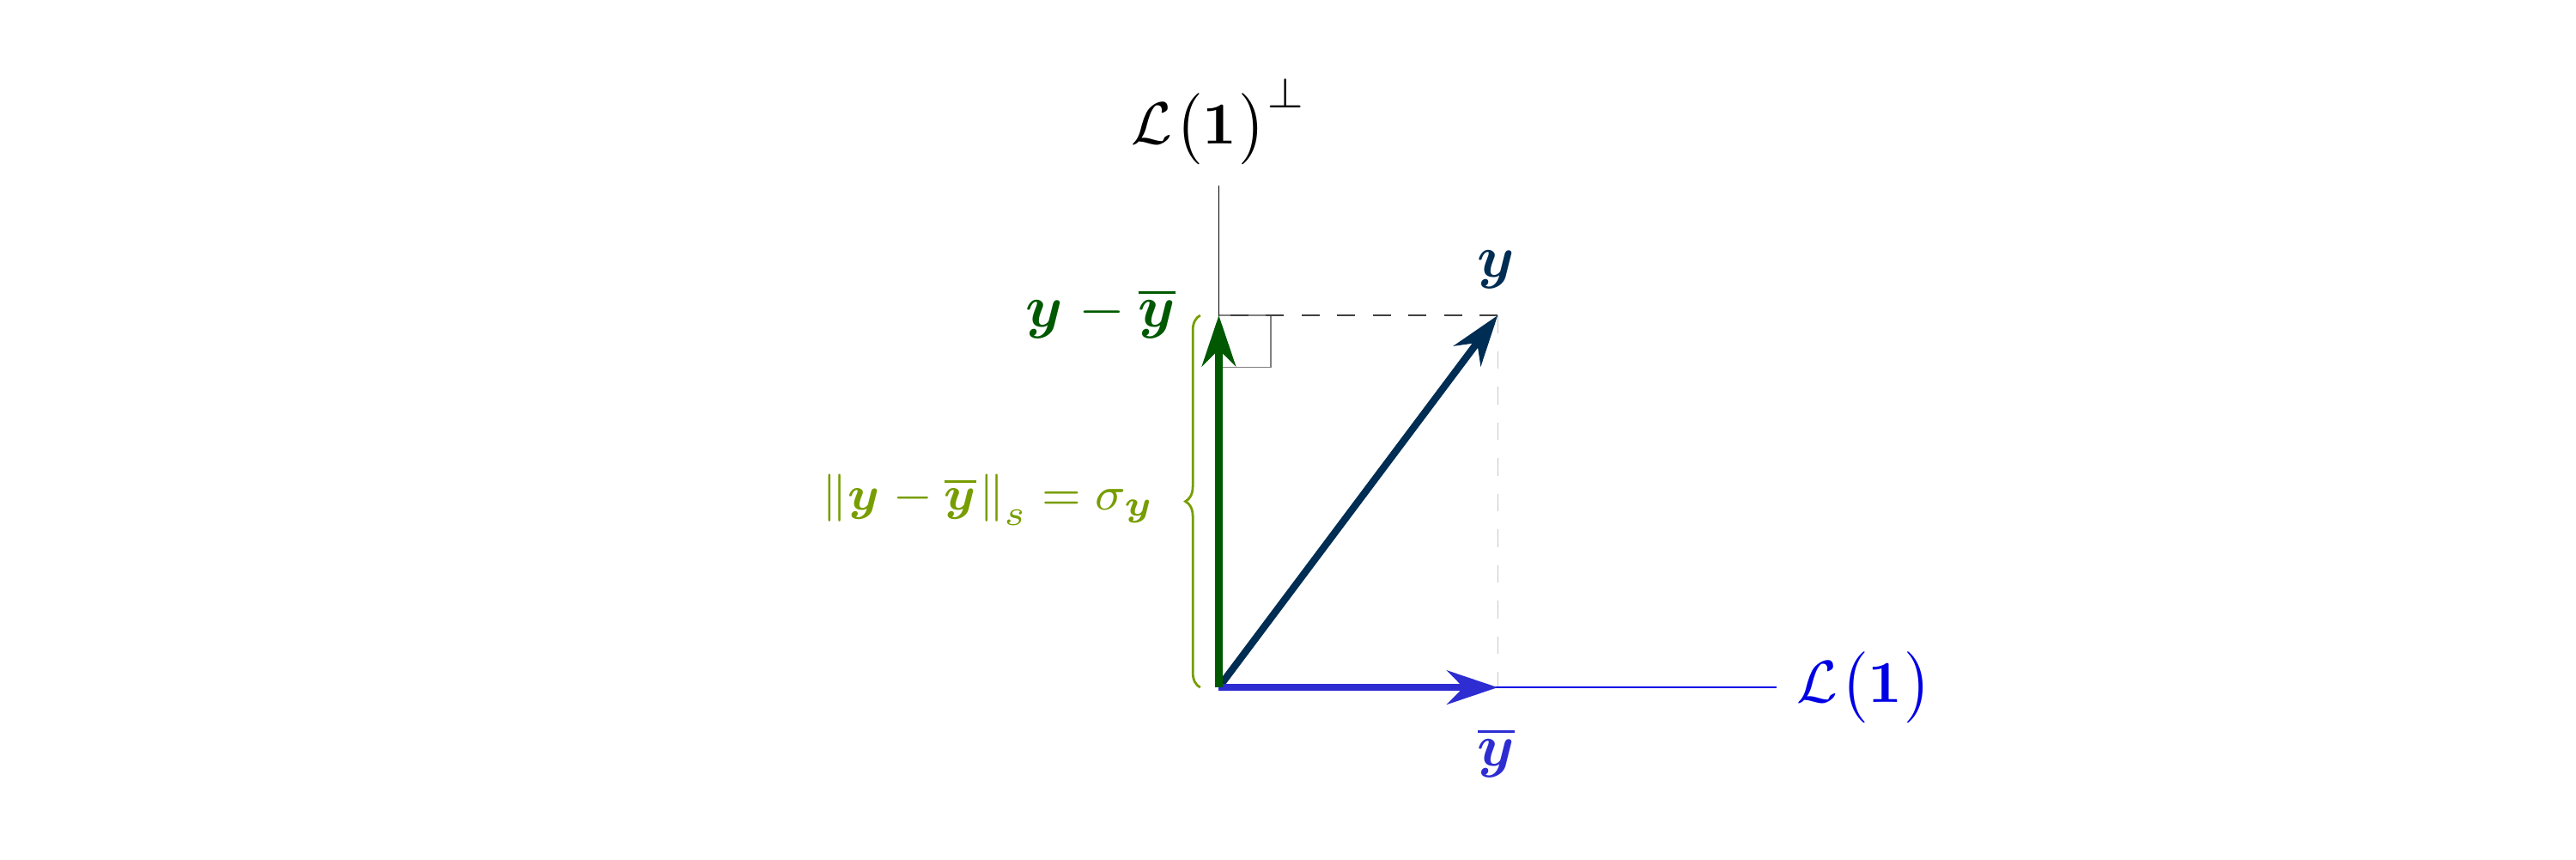
Como \(\boldsymbol{\mathop{\overline{y}}} \perp (\boldsymbol{y} - \boldsymbol{\mathop{\overline{y}}})\), el Teorema de Pitágoras de la lección 3 aplicado a \(\boldsymbol{y} = \boldsymbol{\mathop{\overline{y}}} + (\boldsymbol{y}-\boldsymbol{\mathop{\overline{y}}})\) da: \[ \|\boldsymbol{y}\|_s^2 = \|\boldsymbol{\mathop{\overline{y}}}\|_s^2 + \|\boldsymbol{y} - \boldsymbol{\mathop{\overline{y}}}\|_s^2 = \|\boldsymbol{\mathop{\overline{y}}}\|_s^2 + \sigma_{\boldsymbol{y}}^2. \] La lección 5 desarrollará esta identidad en profundidad.
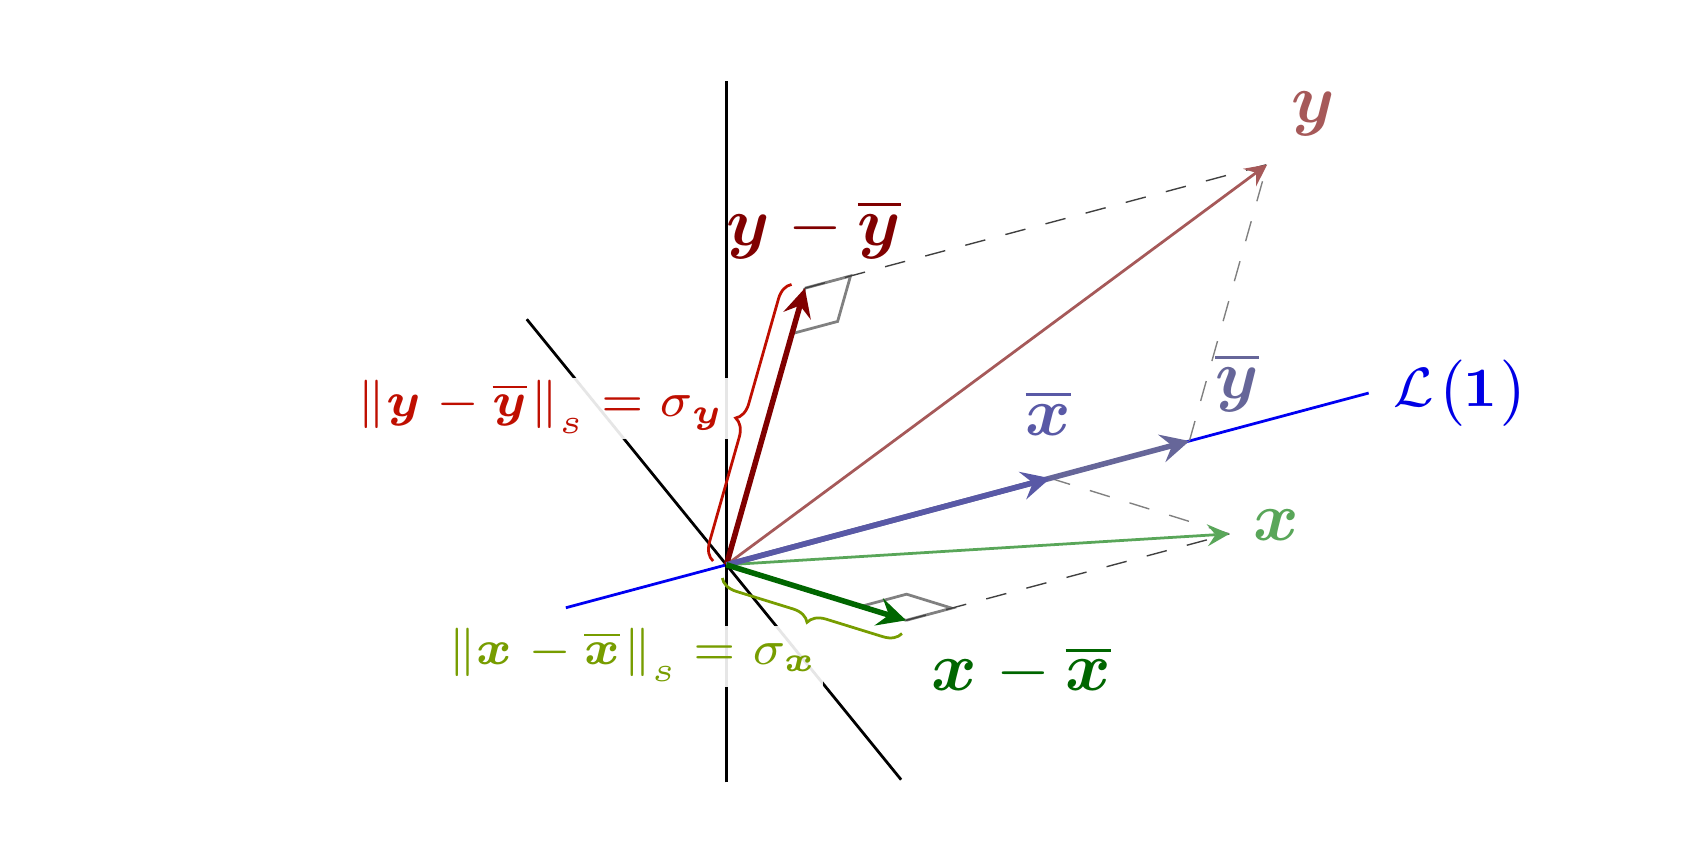
En \(\mathbb{R}^3\): proyecciones de \(\boldsymbol{y}\) y \(\boldsymbol{x}\) sobre \(\mathcal{L}(\boldsymbol{1})\) y sobre \(\mathcal{L}(\boldsymbol{1})^\perp\). Las normas de las proyecciones sobre \(\mathcal{L}(\boldsymbol{1})^\perp\) son las desviaciones típicas respectivas.
La desviación típica como norma del vector en desviaciones respecto a la media
Una vez que tenemos la proyección \(\boldsymbol{\mathop{\overline{y}}} = \mu_{\boldsymbol{y}}\boldsymbol{1}\) y el vector en desviaciones \(\boldsymbol{y} - \boldsymbol{\mathop{\overline{y}}}\), la norma de dicho vector es un objeto natural. Mide cuánto se aleja \(\boldsymbol{y}\) de su proyección, es decir, cómo de lejos está \(\boldsymbol{y}\) del vector constante más próximo \(\boldsymbol{\mathop{\overline{y}}}\). Dicho de otra forma: cuánto se dispersan las componentes de \(\boldsymbol{y}\) respecto a su media \(\mu_{\boldsymbol{y}}\).
Desarrollando la norma: \[ \sigma_{\boldsymbol{y}} = \|\boldsymbol{y} - \boldsymbol{\mathop{\overline{y}}}\|_s = \sqrt{\langle\boldsymbol{y}-\boldsymbol{\mathop{\overline{y}}},\boldsymbol{y}-\boldsymbol{\mathop{\overline{y}}}\rangle_s} = \sqrt{\frac{1}{n}\sum_{i=1}^n(y_i-\mu_{\boldsymbol{y}})^2}. \] Esta es exactamente la fórmula de la desviación típica que se define en los cursos de estadística descriptiva. Aquí vemos que no es una fórmula ad hoc: es la norma de un vector, el vector en desviaciones respecto a la media.
La primera figura de esta sección muestra la geometría en \(\mathbb{R}^2\): el vector \(\boldsymbol{y}\) (verde) se descompone en su proyección \(\boldsymbol{\mathop{\overline{y}}}\) (sobre la recta azul \(\mathcal{L}(\boldsymbol{1})\)) y el vector en desviaciones \(\boldsymbol{y} - \boldsymbol{\mathop{\overline{y}}}\) (sobre la recta negra \(\mathcal{L}(\boldsymbol{1})^\perp\)). La desviación típica \(\sigma_{\boldsymbol{y}}\) es la longitud de la componente vertical, es decir, la norma del vector en desviaciones respecto a la media.
Como \(\boldsymbol{\mathop{\overline{y}}} \perp (\boldsymbol{y} - \boldsymbol{\mathop{\overline{y}}})\) (por construcción), el Teorema de Pitágoras en \(\mathbb{R}^n\) (demostrado en la lección 3, con enunciado genérico \(\boldsymbol{x}\perp\boldsymbol{z} \Rightarrow \|\boldsymbol{x}+\boldsymbol{z}\|^2=\|\boldsymbol{x}\|^2+\|\boldsymbol{z}\|^2\)) aplicado a la descomposición \(\boldsymbol{y} = \boldsymbol{\mathop{\overline{y}}} + (\boldsymbol{y}-\boldsymbol{\mathop{\overline{y}}})\) nos da: \[ \|\boldsymbol{y}\|_s^2 = \|\boldsymbol{\mathop{\overline{y}}}\|_s^2 + \|\boldsymbol{y} - \boldsymbol{\mathop{\overline{y}}}\|_s^2 = \mu_{\boldsymbol{y}}^2 + \sigma_{\boldsymbol{y}}^2, \] donde el paso \(\|\boldsymbol{\mathop{\overline{y}}}\|_s^2 = \mu_{\boldsymbol{y}}^2\) usa la homogeneidad de la norma (vista en la lección 2): \(\|\mu_{\boldsymbol{y}}\boldsymbol{1}\|_s = |\mu_{\boldsymbol{y}}|\cdot\|\boldsymbol{1}\|_s = |\mu_{\boldsymbol{y}}|\cdot 1 = |\mu_{\boldsymbol{y}}|\), y al elevar al cuadrado \(|\mu_{\boldsymbol{y}}|^2 = \mu_{\boldsymbol{y}}^2\).
En la lección 5 desarrollaremos esta identidad con todo detalle: de ella saldrán la varianza, la covarianza y la correlación.
La segunda figura muestra la misma geometría para dos vectores distintos en \(\mathbb{R}^3\). Cada uno se descompone en su componente en \(\mathcal{L}(\boldsymbol{1})\) (su media, en azul) y su componente en \(\mathcal{L}(\boldsymbol{1})^\perp\) (su vector centrado, en verde/rojo). La norma de esta segunda componente es la desviación típica respectiva.
Para recordar. La desviación típica es una norma. El vector de medias es una proyección y la media aritmética es el valor de las componentes del vector de medias. Todos son objetos geométricos elementales que ya conocíamos; la novedad es reconocerlos en las fórmulas estadísticas habituales.
7. Ejemplos numéricos en \(\mathbb{R}^2\)
Ejemplos numéricos en \(\mathbb{R}^2\)
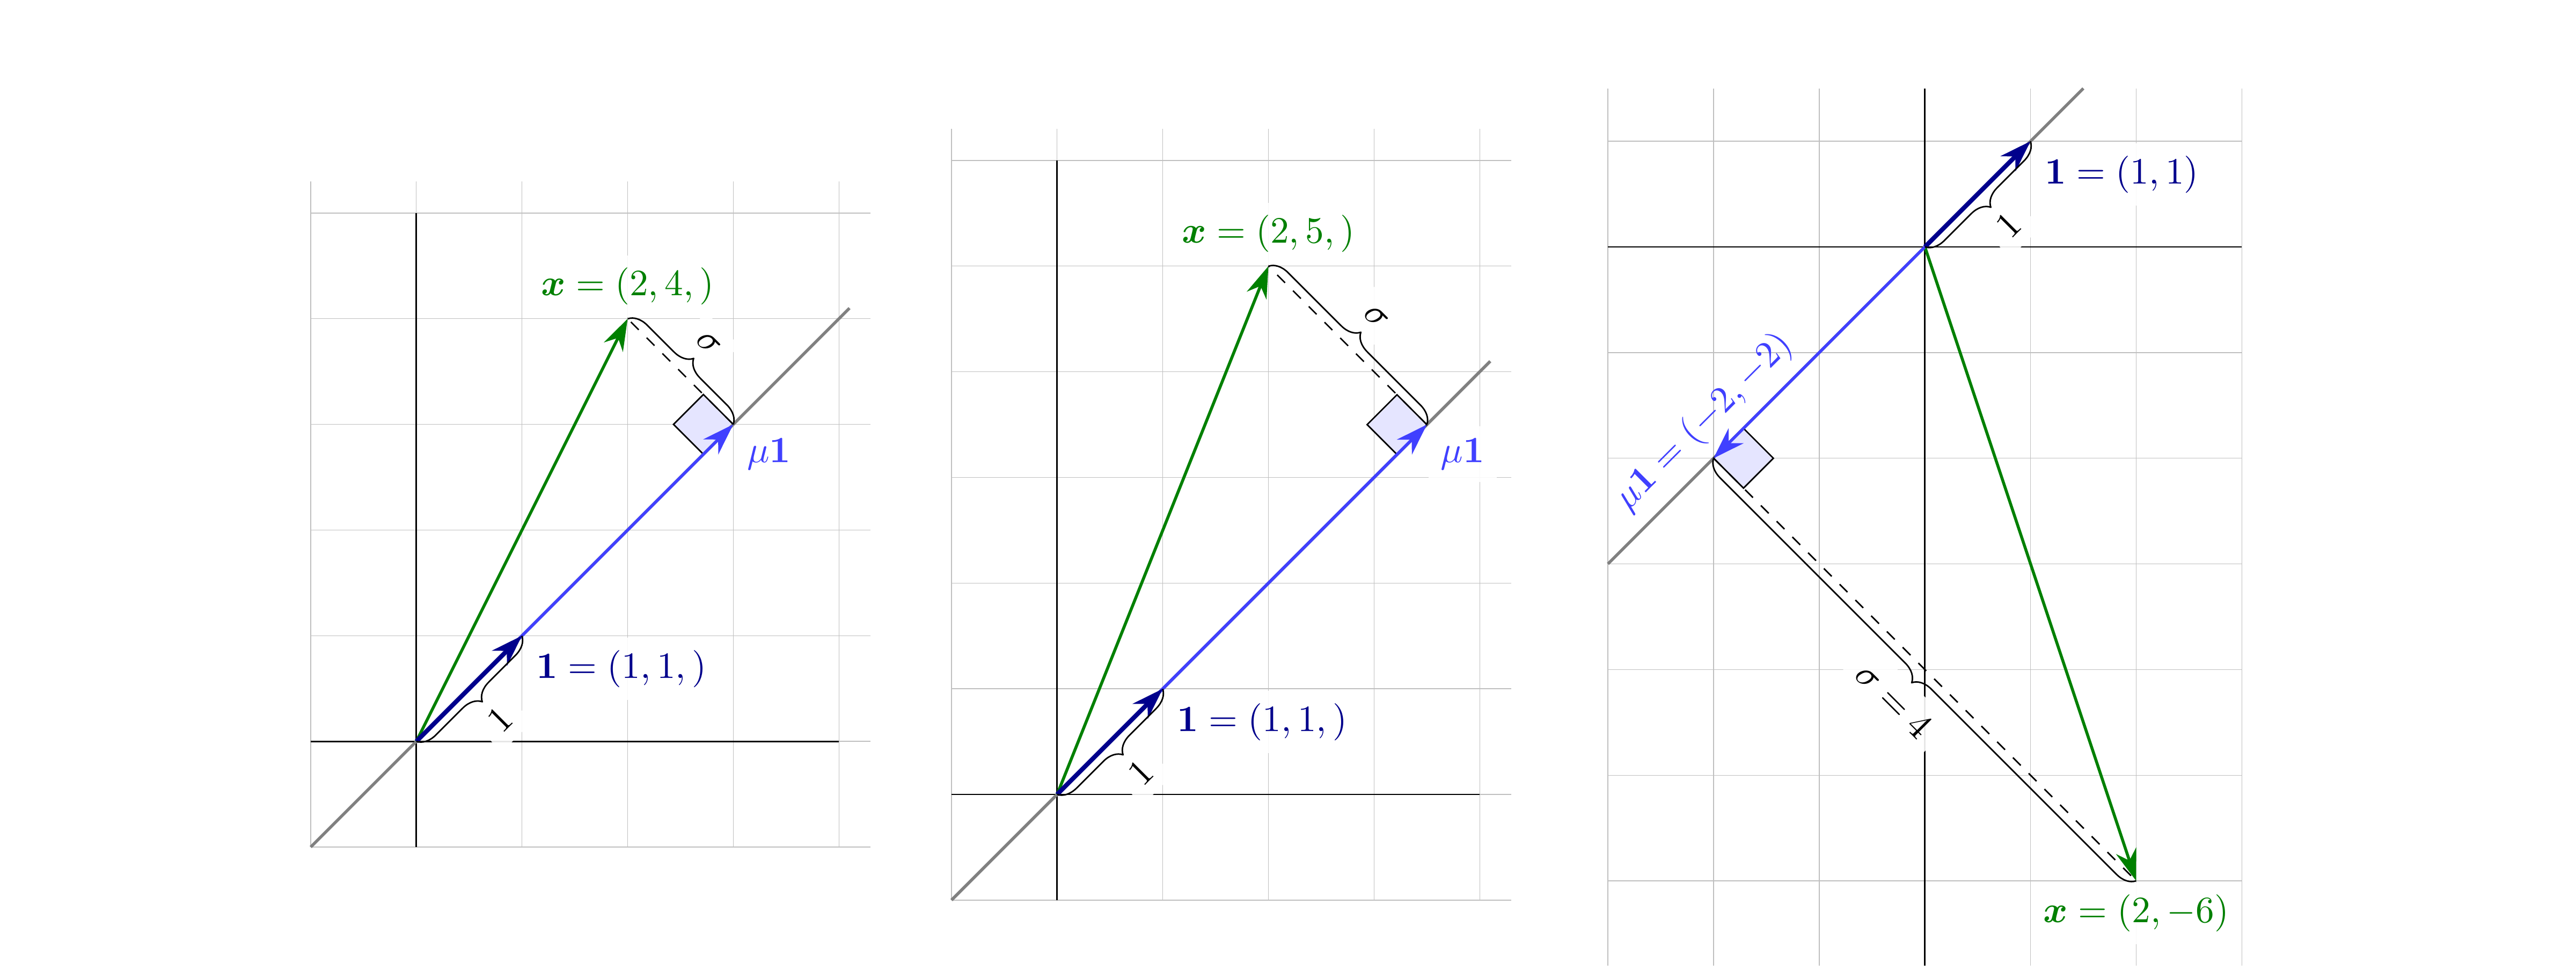
Verificamos los tres ejemplos de las figuras.
- Ejemplo 1.
\(\boldsymbol{x} = (2,4)\).
Media: \(\mu_{\boldsymbol{x}} = \frac{1}{2}(2+4) = 3\).
Vector de medias: \(\boldsymbol{\mathop{\overline{x}}} = 3\boldsymbol{1} = (3,3)\).
Vector en desviaciones: \(\boldsymbol{x} - \boldsymbol{\mathop{\overline{x}}} = (2-3, 4-3) = (-1, 1)\).
Comprobación de ortogonalidad: \(\langle(-1,1),(1,1)\rangle_s = \frac{1}{2}(-1+1) = 0\). ✓
Desviación típica: \(\sigma_{\boldsymbol{x}} = \|(-1,1)\|_s = \sqrt{\frac{1}{2}(1+1)} = \sqrt{1} = 1\).
Pitágoras: \(\|\boldsymbol{x}\|_s^2 = \frac{1}{2}(4+16) = 10\); \(\mu_{\boldsymbol{x}}^2 + \sigma_{\boldsymbol{x}}^2 = 9 + 1 = 10\). ✓
- Ejemplo 2.
\(\boldsymbol{x} = (2,5)\).
Media: \(\mu_{\boldsymbol{x}} = \frac{7}{2} = 3{,}5\).
Vector de medias: \(\boldsymbol{\mathop{\overline{x}}} = (3{,}5,\, 3{,}5)\).
Vector en desviaciones: \(\boldsymbol{x} - \boldsymbol{\mathop{\overline{x}}} = (-1{,}5,\, 1{,}5)\).
Comprobación de ortogonalidad: \(\langle(-1{,}5,\,1{,}5),(1,1)\rangle_s = \frac{1}{2}(-1{,}5+1{,}5) = 0\). ✓
Desviación típica: \(\sigma_{\boldsymbol{x}} = \sqrt{\frac{1}{2}(2{,}25+2{,}25)} = \sqrt{2{,}25} = 1{,}5\).
- Ejemplo 3.
\(\boldsymbol{x} = (2,-6)\).
Media: \(\mu_{\boldsymbol{x}} = \frac{1}{2}(2-6) = -2\).
Vector de medias: \(\boldsymbol{\mathop{\overline{x}}} = (-2,-2)\).
Vector en desviaciones: \(\boldsymbol{x} - \boldsymbol{\mathop{\overline{x}}} = (4,-4)\).
Comprobación de ortogonalidad: \(\langle(4,-4),(1,1)\rangle_s = \frac{1}{2}(4-4) = 0\). ✓
Desviación típica: \(\sigma_{\boldsymbol{x}} = \sqrt{\frac{1}{2}(16+16)} = \sqrt{16} = 4\).
Pitágoras: \(\|\boldsymbol{x}\|_s^2 = \frac{1}{2}(4+36) = 20\); \(\mu_{\boldsymbol{x}}^2 + \sigma_{\boldsymbol{x}}^2 = 4 + 16 = 20\). ✓
Observación. En los tres casos la norma del vector \(\boldsymbol{1}\) es \(\|(1,1)\|_s = \sqrt{\frac{1}{2}(1+1)} = 1\), como exigimos. Y el ángulo que forma \(\boldsymbol{1}\) con el eje horizontal es de 45°, de modo que la proyección sobre \(\mathcal{L}(\boldsymbol{1})\) es efectivamente la diagonal del plano. El tercer ejemplo es especialmente ilustrativo: la media es negativa (\(\mu = -2\)), así que el vector de medias apunta en el sentido negativo de la diagonal.
Es buen momento para mirar el notebook Python.
Las figuras de hoy tienen su versión interactiva en \(\mathbb{R}^3\): rote los vectores y compruebe que la desviación típica es la norma del vector en desviaciones.
8. Propiedades geométricas
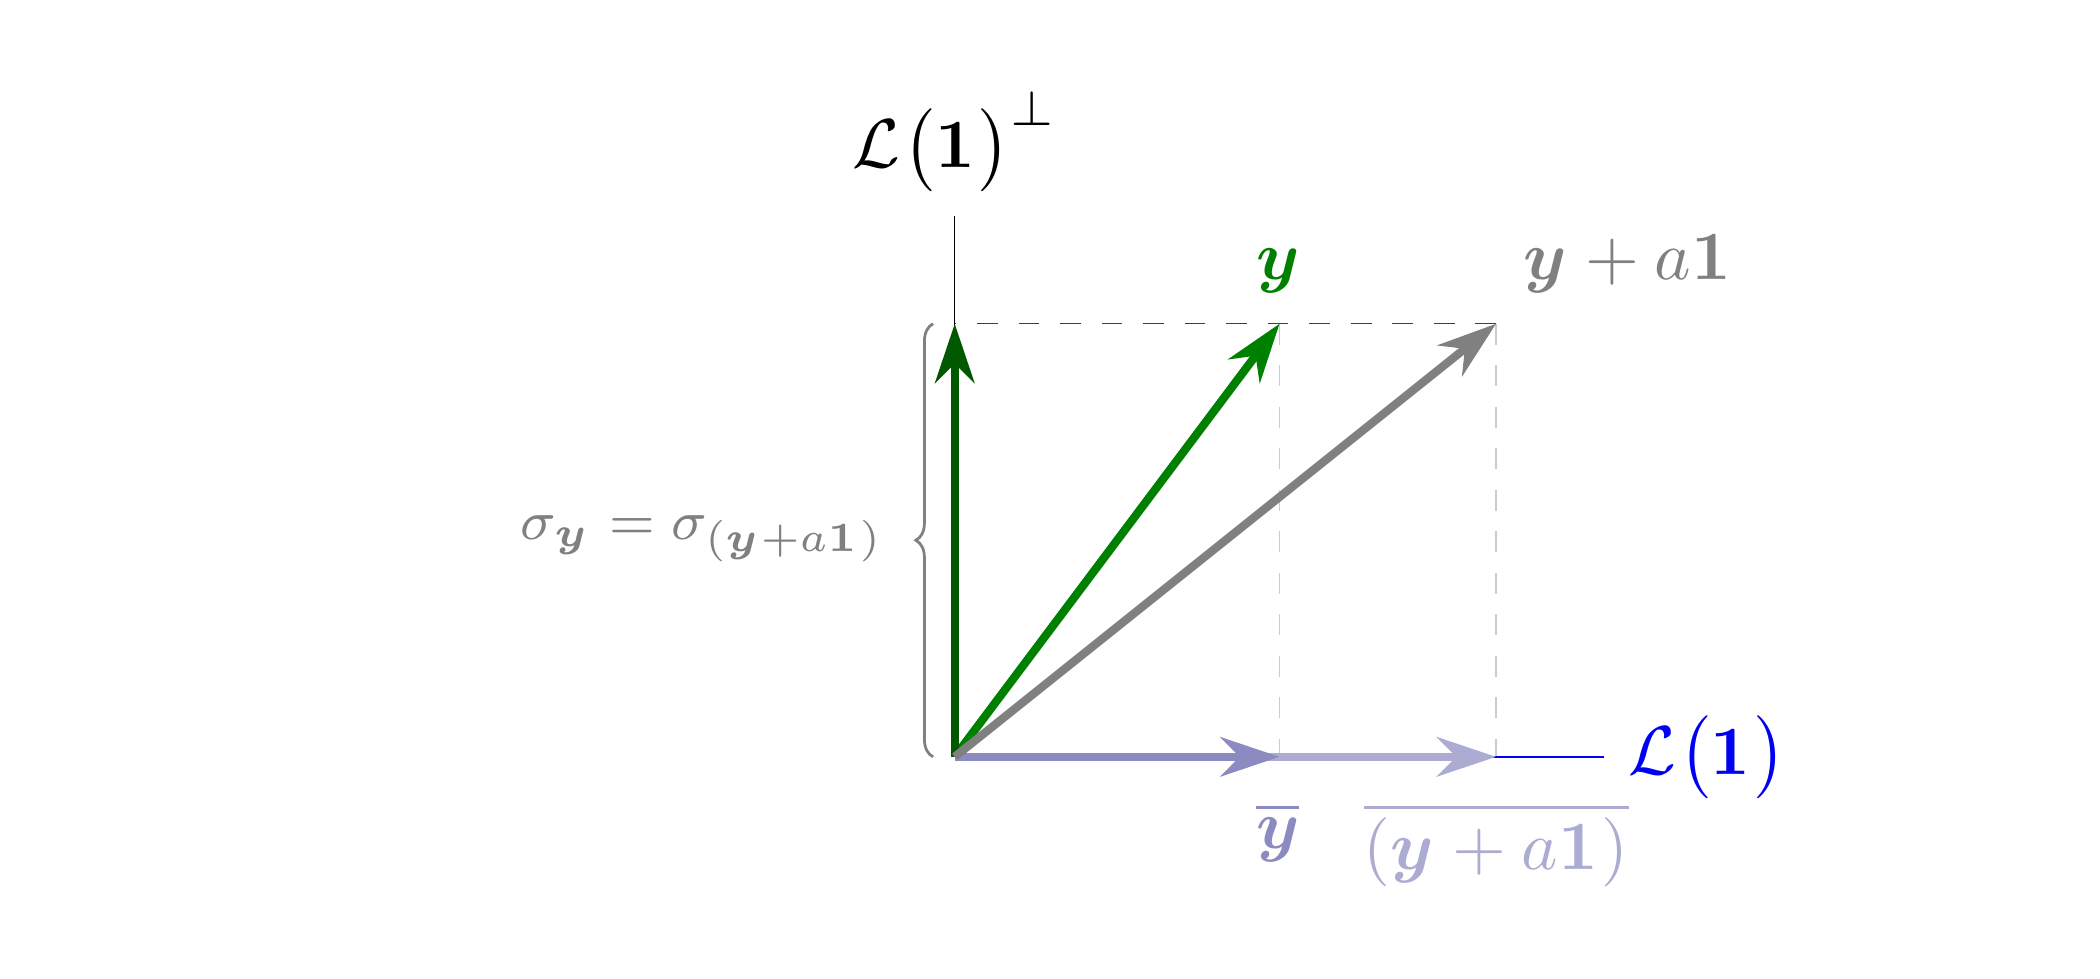
Sumar una constante no nula (\(\boldsymbol{y} + a\boldsymbol{1}\)): cambia la media \(\mu\), pero nunca la desviación típica \(\sigma\).
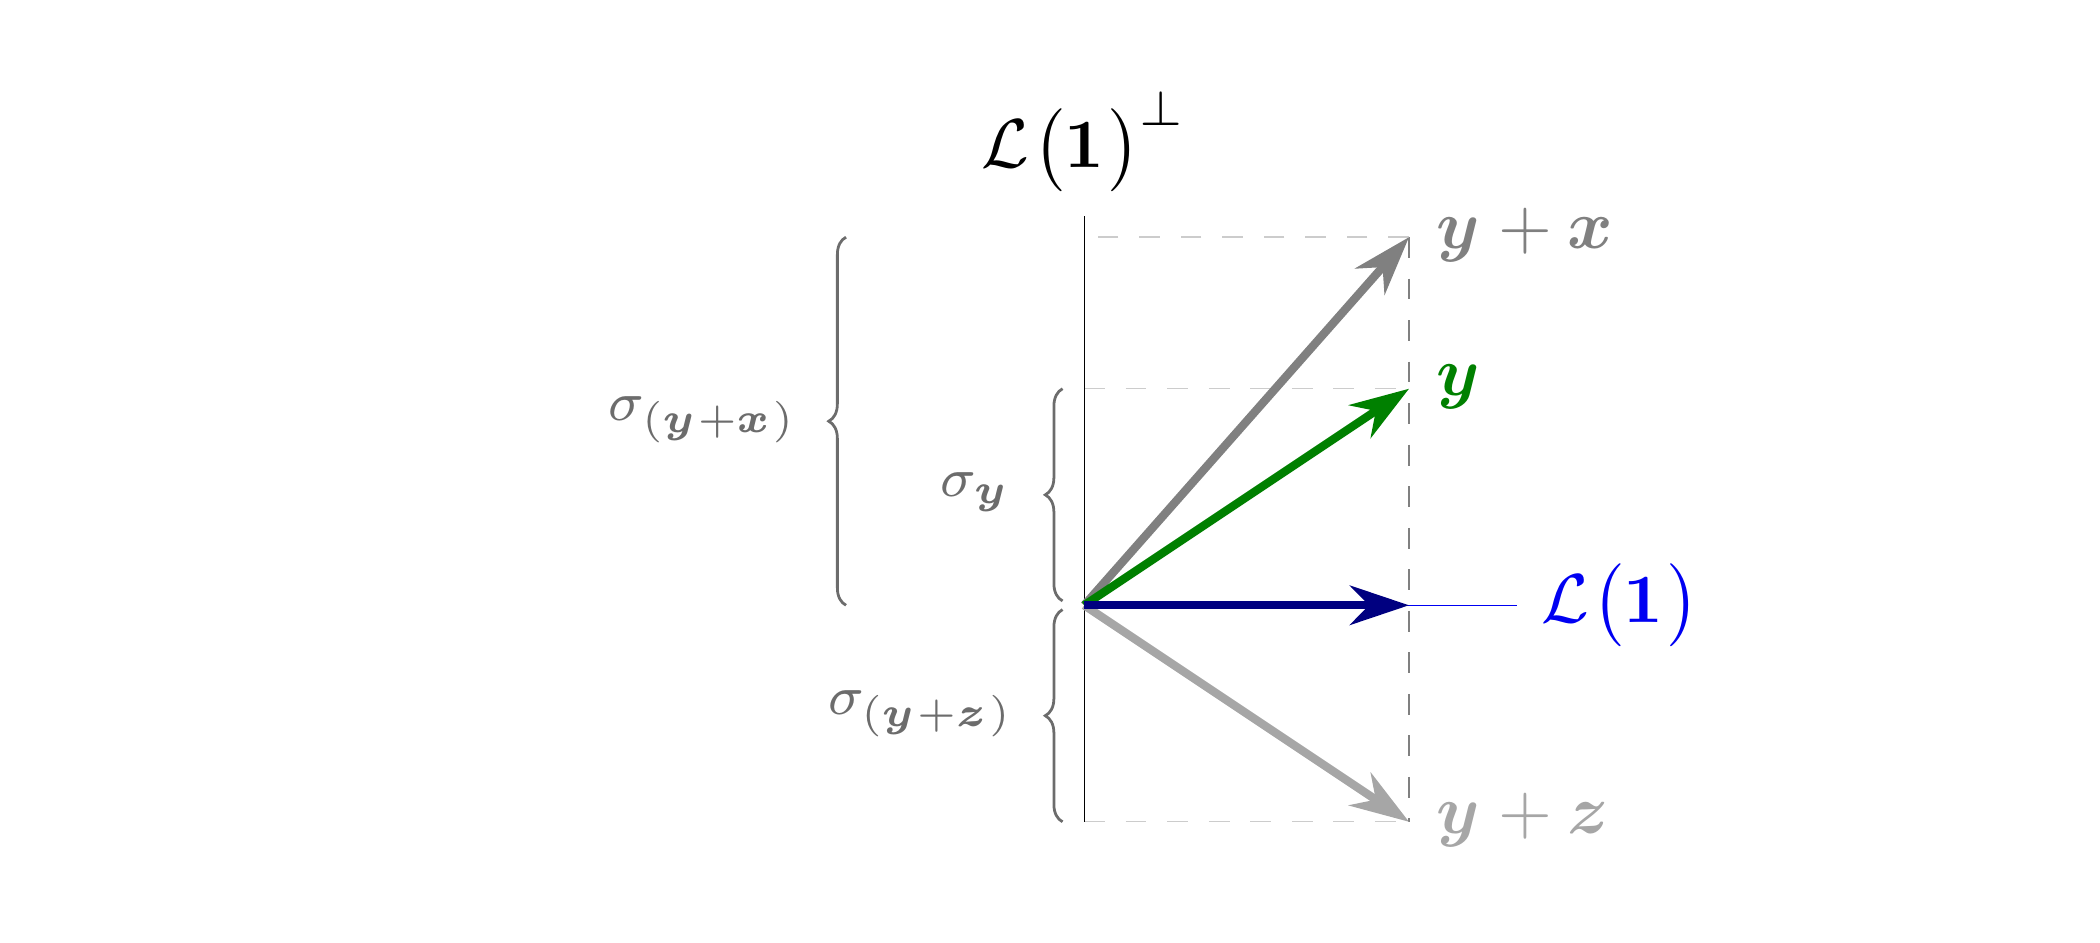
Sumar un vector de media cero (i.e., perpendicular a \(\boldsymbol{1}\)): no cambia la media \(\mu\), pero generalmente cambia la desviación típica \(\sigma\).
Propiedades geométricas
Las figuras anteriores ilustran dos propiedades geométricas de la media y la desviación típica que son inmediatas desde la perspectiva de la proyección, pero que en los cursos de estadística descriptiva se demuestran algebraicamente.
Propiedad 1: sumar una constante no cambia la desviación típica.
Si \(\boldsymbol{w} = \boldsymbol{y} + a\boldsymbol{1}\) para algún escalar \(a\), entonces:
- La proyección de \(\boldsymbol{w}\) sobre \(\mathcal{L}(\boldsymbol{1})\) es \(\boldsymbol{\mathop{\overline{w}}} = (\mu_{\boldsymbol{y}} + a)\boldsymbol{1}\): la media aumenta en \(a\).
- Los vectores en desviaciones respecto a sus respectivas medias son iguales: \(\boldsymbol{w} - \boldsymbol{\mathop{\overline{w}}} = (\boldsymbol{y} + a\boldsymbol{1}) - (\mu_{\boldsymbol{y}}+a)\boldsymbol{1} = \boldsymbol{y} - \mu_{\boldsymbol{y}}\boldsymbol{1} = \boldsymbol{y} - \boldsymbol{\mathop{\overline{y}}}\).
Geométricamente, \(a\boldsymbol{1}\) está en \(\mathcal{L}(\boldsymbol{1})\), así que sumar \(a\boldsymbol{1}\) desplaza el vector a lo largo de la recta \(\mathcal{L}(\boldsymbol{1})\), sin modificar la componente perpendicular. La desviación típica, que es la norma de esa componente perpendicular, no varía.
Propiedad 2: sumar un vector de media cero puede cambiar la desviación típica.
Sea \(\boldsymbol{x}\) un vector de media cero, \(\mu_{\boldsymbol{x}} = 0\); entonces \(\boldsymbol{x} \perp \boldsymbol{1}\), es decir, \(\boldsymbol{x} \in \mathcal{L}(\boldsymbol{1})^\perp\). Al sumárselo a \(\boldsymbol{y}\):
- La proyección de \(\boldsymbol{y}+\boldsymbol{x}\) sobre \(\mathcal{L}(\boldsymbol{1})\) sigue siendo \(\boldsymbol{\mathop{\overline{y}}}\): la media no cambia, porque \(\boldsymbol{x}\) no tiene componente en \(\mathcal{L}(\boldsymbol{1})\).
- Su vector en desviaciones es \((\boldsymbol{y} - \boldsymbol{\mathop{\overline{y}}}) + \boldsymbol{x}\): la componente perpendicular generalmente sí cambia.
La desviación típica de \(\boldsymbol{y}+\boldsymbol{x}\) depende de cómo se combine \(\boldsymbol{y} - \boldsymbol{\mathop{\overline{y}}}\) con \(\boldsymbol{x}\) dentro del subespacio \(\mathcal{L}(\boldsymbol{1})^\perp\). Puede ser mayor, menor o igual que \(\sigma_{\boldsymbol{y}}\), según la dirección de \(\boldsymbol{x}\).
La segunda figura de esta sección ilustra las dos posibilidades con dos vectores de media cero distintos, \(\boldsymbol{x}\) y \(\boldsymbol{z}\): el vector \(\boldsymbol{y}+\boldsymbol{x}\) tiene mayor desviación típica que \(\boldsymbol{y}\), mientras que \(\boldsymbol{y}+\boldsymbol{z}\) tiene la misma. Los tres vectores, en cambio, tienen la misma proyección sobre \(\mathcal{L}(\boldsymbol{1})\) (la misma media).
Para profundizar. Estas dos propiedades son la versión geométrica de lo que en estadística se llama ``invarianza de la varianza frente a traslaciones'' y ``la varianza mide dispersión respecto a la media''. (La varianza no es más que \(\sigma_{\boldsymbol{x}}^2\), el cuadrado de la desviación típica que acabamos de definir; la lección 5 la presentará con ese nombre y la estudiará con detalle.) Desde la geometría, son casi obvias: la varianza es el cuadrado de la norma de la componente perpendicular a \(\mathcal{L}(\boldsymbol{1})\); sumar algo paralelo a \(\boldsymbol{1}\) no cambia esa componente; sumar algo perpendicular a \(\boldsymbol{1}\) generalmente la cambia.
- Wooldridge, J. Introductory Econometrics (2020), Apéndice C: invarianza de la media y la desviación típica ante transformaciones lineales, desde la estadística clásica.
9. Recapitulación
| Objeto/Concepto | Definición geométrica/algebraica | Fórmula en estadística descriptiva |
|---|---|---|
| Media \(\mu_{\boldsymbol{y}}\) | \(\langle\boldsymbol{y},\boldsymbol{1}\rangle_s\) | \(\frac{1}{n}\sum y_i\) |
| Vector de medias \(\boldsymbol{\mathop{\overline{y}}}\) | Proyección de \(\boldsymbol{y}\) sobre \(\mathcal{L}(\boldsymbol{1})\) | --- |
| Vector en desviaciones | \(\boldsymbol{y} - \boldsymbol{\mathop{\overline{y}}}\), con \((\boldsymbol{y}-\boldsymbol{\mathop{\overline{y}}})\perp\boldsymbol{1}\) | --- |
| Desviación típica \(\sigma_{\boldsymbol{y}}\) | \(\Vert\boldsymbol{y} - \boldsymbol{\mathop{\overline{y}}}\Vert_s\) | \(\sqrt{\frac{1}{n}\sum(y_i-\mu_{\boldsymbol{y}})^2}\) |
| Teorema de Pitágoras (*) | \(\Vert\boldsymbol{y}\Vert_s^2 = \Vert\boldsymbol{\mathop{\overline{y}}}\Vert_s^2 + \sigma_{\boldsymbol{y}}^2\) | \(\frac{1}{n}\sum y_i^2 = \mu_{\boldsymbol{y}}^2 + \sigma_{\boldsymbol{y}}^2\) |
(*) Lo veremos con más detalle en la siguiente lección.
El principio unificador: la media \(\mu_{\boldsymbol{y}}\) es, a la vez, el producto escalar \(\langle\boldsymbol{y},\boldsymbol{1}\rangle_s\) y el coeficiente de la proyección ortogonal de \(\boldsymbol{y}\) sobre \(\mathcal{L}(\boldsymbol{1})\). La ortogonalidad lo define todo.
Recapitulación
El mensaje central de esta sesión es que dos de los estadísticos más elementales —la media \(\mu\) y la desviación típica \(\sigma\)— son objetos geométricos: el coeficiente de una proyección ortogonal (por cuanto queda multiplicado el vector \(\boldsymbol{1}\)) y una norma, respectivamente.
Esto no es una mera reformulación. Tiene consecuencias prácticas:
- La condición \((\boldsymbol{y} - \boldsymbol{\mathop{\overline{y}}}) \perp \boldsymbol{1}\) —es decir, \(\sum(y_i - \mu_{\boldsymbol{y}}) = 0\)— no es una propiedad de la media: es la definición de la media como proyección ortogonal sobre los vectores constantes \(\mathcal{L}(\boldsymbol{1})\).
- El Teorema de Pitágoras \(\|\boldsymbol{y}\|_s^2 = \|\boldsymbol{\mathop{\overline{y}}}\|_s^2 + \sigma_{\boldsymbol{y}}^2\) no es una fórmula a memorizar: es la consecuencia inevitable de la ortogonalidad entre \(\boldsymbol{\mathop{\overline{y}}}\) y \(\boldsymbol{y} - \boldsymbol{\mathop{\overline{y}}}\).
- El factor \(\frac{1}{n}\) en el producto escalar estadístico no es arbitrario: es la consecuencia de exigir \(\|\boldsymbol{1}\|_s = 1\), que a su vez es la condición para que la media de \(\boldsymbol{1}\) sea \(1\).
La lección 5 llevará este marco geométrico más lejos: la varianza (con más profundidad que la mención de hoy), la covarianza como producto escalar de vectores centrados, y la correlación como el coseno del ángulo entre esos vectores centrados. El ángulo, que introdujimos en la lección 3, vuelve a ser protagonista.
10. Guiño a la sesión siguiente
Lección 5: varianza, covarianza y correlación.
- La varianza \(\sigma_{\boldsymbol{y}}^2 = \|\boldsymbol{y} - \boldsymbol{\mathop{\overline{y}}}\|_s^2\): Tma. de Pitágoras con más profundidad.
- La covarianza entre \(\boldsymbol{x}\) e \(\boldsymbol{y}\): el producto escalar de sus vectores en desviaciones \((\boldsymbol{x} - \boldsymbol{\mathop{\overline{x}}})\) e \((\boldsymbol{y} - \boldsymbol{\mathop{\overline{y}}})\).
- La correlación \(\rho_{\boldsymbol{x}\boldsymbol{y}}\): el coseno del ángulo entre esos vectores en desviaciones.
El ángulo que introdujimos en la lección 3 vuelve al centro del escenario.
Y vista la correlación tendremos todas las piezas para abordar la regresión lineal simple.
Guiño a la sesión siguiente
Hoy hemos visto que la media y la desviación típica son una proyección y una norma. Eso ya es mucho. Pero hay más.
En la lección 5 llevaremos la misma lógica más lejos. Centrar los vectores significa trabajar con \(\boldsymbol{x} - \boldsymbol{\mathop{\overline{x}}}\) e \(\boldsymbol{y} - \boldsymbol{\mathop{\overline{y}}}\): las componentes perpendiculares a las proyecciones sobre \(\mathcal{L}(\boldsymbol{1})\), una por cada variable. El producto escalar de esos dos vectores en desviaciones es la covarianza:2 \[ \sigma_{\boldsymbol{x}\boldsymbol{y}} = \langle\boldsymbol{x} - \boldsymbol{\mathop{\overline{x}}},\, \boldsymbol{y} - \boldsymbol{\mathop{\overline{y}}}\rangle_s = \frac{1}{n}\sum_{i=1}^n(x_i - \mu_{\boldsymbol{x}})(y_i - \mu_{\boldsymbol{y}}). \] Y el coseno del ángulo entre esos vectores en desviaciones es el coeficiente de correlación de Pearson: \[ \rho_{\boldsymbol{x}\boldsymbol{y}} = \cos\theta = \frac{\langle\boldsymbol{x}-\boldsymbol{\mathop{\overline{x}}},\boldsymbol{y}-\boldsymbol{\mathop{\overline{y}}}\rangle_s}{\|\boldsymbol{x}-\boldsymbol{\mathop{\overline{x}}}\|_s\,\|\boldsymbol{y}-\boldsymbol{\mathop{\overline{y}}}\|_s} = \frac{\sigma_{\boldsymbol{x}\boldsymbol{y}}}{\sigma_{\boldsymbol{x}}\sigma_{\boldsymbol{y}}}. \] El ángulo, que en la lección 3 introdujimos como herramienta geométrica, resulta ser el coeficiente de correlación. La desigualdad de Cauchy–Schwarz, que en la lección 3 garantizaba que el coseno está en \([-1,1]\), garantiza aquí que \(\rho \in [-1,1]\). Todo es coherente.
Con la correlación en la mano, estaremos listos para abordar la regresión lineal simple: veremos que el coeficiente de regresión es, esencialmente, la correlación reescalada por las desviaciones típicas. Y el \(R^2\) de la regresión resultará ser \(\rho^2 = \cos^2\theta\): el cuadrado del coseno del ángulo entre los vectores en desviaciones.
En los libros de estadística, \(\rho_{\boldsymbol{x}\boldsymbol{y}}\) aparece a veces como \(r_{\boldsymbol{x}\boldsymbol{y}}\) cuando se quiere subrayar su carácter de estimador muestral; en este curso usaremos siempre \(\rho\).
11. Preguntas de repaso (sesión 5) htmlonly
Te propongo 12 preguntas. Las marco con un nivel orientativo: [B] básica, [M] media, [D] discriminadora.
Comentario
Las preguntas más valiosas pedagógicamente son la 11 (conecta la condición de primer orden del cálculo con la ortogonalidad geométrica, mostrando que son la misma cosa) y la 12 (fija el patrón general que vertebra toda la regresión). La pregunta 1 es imprescindible: el factor \(1/n\) no es un detalle técnico sino la consecuencia de una exigencia estadística fundamental, y conviene que los estudiantes lo tengan claro desde el principio.
Pregunta 1 [B] — Por qué el factor \(1/n\)
¿Por qué el producto escalar estadístico incluye el factor \(\frac{1}{n}\)?
- Para que la norma del vector \(\boldsymbol{1}\) sea igual a \(1\).
- Para que la covarianza sea siempre positiva.
- Para que la suma de las desviaciones respecto a la media sea igual a \(n\).
- Para facilitar el cálculo de la desviación típica.
Pregunta 2 [B] — Definición del vector de medias
¿Qué es el vector de medias \(\boldsymbol{\mathop{\overline{y}}}\)?
- El vector cuyas componentes son los cuadrados de la media.
- La proyección ortogonal de \(\boldsymbol{y}\) sobre \(\mathcal{L}(\boldsymbol{1})\).
- El vector \(\boldsymbol{y} - \mu_{\boldsymbol{y}}\boldsymbol{1}\).
- Es \(\mu_{\boldsymbol{y}}\).
Pregunta 3 [B] — Condición de ortogonalidad del vector en desviaciones
La condición \((\boldsymbol{y} - \boldsymbol{\mathop{\overline{y}}}) \perp \boldsymbol{1}\) equivale a:
- \(\sum y_i^2 = 0\).
- \(\max_i(y_i - \mu_{\boldsymbol{y}}) = 0\).
- \(\frac{1}{n}\sum(y_i - \mu_{\boldsymbol{y}}) = 0\).
- \(\sum(y_i - \mu_{\boldsymbol{y}})^2 = 1\).
Pregunta 4 [B] — La desviación típica como norma
La desviación típica \(\sigma_{\boldsymbol{y}}\) es:
- La norma del vector de medias \(\boldsymbol{\mathop{\overline{y}}}\).
- El producto escalar de \(\boldsymbol{y}\) con \(\boldsymbol{1}\).
- La norma del vector en desviaciones \(\boldsymbol{y} - \boldsymbol{\mathop{\overline{y}}}\).
- La distancia entre \(\boldsymbol{y}\) y el vector \(\boldsymbol{0}\).
Pregunta 5 [M] — Cálculo de la media y desviación típica
Sea \(\boldsymbol{x} = (1, 3) \in \mathbb{R}^2\) con el producto escalar estadístico. ¿Cuáles son \(\mu_{\boldsymbol{x}}\) y \(\sigma_{\boldsymbol{x}}\)?
- \(\mu_{\boldsymbol{x}} = 2\), \(\sigma_{\boldsymbol{x}} = \sqrt{2}\).
- \(\mu_{\boldsymbol{x}} = 4\), \(\sigma_{\boldsymbol{x}} = 2\).
- \(\mu_{\boldsymbol{x}} = 2\), \(\sigma_{\boldsymbol{x}} = 1\).
- \(\mu_{\boldsymbol{x}} = 2\), \(\sigma_{\boldsymbol{x}} = 2\).
Pregunta 6 [M] — Pitágoras estadístico
Para \(\boldsymbol{x} = (1,3)\), ¿se cumple \(\|\boldsymbol{x}\|_s^2 = \mu_{\boldsymbol{x}}^2 + \sigma_{\boldsymbol{x}}^2\)?
- No, porque Pitágoras solo vale en \(\mathbb{R}^3\).
- Sí: \(\|\boldsymbol{x}\|_s^2 = 5\), \(\mu^2 + \sigma^2 = 4 + 1 = 5\).
- No, porque \(\mu\) y \(\sigma\) no son vectores ortogonales.
- Sí, pero solo cuando la media es positiva.
Pregunta 7 [M] — Efecto de sumar una constante
Si \(\boldsymbol{z} = \boldsymbol{y} + 3\boldsymbol{1}\), ¿qué cambia respecto a \(\boldsymbol{y}\)?
- La media aumenta en \(3\) y la desviación típica también aumenta en \(3\).
- La media no cambia pero la desviación típica aumenta en \(3\).
- La media aumenta en \(3\) pero la desviación típica no cambia.
- Ni la media ni la desviación típica cambian.
Pregunta 8 [M] — Efecto de sumar un vector de media cero
Si \(\mu_{\boldsymbol{x}} = 0\) y \(\boldsymbol{z} = \boldsymbol{y} + \boldsymbol{x}\), ¿qué se puede afirmar?
- La media de \(\boldsymbol{z}\) es igual a la de \(\boldsymbol{y}\), y la desviación típica no cambia.
- La media de \(\boldsymbol{z}\) es igual a la de \(\boldsymbol{y}\), pero la desviación típica puede cambiar.
- Tanto la media como la desviación típica de \(\boldsymbol{z}\) coinciden con las de \(\boldsymbol{y}\).
- La media de \(\boldsymbol{z}\) cambia, pero la desviación típica no.
Pregunta 9 [M] — La media como caso de MCO (de mínimos cuadrados ordinarios)
¿Por qué se dice que calcular la media aritmética es un caso particular de mínimos cuadrados?
- Porque la media minimiza \(\sum |y_i - c|\) sobre todos los escalares \(c\).
- Porque la media es el valor \(c\) que minimiza \(\frac{1}{n}\sum(y_i - c)^2\), es decir, \(\|\boldsymbol{y} - c\boldsymbol{1}\|_s^2\).
- Porque la media coincide con la mediana cuando los datos son simétricos.
- Porque la media minimiza la norma del vector de medias \(\boldsymbol{\mathop{\overline{y}}}\).
Pregunta 10 [D] — Norma del vector \(\boldsymbol{1}\) en \(\mathbb{R}^4\)
Con el producto escalar estadístico en \(\mathbb{R}^4\), ¿cuánto vale \(\|\boldsymbol{1}\|_s\)?
- \(4\).
- \(2\).
- \(1\).
- \(\frac{1}{2}\).
Pregunta 11 [D] — Interpretación de la condición de primer orden
Al minimizar \(f(\alpha) = \frac{1}{n}\sum(y_i - \alpha)^2\), la condición de primer orden \(f'(\alpha) = 0\) equivale a:
- \(\sum y_i^2 = n\alpha^2\).
- \(\langle\boldsymbol{y} - \alpha\boldsymbol{1},\, \boldsymbol{1}\rangle_s = 0\), es decir, \((\boldsymbol{y} - \alpha\boldsymbol{1}) \perp \boldsymbol{1}\).
- \(\|\boldsymbol{y}\|_s^2 = \|\alpha\boldsymbol{1}\|_s^2\).
- \(\alpha = \|\boldsymbol{y}\|_s\).
Pregunta 12 [D] — Guiño a la regresión
En la regresión lineal simple (con regresor \(\boldsymbol{x}\) además de \(\boldsymbol{1}\)), ¿cuántas condiciones de ortogonalidad habrá sobre el vector de residuos?
- Una sola: \((\boldsymbol{y} - \boldsymbol{\mathop{\widehat{y}}}) \perp \boldsymbol{1}\).
- Ninguna: en la regresión no se usa la ortogonalidad.
- Dos: \((\boldsymbol{y} - \boldsymbol{\mathop{\widehat{y}}}) \perp \boldsymbol{1}\) y \((\boldsymbol{y} - \boldsymbol{\mathop{\widehat{y}}}) \perp \boldsymbol{x}\).
- Tantas como observaciones haya.
12. Respuestas htmlonly
- Pregunta 1 [B] — Por qué el factor \(1/n\)
Respuesta correcta: 1. Evalúa: comprensión de la motivación del factor \(1/n\).
- Pregunta 2 [B] — Definición del vector de medias
Respuesta correcta: 2. Evalúa: definición del vector de medias como proyección.
- Pregunta 3 [B] — Condición de ortogonalidad del vector en desviaciones
Respuesta correcta: 3. Evalúa: traducción de la condición de ortogonalidad al lenguaje de sumatorios.
- Pregunta 4 [B] — La desviación típica como norma
Respuesta correcta: 3. Evalúa: definición geométrica de la desviación típica.
- Pregunta 5 [M] — Cálculo de la media y desviación típica
Respuesta correcta: 3. Evalúa: cálculo directo. \(\mu = \frac{1}{2}(1+3) = 2\); Vector en desviaciones \(= (-1,1)\); \(\sigma = \sqrt{\frac{1}{2}(1+1)} = 1\).
- Pregunta 6 [M] — Pitágoras estadístico
Respuesta correcta: 2. Evalúa: verificación de la identidad pitagórica. \(\|\boldsymbol{x}\|_s^2 = \frac{1}{2}(1+9) = 5\).
- Pregunta 7 [M] — Efecto de sumar una constante
Respuesta correcta: 3. Evalúa: propiedad geométrica de la proyección: sumar \(3\boldsymbol{1}\) desplaza la componente en \(\mathcal{L}(\boldsymbol{1})\) sin tocar la componente perpendicular.
- Pregunta 8 [M] — Efecto de sumar un vector de media cero
Respuesta correcta: 2. Evalúa: comprensión de que \(\boldsymbol{x} \perp \boldsymbol{1}\) implica que la proyección sobre \(\mathcal{L}(\boldsymbol{1})\) no cambia, pero la componente perpendicular sí puede cambiar y, consecuentemente, cambiar su longitud (que es la desviación típica).
- Pregunta 9 [M] — La media como caso de MCO (de mínimos cuadrados ordinarios)
Respuesta correcta: 2. Evalúa: comprensión del vínculo entre la media y la proyección como problema de minimización.
- Pregunta 10 [D] — Norma del vector \(\boldsymbol{1}\) en \(\mathbb{R}^4\)
Respuesta correcta: 3. Evalúa: comprensión de que el factor \(1/n\) hace que \(\|\boldsymbol{1}\|_s = 1\) independientemente de \(n\). \(\|\boldsymbol{1}\|_s^2 = \frac{1}{4}(1+1+1+1) = 1\).
- Pregunta 11 [D] — Interpretación de la condición de primer orden
Respuesta correcta: 2. Evalúa: conexión entre la condición de primer orden del cálculo y la condición de ortogonalidad. Discrimina porque exige haber seguido la doble derivación (analítica y geométrica) de la transparencia 3.
- Pregunta 12 [D] — Guiño a la regresión
Respuesta correcta: 3. Evalúa: comprensión del patrón general (una condición por regresor) anticipado al final de la transparencia 5. Discrimina porque requiere haber asimilado el guiño al futuro.
Notas al pie de página:
Usamos aquí la palabra ``dimensión'' de forma completamente informal, apoyándonos en la intuición visual de recta (una dirección) y plano (dos direcciones). En la lección 5 precisaremos esta idea con más calma, al explicar por qué en \(\mathbb{R}^2\) la correlación entre dos vectores es siempre \(\pm1\).
Adelantamos ya las fórmulas exactas, a modo de anticipo; la lección 5 las presentará como definiciones formales y se detendrá con calma en justificar por qué tienen precisamente esa forma.