Lección 4. Proyección ortogonal, media y desviación típica
Author: Marcos Bujosa
De dónde venimos: la proyección ortogonal
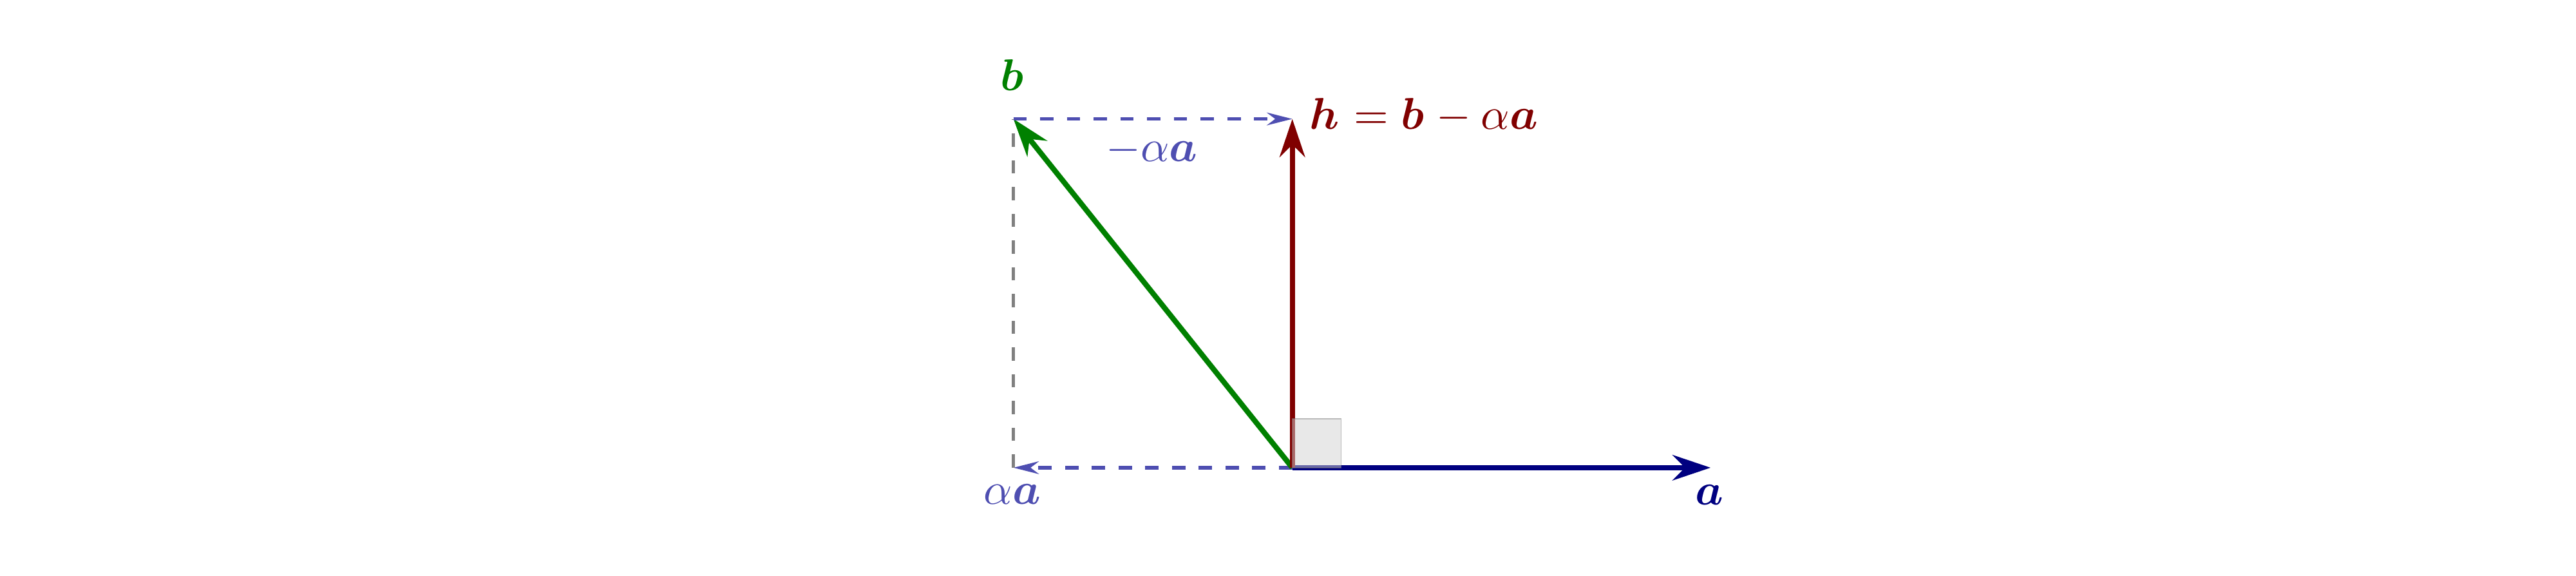
En la lección 3 construimos un vector $\boldsymbol{h} = \boldsymbol{b} - \alpha\boldsymbol{a}$ ortogonal a $\boldsymbol{a}$:
 $$
\langle\boldsymbol{a},\,\boldsymbol{h}\rangle = 0
\;\Longrightarrow\;
\alpha = \frac{\langle\boldsymbol{a},\,\boldsymbol{b}\rangle}{\langle\boldsymbol{a},\,\boldsymbol{a}\rangle};
\qquad
\boldsymbol{b} = \underbrace{\alpha\boldsymbol{a}}_{\text{``sombra''}} + \underbrace{\boldsymbol{h}}_{\perp\,\boldsymbol{a}}.
$$
Dijimos que cuando $\boldsymbol{a} = \boldsymbol{1}$ ``ese $\alpha$ resultará ser la media''.
El vector $\alpha\boldsymbol{a}$, que llamamos ``sombra'' de $\boldsymbol{b}$ sobre $\boldsymbol{a}$, es lo que ahora
llamaremos proyección ortogonal. Veremos que:
- La media aritmética es fruto de una proyección ortogonal (sobre $\mathcal{L}(\boldsymbol{1})$).
- La desviación típica es una norma (distancia).
El principio que une ambos conceptos es la ortogonalidad.
El producto escalar en la estadística
Con el producto escalar estándar, $\|\boldsymbol{1}\|_e^2 = \langle\boldsymbol{1},\boldsymbol{1}\rangle_e = \sum\nolimits_{i=1}^n 1 = n \neq 1$.
Exigencia estadística: la media de un vector constante $c$ debe ser $c$. Equivalentemente: $\|\boldsymbol{1}\|=1$.
La solución: un nuevo producto escalar con factor de corrección $\frac{1}{n}$: $$ \langle\boldsymbol{x},\boldsymbol{y}\rangle_{s} = \frac{1}{n}\,\langle\boldsymbol{x},\boldsymbol{y}\rangle_{e} = \frac{1}{n}\sum_{i=1}^n x_i y_i. $$
Ahora $\|\boldsymbol{1}\|_s^2 = \langle\boldsymbol{1},\boldsymbol{1}\rangle_s = \frac{1}{n} n = 1$, como queríamos.
- Hereda las propiedades de producto escalar: simetría, linealidad, definido positivo.
- La norma asociada: $\|\boldsymbol{x}\|_s = \sqrt{\langle\boldsymbol{x},\boldsymbol{x}\rangle_s} = \sqrt{\frac{1}{n}\sum x_i^2}$.
- La ortogonalidad: $\boldsymbol{x}\perp\boldsymbol{y} \Leftrightarrow {\langle\boldsymbol{x},\boldsymbol{y}\rangle}_e = 0 \Leftrightarrow {\langle\boldsymbol{x},\boldsymbol{y}\rangle}_s = 0$.
- Por tanto, el Teorema de Pitágoras, Cauchy–Schwarz y la desigualdad triangular de la lección 3 siguen siendo válidos con $\langle\cdot,\cdot\rangle_s$ y $\|\cdot\|_s$.
La media: dos caras de la misma moneda
Primera cara: la media como producto escalar con $\boldsymbol{1}$. $$ \mu_{\boldsymbol{y}} \;=\; \langle\boldsymbol{y}, \boldsymbol{1}\rangle_s \;=\; \frac{1}{n}\sum_{i=1}^n y_i. $$
Segunda cara: la media como proyección ortogonal sobre $\mathcal{L}(\boldsymbol{1})$ (los múltiplos de $\boldsymbol{1}$).
Buscamos $\alpha$ tal que $(\boldsymbol{y} - \alpha\boldsymbol{1})\perp\boldsymbol{1}$: $$ \langle\boldsymbol{y} - \alpha\boldsymbol{1},\, \boldsymbol{1}\rangle_s = 0 \;\Longrightarrow\; \langle\boldsymbol{y},\boldsymbol{1}\rangle_s - \alpha\,\langle\boldsymbol{1},\boldsymbol{1}\rangle_s = 0 \;\Longrightarrow\; \alpha = \frac{\langle\boldsymbol{y},\boldsymbol{1}\rangle_s}{\langle\boldsymbol{1},\boldsymbol{1}\rangle_s} = \frac{\mu_{\boldsymbol{y}}}{1} = \mu_{\boldsymbol{y}}. $$ (Ambas caras colapsan: $\alpha = \mu_{\boldsymbol{y}}$.)
Llamaremos vector de medias $\boldsymbol{\mathop{\overline{y}}} = \mu_{\boldsymbol{y}}\boldsymbol{1}$ al vector constante cuyas componentes son todas iguales a $\mu_{\boldsymbol{y}}$. El vector de medias $\boldsymbol{\mathop{\overline{y}}}$ es la proyección ortogonal de $\boldsymbol{y}$ sobre $\mathcal{L}(\boldsymbol{1})$.
Ilustración geométrica de la proyección
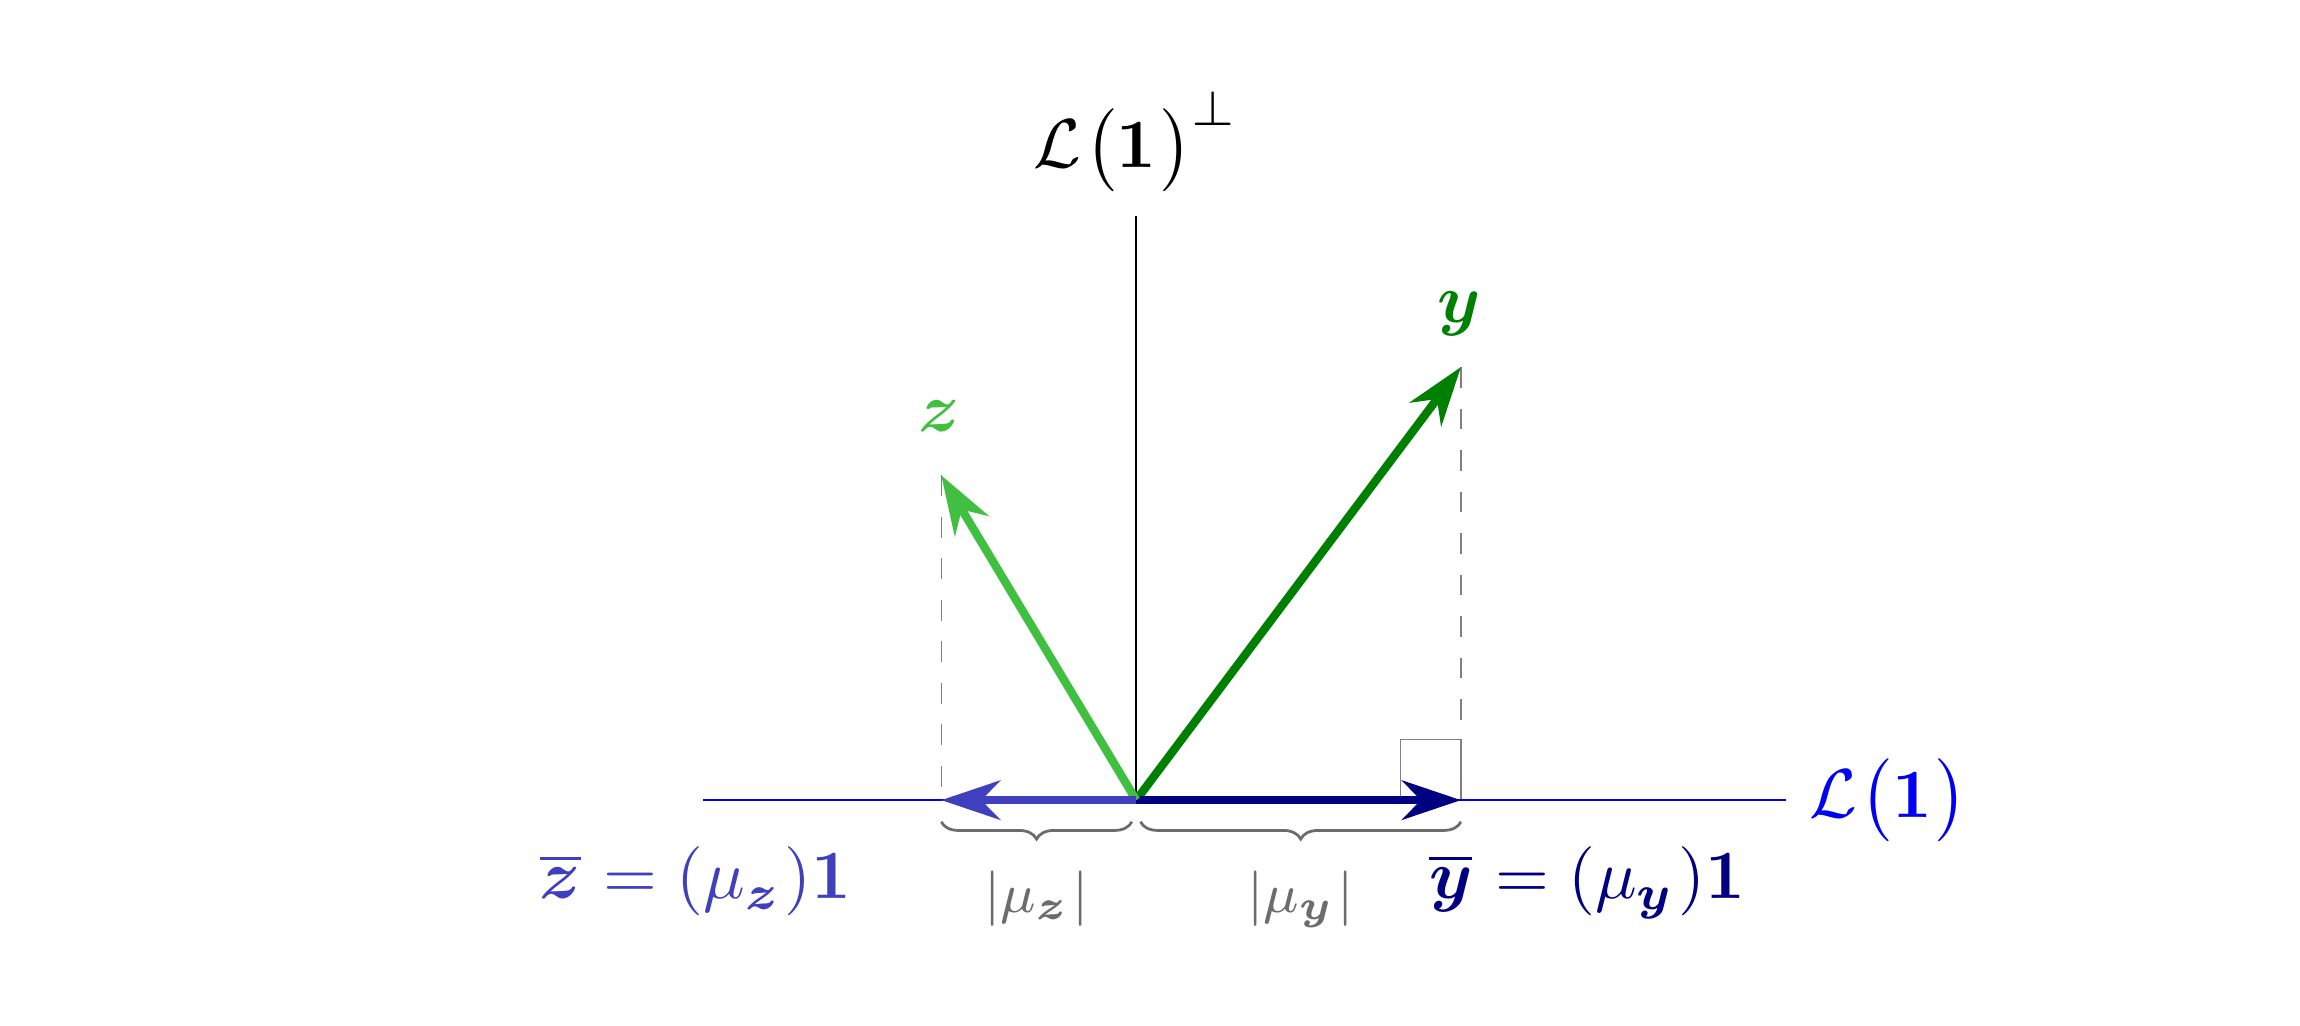
El vector $\boldsymbol{y}$ (verde oscuro) se proyecta sobre $\mathcal{L}(\boldsymbol{1})$ (la recta de los vectores constantes, en azul). La ``sombra'' $\boldsymbol{\mathop{\overline{y}}} = \mu_{\boldsymbol{y}}\boldsymbol{1}$ es su correspondiente vector de medias, cuya longitud es $|\mu_{\boldsymbol{y}}|$. El vector $\boldsymbol{z}$ (verde claro) es otro ejemplo con media negativa.
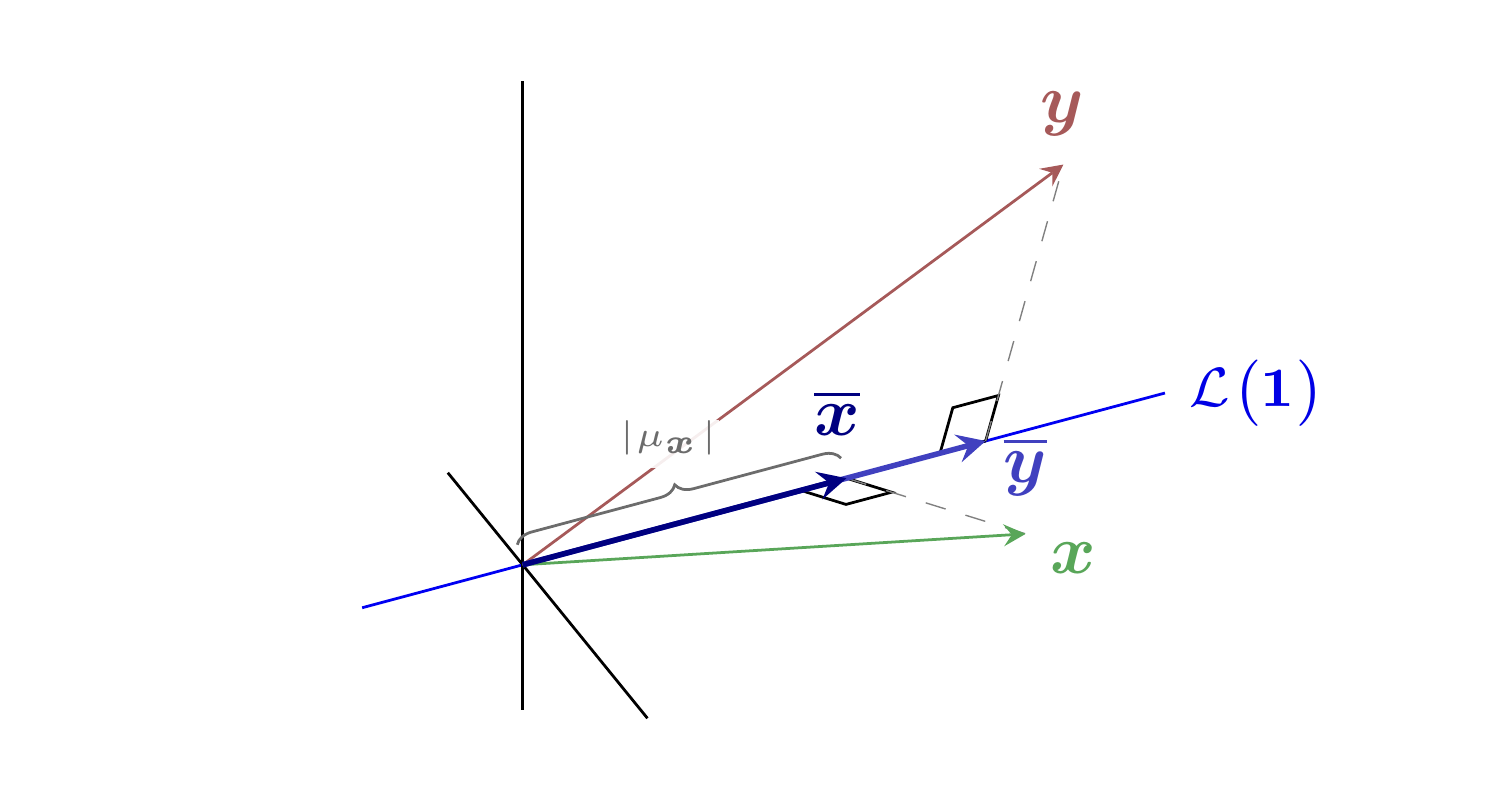
Representación de dos vectores, $\boldsymbol{y}$ (rojo) y $\boldsymbol{x}$ (verde claro), y sus proyecciones ortogonales sobre $\mathcal{L}(\boldsymbol{1})$; es decir, sus correspondientes vectores de medias $\boldsymbol{\mathop{\overline{y}}}$ y $\boldsymbol{\mathop{\overline{x}}}$. Los ejes de color negro son perpendiculares a $\boldsymbol{1}$, es decir, pertenecen al complemento ortogonal $\mathcal{L}(\boldsymbol{1})^\perp$: el conjunto de todos los vectores perpendiculares a $\boldsymbol{1}$.
Ilustración con la visión estadística
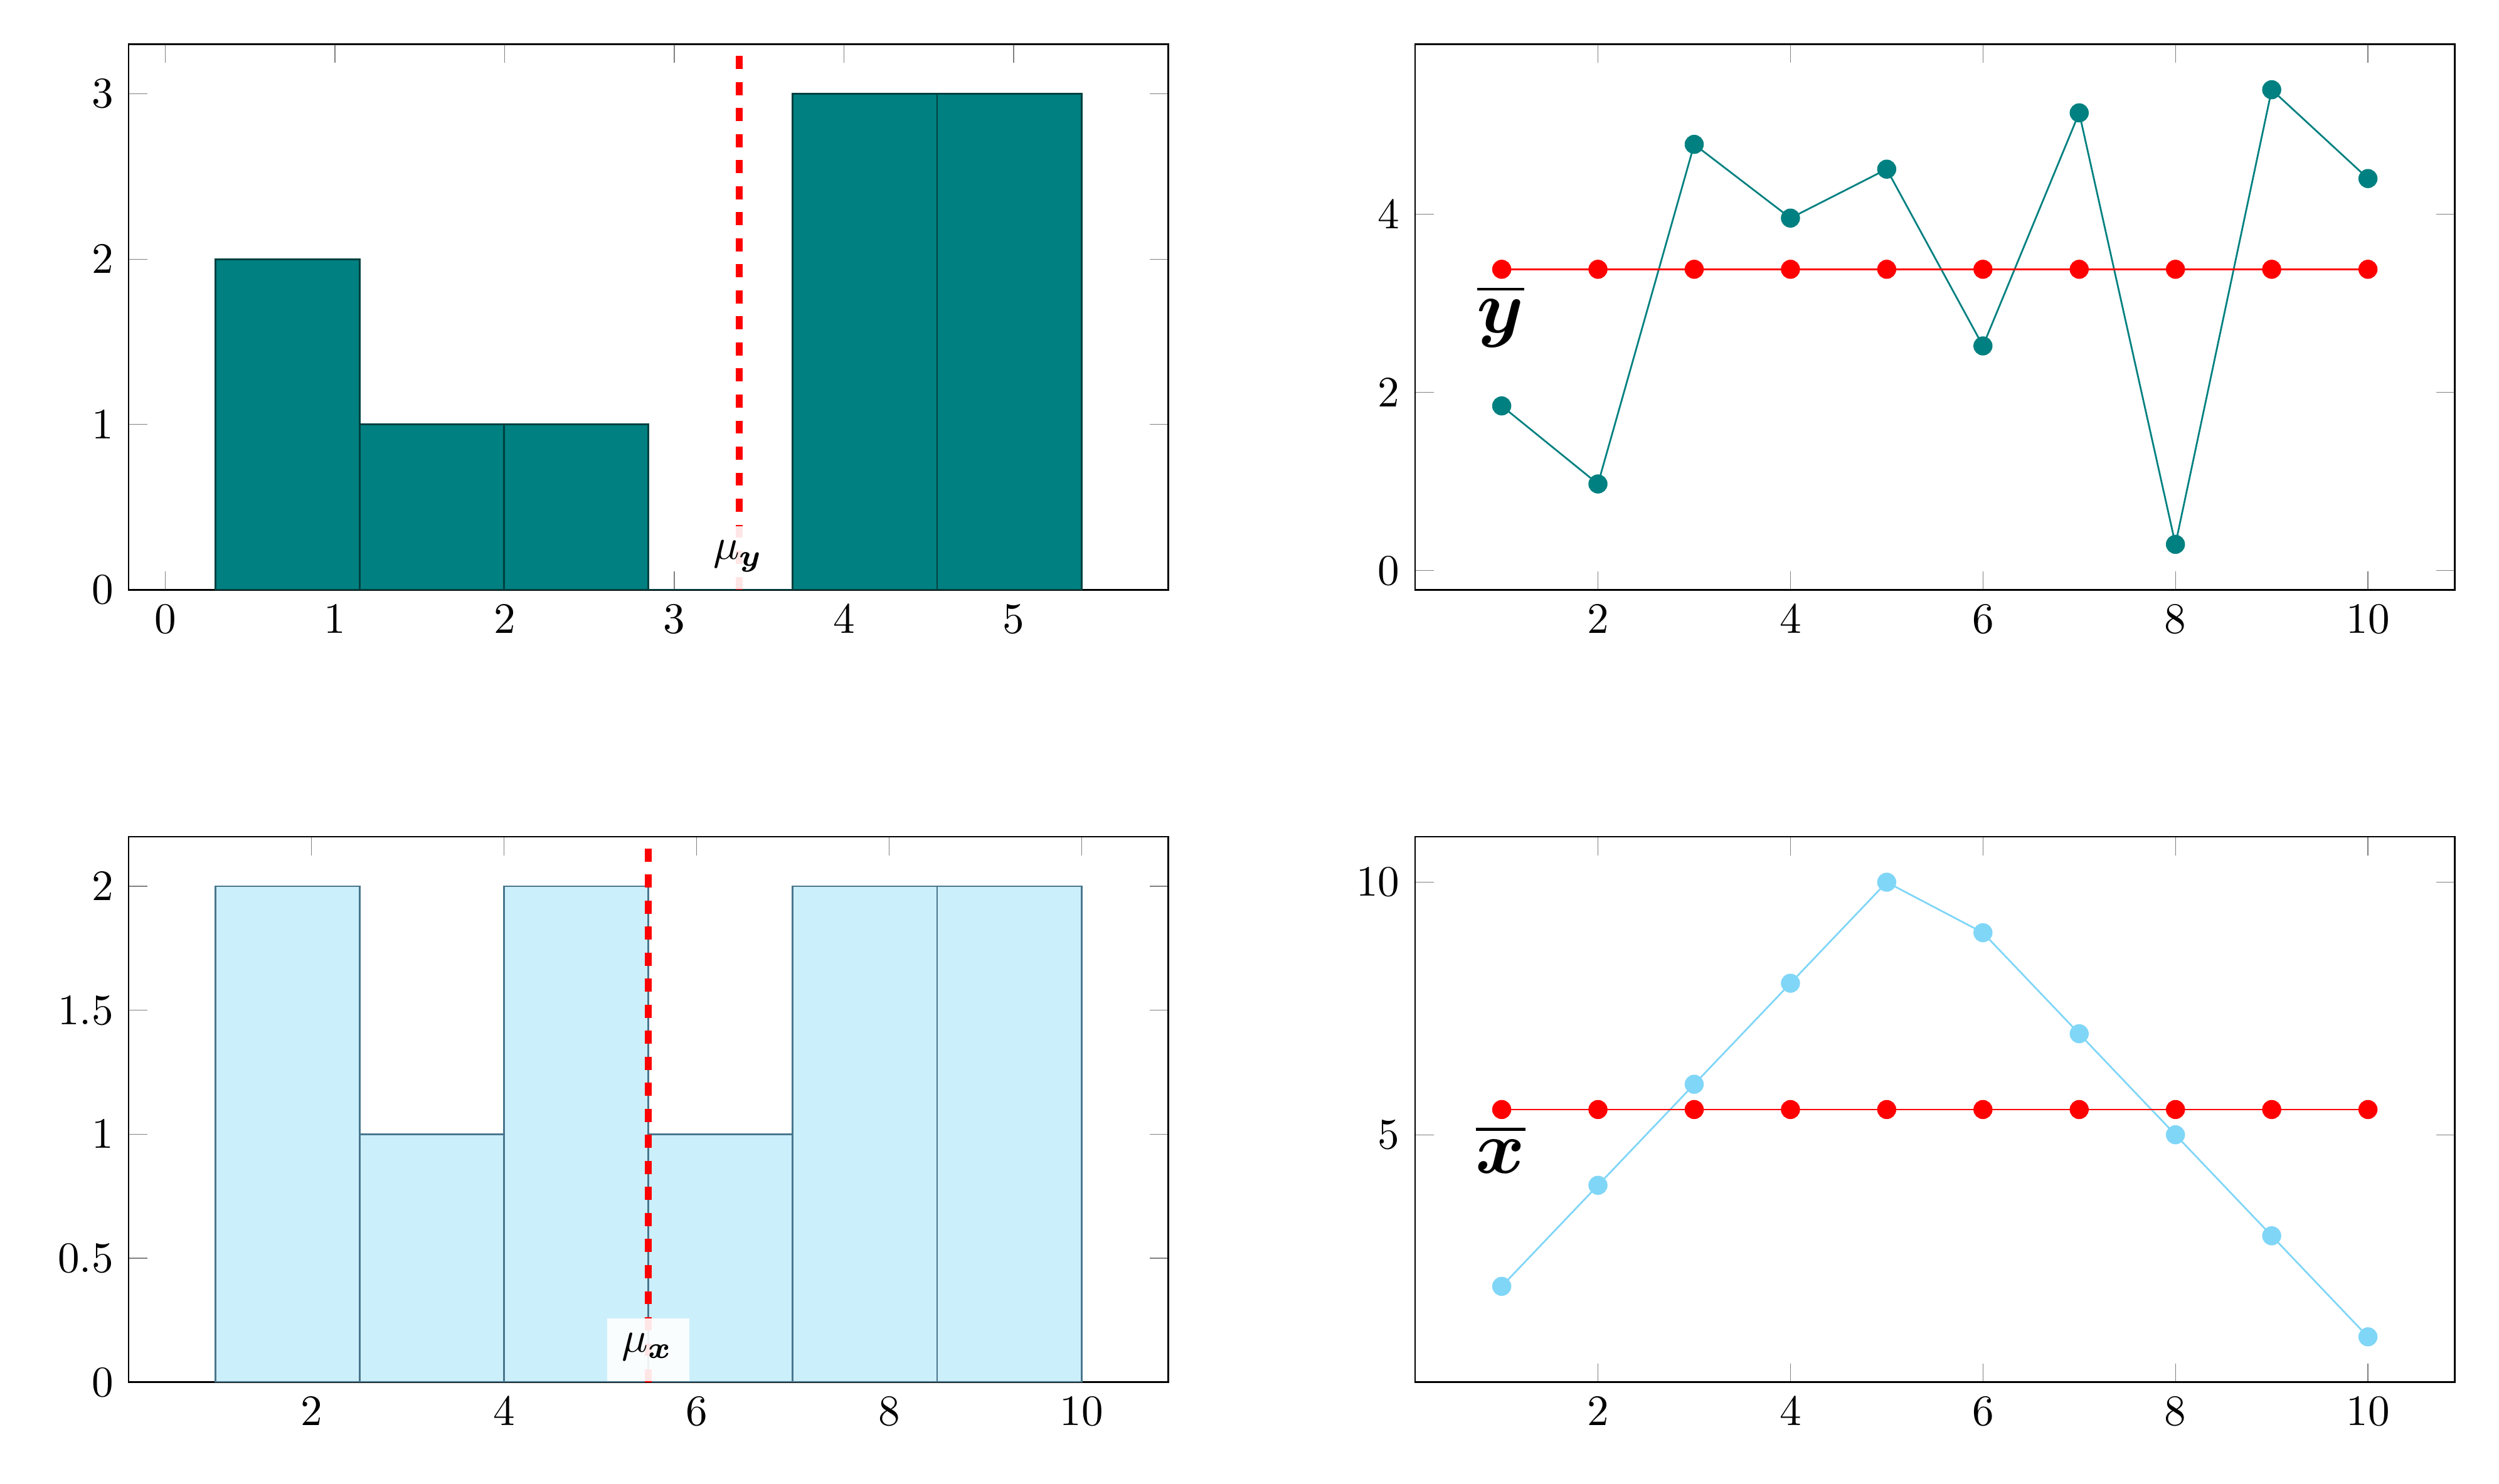
$\mu_{\boldsymbol{y}}$: un punto en el histograma; $\quad\boldsymbol{\mathop{\overline{y}}}=\mu_{\boldsymbol{y}}\boldsymbol{1}$ un vector constante en $\mathbb{R}^n$.
El vector en desviaciones es ortogonal a $\boldsymbol{1}$
El vector en desviaciones (respecto a la media) es $$\boldsymbol{y} - \boldsymbol{\mathop{\overline{y}}} \; = \; \boldsymbol{y} - \mu_{\boldsymbol{y}}\boldsymbol{1}.$$
Por construcción, $(\boldsymbol{y} - \boldsymbol{\mathop{\overline{y}}}) \perp \boldsymbol{1}$, es decir: $$ \langle\boldsymbol{y} - \boldsymbol{\mathop{\overline{y}}},\, \boldsymbol{1}\rangle_s = 0 \;\Longleftrightarrow\; \frac{1}{n}\sum_{i=1}^n (y_i - \mu_{\boldsymbol{y}}) = 0. $$
Por tanto, la media del vector en desviaciones, $\mu_{(\boldsymbol{y} - \boldsymbol{\mathop{\overline{y}}})}$, es cero.
Esta no es una propiedad que surja a posteriori; esta es la condición de ortogonalidad que caracteriza a la media.
Resumiendo:
La estadística descompone el vector de datos $\boldsymbol{y}$ en dos componentes ortogonales: $$ \boldsymbol{y} = \underbrace{\boldsymbol{\mathop{\overline{y}}}}_{\text{Vector de medias}} + \underbrace{(\boldsymbol{y}-\boldsymbol{\mathop{\overline{y}}})}_{\text{Vector en desviaciones}}, $$ donde el vector de medias es un vector constante: $\boldsymbol{\mathop{\overline{y}}}=\mu_{\boldsymbol{y}}\boldsymbol{1}$; es decir, $\boldsymbol{\mathop{\overline{y}}}\in\mathcal{L}(\boldsymbol{1})$; y donde la constante $\mu_{\boldsymbol{y}}$ se denomina media aritmética.
Avance: la regresión lineal simple descompondrá $\boldsymbol{y}$ en dos componentes ortogonales: $$ \boldsymbol{y} = \underbrace{\boldsymbol{\mathop{\widehat{y}}}}_{\text{Ajuste}} + \underbrace{\boldsymbol{\mathop{\widehat{e}}}}_{\text{Vector de residuos}}, $$ donde $\boldsymbol{\mathop{\widehat{y}}}\in\mathcal{L}(\boldsymbol{1},\boldsymbol{x})$; es decir, $\boldsymbol{\mathop{\widehat{y}}}$ es una combinación lineal de $\boldsymbol{1}$ y $\boldsymbol{x}$. Consecuentemente habrá dos condiciones de ortogonalidad (una por cada regresor).
La regresión lineal múltiple es similar, con tantas condiciones de ortogonalidad como regresores. La lógica será siempre la misma.
Desviación típica: como norma del vector en desviaciones
Definición. La desviación típica de $\boldsymbol{y}$ es la norma del componente $\boldsymbol{y} - \boldsymbol{\mathop{\overline{y}}}$ ortogonal a $\boldsymbol{1}$:$$ \sigma_{\boldsymbol{y}} = \|\boldsymbol{y} - \boldsymbol{\mathop{\overline{y}}}\|_s = \sqrt{\frac{1}{n}\sum\limits_{i=1}^n(y_i - \mu_{\boldsymbol{y}})^2}. $$
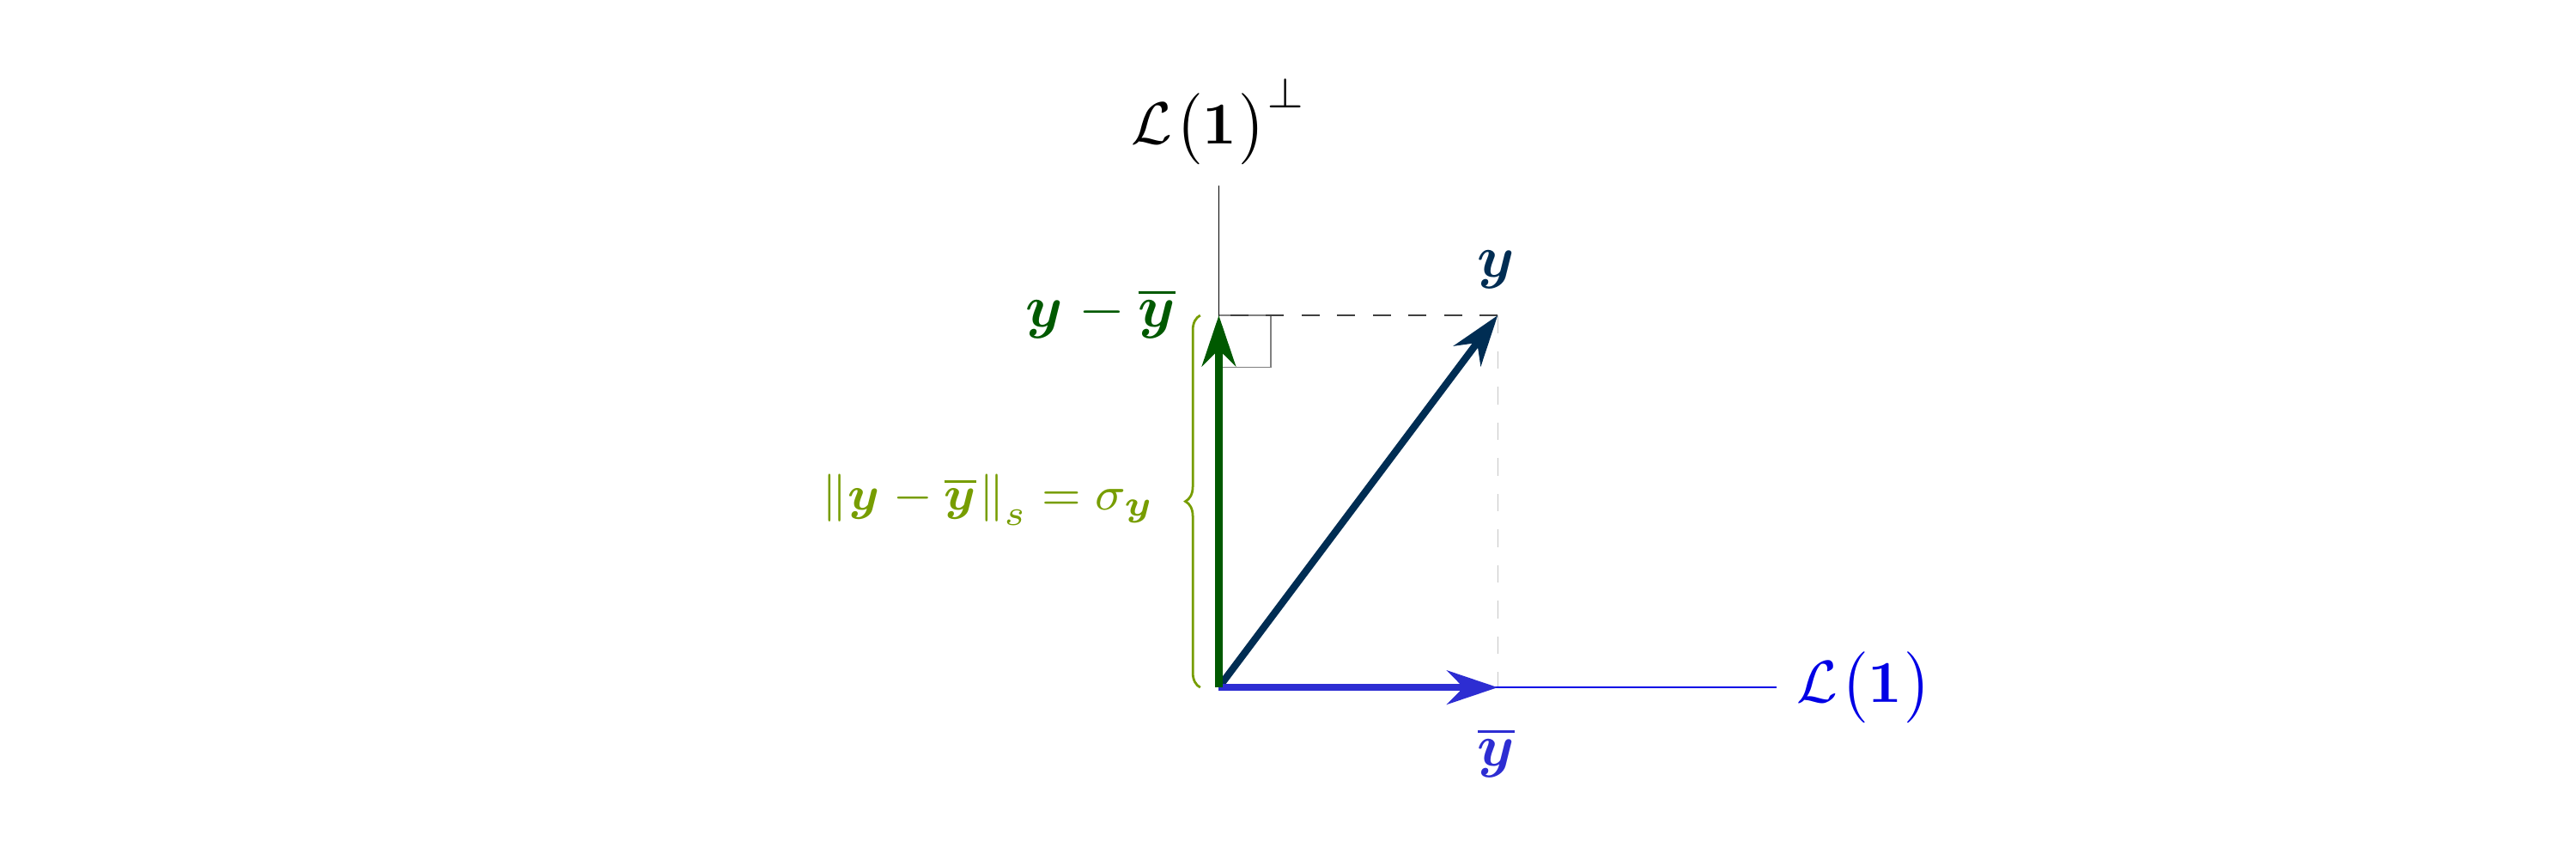
Como $\boldsymbol{\mathop{\overline{y}}} \perp (\boldsymbol{y} - \boldsymbol{\mathop{\overline{y}}})$, el Teorema de Pitágoras de la lección 3 aplicado a $\boldsymbol{y} = \boldsymbol{\mathop{\overline{y}}} + (\boldsymbol{y}-\boldsymbol{\mathop{\overline{y}}})$ da: $$ \|\boldsymbol{y}\|_s^2 = \|\boldsymbol{\mathop{\overline{y}}}\|_s^2 + \|\boldsymbol{y} - \boldsymbol{\mathop{\overline{y}}}\|_s^2 = \|\boldsymbol{\mathop{\overline{y}}}\|_s^2 + \sigma_{\boldsymbol{y}}^2. $$ La lección 5 desarrollará esta identidad en profundidad.
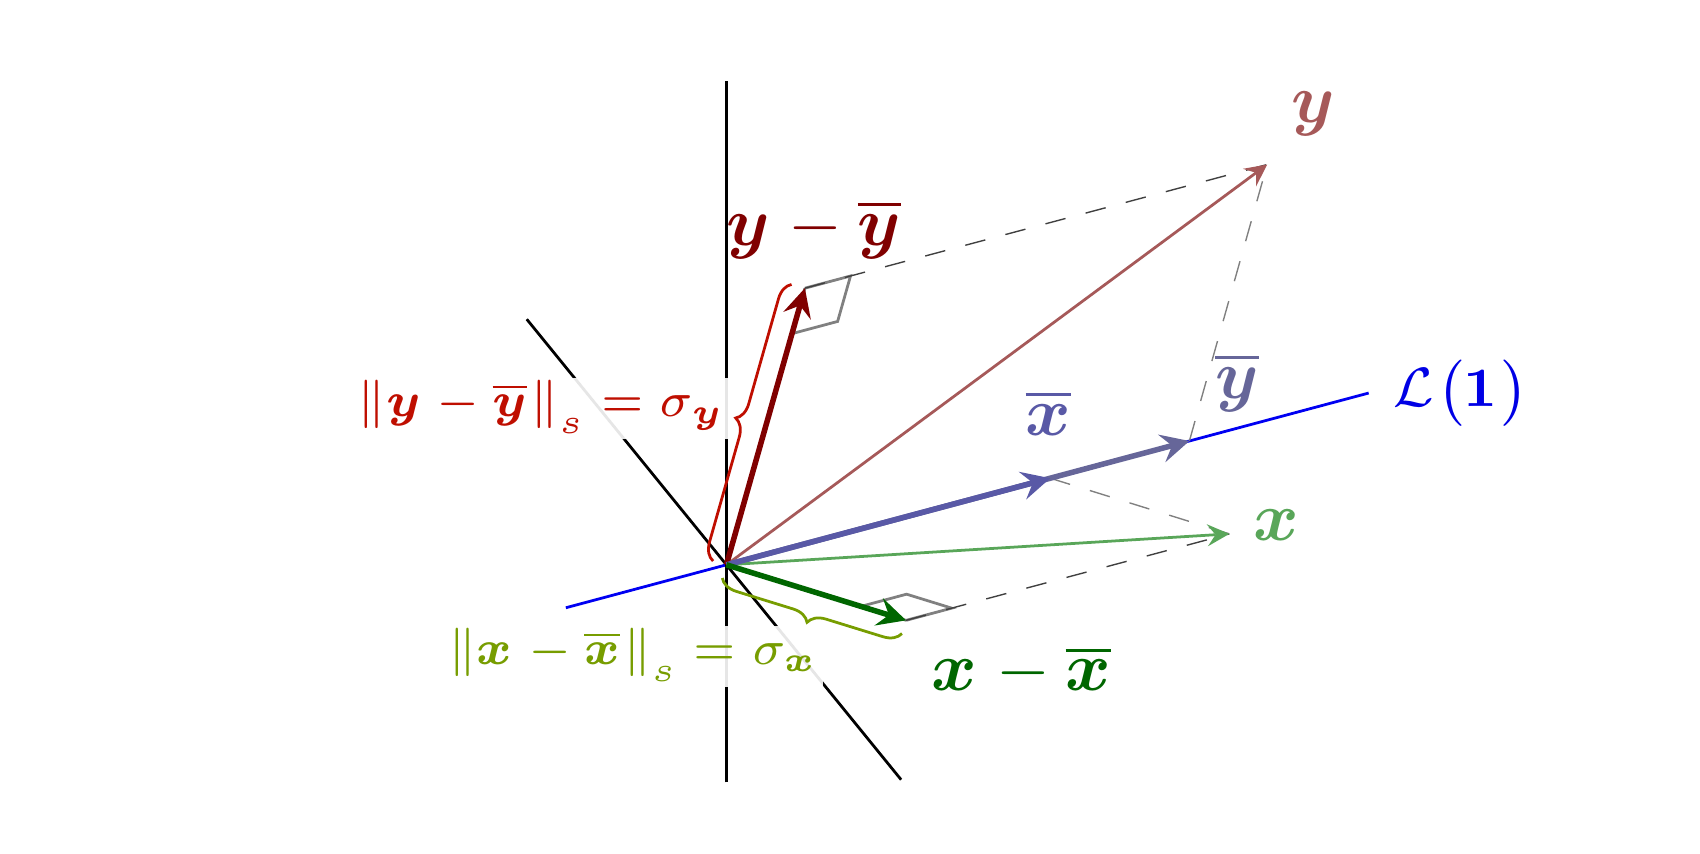
En $\mathbb{R}^3$: proyecciones de $\boldsymbol{y}$ y $\boldsymbol{x}$ sobre $\mathcal{L}(\boldsymbol{1})$ y sobre $\mathcal{L}(\boldsymbol{1})^\perp$. Las normas de las proyecciones sobre $\mathcal{L}(\boldsymbol{1})^\perp$ son las desviaciones típicas respectivas.
Ejemplos numéricos en $\mathbb{R}^2$
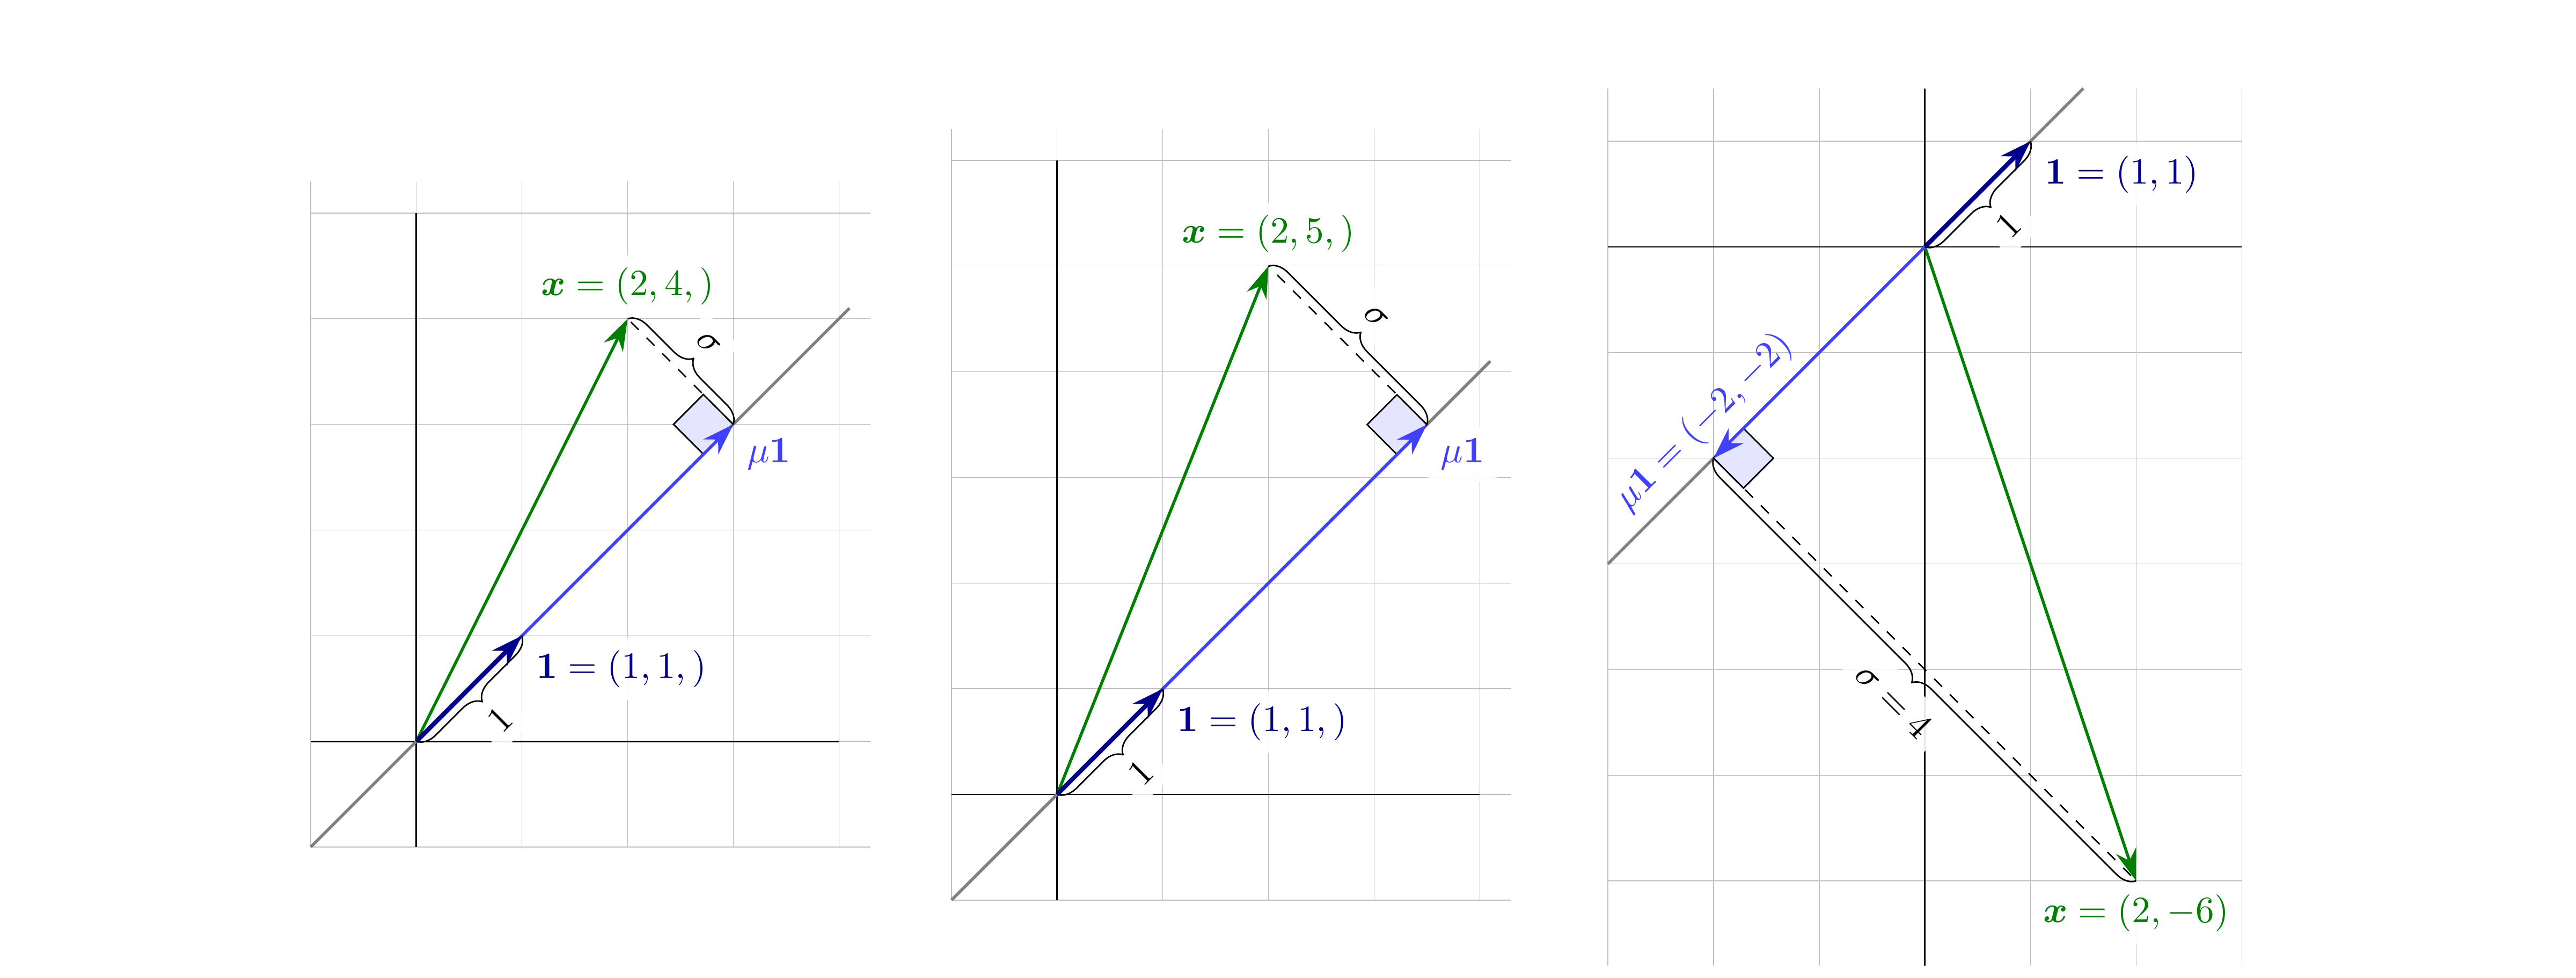
Las figuras de hoy tienen su versión interactiva en $\mathbb{R}^3$: rote los vectores y compruebe que la desviación típica es la norma del vector en desviaciones.
Propiedades geométricas
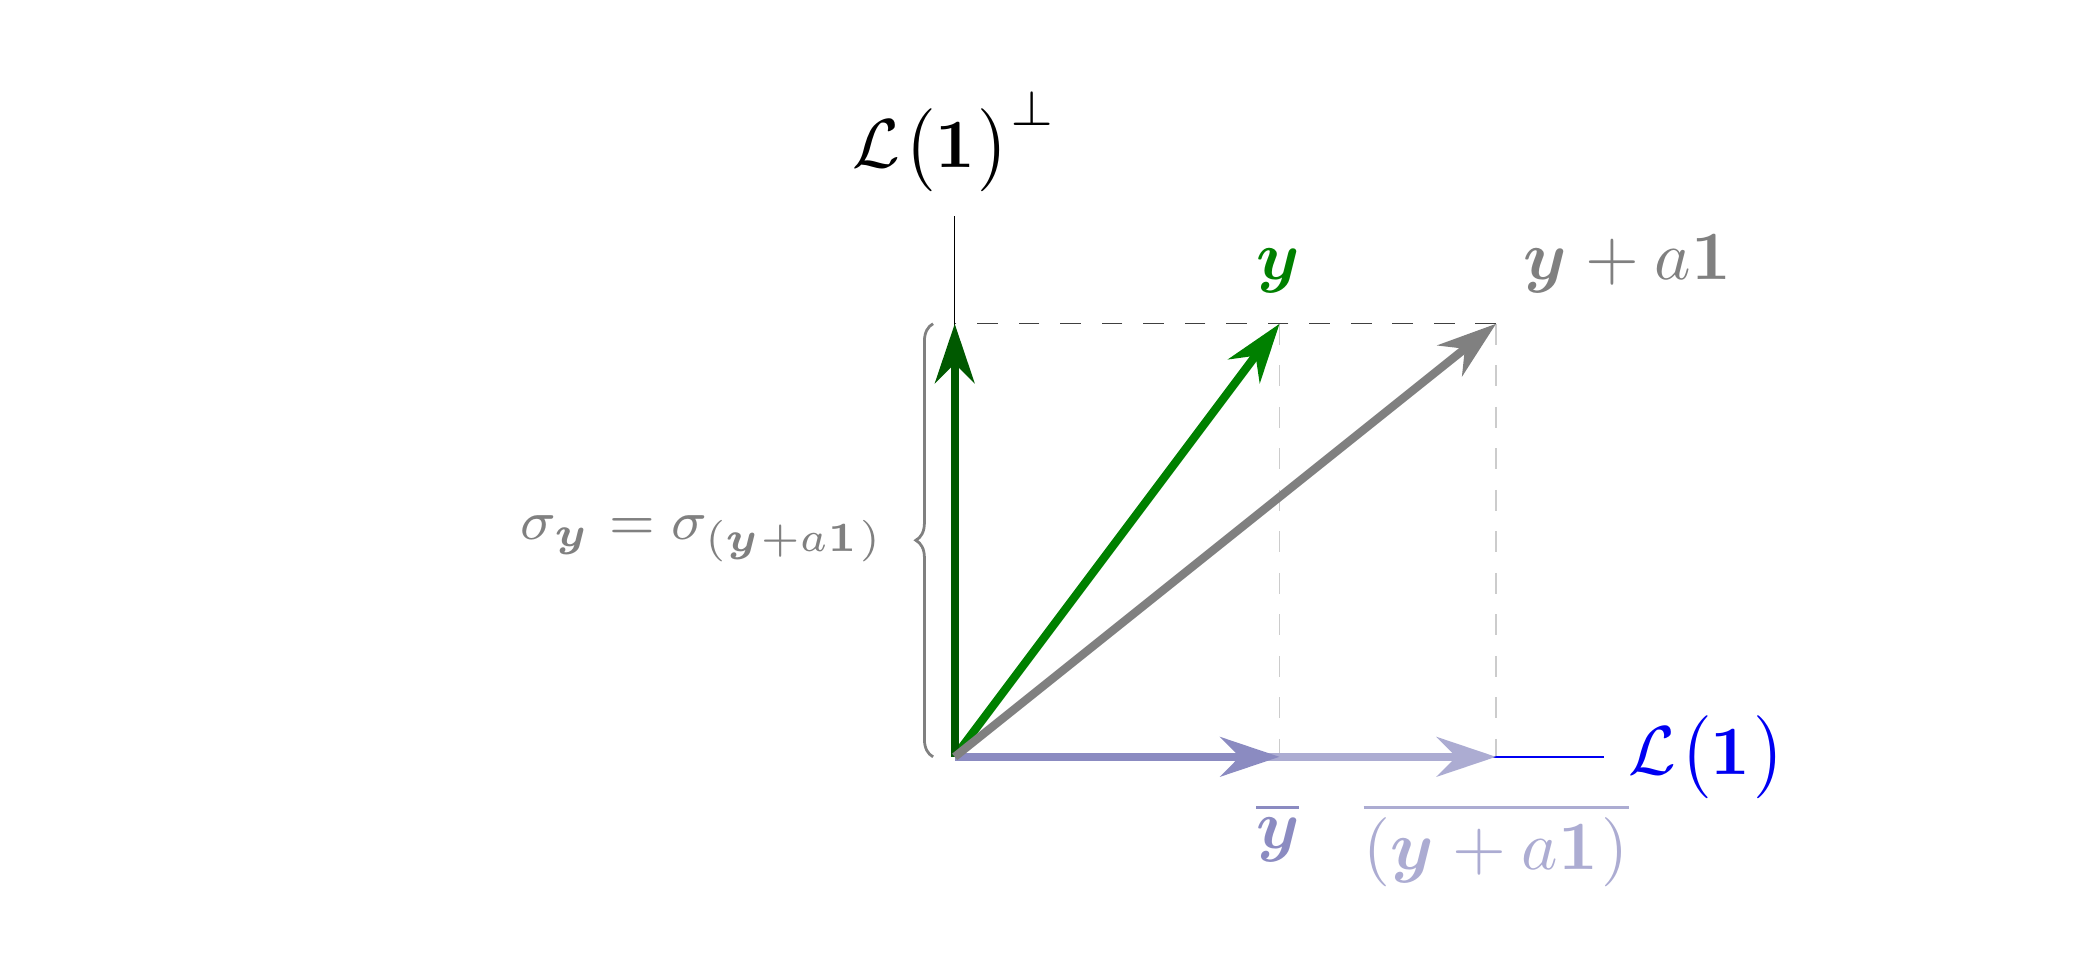
Sumar una constante no nula ($\boldsymbol{y} + a\boldsymbol{1}$): cambia la media $\mu$, pero nunca la desviación típica $\sigma$.
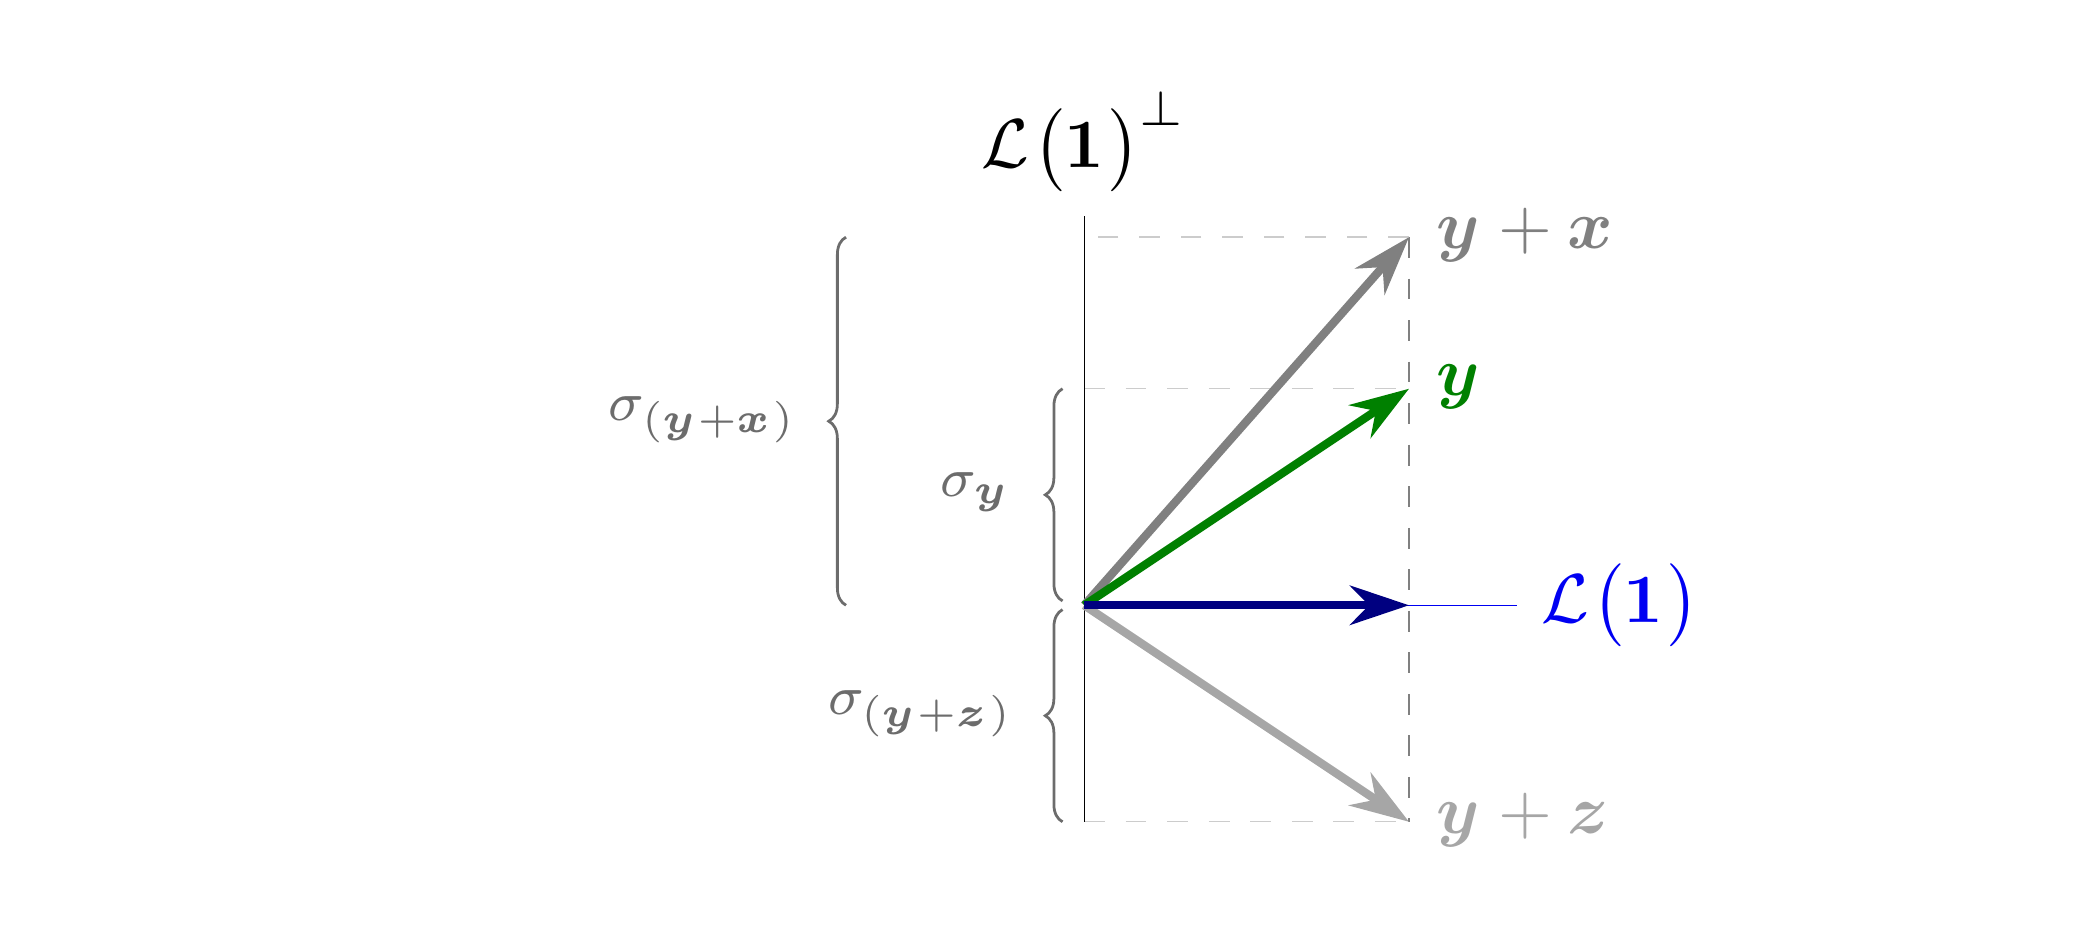
Sumar un vector de media cero (i.e., perpendicular a $\boldsymbol{1}$): no cambia la media $\mu$, pero generalmente cambia la desviación típica $\sigma$.
Recapitulación
| Objeto/Concepto | Definición geométrica/algebraica | Fórmula en estadística descriptiva |
|---|---|---|
| Media $\mu_{\boldsymbol{y}}$ | $\langle\boldsymbol{y},\boldsymbol{1}\rangle_s$ | $\frac{1}{n}\sum y_i$ |
| Vector de medias $\boldsymbol{\mathop{\overline{y}}}$ | Proyección de $\boldsymbol{y}$ sobre $\mathcal{L}(\boldsymbol{1})$ | --- |
| Vector en desviaciones | $\boldsymbol{y} - \boldsymbol{\mathop{\overline{y}}}$, con $(\boldsymbol{y}-\boldsymbol{\mathop{\overline{y}}})\perp\boldsymbol{1}$ | --- |
| Desviación típica $\sigma_{\boldsymbol{y}}$ | $\Vert\boldsymbol{y} - \boldsymbol{\mathop{\overline{y}}}\Vert_s$ | $\sqrt{\frac{1}{n}\sum(y_i-\mu_{\boldsymbol{y}})^2}$ |
| Teorema de Pitágoras (*) | $\Vert\boldsymbol{y}\Vert_s^2 = \Vert\boldsymbol{\mathop{\overline{y}}}\Vert_s^2 + \sigma_{\boldsymbol{y}}^2$ | $\frac{1}{n}\sum y_i^2 = \mu_{\boldsymbol{y}}^2 + \sigma_{\boldsymbol{y}}^2$ |
(*) Lo veremos con más detalle en la siguiente lección.
El principio unificador: la media $\mu_{\boldsymbol{y}}$ es, a la vez, el producto escalar $\langle\boldsymbol{y},\boldsymbol{1}\rangle_s$ y el coeficiente de la proyección ortogonal de $\boldsymbol{y}$ sobre $\mathcal{L}(\boldsymbol{1})$. La ortogonalidad lo define todo.
Guiño a la sesión siguiente
Lección 5: varianza, covarianza y correlación.
- La varianza $\sigma_{\boldsymbol{y}}^2 = \|\boldsymbol{y} - \boldsymbol{\mathop{\overline{y}}}\|_s^2$: Tma. de Pitágoras con más profundidad.
- La covarianza entre $\boldsymbol{x}$ e $\boldsymbol{y}$: el producto escalar de sus vectores en desviaciones $(\boldsymbol{x} - \boldsymbol{\mathop{\overline{x}}})$ e $(\boldsymbol{y} - \boldsymbol{\mathop{\overline{y}}})$.
- La correlación $\rho_{\boldsymbol{x}\boldsymbol{y}}$: el coseno del ángulo entre esos vectores en desviaciones.
El ángulo que introdujimos en la lección 3 vuelve al centro del escenario.
Y vista la correlación tendremos todas las piezas para abordar la regresión lineal simple.