Lección 5. Varianza, covarianza y correlación
Índice
- 1. De dónde venimos: Pitágoras, otra vez
- 2. La varianza: el cuadrado de la norma
- 3. Varianza y Pitágoras
- 4. De un vector a dos: la covarianza
- 5. La correlación: el coseno de un ángulo
- 6. Ilustración geométrica de la correlación
- 7. Un hecho geométrico: en \(\mathbb{R}^2\) la correlación es siempre \(\pm1\)
- 8. Propiedades geométricas: traslación y escala
- 9. Ejemplo numérico completo en \(\mathbb{R}^3\)
- 10. Recapitulación
- 11. Guiño a la sesión siguiente
- 12. Preguntas de repaso (sesión 6) htmlonly
- 13. Respuestas htmlonly
La varianza como el cuadrado de una norma, la covarianza como un producto escalar y la correlación como el coseno de un ángulo. El teorema de Pitágoras de la lección 4, ahora con dos vectores.
``Dos vectores, un ángulo entre sus componentes no constantes: ahí vive toda la correlación.''
1. De dónde venimos: Pitágoras, otra vez
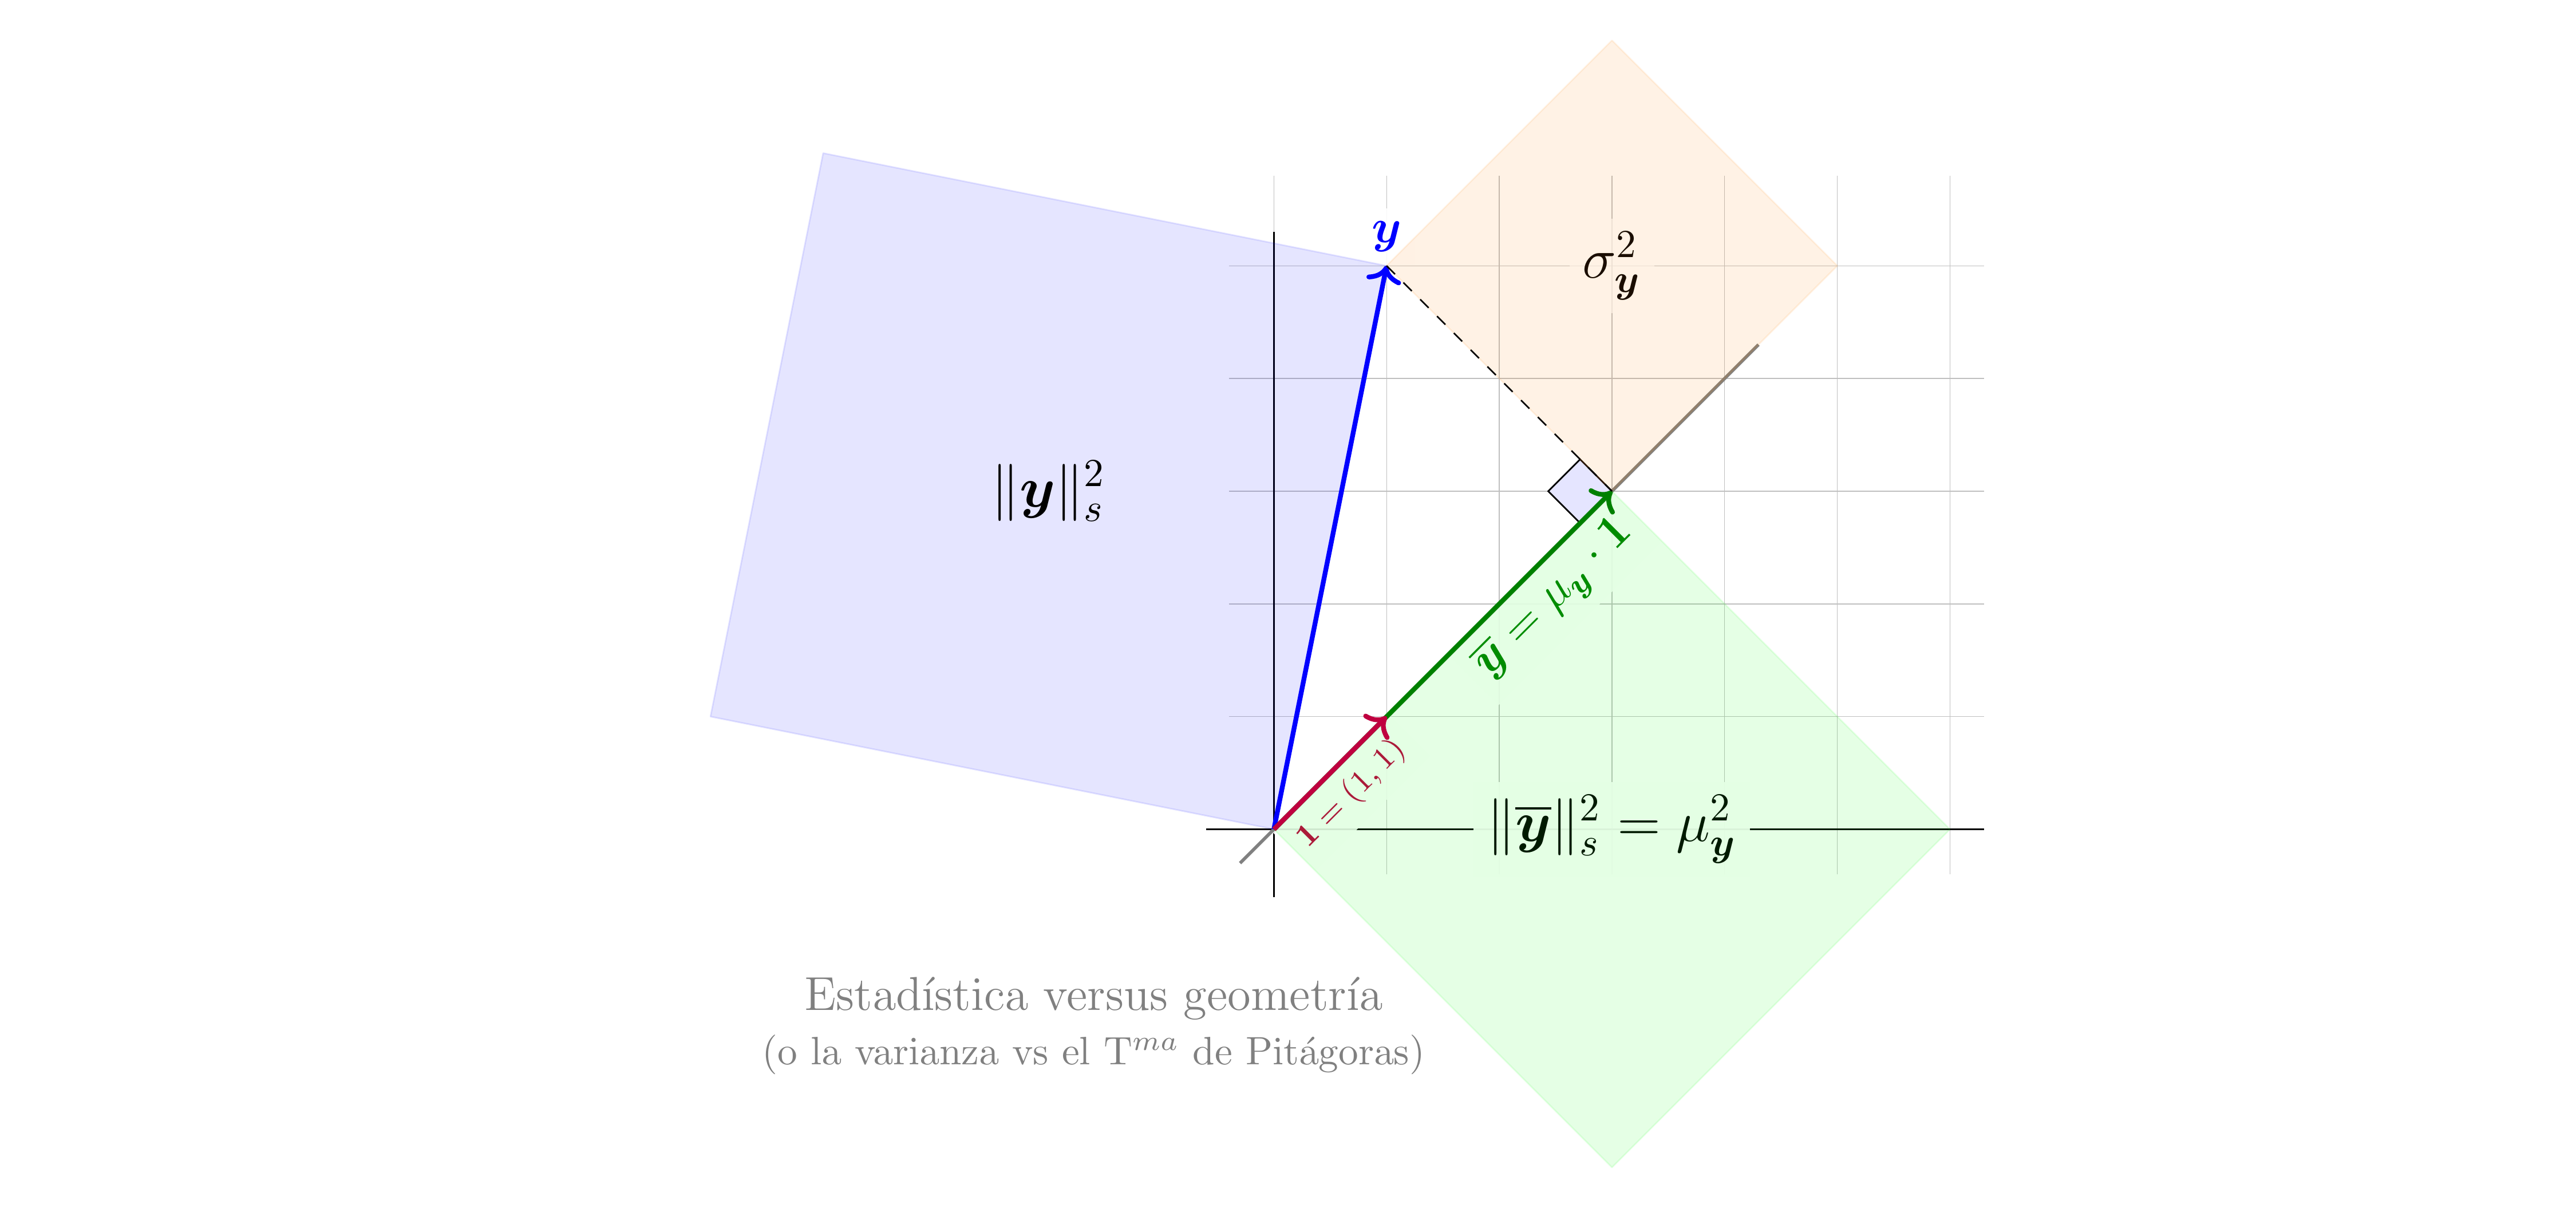
- \(\mu_{\boldsymbol{y}}\): escalar que multiplica a \(\boldsymbol{1}\) para obtener la proyección \(\boldsymbol{\mathop{\overline{y}}}\) sobre \(\mathcal{L}(\boldsymbol{1})\) (recordemos: \(\mu_{\boldsymbol{y}}=\langle\boldsymbol{y},\boldsymbol{1}\rangle_s\), la media ES ese producto escalar).
- \(\sigma_{\boldsymbol{y}}\): norma del vector en desviaciones \(\boldsymbol{y}-\boldsymbol{\mathop{\overline{y}}}\;\) (perpendicular a \(\boldsymbol{1}\)).
En la lección 4 apareció la identidad: \( \|\boldsymbol{y}\|_s^2 = \|\boldsymbol{\mathop{\overline{y}}}\|_s^2 + \|\boldsymbol{y}-\boldsymbol{\mathop{\overline{y}}}\|_s^2 = \|\boldsymbol{\mathop{\overline{y}}}\|_s^2 + \sigma_{\boldsymbol{y}}^2. \)
Tres preguntas:
- ¿Podemos calcular la varianza sin haber calculado \(\boldsymbol{y}-\boldsymbol{\mathop{\overline{y}}}\)?
Y si consideramos dos vectores de datos, \(\boldsymbol{x}\) e \(\boldsymbol{y}\):
- ¿Qué mide el producto escalar de sus vectores en desviaciones? (la covarianza)
- ¿Qué mide el coseno del ángulo entre esos dos vectores en desviaciones? (la correlación)
Mismo escenario que en la lección 4: proyecciones, normas y ángulos en \(\mathcal{L}(\boldsymbol{1})^\perp\).
De dónde venimos: Pitágoras, otra vez
La lección 4 terminó con una identidad que conviene tener muy presente: el vector de datos \(\boldsymbol{y}\) se descompone en dos componentes ortogonales: su proyección sobre \(\mathcal{L}(\boldsymbol{1})\) (el vector de medias \(\boldsymbol{\mathop{\overline{y}}}=\mu_{\boldsymbol{y}}\boldsymbol{1}\)) que es la componente constante, y su vector en desviaciones \(\boldsymbol{y}-\boldsymbol{\mathop{\overline{y}}}\) (perpendicular a \(\boldsymbol{1}\)) que es la componente variable. El teorema de Pitágoras, aplicado a esa descomposición, dio \[ \|\boldsymbol{y}\|_s^2 = \|\boldsymbol{\mathop{\overline{y}}}\|_s^2 + \sigma_{\boldsymbol{y}}^2. \]
Hoy vamos a explorar esa misma geometría un paso más allá y en dos direcciones.
Primero, vamos a mirar con más detalle la propia varianza \(\sigma_{\boldsymbol{y}}^2\) (el cuadrado de la norma de la componente variable), porque de ahí sale una fórmula de cálculo muy conocida en estadística descriptiva.
Segundo —y esto es lo verdaderamente nuevo—, vamos a dejar de trabajar con un único vector y vamos a contemplar dos vectores de datos simultáneamente, \(\boldsymbol{x}\) e \(\boldsymbol{y}\). Cuando tenemos dos vectores, dos preguntas geométricas naturales son: ¿cuánto vale el producto escalar de sus vectores en desviaciones (sus componentes variables)? y ¿qué ángulo forman dichas componentes variables? Las respuestas son, respectivamente, la covarianza y la correlación.
Para profundizar:
- Wooldridge, J. Introductory Econometrics (2020), Apéndice C: repaso de varianza, covarianza y correlación desde la estadística clásica (sin la lectura geométrica que estamos construyendo aquí).
2. La varianza: el cuadrado de la norma
Definición. La varianza de \(\boldsymbol{y}\) es el cuadrado de la norma del vector en desviaciones respecto a la media \(\;\boldsymbol{y}-\boldsymbol{\mathop{\overline{y}}}\):
\[ \|\boldsymbol{y}-\boldsymbol{\mathop{\overline{y}}}\|_s^2 \; = \; \sigma_{\boldsymbol{y}}^2 \; = \; \frac{1}{n}\sum_{i=1}^n (y_i-\mu_{\boldsymbol{y}})^2. \]
No es un concepto verdaderamente nuevo: es, literalmente, elevar al cuadrado la norma \(\sigma_{\boldsymbol{y}}\) que ya conocíamos de la lección 4.
De la identidad de Pitágoras, despejando \(\sigma_{\boldsymbol{y}}^2\) tenemos: \[ \|\boldsymbol{y}\|_s^2 = \|\boldsymbol{\mathop{\overline{y}}}\|_s^2 + \sigma_{\boldsymbol{y}}^2 \;\Longrightarrow\; \sigma_{\boldsymbol{y}}^2 = \|\boldsymbol{y}\|_s^2 - \|\boldsymbol{\mathop{\overline{y}}}\|_s^2. \]
¿Qué son exactamente \(\|\boldsymbol{y}\|_s^2\) y \(\|\boldsymbol{\mathop{\overline{y}}}\|_s^2\) en términos de sumatorios o, mejor aún, en términos de medias aritméticas?
La varianza: el cuadrado de la norma
En la lección 4 llamamos \(\sigma_{\boldsymbol{y}}\) a la norma del vector en desviaciones \(\boldsymbol{y}-\boldsymbol{\mathop{\overline{y}}}\). La varianza no es un objeto distinto: es simplemente el cuadrado de esa norma, \[ \sigma_{\boldsymbol{y}}^2 = \|\boldsymbol{y}-\boldsymbol{\mathop{\overline{y}}}\|_s^2 = \langle\boldsymbol{y}-\boldsymbol{\mathop{\overline{y}}},\,\boldsymbol{y}-\boldsymbol{\mathop{\overline{y}}}\rangle_s = \frac{1}{n}\sum_{i=1}^n(y_i-\mu_{\boldsymbol{y}})^2. \] Esta es la definición habitual de la varianza en estadística descriptiva. Aquí insistimos en que no aparece de la nada: es el cuadrado de una norma, y esa norma es la que mide la distancia de \(\boldsymbol{y}\) al vector constante más próximo, \(\boldsymbol{\mathop{\overline{y}}}\); o, visto de otra manera, es la longitud de la componente variable de \(\boldsymbol{y}\).
La identidad de Pitágoras de la lección 4, \(\|\boldsymbol{y}\|_s^2 = \|\boldsymbol{\mathop{\overline{y}}}\|_s^2 + \sigma_{\boldsymbol{y}}^2\), puede despejarse para obtener \[ \sigma_{\boldsymbol{y}}^2 = \|\boldsymbol{y}\|_s^2 - \|\boldsymbol{\mathop{\overline{y}}}\|_s^2. \] Esta forma alternativa de escribir la varianza —la que en los cursos de estadística descriptiva se suele presentar como ``fórmula de cálculo'' o ``fórmula abreviada''— no es un truco algebraico: es lo que se obtiene del teorema de Pitágoras si se despeja la varianza. Para poder calcularla solo falta saber qué es \(\|\boldsymbol{y}\|_s^2\) en forma de sumatorios o de medias aritméticas; y eso es justamente lo que hace la siguiente transparencia.
3. Varianza y Pitágoras
Los tres lados del triángulo rectángulo, elevados al cuadrado: \[ \underbrace{\|\boldsymbol{y}\|_s^2}_{\text{hipotenusa}^2} \;=\; \underbrace{\|\mu_{\boldsymbol{y}}\boldsymbol{1}\|_s^2}_{\text{cateto}^2} \;+\; \underbrace{\sigma_{\boldsymbol{y}}^2}_{\text{cateto}^2}. \]
Como \(\|\boldsymbol{1}\|_s=1\): \(\quad\|\mu_{\boldsymbol{y}}\boldsymbol{1}\|_s = |\mu_{\boldsymbol{y}}|\cdot\|\boldsymbol{1}\|_s = |\mu_{\boldsymbol{y}}| \;\Longrightarrow\; \|\mu_{\boldsymbol{y}}\boldsymbol{1}\|_s^2=\mu_{\boldsymbol{y}}^2\).
Despejando \(\sigma_{\boldsymbol{y}}^2\) y recordando que \(\|\boldsymbol{y}\|_s^2=\langle\boldsymbol{y},\boldsymbol{y}\rangle_s\): \[ \boxed{\;\sigma_{\boldsymbol{y}}^2 \;=\; \|\boldsymbol{y}\|_s^2 - \mu_{\boldsymbol{y}}^2 \;=\; \frac{1}{n}\sum_{i=1}^n y_i^2 \,-\, \mu_{\boldsymbol{y}}^2 \;=\; \mu_{\boldsymbol{y}^2} \,-\, \mu_{\boldsymbol{y}}^2;\;} \] donde \(\boldsymbol{y}^2\) denota el vector cuyas componentes son el cuadrado de las de \(\boldsymbol{y}\).
La ``fórmula de cálculo'' de la varianza de los cursos de estadística no es truco algebraico: es una implicación del Tma. de Pitágoras.
Varianza y Pitágoras
Si nos fijamos en la figura de la transparencia ``De dónde venimos: Pitágoras, otra vez'' vemos el cuadrado correspondiente a cada lado del triángulo rectángulo. El área del cuadrado de la hipotenusa es \(\|\boldsymbol{y}\|_s^2\); el área del cuadrado del cateto que va por la recta \(\mathcal{L}(\boldsymbol{1})\) es \(\|\mu_{\boldsymbol{y}}\boldsymbol{1}\|_s^2\); y el área del cuadrado del cateto perpendicular es \(\sigma_{\boldsymbol{y}}^2\). El teorema de Pitágoras dice que el área grande es la suma de las dos pequeñas.
Basándonos en esta identidad, vamos a obtener una segunda expresión algebráica para calcular la varianza de un vector. Primero veamos que \(\|\mu_{\boldsymbol{y}}\boldsymbol{1}\|_s^2\) es simplemente \(\mu_{\boldsymbol{y}}^2\). El motivo procede de la homogeneidad de la norma (vista en la lección 2): para cualquier escalar \(\lambda\) y vector \(\boldsymbol{v}\), \(\|\lambda\boldsymbol{v}\|_s=|\lambda|\cdot\|\boldsymbol{v}\|_s\). Aplicándolo con \(\lambda=\mu_{\boldsymbol{y}}\) y \(\boldsymbol{v}=\boldsymbol{1}\): \[ \|\mu_{\boldsymbol{y}}\boldsymbol{1}\|_s = |\mu_{\boldsymbol{y}}|\cdot\|\boldsymbol{1}\|_s. \] Y como fijamos en la lección 4 que \(\|\boldsymbol{1}\|_s=1\) (esa fue precisamente la razón de introducir el factor \(\frac1n\)), tenemos \(\|\mu_{\boldsymbol{y}}\boldsymbol{1}\|_s = |\mu_{\boldsymbol{y}}|\), y al elevar al cuadrado, \(\|\mu_{\boldsymbol{y}}\boldsymbol{1}\|_s^2 = \mu_{\boldsymbol{y}}^2\). Sin este paso —que solo funciona porque \(\|\boldsymbol{1}\|_s=1\)— la fórmula de cálculo no tendría esta forma tan simple.
En segundo lugar tenemos que \(\|\boldsymbol{y}\|_s^2=\langle\boldsymbol{y},\boldsymbol{y}\rangle_s=\frac{1}{n}\sum_{i=1}^n y_i^2\); pero esta última expresión es la media aritmética del cuadrado de las componentes del vector \(\boldsymbol{y}\). Si denotamos con \(\boldsymbol{y}^2\) con dicho vector, obtenemos esta bonita relación \(\|\boldsymbol{y}\|_s^2=\mu_{\boldsymbol{y}^2}=\langle\boldsymbol{y}^2,\boldsymbol{1}\rangle_s\).
Sustituyendo en Pitágoras, \(\mu_{\boldsymbol{y}^2} = \mu_{\boldsymbol{y}}^2 + \sigma_{\boldsymbol{y}}^2\), y despejando: \[ \sigma_{\boldsymbol{y}}^2 = \mu_{\boldsymbol{y}^2} - \mu_{\boldsymbol{y}}^2. \]
Comprobación con el vector de la figura de la transparencia de apertura. El vector dibujado es \(\boldsymbol{y}=(1,5)\). Su media es \(\mu_{\boldsymbol{y}}=\frac{1+5}{2}=3\). Por un lado, directamente: \[ \sigma_{\boldsymbol{y}}^2 = \frac{1}{2}\big[(1-3)^2+(5-3)^2\big] = \frac{1}{2}(4+4) = 4. \] Por otro, con la fórmula de cálculo: \[ \|\boldsymbol{y}\|_s^2 = \frac{1}{2}(1^2+5^2) = \frac{26}{2}=13, \qquad \sigma_{\boldsymbol{y}}^2 = 13 - 3^2 = 13-9 = 4. \] Ambos caminos coinciden, como debían: son la misma cosa vista desde dos ángulos distintos (uno directo, otro pasando por Pitágoras).
Este es un buen momento para insistir en la diferencia de estatus entre las dos fórmulas. La expresión \(\sigma_{\boldsymbol{y}}^2=\frac1n\sum(y_i-\mu_{\boldsymbol{y}})^2\) es la definición: mide directamente la dispersión respecto a la media. La fórmula \(\sigma_{\boldsymbol{y}}^2=\mu_{\boldsymbol{y}^2}-\mu_{\boldsymbol{y}}^2\) es una consecuencia geométrica, útil para el cálculo a mano (solo hace falta \(\sum y_i\) y \(\sum y_i^2\), sin calcular cada diferencia), pero que sin el contexto geométrico oculta su naturaleza. Sin embargo, con la geometría en la mano, la fórmula de cálculo deja de ser un truco de manipulación algebráica: es, sencillamente, el teorema de Pitágoras.
Para profundizar:
- Strang, G. Introduction to Linear Algebra (2016), sección sobre varianza y desviación típica como norma en el capítulo dedicado a estadística.
4. De un vector a dos: la covarianza
Dados \(\boldsymbol{x},\boldsymbol{y}\in\mathbb{R}^n\), consideremos sus vectores en desviaciones (cada uno respecto de su propia media): \(\boldsymbol{x}-\boldsymbol{\mathop{\overline{x}}}\) e \(\boldsymbol{y}-\boldsymbol{\mathop{\overline{y}}}\).
Definición. La covarianza entre \(\boldsymbol{x}\) e \(\boldsymbol{y}\) es el producto escalar de sus vectores en desviaciones:
\[ \sigma_{\boldsymbol{x}\boldsymbol{y}} = \langle \boldsymbol{x}-\boldsymbol{\mathop{\overline{x}}},\, \boldsymbol{y}-\boldsymbol{\mathop{\overline{y}}}\rangle_s = \frac{1}{n}\sum_{i=1}^n (x_i-\mu_{\boldsymbol{x}})(y_i-\mu_{\boldsymbol{y}}). \]
- Si \(\boldsymbol{y}=\boldsymbol{x}\): \(\;\sigma_{\boldsymbol{x}\boldsymbol{x}} = \sigma_{\boldsymbol{x}}^2\) (la varianza es la covarianza de un vector consigo mismo).
- Simetría: \(\sigma_{\boldsymbol{x}\boldsymbol{y}} = \sigma_{\boldsymbol{y}\boldsymbol{x}}\).
- Linealidad en cada argumento.
Todo heredado del producto escalar: no hay nada nuevo que demostrar.
De un vector a dos: la covarianza
Hasta ahora trabajábamos con un único vector de datos \(\boldsymbol{y}\) y su descomposición ortogonal en su vector de medias (su componente constante) y vector en desviaciones (su componente variable). La novedad de hoy es tener dos vectores de datos, \(\boldsymbol{x}\) e \(\boldsymbol{y}\), cada uno con su propia media (\(\mu_{\boldsymbol{x}}\) y \(\mu_{\boldsymbol{y}}\)) y su propio vector en desviaciones (\(\boldsymbol{x}-\boldsymbol{\mathop{\overline{x}}}\) y \(\boldsymbol{y}-\boldsymbol{\mathop{\overline{y}}}\)). Ambos vectores en desviaciones viven en el mismo subespacio, \(\mathcal{L}(\boldsymbol{1})^\perp\) (el conjunto de todos los vectores ortogonales a \(\boldsymbol{1}\), i.e., los vectores de media nula), así que tiene sentido preguntarse cómo se relacionan entre sí dentro de ese subespacio.
Una sencilla pregunta que nos podemos hacer sobre dos vectores es ¿cuánto vale su producto escalar? Esta pregunta, aplicada a los vectores en desviaciones, tiene nombre propio en estadística: la covarianza.
Definición. La covarianza entre \(\boldsymbol{x}\) e \(\boldsymbol{y}\) es \[ \sigma_{\boldsymbol{x}\boldsymbol{y}} = \langle\boldsymbol{x}-\boldsymbol{\mathop{\overline{x}}},\,\boldsymbol{y}-\boldsymbol{\mathop{\overline{y}}}\rangle_s = \frac{1}{n}\sum_{i=1}^n(x_i-\mu_{\boldsymbol{x}})(y_i-\mu_{\boldsymbol{y}}). \]
Un caso particular: si tomamos \(\boldsymbol{y}=\boldsymbol{x}\), la covarianza se convierte en \(\sigma_{\boldsymbol{x}\boldsymbol{x}}=\langle\boldsymbol{x}-\boldsymbol{\mathop{\overline{x}}},\boldsymbol{x}-\boldsymbol{\mathop{\overline{x}}}\rangle_s=\|\boldsymbol{x}-\boldsymbol{\mathop{\overline{x}}}\|_s^2=\sigma_{\boldsymbol{x}}^2\). Es decir, la varianza es la covarianza de un vector consigo mismo. Esto no es una coincidencia: la varianza es, geométricamente, el caso degenerado de la covarianza. Consecuentemente, todo lo que digamos sobre la covarianza se aplicará, como caso particular, a la varianza.
Como la covarianza es (por definición) un producto escalar, hereda de manera automática sus propiedades: es simétrica (\(\sigma_{\boldsymbol{x}\boldsymbol{y}}=\sigma_{\boldsymbol{y}\boldsymbol{x}}\), porque \(\langle\boldsymbol{a},\boldsymbol{b}\rangle_s=\langle\boldsymbol{b},\boldsymbol{a}\rangle_s\)) y lineal en cada uno de sus dos argumentos (con respecto al primer argumento: \(\sigma_{(\alpha\boldsymbol{x}+\beta\boldsymbol{y})\boldsymbol{z}}=\alpha\sigma_{\boldsymbol{x}\boldsymbol{z}}+\beta\sigma_{\boldsymbol{y}\boldsymbol{z}}\); y de manera similar respecto al segundo). No hace falta demostrar nada nuevo: son las mismas propiedades del producto escalar que fijamos en la lección 2, aplicadas ahora a vectores en desviaciones.
Una advertencia importante, que retomaremos en la siguiente transparencia: la covarianza, por sí sola, no tiene una escala interpretable. Su valor numérico depende de las unidades en que midamos \(\boldsymbol{x}\) e \(\boldsymbol{y}\) (si \(\boldsymbol{x}\) está en euros y lo pasamos a céntimos, la covarianza se multiplica por 100, sin que la naturaleza de la posible relación entre ambas variables haya cambiado en absoluto, pues solo hemos cambiado la unidad de medida). Esto es lo mismo que le ocurre al producto escalar ordinario: por sí solo no nos dice nada sobre el ángulo entre dos vectores, salvo que lo dividamos por sus normas; lo que produce un ratio sin unidades de medida (pues las unidades del numerador y del denominador se cancelan). Ese es el papel que va a jugar la correlación.
5. La correlación: el coseno de un ángulo
Definición. La correlación entre dos vectores no constantes \(\boldsymbol{x}\) e \(\boldsymbol{y}\) es el coseno del ángulo \(\theta\) que forman sus vectores en desviaciones:
\[ \rho_{\boldsymbol{x}\boldsymbol{y}} = \cos\theta = \frac{\langle \boldsymbol{x}-\boldsymbol{\mathop{\overline{x}}},\, \boldsymbol{y}-\boldsymbol{\mathop{\overline{y}}}\rangle_s}{\|\boldsymbol{x}-\boldsymbol{\mathop{\overline{x}}}\|_s\,\|\boldsymbol{y}-\boldsymbol{\mathop{\overline{y}}}\|_s} = \frac{\sigma_{\boldsymbol{x}\boldsymbol{y}}}{\sigma_{\boldsymbol{x}}\,\sigma_{\boldsymbol{y}}}. \]
Por Cauchy–Schwarz (lección 3): \(\quad -1\leq\rho_{\boldsymbol{x}\boldsymbol{y}}\leq1\).
- \(\rho_{\boldsymbol{x}\boldsymbol{y}}=\pm1\): vectores en desviaciones alineados (\(\theta=0^o\) o \(180^o\)).
- \(\rho_{\boldsymbol{x}\boldsymbol{y}}=0\): vectores en desviaciones ortogonales (\(\theta=90^o\)).
A diferencia de la covarianza, la correlación no depende de las unidades: es algún número en el intervalo \([-1,1]\).
La correlación: el coseno de un ángulo
En la lección 3 definimos el coseno del ángulo entre dos vectores cualesquiera como \(\cos\theta=\frac{\langle\boldsymbol{a},\,\boldsymbol{b}\rangle}{\|\boldsymbol{a}\|\|\boldsymbol{b}\|}\), y demostramos que la desigualdad de Cauchy–Schwarz garantiza que ese cociente siempre cae en el intervalo de valores \([-1,1]\). No hay nada que impida aplicar la misma definición a los vectores en desviaciones \(\boldsymbol{x}-\boldsymbol{\mathop{\overline{x}}}\) e \(\boldsymbol{y}-\boldsymbol{\mathop{\overline{y}}}\): ambos son vectores de \(\mathbb{R}^n\) como cualquier otro, y todo lo demostrado en la lección 3 (Pitágoras, Cauchy–Schwarz, la desigualdad triangular) sigue siendo válido, porque se apoya únicamente en las propiedades abstractas del producto escalar, no en cuáles sean concretamente los vectores1.
Definición. La correlación entre dos vectores no constantes \(\boldsymbol{x}\) e \(\boldsymbol{y}\) es \[ \rho_{\boldsymbol{x}\boldsymbol{y}} = \frac{\langle\boldsymbol{x}-\boldsymbol{\mathop{\overline{x}}},\,\boldsymbol{y}-\boldsymbol{\mathop{\overline{y}}}\rangle_s}{\|\boldsymbol{x}-\boldsymbol{\mathop{\overline{x}}}\|_s\,\|\boldsymbol{y}-\boldsymbol{\mathop{\overline{y}}}\|_s} = \frac{\sigma_{\boldsymbol{x}\boldsymbol{y}}}{\sigma_{\boldsymbol{x}}\sigma_{\boldsymbol{y}}}. \]
Es, literalmente, el coseno del ángulo \(\theta\) que forman los dos vectores en desviaciones. La desigualdad de Cauchy–Schwarz —demostrada con detalle en la lección 3— nos garantiza que \(-1\leq\rho_{\boldsymbol{x}\boldsymbol{y}}\leq1\) siempre, para cualesquiera \(\boldsymbol{x}\) e \(\boldsymbol{y}\).
Los dos casos extremos son especialmente informativos:
- \(\rho_{\boldsymbol{x}\boldsymbol{y}}=\pm1\) ocurre exactamente cuando los vectores en desviaciones están alineados (uno es múltiplo escalar no nulo del otro): recordemos que en la lección 3 vimos que la igualdad en Cauchy–Schwarz se da si y solo si los vectores son proporcionales.
- \(\rho_{\boldsymbol{x}\boldsymbol{y}}=0\) ocurre exactamente cuando los vectores en desviaciones son ortogonales. Este es el sentido geométrico preciso de ``no estar correlacionados'': no que \(\boldsymbol{x}\) e \(\boldsymbol{y}\) no tengan relación alguna, sino que sus desviaciones respecto a sus medias son perpendiculares.
Nótese la diferencia de estatus con la covarianza. La covarianza cambia de valor si cambiamos las unidades de medida (multiplicar \(\boldsymbol{x}\) por una constante multiplica \(\sigma_{\boldsymbol{x}\boldsymbol{y}}\) por esa misma constante; propiedad de los productos escalares que revisitaremos en unas transparencias). La correlación, al ser un coseno, es adimensional: no depende de las unidades. Esta es la razón por la que la correlación —y no la covarianza— es la medida habitual para comparar la fuerza de la relación lineal entre las componentes no constantes de dos variables.
Para profundizar:
- Wooldridge, J. Introductory Econometrics (2020), Apéndice C.3: covarianza y correlación como medidas de asociación lineal.
6. Ilustración geométrica de la correlación
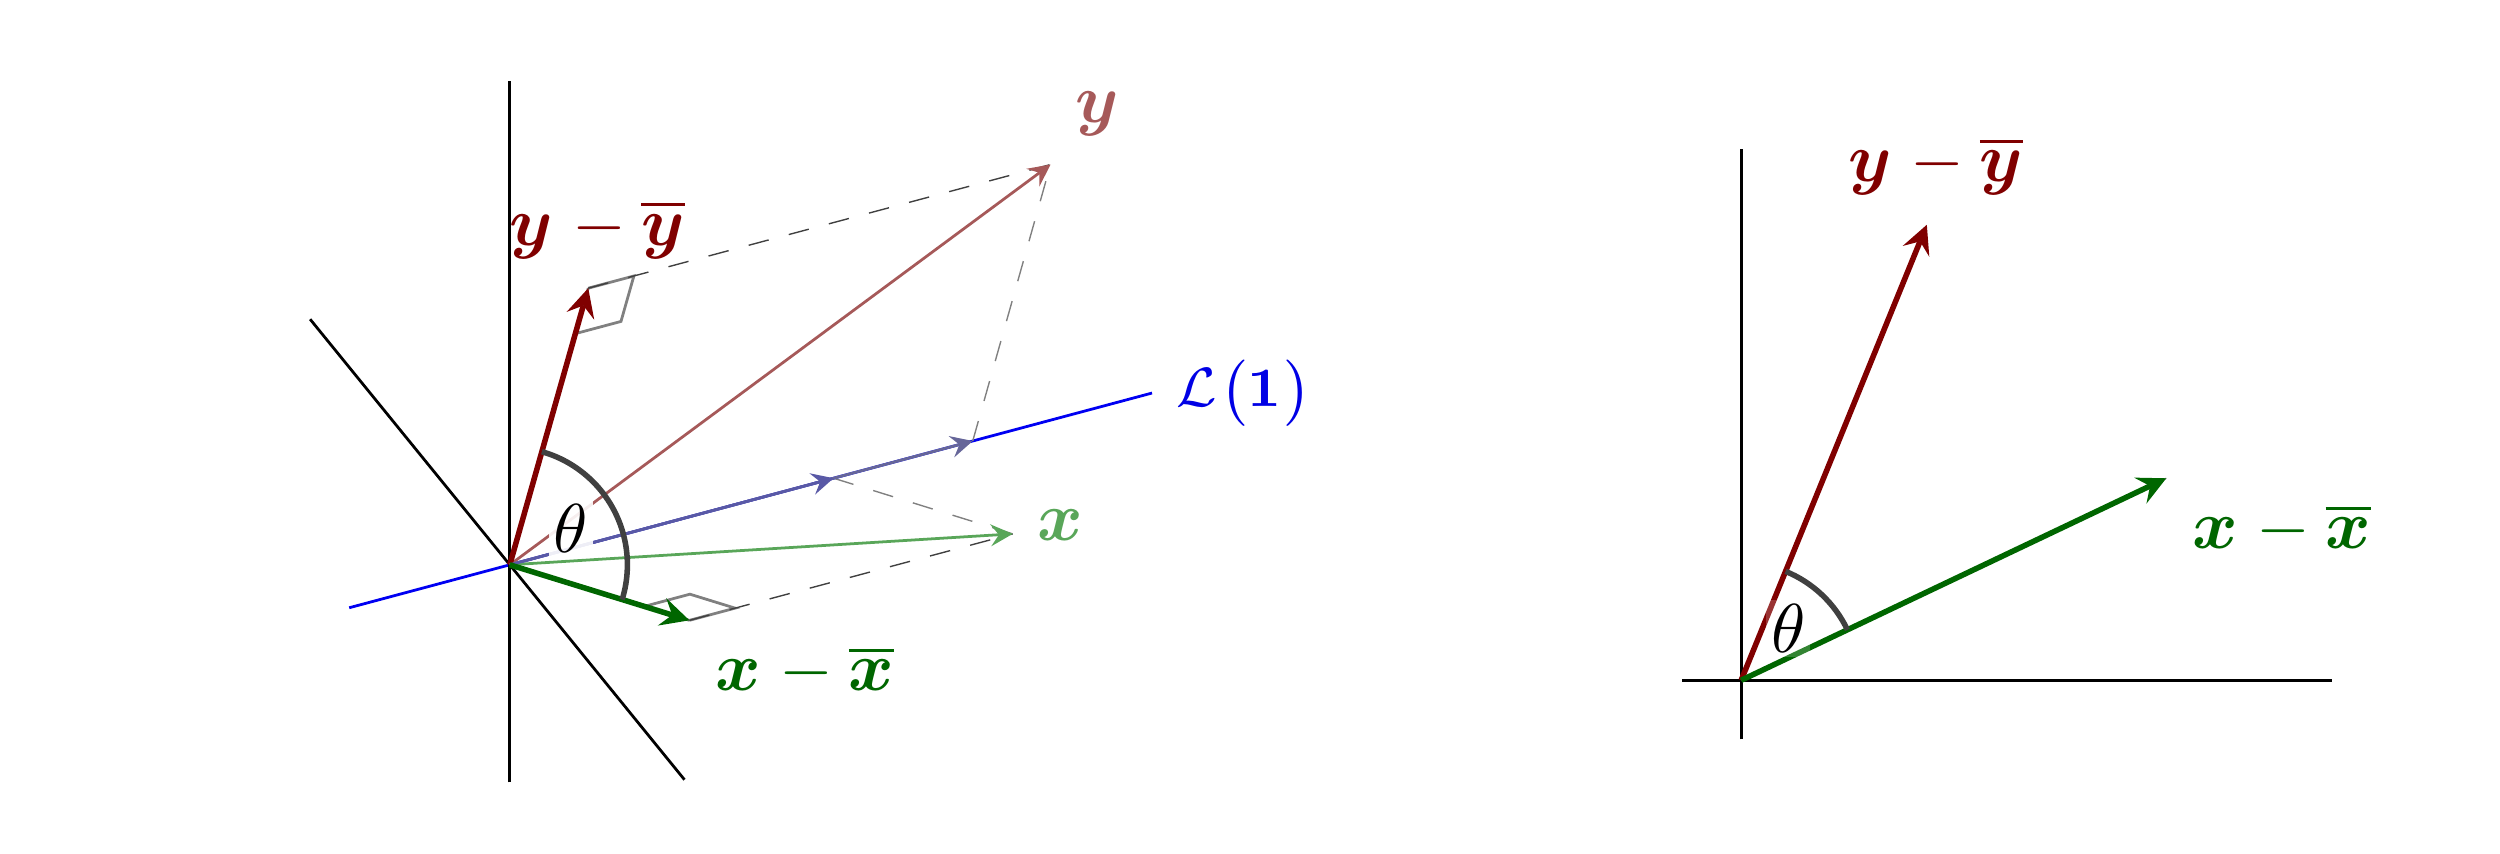
Dos vectores \(\boldsymbol{y}\) (rojo) y \(\boldsymbol{x}\) (verde) en \(\mathbb{R}^3\), con sus vectores en desviaciones \(\boldsymbol{y}-\boldsymbol{\mathop{\overline{y}}}\) y \(\boldsymbol{x}-\boldsymbol{\mathop{\overline{x}}}\) en el plano perpendicular al eje azul \(\mathcal{L}(\boldsymbol{1})\). El coseno del ángulo \(\theta\) entre esos dos vectores en desviaciones es la correlación \(\rho_{\boldsymbol{x}\boldsymbol{y}}\). La figura de la derecha es la misma escena, contemplada desde un punto de vista distinto (perpendicular a ambos vectores en desviaciones para apreciar mejor el ángulo \(\theta\)). (versión interactiva, parte 2)
La correlación indica el ``grado de alineación'' entre las componentes no constantes.
Ilustración geométrica de la correlación
La figura retoma la escena de la lección 4 (dos vectores en \(\mathbb{R}^3\) proyectados sobre \(\mathcal{L}(\boldsymbol{1})\)), pero añade un elemento nuevo: el ángulo \(\theta\) entre los vectores en desviaciones \(\boldsymbol{y}-\boldsymbol{\mathop{\overline{y}}}\) y \(\boldsymbol{x}-\boldsymbol{\mathop{\overline{x}}}\), ambos en el plano \(\mathcal{L}(\boldsymbol{1})^\perp\) (perpendicular al eje azul). El coseno de dicho ángulo es la correlación \(\rho_{\boldsymbol{x}\boldsymbol{y}}\).
La primera imagen muestra la escena desde un punto de vista arbitrario de \(\mathbb{R}^3\); en ella el ángulo \(\theta\) es difícil de apreciar a simple vista, porque los dos vectores en desviaciones no están en el plano de la página (o pantalla del proyector). La segunda imagen es la misma escena, pero vista desde un punto de observación situado sobre la propia dirección ortogonal a ambos vectores en desviaciones: desde ahí, el plano \(\mathcal{L}(\boldsymbol{1})^\perp\) se ve ``de frente'', y el ángulo \(\theta\) se aprecia con su verdadera magnitud.
Una observación: para que dos vectores en desviaciones puedan formar un ángulo distinto de \(0^o\) o \(180^o\), necesitamos que \(\mathcal{L}(\boldsymbol{1})^\perp\) tenga al menos dos dimensiones, es decir, necesitamos una cantidad de datos \(n\geq3\) en cada vector. La siguiente transparencia lo explica.
7. Un hecho geométrico: en \(\mathbb{R}^2\) la correlación es siempre \(\pm1\)
En \(\mathbb{R}^2\), \(\mathcal{L}(\boldsymbol{1})^\perp\) tiene dimensión \(2-1=1\): es una recta.
Todo vector en desviaciones en \(\mathbb{R}^2\) vive en esa misma recta.
Por tanto, dos vectores en desviaciones cualesquiera en \(\mathbb{R}^2\) están siempre alineados: \[ \rho_{\boldsymbol{x}\boldsymbol{y}} = \pm1 \qquad (\text{en } \mathbb{R}^2). \]
Comprobación, con los ejemplos de la lección 4: \(\boldsymbol{x}=(2,4)\) y \(\boldsymbol{z}=(2,-6)\) dan \(\rho_{\boldsymbol{x}\boldsymbol{z}}=-1\).
Para ver ángulos genuinos hace falta \(n\geq3\). Por eso las figuras de hoy viven en \(\mathbb{R}^3\).
Un hecho geométrico: en \(\mathbb{R}^2\) la correlación es siempre \(\pm1\)
Aquí hay una consecuencia geométrica que conviene entender bien, pues explica por qué las figuras de esta lección requieren necesariamente escenas en \(\mathbb{R}^3\).
El subespacio \(\mathcal{L}(\boldsymbol{1})^\perp\) —el conjunto de todos los vectores ortogonales a \(\boldsymbol{1}\), es decir, el conjunto de todos los posibles vectores en desviaciones— tiene dimensión \(n-1\) dentro de \(\mathbb{R}^n\) (porque \(\mathcal{L}(\boldsymbol{1})\), al ser una recta, ya ``ocupa'' una dimensión).2 En el espacio bidimensional \(\mathbb{R}^2\), eso significa que \(\mathcal{L}(\boldsymbol{1})^\perp\) tiene dimensión \(2-1=1\): es una simple recta que pasa por el origen, perpendicular a \(\boldsymbol{1}\).
Ahora bien: en una recta, todos los vectores no nulos son múltiplos escalares unos de otros (dos vectores en una recta están, por definición, alineados). Así que, para cualesquiera dos vectores \(\boldsymbol{x},\boldsymbol{y}\in\mathbb{R}^2\) (ninguno de ellos constante), sus vectores en desviaciones \(\boldsymbol{x}-\boldsymbol{\mathop{\overline{x}}}\) e \(\boldsymbol{y}-\boldsymbol{\mathop{\overline{y}}}\) viven forzosamente en esa misma recta \(\mathcal{L}(\boldsymbol{1})^\perp\), y por tanto están siempre alineados. Recordando la lección 3: vectores alineados dan \(\cos\theta=\pm1\). Es decir:
Con solo dos observaciones (\(n=2\)), la correlación entre dos variables cualesquiera es siempre \(\rho=+1\) o \(\rho=-1\) (salvo que alguna tenga varianza cero, en cuyo caso la correlación ni siquiera está definida).
Verifiquémoslo con dos de los ejemplos numéricos de la lección 4. Tomamos \(\boldsymbol{x}=(2,4)\) (con \(\mu_{\boldsymbol{x}}=3\), en desviaciones \((-1,1)\) y \(\sigma_{\boldsymbol{x}}=1\)) y \(\boldsymbol{z}=(2,-6)\) (con \(\mu_{\boldsymbol{z}}=-2\), en desviaciones \((4,-4)\) y \(\sigma_{\boldsymbol{z}}=4\)). La covarianza es \[ \sigma_{\boldsymbol{x}\boldsymbol{z}} = \frac{1}{2}\big[(-1)(4)+(1)(-4)\big] = \frac{1}{2}(-8) = -4. \] Y la correlación, \[ \rho_{\boldsymbol{x}\boldsymbol{z}} = \frac{-4}{1\cdot4} = -1. \] Efectivamente, \(-1\): los vectores en desviaciones \((-1,1)\) y \((4,-4)\) son múltiplos el uno del otro (de hecho, \((4,-4)=-4\cdot(-1,1)\)), así que están alineados, pero con sentidos opuestos.
Este hecho no es una peculiaridad de estos dos vectores concretos: es forzoso en \(\mathbb{R}^2\), sea cual sea el par de vectores que elijamos. La consecuencia práctica es importante: para ilustrar con un dibujo una correlación distinta de \(\pm1\) (es decir, un ángulo \(\theta\) genuino, ni nulo ni llano) necesitamos, como mínimo, \(\mathbb{R}^3\) (\(n=3\) observaciones), porque solo entonces \(\mathcal{L}(\boldsymbol{1})^\perp\) tiene dimensión \(2\) y puede albergar de verdad dos direcciones distintas. Por eso las figuras de esta lección —y el ejemplo numérico que viene a continuación— se sitúan en \(\mathbb{R}^3\).
Para profundizar:
- Strang, G. Introduction to Linear Algebra (2016), capítulo 4: dimensión de subespacios y su relación con el número de direcciones independientes (tratamiento formal de la noción que aquí usamos de manera informal).
8. Propiedades geométricas: traslación y escala
- Invarianza ante traslaciones
- sumar una constante a \(\boldsymbol{x}\) o a \(\boldsymbol{y}\) no cambia \(\sigma_{\boldsymbol{x}\boldsymbol{y}}\) ni \(\rho_{\boldsymbol{x}\boldsymbol{y}}\).
- Homogeneidad ante escala
- si \(\boldsymbol{x}'=\lambda\boldsymbol{x}\) con \(\lambda\neq0\):
\[ \sigma_{\boldsymbol{x}'\boldsymbol{y}} = \lambda\,\sigma_{\boldsymbol{x}\boldsymbol{y}}, \qquad \rho_{\boldsymbol{x}'\boldsymbol{y}} = \frac{\lambda}{|\lambda|}\,\rho_{\boldsymbol{x}\boldsymbol{y}} = \pm\rho_{\boldsymbol{x}\boldsymbol{y}}. \]
El caso \(\boldsymbol{y}=\boldsymbol{x}\) (la varianza): \[ \sigma_{\boldsymbol{x}+a\boldsymbol{1}}^2 = \sigma_{\boldsymbol{x}}^2, \qquad \sigma_{\lambda\boldsymbol{x}}^2 = \lambda^2\,\sigma_{\boldsymbol{x}}^2. \]
La correlación es invariante a cambios de escala (salvo, quizá, el signo); pero la covarianza no.
Por otra parte, la desviación típica se escala por \(|\lambda|\) (y la varianza, por \(\lambda^2\)).
Propiedades geométricas: traslación y escala
Estas dos propiedades son la versión, para dos vectores, de las que ya vimos en la lección 4 para la desviación típica de un solo vector.
Invarianza ante traslaciones. Si \(\boldsymbol{x}'=\boldsymbol{x}+a\boldsymbol{1}\) (sumamos una constante \(a\) a todas las componentes de \(\boldsymbol{x}\)), entonces \(\mu_{\boldsymbol{x}'}=\mu_{\boldsymbol{x}}+a\), pero el vector en desviaciones (la componente no constante) no cambia: \[ \boldsymbol{x}'-\boldsymbol{\mathop{\overline{x'}}} = (\boldsymbol{x}+a\boldsymbol{1}) - (\mu_{\boldsymbol{x}}+a)\boldsymbol{1} = \boldsymbol{x}-\boldsymbol{\mathop{\overline{x}}}. \] Como la covarianza y la correlación solo dependen de los vectores en desviaciones, ni \(\sigma_{\boldsymbol{x}'\boldsymbol{y}}\) ni \(\rho_{\boldsymbol{x}'\boldsymbol{y}}\) cambian. Geométricamente: sumar \(a\boldsymbol{1}\) desplaza el vector a lo largo de \(\mathcal{L}(\boldsymbol{1})\), sin tocar su componente en \(\mathcal{L}(\boldsymbol{1})^\perp\).
Homogeneidad ante escala. Si \(\boldsymbol{x}'=\lambda\boldsymbol{x}\) con \(\lambda\neq0\), entonces \(\mu_{\boldsymbol{x}'}=\lambda\mu_{\boldsymbol{x}}\); pero ahora, además, el vector en desviaciones también se escala por \(\lambda\): \[ \boldsymbol{x}'-\boldsymbol{\mathop{\overline{x'}}} = \lambda\boldsymbol{x}-\lambda\mu_{\boldsymbol{x}}\boldsymbol{1} = \lambda(\boldsymbol{x}-\boldsymbol{\mathop{\overline{x}}}). \] Por la linealidad del producto escalar, \[ \sigma_{\boldsymbol{x}'\boldsymbol{y}} = \langle\lambda(\boldsymbol{x}-\boldsymbol{\mathop{\overline{x}}}),\,\boldsymbol{y}-\boldsymbol{\mathop{\overline{y}}}\rangle_s = \lambda\,\sigma_{\boldsymbol{x}\boldsymbol{y}}. \] Y como \(\|\lambda(\boldsymbol{x}-\boldsymbol{\mathop{\overline{x}}})\|_s = |\lambda|\,\|\boldsymbol{x}-\boldsymbol{\mathop{\overline{x}}}\|_s\) (homogeneidad de la norma, lección 2), la correlación queda afectada del siguiente modo: \[ \rho_{\boldsymbol{x}'\boldsymbol{y}} = \frac{\lambda\,\sigma_{\boldsymbol{x}\boldsymbol{y}}}{|\lambda|\,\sigma_{\boldsymbol{x}}\sigma_{\boldsymbol{y}}} = \frac{\lambda}{|\lambda|}\,\rho_{\boldsymbol{x}\boldsymbol{y}}. \] Si \(\lambda>0\), \(\frac{\lambda}{|\lambda|}=1\) y la correlación no cambia. Si \(\lambda<0\), \(\frac{\lambda}{|\lambda|}=-1\) y la correlación cambia de signo, pero conserva su magnitud \(|\rho_{\boldsymbol{x}\boldsymbol{y}}|=|\rho_{\boldsymbol{x}'\boldsymbol{y}}|\).
Caso particular: la varianza. Tomando \(\boldsymbol{y}=\boldsymbol{x}\) en las dos propiedades anteriores obtenemos, de forma inmediata, las propiedades correspondientes de la varianza —el caso degenerado \(\sigma_{\boldsymbol{x}\boldsymbol{x}}=\sigma_{\boldsymbol{x}}^2\) que ya vimos en la transparencia de la covarianza—. De la invarianza ante traslaciones: \[ \sigma_{\boldsymbol{x}+a\boldsymbol{1}}^2 = \sigma_{(\boldsymbol{x}+a\boldsymbol{1})(\boldsymbol{x}+a\boldsymbol{1})} = \sigma_{\boldsymbol{x}\boldsymbol{x}} = \sigma_{\boldsymbol{x}}^2. \] Y de la homogeneidad ante escala, aplicada dos veces —una por cada argumento de \(\sigma_{\boldsymbol{x}\boldsymbol{x}}\), ya que ambos son \(\boldsymbol{x}\)—: \[ \sigma_{\lambda\boldsymbol{x}}^2 = \sigma_{(\lambda\boldsymbol{x})(\lambda\boldsymbol{x})} = \lambda\,\sigma_{\boldsymbol{x}(\lambda\boldsymbol{x})} = \lambda\cdot\lambda\,\sigma_{\boldsymbol{x}\boldsymbol{x}} = \lambda^2\,\sigma_{\boldsymbol{x}}^2. \] Otra forma más directa de verlo: esto es también consecuencia inmediata de la homogeneidad de la norma (lección 2): \(\|\lambda(\boldsymbol{x}-\boldsymbol{\mathop{\overline{x}}})\|_s = |\lambda|\,\|\boldsymbol{x}-\boldsymbol{\mathop{\overline{x}}}\|_s\); por lo que al elevar al cuadrado la desviación típica (que es una norma), tenemos que \(|\lambda|^2=\lambda^2\).
Ambas identidades ya estaban, en realidad, implícitas en la lección 4 (sección ``Propiedades geométricas''): allí vimos que sumar una constante no cambia la desviación típica \(\sigma_{\boldsymbol{x}}\), lo cual —al elevar al cuadrado— es exactamente la invarianza de la varianza ante traslaciones. Lo que añadimos aquí es el efecto, cuadrático, de la escala: si \(\boldsymbol{x}\) pasa de medirse en euros a medirse en céntimos (\(\lambda=100\)), la desviación típica se multiplica por \(100\), pero la varianza se multiplica por \(100^2=10\,000\), no por \(100\). Confundir ambos efectos es una fuente frecuente de errores al comparar varianzas expresadas en unidades distintas.
La lectura práctica: la covarianza cambia con las unidades (si \(\boldsymbol{x}\) pasa de metros a centímetros, \(\sigma_{\boldsymbol{x}\boldsymbol{y}}\) se multiplica por 100), pero la correlación —al ser un coseno— es invariante a cambios de escala (salvo, cuando la escala es negativa, un cambio de signo). Esta es la razón geométrica de por qué la correlación, y no la covarianza, es la medida de asociación lineal que se puede comparar entre variables medidas en unidades distintas.
Para profundizar:
- Wooldridge, J. Introductory Econometrics (2020), Apéndice C: efecto de las transformaciones lineales sobre la media, la varianza y la covarianza.
9. Ejemplo numérico completo en \(\mathbb{R}^3\)
| Primer Vector \(\boldsymbol{x}\) | Segundo Vector \(\boldsymbol{y}\) | |
|---|---|---|
| Datos | \(\mbox{$\boldsymbol{x}=(1,2,3)$}\) | \(\mbox{$\boldsymbol{y}=(2,2,5)$}\) |
| Media | \(\mu_{\boldsymbol{x}}=2\) | \(\mu_{\boldsymbol{y}}=3\) |
| Vector en desviaciones | \((-1,0,1)\) | \((-1,-1,2)\) |
| Varianza | \(\sigma_{\boldsymbol{x}}^2=\frac{2}{3}\) | \(\sigma_{\boldsymbol{y}}^2=2\) |
Covarianza : \(\sigma_{\boldsymbol{x}\boldsymbol{y}} = \frac{1}{3}\big[(-1)(-1)+(0)(-1)+(1)(2)\big] = 1\).
\[ \rho_{\boldsymbol{x}\boldsymbol{y}} = \frac{1}{\sqrt{\frac{2}{3}\cdot2}} = \frac{1}{\sqrt{4/3}} = \frac{\sqrt{3}}{2} \approx 0{,}866. \]
Un ángulo \(\theta=30^o\): ni ortogonales, ni alineados. Un caso imposible en \(\mathbb{R}^2\).
Ejemplo numérico completo
Verifiquemos todo lo dicho con un ejemplo completo. Necesitamos \(n\geq3\) para que la correlación pueda tomar un valor distinto de \(\pm1\), así que trabajamos en \(\mathbb{R}^3\): \(\boldsymbol{x}=(1,2,3)\), \(\boldsymbol{y}=(2,2,5)\).
Medias: \[ \mu_{\boldsymbol{x}} = \frac{1+2+3}{3} = 2, \qquad \mu_{\boldsymbol{y}} = \frac{2+2+5}{3} = 3. \]
Vectores en desviaciones: \[ \boldsymbol{x}-\boldsymbol{\mathop{\overline{x}}} = (1-2,\,2-2,\,3-2) = (-1,0,1), \qquad \boldsymbol{y}-\boldsymbol{\mathop{\overline{y}}} = (2-3,\,2-3,\,5-3) = (-1,-1,2). \]
Covarianza: \[ \sigma_{\boldsymbol{x}\boldsymbol{y}} = \frac{1}{3}\big[(-1)(-1)+(0)(-1)+(1)(2)\big] = \frac{1}{3}(1+0+2) = 1. \]
Varianzas: \[ \sigma_{\boldsymbol{x}}^2 = \frac{1}{3}\big[(-1)^2+0^2+1^2\big] = \frac{2}{3}, \qquad \sigma_{\boldsymbol{y}}^2 = \frac{1}{3}\big[(-1)^2+(-1)^2+2^2\big] = \frac{6}{3} = 2. \]
Correlación: \[ \rho_{\boldsymbol{x}\boldsymbol{y}} = \frac{\sigma_{\boldsymbol{x}\boldsymbol{y}}}{\sigma_{\boldsymbol{x}}\sigma_{\boldsymbol{y}}} = \frac{1}{\sqrt{\frac{2}{3}}\cdot\sqrt{2}} = \frac{1}{\sqrt{\frac{4}{3}}} = \frac{\sqrt{3}}{2} \approx 0{,}866. \]
Comprobamos que se cumple Cauchy–Schwarz con desigualdad estricta: \(\sigma_{\boldsymbol{x}\boldsymbol{y}}^2=1 \leq \sigma_{\boldsymbol{x}}^2\sigma_{\boldsymbol{y}}^2=\frac{2}{3}\cdot2=\frac{4}{3}\), y en efecto \(1<\frac{4}{3}\), señal de que los vectores en desviaciones no están alineados (si lo estuvieran, tendríamos igualdad, y \(\rho=\pm1\)).
El valor \(\rho_{\boldsymbol{x}\boldsymbol{y}}=\frac{\sqrt3}{2}\) corresponde a un ángulo \(\theta=30^o\) entre los vectores en desviaciones \((-1,0,1)\) y \((-1,-1,2)\): ni ortogonales (\(\theta\neq90^o\), \(\rho\neq0\)), ni alineados (\(\theta\neq0^o,180^o\), \(\rho\neq\pm1\)). Es exactamente el tipo de situación que, como vimos al estudiar la correlación en \(\mathbb{R}^2\), es imposible de obtener con solo \(n=2\) observaciones (por eso hemos acudido a un ejemplo en \(\mathbb{R}^3\)).
10. Recapitulación
| Objeto/Concepto | Definición geométrica/algebraica | Fórmula en estadística descriptiva |
|---|---|---|
| Varianza \(\sigma_{\boldsymbol{x}}^2\) | \(\Vert\boldsymbol{x}-\boldsymbol{\mathop{\overline{x}}}\Vert_s^2\) | \(\frac{1}{n}\sum(x_i-\mu_{\boldsymbol{x}})^2 = \mu_{\boldsymbol{x}^2}-\mu_{\boldsymbol{x}}^2\) |
| Covarianza \(\sigma_{\boldsymbol{x}\boldsymbol{y}}\) | \(\langle\boldsymbol{x}-\boldsymbol{\mathop{\overline{x}}},\,\boldsymbol{y}-\boldsymbol{\mathop{\overline{y}}}\rangle_s\) | \(\frac{1}{n}\sum(x_i-\mu_{\boldsymbol{x}})(y_i-\mu_{\boldsymbol{y}})\) |
| Correlación \(\rho_{\boldsymbol{x}\boldsymbol{y}}\) | \(\cos\) del ángulo \(\theta\) entre \((\boldsymbol{x}-\boldsymbol{\mathop{\overline{x}}})\) e \((\boldsymbol{y}-\boldsymbol{\mathop{\overline{y}}})\) | \(\dfrac{\sigma_{\boldsymbol{x}\boldsymbol{y}}}{\sigma_{\boldsymbol{x}}\sigma_{\boldsymbol{y}}}\) |
El principio unificador: la covarianza es un producto escalar; la correlación, un coseno. Nada de esto es nuevo: es la geometría de las lecciones 2 y 3, aplicada ahora a los vectores en desviaciones.
Recapitulación
El mensaje central de esta sesión es que, al pasar de un vector a dos, no necesitamos ningún concepto nuevo: la covarianza y la correlación son, respectivamente, el producto escalar y el coseno del ángulo, aplicados a los vectores en desviaciones. Todo lo que sabíamos sobre productos escalares y ángulos (lecciones 2 y 3) se traslada sin cambios.
Tres consecuencias prácticas:
- La varianza es el caso particular \(\sigma_{\boldsymbol{x}\boldsymbol{x}}=\sigma_{\boldsymbol{x}}^2\) de la covarianza.
- La desigualdad de Cauchy–Schwarz, demostrada en la lección 3, es la que garantiza \(-1\leq\rho_{\boldsymbol{x}\boldsymbol{y}}\leq1\): no hace falta ninguna demostración nueva para justificar por qué la correlación nunca se sale de ese intervalo.
- La dimensión de \(\mathcal{L}(\boldsymbol{1})^\perp\) importa: en \(\mathbb{R}^2\) es una recta, y por eso la correlación entre cualquier par de vectores en \(\mathbb{R}^2\) es forzosamente \(\pm1\). Se necesita \(n\geq3\) para observar correlaciones intermedias.
La lección 6 llevará este mismo aparato —proyecciones, ortogonalidad, ángulos— a un problema distinto: buscaremos la combinación lineal de \(\boldsymbol{1}\) y \(\boldsymbol{x}\) que mejor aproxima a \(\boldsymbol{y}\). Ese será el problema de la regresión lineal simple.
11. Guiño a la sesión siguiente
Próxima sesión: laboratorio en Gretl. Estadísticos descriptivos, correlaciones y diagramas de dispersión con datos reales; verificación numérica de las identidades de hoy (Pitágoras, covarianza, correlación) con datos simulados.
Lección 6: la regresión lineal simple. Añadiremos un segundo regresor \(\boldsymbol{x}\) a la proyección sobre \(\mathcal{L}(\boldsymbol{1})\): proyectaremos sobre \(\mathcal{L}(\boldsymbol{1},\boldsymbol{x})\), ya no una recta sino un plano. El ángulo \(\theta\) de hoy reaparecerá en la lección 8 como \(R^2=\cos^2\theta\).
Guiño a la sesión siguiente
Hoy hemos visto que para relacionar dos vectores no se exige ningún concepto matemáticamente nuevo: la covarianza es un producto escalar (entre vectores en desviaciones) y la correlación es un coseno (entre esos mismos vectores en desviaciones). La próxima sesión es un laboratorio: en él calcularemos, con datos reales, medias, varianzas, covarianzas y correlaciones, y dibujaremos diagramas de dispersión; y comprobaremos, con datos simulados, que las identidades de hoy (en particular, la fórmula de cálculo de la varianza y la relación \(\rho=\cos\theta\)) se cumplen exactamente.
La lección 6 dará el siguiente gran paso del curso: la regresión lineal simple. Hasta ahora hemos proyectado un único vector \(\boldsymbol{y}\) sobre la recta \(\mathcal{L}(\boldsymbol{1})\) (lección 4); ahora añadiremos un segundo regresor \(\boldsymbol{x}\) y proyectaremos sobre el plano \(\mathcal{L}(\boldsymbol{1},\boldsymbol{x})\) (el conjunto de todas las combinaciones lineales de \(\boldsymbol{1}\) y \(\boldsymbol{x}\)). La lógica —imponer condiciones de ortogonalidad— será la misma que ya conocemos; solo cambia el subespacio sobre el que proyectamos. Y al final de ese camino, cuando preguntemos ``¿cómo de bueno es el ajuste?'', la respuesta será, el coseno al cuadrado de un ángulo: \(R^2=\cos^2\theta\), donde \(\theta\) es el ángulo entre el vector en desviaciones y su ajuste en desviaciones.3 El ángulo de hoy no desaparece: reaparece con otro nombre.
Por último, una pincelada de lo que vendrá más lejos: cuando haya varios regresores, resultará cómodo agruparlos como columnas de una matriz. Esa notación llegará en la lección 10, cuando de verdad la necesitemos; y allí veremos que la doble lectura de la media de hoy —producto escalar \(\langle\boldsymbol{y},\boldsymbol{1}\rangle_s\) y, a la vez, coeficiente de la proyección \(\mu_{\boldsymbol{y}}\boldsymbol{1}\)— reaparece con varios regresores.
12. Preguntas de repaso (sesión 6) htmlonly
Te propongo 12 preguntas. Las marco con un nivel orientativo: [B] básica, [M] media, [D] discriminadora.
Comentario
Las preguntas más valiosas pedagógicamente son la 6 (fija que la ``fórmula de cálculo'' de la varianza no es un atajo aislado, sino Pitágoras despejado, con el paso \(\Vert\mu_{\boldsymbol{x}}\boldsymbol{1}\Vert_s^2=\mu_{\boldsymbol{x}}^2\) como pieza clave), la 11 (obliga a conectar dimensión de subespacio con alineación de vectores, un resultado que sorprende y que conviene comentar en clase) y la 12 (fija el guiño hacia la regresión, mostrando que el ángulo de hoy no es un ejercicio aislado sino el mismo objeto que reaparecerá como \(R^2\)). La pregunta 10 es la más discriminadora entre las de cálculo: distingue a quien ha entendido de verdad la diferencia entre el comportamiento de la covarianza y el de la correlación ante un cambio de escala negativo.
Pregunta 1 [B] — Definición de varianza
La varianza \(\sigma_{\boldsymbol{x}}^2\) se define geométricamente como:
- La norma del vector \(\boldsymbol{x}\).
- El cuadrado de la norma del vector en desviaciones \(\boldsymbol{x}-\boldsymbol{\mathop{\overline{x}}}\).
- El producto escalar de \(\boldsymbol{x}\) con \(\boldsymbol{1}\).
- El ángulo entre \(\boldsymbol{x}\) y \(\boldsymbol{1}\).
Pregunta 2 [B] — Definición de covarianza
La covarianza \(\sigma_{\boldsymbol{x}\boldsymbol{y}}\) se define como:
- La suma de las varianzas de \(\boldsymbol{x}\) e \(\boldsymbol{y}\).
- El producto escalar de \(\boldsymbol{x}\) e \(\boldsymbol{y}\) (sin centrar).
- El producto escalar de los vectores en desviaciones \(\boldsymbol{x}-\boldsymbol{\mathop{\overline{x}}}\) e \(\boldsymbol{y}-\boldsymbol{\mathop{\overline{y}}}\).
- El coseno del ángulo entre \(\boldsymbol{x}\) e \(\boldsymbol{y}\).
Pregunta 3 [B] — Definición de correlación
La correlación \(\rho_{\boldsymbol{x}\boldsymbol{y}}\) es:
- La covarianza dividida por \(n\).
- El coseno del ángulo entre los vectores en desviaciones de \(\boldsymbol{x}\) e \(\boldsymbol{y}\).
- El producto de las desviaciones típicas de \(\boldsymbol{x}\) e \(\boldsymbol{y}\).
- La distancia entre \(\boldsymbol{x}\) e \(\boldsymbol{y}\).
Pregunta 4 [B] — Rango de la correlación
¿Por qué la correlación \(\rho_{\boldsymbol{x}\boldsymbol{y}}\) siempre cumple \(-1\leq\rho_{\boldsymbol{x}\boldsymbol{y}}\leq1\)?
- Porque la varianza nunca es negativa.
- Por la desigualdad de Cauchy–Schwarz, demostrada en la lección 3.
- Porque \(n\) siempre es positivo.
- Porque la covarianza está acotada por \(1\).
Pregunta 5 [M] — Cálculo de varianza (comprobación directa vs. fórmula)
Para \(\boldsymbol{x}=(1,5)\), ¿cuánto vale \(\sigma_{\boldsymbol{x}}^2\)?
- \(1\).
- \(2\).
- \(4\).
- \(9\).
Pregunta 6 [M] — La fórmula de cálculo de la varianza
La igualdad \(\sigma_{\boldsymbol{x}}^2=\frac{1}{n}\sum x_i^2-\mu_{\boldsymbol{x}}^2\) es válida:
- Solo quiere decir lo mismo que la definición, pero es más difícil de calcular.
- Es el teorema de Pitágoras despejado, usando que \(\Vert\mu_{\boldsymbol{x}}\boldsymbol{1}\Vert_s^2=\mu_{\boldsymbol{x}}^2\) porque \(\Vert\boldsymbol{1}\Vert_s=1\).
- Solo es válida cuando \(\mu_{\boldsymbol{x}}=0\).
- Es una aproximación, no una igualdad exacta.
Pregunta 7 [M] — Covarianza de un vector consigo mismo
¿Cuánto vale \(\sigma_{\boldsymbol{x}\boldsymbol{x}}\)?
- Siempre \(0\).
- Siempre \(1\).
- \(\sigma_{\boldsymbol{x}}^2\), la varianza de \(\boldsymbol{x}\).
- \(\mu_{\boldsymbol{x}}^2\).
Pregunta 8 [M] — Cálculo de correlación
Para \(\boldsymbol{x}=(1,2,3)\) e \(\boldsymbol{y}=(2,2,5)\), ¿cuánto vale \(\rho_{\boldsymbol{x}\boldsymbol{y}}\)?
- \(1\).
- \(0\).
- \(\frac{\sqrt3}{2}\).
- \(-\frac{\sqrt3}{2}\).
Pregunta 9 [M] — Invarianza ante traslaciones
Si \(\boldsymbol{y}'=\boldsymbol{y}+5\boldsymbol{1}\), ¿qué ocurre con \(\sigma_{\boldsymbol{x}\boldsymbol{y}'}\) respecto a \(\sigma_{\boldsymbol{x}\boldsymbol{y}}\)?
- Se multiplica por \(5\).
- Aumenta en \(5\).
- No cambia.
- Cambia de signo.
Pregunta 10 [D] — Homogeneidad ante escala negativa
Si \(\boldsymbol{x}'=-3\boldsymbol{x}\), ¿cómo se relaciona \(\rho_{\boldsymbol{x}'\boldsymbol{y}}\) con \(\rho_{\boldsymbol{x}\boldsymbol{y}}\)?
- \(\rho_{\boldsymbol{x}'\boldsymbol{y}} = -3\,\rho_{\boldsymbol{x}\boldsymbol{y}}\).
- \(\rho_{\boldsymbol{x}'\boldsymbol{y}} = 3\,\rho_{\boldsymbol{x}\boldsymbol{y}}\).
- \(\rho_{\boldsymbol{x}'\boldsymbol{y}} = -\rho_{\boldsymbol{x}\boldsymbol{y}}\).
- \(\rho_{\boldsymbol{x}'\boldsymbol{y}} = \rho_{\boldsymbol{x}\boldsymbol{y}}\).
Pregunta 11 [D] — Correlación en \(\mathbb{R}^2\)
¿Por qué la correlación entre dos vectores cualesquiera de \(\mathbb{R}^2\) (ninguno constante) es siempre \(+1\) o \(-1\)?
- Porque en \(\mathbb{R}^2\) la desigualdad de Cauchy–Schwarz no es válida.
- Porque \(\mathcal{L}(\boldsymbol{1})^\perp\) tiene dimensión \(1\) en \(\mathbb{R}^2\), así que todo vector en desviaciones vive en la misma recta.
- Porque en \(\mathbb{R}^2\) la media siempre coincide con la varianza.
- Porque en \(\mathbb{R}^2\) no existen vectores ortogonales a \(\boldsymbol{1}\).
Pregunta 12 [D] — Guiño a la regresión
En la lección 8 se definirá \(R^2=\cos^2\theta\) para la regresión lineal simple. Según la lógica de esta sesión, ¿entre qué par de vectores se medirá ese ángulo \(\theta\)?
- Entre \(\boldsymbol{1}\) y \(\boldsymbol{x}\).
- Entre \(\boldsymbol{y}-\boldsymbol{\mathop{\overline{y}}}\) y el vector ajustado centrado \(\boldsymbol{\mathop{\widehat{y}}}-\boldsymbol{\mathop{\overline{y}}}\).
- Entre \(\boldsymbol{y}\) y \(\boldsymbol{1}\).
- Entre el vector de residuos y \(\boldsymbol{x}\).
13. Respuestas htmlonly
- Pregunta 1 [B] — Definición de varianza
Respuesta correcta: 2. Evalúa: definición geométrica básica de varianza como norma al cuadrado.
- Pregunta 2 [B] — Definición de covarianza
Respuesta correcta: 3. Evalúa: distinguir la covarianza (producto escalar de vectores centrados) de un producto escalar sin centrar.
- Pregunta 3 [B] — Definición de correlación
Respuesta correcta: 2. Evalúa: definición geométrica de correlación.
- Pregunta 4 [B] — Rango de la correlación
Respuesta correcta: 2. Evalúa: conexión explícita con la demostración de Cauchy–Schwarz de la lección 3 (no una propiedad ``porque sí'').
- Pregunta 5 [M] — Cálculo de varianza (comprobación directa vs. fórmula)
Respuesta correcta: 3. Evalúa: cálculo directo. \(\mu_{\boldsymbol{x}}=3\); desviaciones \((-2,2)\); \(\sigma_{\boldsymbol{x}}^2=\frac12(4+4)=4\).
- Pregunta 6 [M] — La fórmula de cálculo de la varianza
Respuesta correcta: 2. Evalúa: comprensión de que la ``fórmula de cálculo'' es consecuencia directa de Pitágoras, no un atajo independiente.
- Pregunta 7 [M] — Covarianza de un vector consigo mismo
Respuesta correcta: 3. Evalúa: reconocer la varianza como caso particular (degenerado) de la covarianza.
- Pregunta 8 [M] — Cálculo de correlación
Respuesta correcta: 3. Evalúa: cálculo directo siguiendo el ejemplo desarrollado en la sesión (\(\sigma_{\boldsymbol{x}\boldsymbol{y}}=1\), \(\sigma_{\boldsymbol{x}}^2=2/3\), \(\sigma_{\boldsymbol{y}}^2=2\)).
- Pregunta 9 [M] — Invarianza ante traslaciones
Respuesta correcta: 3. Evalúa: comprensión de que sumar una constante no altera el vector en desviaciones, y por tanto no altera la covarianza.
- Pregunta 10 [D] — Homogeneidad ante escala negativa
Respuesta correcta: 3. Evalúa: distinguir el efecto de un escalar negativo en la correlación (cambia el signo, pero no la magnitud) del efecto en la covarianza (que sí se multiplica por \(-3\)). Discrimina porque tienta a confundir el factor de escala con el nuevo valor de \(\rho\).
- Pregunta 11 [D] — Correlación en \(\mathbb{R}^2\)
Respuesta correcta: 2. Evalúa: comprensión del argumento de dimensión: el complemento ortogonal de \(\mathcal{L}(\boldsymbol{1})\) en \(\mathbb{R}^2\) es una recta, y dos vectores en una recta están siempre alineados. Discrimina porque exige conectar dimensión de subespacio con la noción de vectores alineados de la lección 3.
- Pregunta 12 [D] — Guiño a la regresión
Respuesta correcta: 2. Evalúa: comprensión del guiño final: el mismo esquema de ``ángulo entre vectores centrados'' que hoy usamos para \(\rho_{\boldsymbol{x}\boldsymbol{y}}\) reaparecerá para medir la bondad del ajuste de la regresión. Discrimina porque exige haber seguido el hilo conductor hasta el final de la sesión.
Notas al pie de página:
Fíjese que la definición de la correlación emplea específicamente el producto escalar de la estadística
Nota sobre la palabra ``dimensión''. En este curso no hemos definido axiomáticamente qué es la dimensión de un subespacio (evitamos deliberadamente la maquinaria abstracta del álgebra lineal). La usamos aquí en su sentido más intuitivo: el número de ``direcciones independientes'' que caben dentro de un subespacio, la misma idea que ya manejábamos visualmente al hablar de rectas (una dirección) y planos (dos direcciones). Esta noción informal es todo lo que necesitamos para lo que sigue.
recuerde que vector en desviaciones respecto a la media y vector centrado son sinónimos.