Lección 5. Varianza, covarianza y correlación
Author: Marcos Bujosa
La varianza como el cuadrado de una norma, la covarianza como un producto escalar y la correlación como el coseno de un ángulo. El teorema de Pitágoras de la lección 4, ahora con dos vectores.
``Dos vectores, un ángulo entre sus componentes no constantes: ahí vive toda la correlación.''
De dónde venimos: Pitágoras, otra vez
- $\mu_{\boldsymbol{y}}$: escalar que multiplica a $\boldsymbol{1}$ para obtener la proyección $\boldsymbol{\mathop{\overline{y}}}$ sobre $\mathcal{L}(\boldsymbol{1})$ (recordemos: $\mu_{\boldsymbol{y}}=\langle\boldsymbol{y},\boldsymbol{1}\rangle_s$, la media ES ese producto escalar).
- $\sigma_{\boldsymbol{y}}$: norma del vector en desviaciones $\boldsymbol{y}-\boldsymbol{\mathop{\overline{y}}}\;$ (perpendicular a $\boldsymbol{1}$).
En la lección 4 apareció la identidad: $ \|\boldsymbol{y}\|_s^2 = \|\boldsymbol{\mathop{\overline{y}}}\|_s^2 + \|\boldsymbol{y}-\boldsymbol{\mathop{\overline{y}}}\|_s^2 = \|\boldsymbol{\mathop{\overline{y}}}\|_s^2 + \sigma_{\boldsymbol{y}}^2. $
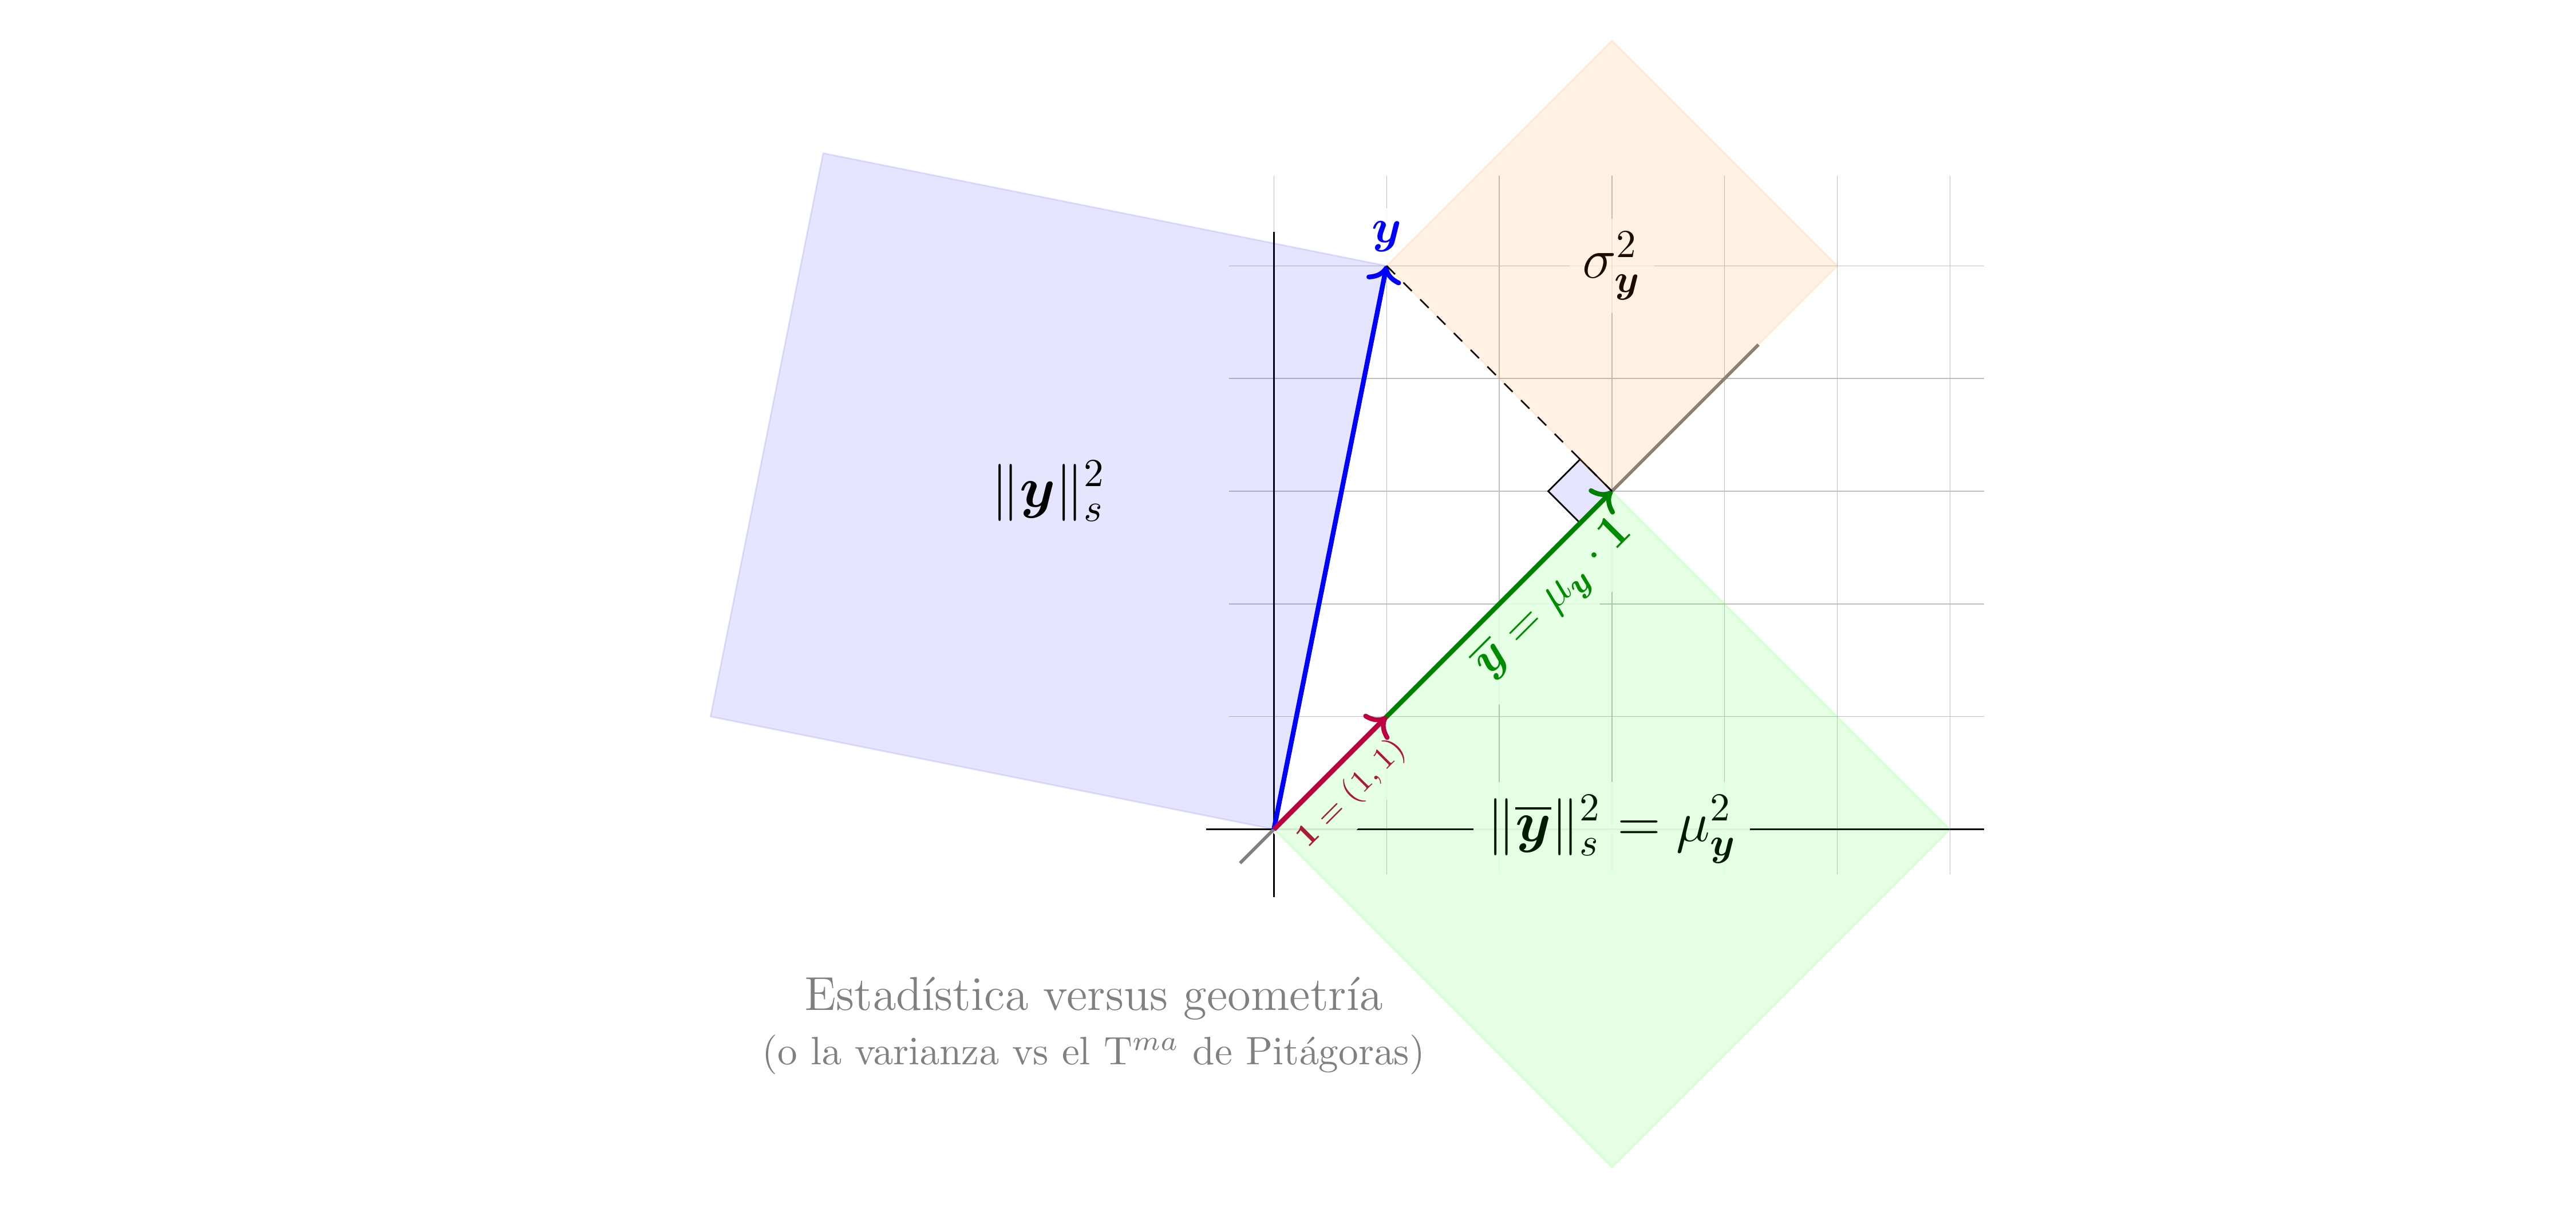
Tres preguntas:
- ¿Podemos calcular la varianza sin haber calculado $\boldsymbol{y}-\boldsymbol{\mathop{\overline{y}}}$?
Y si consideramos dos vectores de datos, $\boldsymbol{x}$ e $\boldsymbol{y}$:
- ¿Qué mide el producto escalar de sus vectores en desviaciones? (la covarianza)
- ¿Qué mide el coseno del ángulo entre esos dos vectores en desviaciones? (la correlación)
Mismo escenario que en la lección 4: proyecciones, normas y ángulos en $\mathcal{L}(\boldsymbol{1})^\perp$.
La varianza: el cuadrado de la norma
Definición. La varianza de $\boldsymbol{y}$ es el cuadrado de la norma del vector en desviaciones respecto a la media $\;\boldsymbol{y}-\boldsymbol{\mathop{\overline{y}}}$:$$ \|\boldsymbol{y}-\boldsymbol{\mathop{\overline{y}}}\|_s^2 \; = \; \sigma_{\boldsymbol{y}}^2 \; = \; \frac{1}{n}\sum_{i=1}^n (y_i-\mu_{\boldsymbol{y}})^2. $$
No es un concepto verdaderamente nuevo: es, literalmente, elevar al cuadrado la norma $\sigma_{\boldsymbol{y}}$ que ya conocíamos de la lección 4.
De la identidad de Pitágoras, despejando $\sigma_{\boldsymbol{y}}^2$ tenemos: $$ \|\boldsymbol{y}\|_s^2 = \|\boldsymbol{\mathop{\overline{y}}}\|_s^2 + \sigma_{\boldsymbol{y}}^2 \;\Longrightarrow\; \sigma_{\boldsymbol{y}}^2 = \|\boldsymbol{y}\|_s^2 - \|\boldsymbol{\mathop{\overline{y}}}\|_s^2. $$
¿Qué son exactamente $\|\boldsymbol{y}\|_s^2$ y $\|\boldsymbol{\mathop{\overline{y}}}\|_s^2$ en términos de sumatorios o, mejor aún, en términos de medias aritméticas?
Varianza y Pitágoras
Los tres lados del triángulo rectángulo, elevados al cuadrado: $$ \underbrace{\|\boldsymbol{y}\|_s^2}_{\text{hipotenusa}^2} \;=\; \underbrace{\|\mu_{\boldsymbol{y}}\boldsymbol{1}\|_s^2}_{\text{cateto}^2} \;+\; \underbrace{\sigma_{\boldsymbol{y}}^2}_{\text{cateto}^2}. $$
Como $\|\boldsymbol{1}\|_s=1$: $\quad\|\mu_{\boldsymbol{y}}\boldsymbol{1}\|_s = |\mu_{\boldsymbol{y}}|\cdot\|\boldsymbol{1}\|_s = |\mu_{\boldsymbol{y}}| \;\Longrightarrow\; \|\mu_{\boldsymbol{y}}\boldsymbol{1}\|_s^2=\mu_{\boldsymbol{y}}^2$.
Despejando $\sigma_{\boldsymbol{y}}^2$ y recordando que $\|\boldsymbol{y}\|_s^2=\langle\boldsymbol{y},\boldsymbol{y}\rangle_s$: $$ \boxed{\;\sigma_{\boldsymbol{y}}^2 \;=\; \|\boldsymbol{y}\|_s^2 - \mu_{\boldsymbol{y}}^2 \;=\; \frac{1}{n}\sum_{i=1}^n y_i^2 \,-\, \mu_{\boldsymbol{y}}^2 \;=\; \mu_{\boldsymbol{y}^2} \,-\, \mu_{\boldsymbol{y}}^2;\;} $$ donde $\boldsymbol{y}^2$ denota el vector cuyas componentes son el cuadrado de las de $\boldsymbol{y}$.
La ``fórmula de cálculo'' de la varianza de los cursos de estadística no es truco algebraico: es una implicación del Tma. de Pitágoras.
De un vector a dos: la covarianza
Dados $\boldsymbol{x},\boldsymbol{y}\in\mathbb{R}^n$, consideremos sus vectores en desviaciones (cada uno respecto de su propia media): $\boldsymbol{x}-\boldsymbol{\mathop{\overline{x}}}$ e $\boldsymbol{y}-\boldsymbol{\mathop{\overline{y}}}$.
Definición. La covarianza entre $\boldsymbol{x}$ e $\boldsymbol{y}$ es el producto escalar de sus vectores en desviaciones:$$ \sigma_{\boldsymbol{x}\boldsymbol{y}} = \langle \boldsymbol{x}-\boldsymbol{\mathop{\overline{x}}},\, \boldsymbol{y}-\boldsymbol{\mathop{\overline{y}}}\rangle_s = \frac{1}{n}\sum_{i=1}^n (x_i-\mu_{\boldsymbol{x}})(y_i-\mu_{\boldsymbol{y}}). $$
- Si $\boldsymbol{y}=\boldsymbol{x}$: $\;\sigma_{\boldsymbol{x}\boldsymbol{x}} = \sigma_{\boldsymbol{x}}^2$ (la varianza es la covarianza de un vector consigo mismo).
- Simetría: $\sigma_{\boldsymbol{x}\boldsymbol{y}} = \sigma_{\boldsymbol{y}\boldsymbol{x}}$.
- Linealidad en cada argumento.
Todo heredado del producto escalar: no hay nada nuevo que demostrar.
La correlación: el coseno de un ángulo
Definición. La correlación entre dos vectores no constantes $\boldsymbol{x}$ e $\boldsymbol{y}$ es el coseno del ángulo $\theta$ que forman sus vectores en desviaciones:$$ \rho_{\boldsymbol{x}\boldsymbol{y}} = \cos\theta = \frac{\langle \boldsymbol{x}-\boldsymbol{\mathop{\overline{x}}},\, \boldsymbol{y}-\boldsymbol{\mathop{\overline{y}}}\rangle_s}{\|\boldsymbol{x}-\boldsymbol{\mathop{\overline{x}}}\|_s\,\|\boldsymbol{y}-\boldsymbol{\mathop{\overline{y}}}\|_s} = \frac{\sigma_{\boldsymbol{x}\boldsymbol{y}}}{\sigma_{\boldsymbol{x}}\,\sigma_{\boldsymbol{y}}}. $$
Por Cauchy–Schwarz (lección 3): $\quad -1\leq\rho_{\boldsymbol{x}\boldsymbol{y}}\leq1$.
- $\rho_{\boldsymbol{x}\boldsymbol{y}}=\pm1$: vectores en desviaciones alineados ($\theta=0^o$ o $180^o$).
- $\rho_{\boldsymbol{x}\boldsymbol{y}}=0$: vectores en desviaciones ortogonales ($\theta=90^o$).
A diferencia de la covarianza, la correlación no depende de las unidades: es algún número en el intervalo $[-1,1]$.
Ilustración geométrica de la correlación
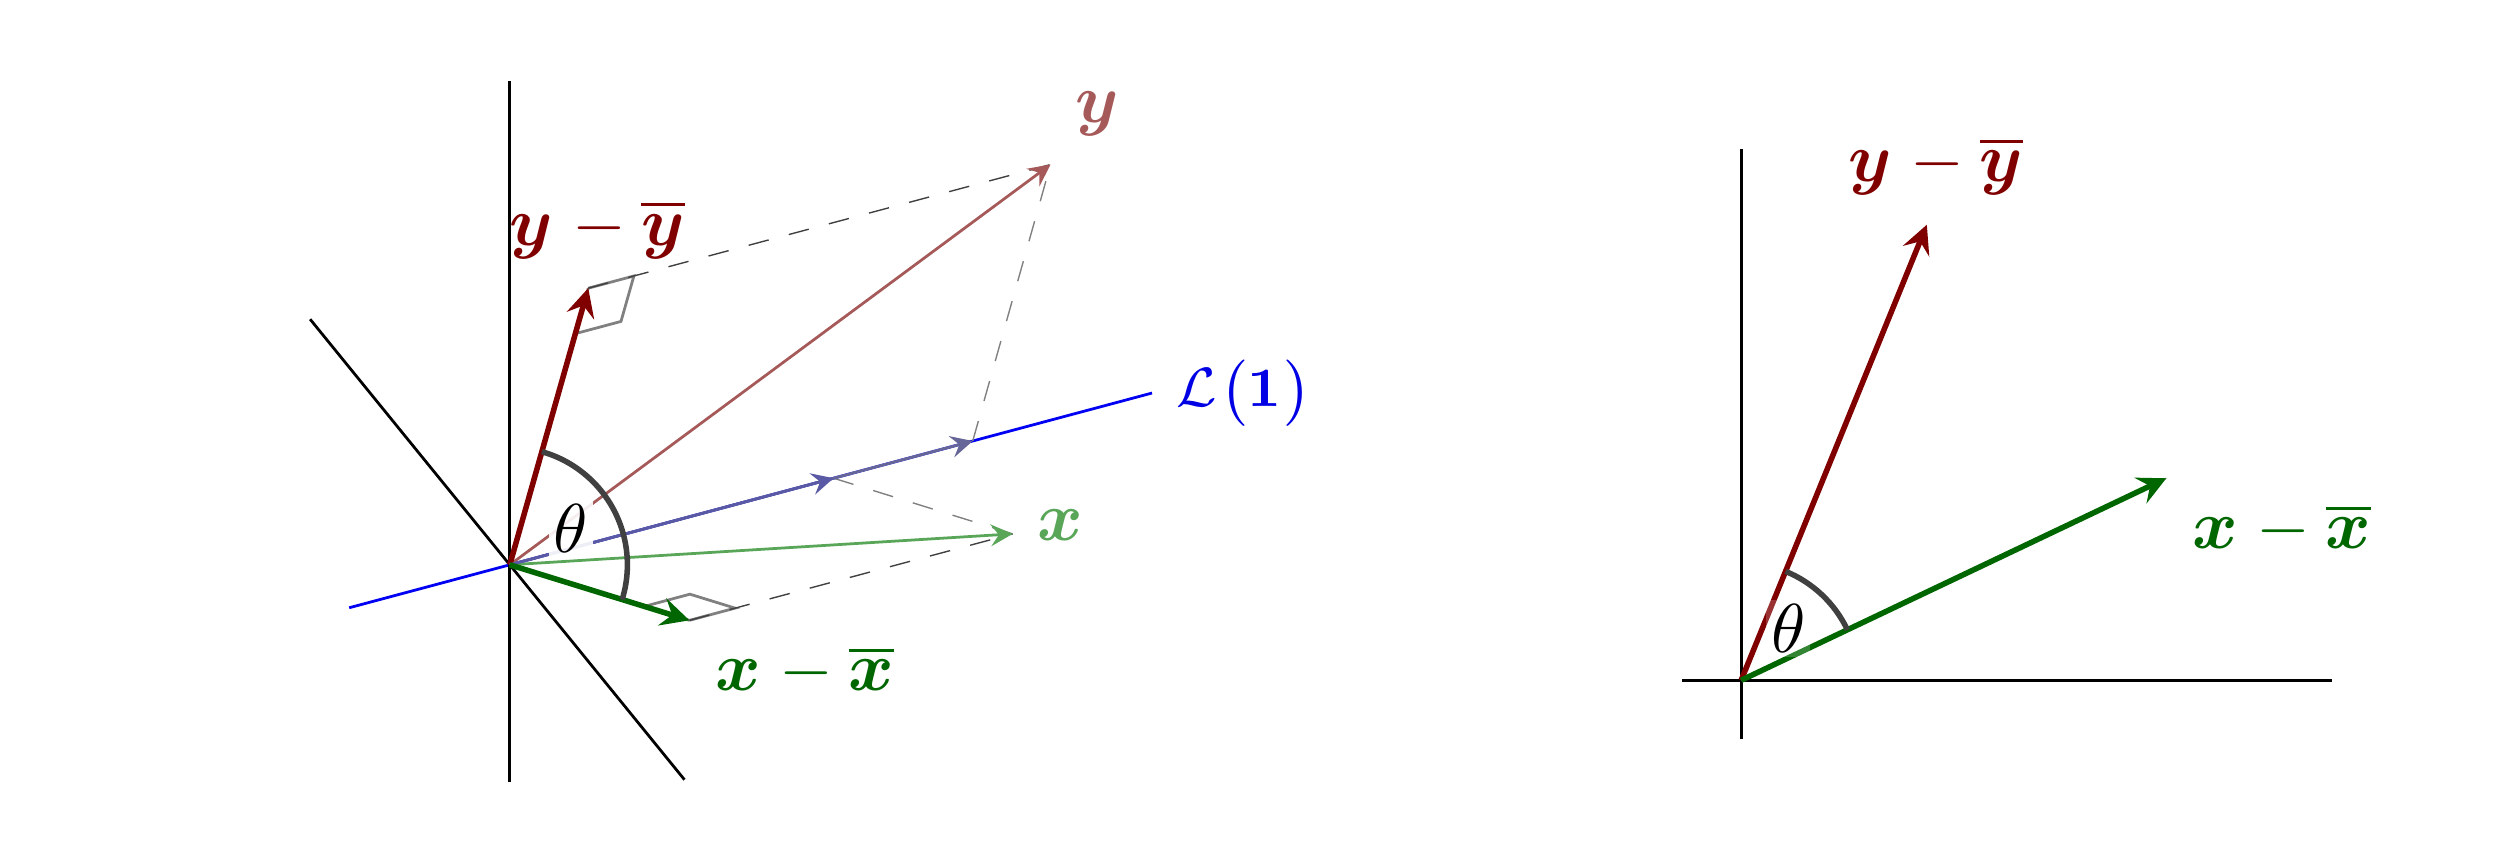
Dos vectores $\boldsymbol{y}$ (rojo) y $\boldsymbol{x}$ (verde) en $\mathbb{R}^3$, con sus vectores en desviaciones $\boldsymbol{y}-\boldsymbol{\mathop{\overline{y}}}$ y $\boldsymbol{x}-\boldsymbol{\mathop{\overline{x}}}$ en el plano perpendicular al eje azul $\mathcal{L}(\boldsymbol{1})$. El coseno del ángulo $\theta$ entre esos dos vectores en desviaciones es la correlación $\rho_{\boldsymbol{x}\boldsymbol{y}}$. La figura de la derecha es la misma escena, contemplada desde un punto de vista distinto (perpendicular a ambos vectores en desviaciones para apreciar mejor el ángulo $\theta$). (versión interactiva, parte 2)
La correlación indica el ``grado de alineación'' entre las componentes no constantes.
Un hecho geométrico: en $\mathbb{R}^2$ la correlación es siempre $\pm1$
En $\mathbb{R}^2$, $\mathcal{L}(\boldsymbol{1})^\perp$ tiene dimensión $2-1=1$: es una recta.
Todo vector en desviaciones en $\mathbb{R}^2$ vive en esa misma recta.
Por tanto, dos vectores en desviaciones cualesquiera en $\mathbb{R}^2$ están siempre alineados: $$ \rho_{\boldsymbol{x}\boldsymbol{y}} = \pm1 \qquad (\text{en } \mathbb{R}^2). $$
Comprobación, con los ejemplos de la lección 4: $\boldsymbol{x}=(2,4)$ y $\boldsymbol{z}=(2,-6)$ dan $\rho_{\boldsymbol{x}\boldsymbol{z}}=-1$.
Para ver ángulos genuinos hace falta $n\geq3$. Por eso las figuras de hoy viven en $\mathbb{R}^3$.
Propiedades geométricas: traslación y escala
- Invarianza ante traslaciones: sumar una constante a $\boldsymbol{x}$ o a $\boldsymbol{y}$ no cambia $\sigma_{\boldsymbol{x}\boldsymbol{y}}$ ni $\rho_{\boldsymbol{x}\boldsymbol{y}}$.
- Homogeneidad ante escala: si $\boldsymbol{x}'=\lambda\boldsymbol{x}$ con $\lambda\neq0$:
El caso $\boldsymbol{y}=\boldsymbol{x}$ (la varianza): $$ \sigma_{\boldsymbol{x}+a\boldsymbol{1}}^2 = \sigma_{\boldsymbol{x}}^2, \qquad \sigma_{\lambda\boldsymbol{x}}^2 = \lambda^2\,\sigma_{\boldsymbol{x}}^2. $$
La correlación es invariante a cambios de escala (salvo, quizá, el signo); pero la covarianza no.
Por otra parte, la desviación típica se escala por $|\lambda|$ (y la varianza, por $\lambda^2$).
Ejemplo numérico completo en $\mathbb{R}^3$
| Primer Vector $\boldsymbol{x}$ | Segundo Vector $\boldsymbol{y}$ | |
|---|---|---|
| Datos | $\mbox{$\boldsymbol{x}=(1,2,3)$}$ | $\mbox{$\boldsymbol{y}=(2,2,5)$}$ |
| Media | $\mu_{\boldsymbol{x}}=2$ | $\mu_{\boldsymbol{y}}=3$ |
| Vector en desviaciones | $(-1,0,1)$ | $(-1,-1,2)$ |
| Varianza | $\sigma_{\boldsymbol{x}}^2=\frac{2}{3}$ | $\sigma_{\boldsymbol{y}}^2=2$ |
Covarianza : $\sigma_{\boldsymbol{x}\boldsymbol{y}} = \frac{1}{3}\big[(-1)(-1)+(0)(-1)+(1)(2)\big] = 1$.
Un ángulo $\theta=30^o$: ni ortogonales, ni alineados. Un caso imposible en $\mathbb{R}^2$.
Recapitulación
| Objeto/Concepto | Definición geométrica/algebraica | Fórmula en estadística descriptiva |
|---|---|---|
| Varianza $\sigma_{\boldsymbol{x}}^2$ | $\Vert\boldsymbol{x}-\boldsymbol{\mathop{\overline{x}}}\Vert_s^2$ | $\frac{1}{n}\sum(x_i-\mu_{\boldsymbol{x}})^2 = \mu_{\boldsymbol{x}^2}-\mu_{\boldsymbol{x}}^2$ |
| Covarianza $\sigma_{\boldsymbol{x}\boldsymbol{y}}$ | $\langle\boldsymbol{x}-\boldsymbol{\mathop{\overline{x}}},\,\boldsymbol{y}-\boldsymbol{\mathop{\overline{y}}}\rangle_s$ | $\frac{1}{n}\sum(x_i-\mu_{\boldsymbol{x}})(y_i-\mu_{\boldsymbol{y}})$ |
| Correlación $\rho_{\boldsymbol{x}\boldsymbol{y}}$ | $\cos$ del ángulo $\theta$ entre $(\boldsymbol{x}-\boldsymbol{\mathop{\overline{x}}})$ e $(\boldsymbol{y}-\boldsymbol{\mathop{\overline{y}}})$ | $\dfrac{\sigma_{\boldsymbol{x}\boldsymbol{y}}}{\sigma_{\boldsymbol{x}}\sigma_{\boldsymbol{y}}}$ |
El principio unificador: la covarianza es un producto escalar; la correlación, un coseno. Nada de esto es nuevo: es la geometría de las lecciones 2 y 3, aplicada ahora a los vectores en desviaciones.
Guiño a la sesión siguiente
Próxima sesión: laboratorio en Gretl. Estadísticos descriptivos, correlaciones y diagramas de dispersión con datos reales; verificación numérica de las identidades de hoy (Pitágoras, covarianza, correlación) con datos simulados.
Lección 6: la regresión lineal simple. Añadiremos un segundo regresor $\boldsymbol{x}$ a la proyección sobre $\mathcal{L}(\boldsymbol{1})$: proyectaremos sobre $\mathcal{L}(\boldsymbol{1},\boldsymbol{x})$, ya no una recta sino un plano. El ángulo $\theta$ de hoy reaparecerá en la lección 8 como $R^2=\cos^2\theta$.