Lección 6. La regresión lineal simple como ajuste geométrico
Índice
- 1. De dónde venimos: Proyección ortogonal sobre una recta
- 2. El plano \(\mathcal{L}(\boldsymbol{1},\boldsymbol{x})\)
- 3. Un matiz importante: \(\boldsymbol{1}\) y \(\boldsymbol{x}\) no son ortogonales
- 4. El problema de ajuste
- 5. La geometría del ajuste
- 6. Lo que la ortogonalidad nos va a dar
- 7. Vocabulario: regresor
- 8. Recapitulación y guiño a la lección siguiente
- 9. Preguntas de repaso (sesión 8) htmlonly
- 10. Respuestas htmlonly
Generalizamos la proyección sobre una recta (la media, lección 4) a la proyección sobre un plano generado por dos vectores: \(\boldsymbol{1}\) (de unos) y \(\boldsymbol{x}\) (de datos). Todavía seguimos trabajando sin supuestos relacionados con la probabilidad: es el mismo problema geométrico de antes (buscar el vector más próximo a los datos \(\boldsymbol{y}\)), pero con una dirección de búsqueda adicional. Formalizamos aquí el término regresor (que ya asomó en la lección 3) y dejamos planteada, como tarea para la lección siguiente, la resolución del sistema que determina el ajuste.
``Después de una recta, un plano: la misma pregunta, un vector más.''
1. De dónde venimos: Proyección ortogonal sobre una recta
- En la lección 4 proyectamos el vector de datos \(\boldsymbol{y}\) sobre la recta \(\mathcal{L}(\boldsymbol{1})\) buscando el múltiplo de \(\boldsymbol{1}\) más próximo. El escalar por el que multiplicar \(\boldsymbol{1}\) resultó ser la media.
- La pregunta era geométrica: ¿cuál es el múltiplo de \(\boldsymbol{1}\) más cercano a \(\boldsymbol{y}\)?
En esta lección:
- Hacemos la misma pregunta, pero añadimos una segunda dirección.
- Proyectaremos sobre el plano generado por \(\boldsymbol{1}\) y un segundo vector de datos \(\boldsymbol{x}\).
Aún no hay variables aleatorias, ni perturbaciones, ni causalidad: sigue siendo pura geometría en \(\mathbb{R}^n\).
De dónde venimos
En la lección 4 planteamos un problema muy concreto: dado un vector de datos \(\boldsymbol{y}\in\mathbb{R}^n\), ¿cuál es el múltiplo de \(\boldsymbol{1}\) (el vector constante) más próximo a \(\boldsymbol{y}\)? La respuesta es \(\mu_{\boldsymbol{y}}\boldsymbol{1}\) (la media de los datos multiplicada por \(\boldsymbol{1}\)). Este resultado es la proyección ortogonal de \(\boldsymbol{y}\) sobre \(\mathcal{L}(\boldsymbol{1})\), es decir, sobre la recta en \(\mathbb{R}^n\) que pasa por el origen y contiene a todos los múltiplos de \(\boldsymbol{1}\).
En esta lección hacemos la misma pregunta, pero con una importante diferencia: en lugar de disponer de un único vector generador (\(\boldsymbol{1}\)), disponemos de dos. Además de \(\boldsymbol{1}\), tenemos ahora un segundo vector de datos \(\boldsymbol{x}\in\mathbb{R}^n\) (por ejemplo, la superficie de \(n\) viviendas, si \(\boldsymbol{y}\) es el precio). La pregunta pasa a ser: ¿cuál es la combinación de \(\boldsymbol{1}\) y \(\boldsymbol{x}\) más próxima a \(\boldsymbol{y}\)?
Quiero subrayar algo importante desde el principio: no vamos a hablar todavía de modelos, de supuestos, ni de si \(\boldsymbol{x}\) ``causa'' \(\boldsymbol{y}\). Eso vendrá más adelante, cuando dispongamos de herramientas para plantearlo con rigor. Por ahora, igual que con la media, esto es un problema puramente geométrico: tenemos unos datos \(\boldsymbol{x}\) y queremos encontrar la combinación de \(\boldsymbol{1}\) y \(\boldsymbol{x}\) (un punto en un cierto subespacio) que está más cerca de \(\boldsymbol{y}\).
Para profundizar:
- Bujosa, M. (2024). Curso de Álgebra Lineal, cap. 11. enlace.
2. El plano \(\mathcal{L}(\boldsymbol{1},\boldsymbol{x})\)
- Un vector generador \(\boldsymbol{a}\) \(\Rightarrow\) \(\mathcal{L}(\boldsymbol{a})\): una recta.
- Dos vectores generadores \(\boldsymbol{a},\boldsymbol{b}\) (no alineados) \(\Rightarrow\) \(\mathcal{L}(\boldsymbol{a},\boldsymbol{b})\): un plano.
\[ \mathcal{L}(\boldsymbol{1},\boldsymbol{x}) = \{\beta_1\boldsymbol{1}+\beta_2\boldsymbol{x} \mid \beta_1,\beta_2\in\mathbb{R}\} \]
El plano \(\mathcal{L}(\boldsymbol{1},\boldsymbol{x})\)
Recordemos de la lección 2 que una combinación lineal de dos vectores \(\boldsymbol{a}\) y \(\boldsymbol{b}\) es cualquier expresión de la forma \(\beta_1\boldsymbol{a}+\beta_2\boldsymbol{b}\), con \(\beta_1,\beta_2\) números reales cualesquiera. El conjunto de todas las combinaciones lineales posibles de \(\boldsymbol{a}\) y \(\boldsymbol{b}\) se denota \(\mathcal{L}(\boldsymbol{a},\boldsymbol{b})\), generalizando la notación \(\mathcal{L}(\boldsymbol{a})\) ya introducida en la lección 4 para el caso de un único vector generador.
Cuando \(\boldsymbol{a}\) y \(\boldsymbol{b}\) no son múltiplos el uno del otro (es decir, cuando no están alineados dentro de la misma recta), el conjunto \(\mathcal{L}(\boldsymbol{a},\boldsymbol{b})\) es, geométricamente, un plano que pasa por el origen: contiene, de manera informal, dos direcciones independientes (retomamos aquí, sin formalizarla, la noción de dimensión que ya usamos en las lecciones 4 y 5). Cualquier punto del plano se alcanza combinando adecuadamente los ``desplazamientos'' o ``pasos'' necesarios en esas dos direcciones.
En nuestro caso, los dos vectores generadores son \(\boldsymbol{1}\) (el vector de unos) y \(\boldsymbol{x}\) (nuestro segundo vector de datos). El plano \(\mathcal{L}(\boldsymbol{1},\boldsymbol{x})\) contiene, en particular, la recta \(\mathcal{L}(\boldsymbol{1})\) con la que ya trabajamos en la lección 4 (es el caso particular \(\beta_2=0\)), pero es un conjunto mucho más rico: contiene todas las variaciones producidas al sumarle a cualquier múltiplo de \(\boldsymbol{1}\) otro múltiplo de \(\boldsymbol{x}\).
Nótese que si \(\boldsymbol{x}\) fuera un múltiplo de \(\boldsymbol{1}\) (es decir, si todos los datos de \(\boldsymbol{x}\) fueran idénticos o, dicho de otro modo, si la varianza de \(\boldsymbol{x}\) fuera cero), \(\mathcal{L}(\boldsymbol{1},\boldsymbol{x})\) colapsaría de nuevo en una simple recta: no ganaríamos ninguna dirección nueva. Volveremos sobre este caso degenerado en la lección 14, dedicada a la colinealidad; por ahora basta con tenerlo presente como advertencia.
Para profundizar:
- Strang, G. (2016). Introduction to Linear Algebra (5ª ed.), sección 1.1: combinaciones lineales de dos vectores y el plano que generan.
- Bujosa, M. Curso de Álgebra Lineal, capítulo 11: libro online.
- Vídeo: Linear combinations, span, and basis vectors de 3Blue1Brown (capítulo 2 de Essence of Linear Algebra). Doce minutos sobre qué conjunto generan uno, dos o tres vectores.
3. Un matiz importante: \(\boldsymbol{1}\) y \(\boldsymbol{x}\) no son ortogonales
Recordamos de la lección 4: \[ \mu_{\boldsymbol{x}} = \langle\boldsymbol{x},\boldsymbol{1}\rangle_s. \]
Si \(\mu_{\boldsymbol{x}}\neq0\) (el caso habitual), entonces \(\boldsymbol{1}\) y \(\boldsymbol{x}\) no son ortogonales.
Los ejes \(\mathcal{L}(\boldsymbol{1})\) y \(\mathcal{L}(\boldsymbol{x})\) generalmente se cortan oblicuamente, no en ángulo recto.
Un matiz importante: \(\boldsymbol{1}\) y \(\boldsymbol{x}\) no son ortogonales
Este detalle técnico va a condicionar la forma en que dibujemos —y, sobre todo, la forma en que interpretemos — la figura de la siguiente transparencia.
En la lección 4 vimos que \(\mu_{\boldsymbol{x}}=\langle\boldsymbol{x},\boldsymbol{1}\rangle_s\) es el producto escalar entre \(\boldsymbol{x}\) y \(\boldsymbol{1}\). Y en la lección 3 aprendimos que dos vectores son ortogonales exactamente cuando su producto escalar es cero. Por tanto, si la media de \(\boldsymbol{x}\) no es cero —que es una situación habitual con datos económicos: precios, superficies, años de educación, todos ellos con media positiva— entonces \(\boldsymbol{x}\) y \(\boldsymbol{1}\) no son ortogonales.
¿Qué consecuencia tiene esto? Que si dibujamos el plano \(\mathcal{L}(\boldsymbol{1},\boldsymbol{x})\) usando como ejes de referencia \(\boldsymbol{1}\) y \(\boldsymbol{x}\) directamente, esos dos ejes no se cortarán en ángulo recto, sino oblicuamente. Esto es exactamente lo que verá en la figura de la próxima transparencia.
Fíjese, no obstante, que podemos generar el mismo plano con otro par de vectores que sí sean ortogonales entre sí. En concreto, \[ \mathcal{L}(\boldsymbol{1},\boldsymbol{x}) = \mathcal{L}(\boldsymbol{1},\ \boldsymbol{x}-\mu_{\boldsymbol{x}}\boldsymbol{1}), \] donde \(\boldsymbol{x}-\mu_{\boldsymbol{x}}\boldsymbol{1}\) es lo que en la lección 4 llamamos el vector en desviaciones de \(\boldsymbol{x}\). Este vector en desviaciones SÍ es ortogonal a \(\boldsymbol{1}\) (es, precisamente, la proyección de \(\boldsymbol{x}\) sobre \(\mathcal{L}(\boldsymbol{1})^\perp\), el conjunto de todos los vectores ortogonales a \(\boldsymbol{1}\)). El plano no cambia —es el mismo conjunto de puntos—, pero si lo dibujamos usando este nuevo par de generadores, los ejes sí aparecerían perpendiculares.
Por ahora nos quedamos con la versión ``cruda'': trabajaremos con \(\boldsymbol{1}\) y \(\boldsymbol{x}\) tal cual, sin centrar. Esto tiene la ventaja de que el ajuste resultante (\(\hat\beta_1,\hat\beta_2\)) es directamente el que buscamos, sin pasos intermedios. Pero conviene tener en mente esta alternativa ``centrada'',1 porque reaparecerá cuando, en lecciones posteriores, discutamos cómo se relaciona la pendiente de la regresión con la correlación entre \(\boldsymbol{x}\) e \(\boldsymbol{y}\).
Para profundizar:
- Wooldridge, J. M. (2020). Introductory Econometrics, Apéndice C (repaso del efecto de transformaciones lineales).
4. El problema de ajuste
Buscamos \(\hat\beta_1,\hat\beta_2\) tales que \[ \|\boldsymbol{y}-(\beta_1\boldsymbol{1}+\beta_2\boldsymbol{x})\|_s \] sea mínima.
\(\boldsymbol{\mathop{\widehat{y}}} = \hat\beta_1\boldsymbol{1}+\hat\beta_2\boldsymbol{x} \quad\) (el ajuste: la proyección)
\(\boldsymbol{\mathop{\widehat{e}}} = \boldsymbol{y}-\boldsymbol{\mathop{\widehat{y}}} \quad\) (el residuo o vector de residuos del ajuste)
El problema de ajuste
Formalicemos el problema que veníamos planteando de manera informal. Dado el vector de datos \(\boldsymbol{y}\) y el plano \(\mathcal{L}(\boldsymbol{1},\boldsymbol{x})\), queremos encontrar los dos números \(\hat\beta_1\) y \(\hat\beta_2\) (nótese: son escalares, sin negrita, exactamente como el \(\alpha\) que buscábamos en la lección 4 cuando solo había un vector generador) que hacen que la distancia (norma estadística) entre \(\boldsymbol{y}\) y el punto \(\beta_1\boldsymbol{1}+\beta_2\boldsymbol{x}\) del plano sea la menor posible.
Al vector del plano que logra esa distancia mínima lo llamamos el ajuste MCO2 y lo denotamos \(\boldsymbol{\mathop{\widehat{y}}}\). Es importante no confundir el vector \(\boldsymbol{\mathop{\widehat{y}}}\) con los escalares \(\hat\beta_1,\hat\beta_2\) que lo determinan: quien es la proyección ortogonal es el vector \(\boldsymbol{\mathop{\widehat{y}}}\); los coeficientes \(\hat\beta_1,\hat\beta_2\) son, simplemente, los números que hay que usar para construirlo a partir de \(\boldsymbol{1}\) y \(\boldsymbol{x}\).
A la diferencia entre los datos observados y el ajuste, \(\boldsymbol{\mathop{\widehat{e}}}=\boldsymbol{y}-\boldsymbol{\mathop{\widehat{y}}}\), la llamamos residuo o vector con los errores de ajuste. Aquí introducimos una precisión terminológica: reservamos la palabra ``residuo'' exclusivamente para este contexto, el de un ajuste con regresores no constantes. Cuando en la lección 4 hablábamos de \(\boldsymbol{y}-\mu_{\boldsymbol{y}}\boldsymbol{1}\), usábamos deliberadamente la expresión ``vector en desviaciones'', no ``residuo'' — comparten una construcción geométrica parecida (una diferencia entre el dato y un ajuste), pero mantenemos los nombres distintos porque corresponden a ajustes distintos, y porque en las próximas lecciones el residuo de la regresión jugará un papel muy específico (será la pieza clave para estimar la variabilidad no explicada al ajustar un modelo).
Para profundizar:
- Wooldridge, J. M. (2020). Introductory Econometrics, cap. 2, sección 2.2: la obtención de las estimaciones MCO, planteada allí como minimización de una suma de cuadrados (la misma que aquí planteamos como distancia mínima).
- Strang, G. (2016), sección 4.3: Least squares approximations, el mismo problema desde el álgebra lineal.
5. La geometría del ajuste
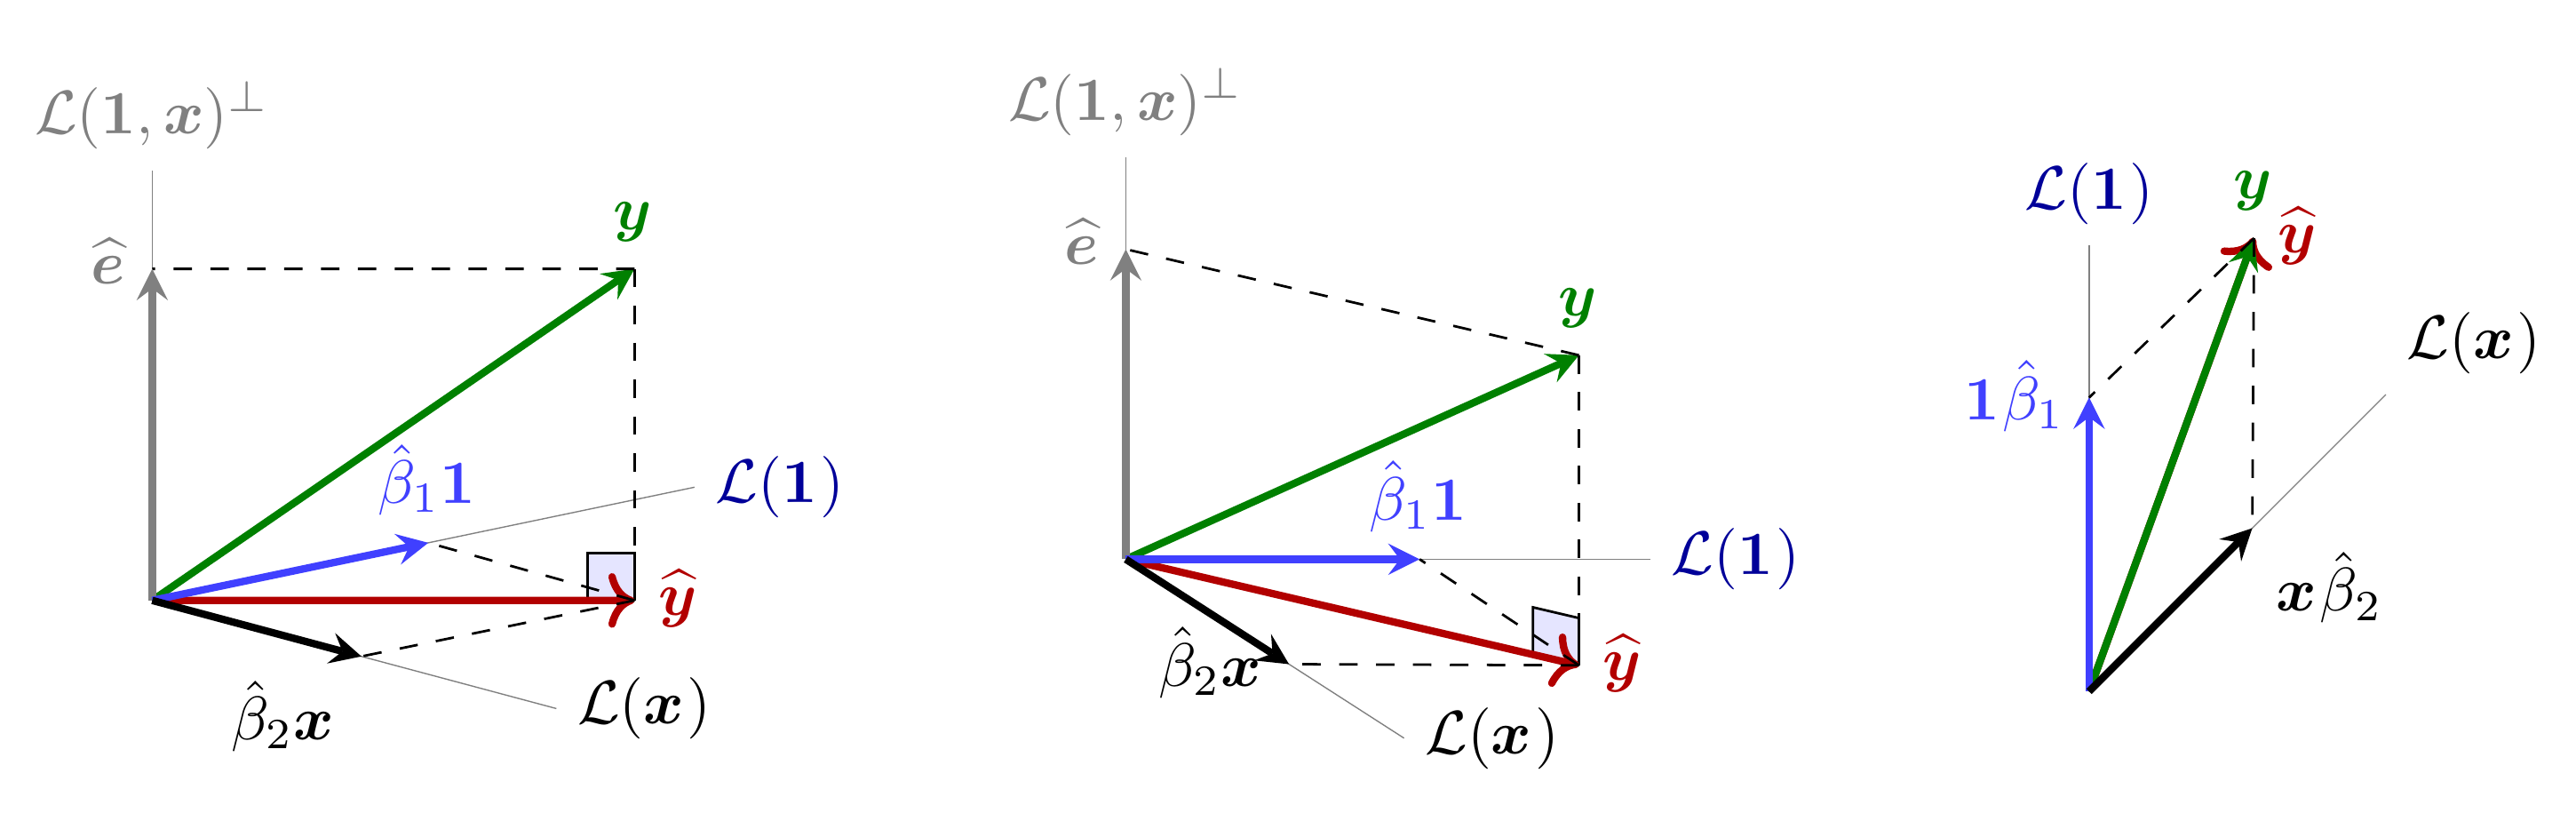
Figura 1: Proyección ortogonal de \(\boldsymbol{y}\) sobre el plano \(\mathcal{L}(\boldsymbol{1},\boldsymbol{x})\), vista desde tres ángulos: (izquierda) de frente al plano \((\boldsymbol{\mathop{\widehat{y}}},\boldsymbol{\mathop{\widehat{e}}})\); (centro) de frente al plano \((\mathcal{L}(\boldsymbol{1}),\mathcal{L}(\boldsymbol{1},\boldsymbol{x})^\perp)\); (derecha) vista cenital, perpendicular al plano de los regresores.
Versión interactiva: cuaderno 2 en MyBinder, parte 1 (el plano, el ajuste y el residuo, rotables).
La geometría del ajuste
Detengámonos con calma en esta figura, porque condensa toda la geometría de la lección.
La escena representa un caso con \(n=3\) datos (por eso podemos dibujarla en un espacio tridimensional) pero la podemos leer como una representación esquemática (no literal) del caso general en \(\mathbb{R}^n\) (para cualquier cantidad de datos \(n\geq3\)). Tenemos el vector de datos \(\boldsymbol{y}\) (en verde), y el plano \(\mathcal{L}(\boldsymbol{1},\boldsymbol{x})\), generado por los dos vectores \(\boldsymbol{1}\) (contenido en el eje \(\mathcal{L}(\boldsymbol{1})\)) y \(\boldsymbol{x}\) (contenido en el eje \(\mathcal{L}(\boldsymbol{x})\)).3 Como \(\boldsymbol{x}\) tiene media distinta de cero, estos dos ejes no son perpendiculares entre sí, sino oblicuos — exactamente lo que anticipamos en la transparencia anterior.
El vector rojo, \(\boldsymbol{\mathop{\widehat{y}}}\), es la proyección ortogonal de \(\boldsymbol{y}\) sobre ese plano: es el punto del plano más próximo a \(\boldsymbol{y}\). De la punta de \(\boldsymbol{\mathop{\widehat{y}}}\) salen líneas discontinuas, paralelas a los ejes, que llegan hasta sus componentes sobre cada uno de los dos generadores: \(\hat\beta_1\boldsymbol{1}\) (en azul) y \(\hat\beta_2\boldsymbol{x}\) (en negro). Esta es la forma geométrica de leer que \(\boldsymbol{\mathop{\widehat{y}}}=\hat\beta_1\boldsymbol{1}+\hat\beta_2\boldsymbol{x}\): sumando esas dos componentes se reconstruye \(\boldsymbol{\mathop{\widehat{y}}}\).
De la punta de \(\boldsymbol{\mathop{\widehat{y}}}\) sale también una línea discontinua vertical que llega hasta \(\boldsymbol{y}\), y en la esquina de esa línea con el plano aparece marcado un ángulo recto para recordarnos que estamos ante la proyección ortogonal de \(\boldsymbol{y}\) sobre el plano \(\mathcal{L}(\boldsymbol{1},\boldsymbol{x})\). En el eje vertical aparece el vector \(\boldsymbol{\mathop{\widehat{e}}}\) (en gris), que resulta ser ortogonal a todo el plano. El eje vertical sobre el que se encuentra está marcado con \(\mathcal{L}(\boldsymbol{1},\boldsymbol{x})^\perp\) (es el conjunto de todos los vectores ortogonales al plano de los regresores).
Las tres vistas de la figura nos ayudan a ver distintos aspectos del ajuste:
- La vista de la izquierda está tomada de frente al plano formado por \(\boldsymbol{\mathop{\widehat{y}}}\) y \(\boldsymbol{\mathop{\widehat{e}}}\), cuya suma es el vector de datos \(\boldsymbol{y}\). Desde aquí se aprecia con claridad un rectángulo dividido en dos triángulos rectángulos cuya hipotenusa es \(\boldsymbol{y}\): la misma estructura pitagórica que ya usamos en la lección 5, pero ahora con \(\boldsymbol{\mathop{\widehat{y}}}\) en el papel que allí jugaba el vector de medias.
- La vista central está tomada de frente al plano formado por el eje \(\mathcal{L}(\boldsymbol{1})\) y el eje vertical \(\mathcal{L}(\boldsymbol{1},\boldsymbol{x})^\perp\) y permite apreciar que los regresores no son perpendiculares entre sí.
- La vista de la derecha es una vista cenital: mirando perpendicularmente al plano de los regresores, desde arriba. Es aquí donde mejor se aprecia la oblicuidad entre los ejes \(\mathcal{L}(\boldsymbol{1})\) y \(\mathcal{L}(\boldsymbol{x})\): si proyecta mentalmente el vector \(\hat\beta_2\boldsymbol{x}\) sobre el eje \(\mathcal{L}(\boldsymbol{1})\) (que en esta vista se ve vertical) y suma esa proyección a \(\hat\beta_1\boldsymbol{1}\), llega al mismo punto donde caen las proyecciones tanto de \(\boldsymbol{\mathop{\widehat{y}}}\) como de \(\boldsymbol{y}\) sobre esa recta. Esto es una consecuencia directa de que \(\boldsymbol{\mathop{\widehat{e}}}\) es ortogonal a \(\mathcal{L}(\boldsymbol{1})\), y anticipa una propiedad que veremos en la lección 7: la media de \(\boldsymbol{\mathop{\widehat{y}}}\) coincide con la media de \(\boldsymbol{y}\).
Nótese lo que esta figura NO contiene: ningún supuesto sobre cómo se generaron los datos, ninguna variable aleatoria, ninguna perturbación ``poblacional''. Es geometría pura sobre un vector de datos y un plano.
Para profundizar:
- Strang, G. (2016), sección 4.2: Projections, con la proyección sobre un subespacio de dimensión mayor que uno.
- Bujosa, M. Curso de Álgebra Lineal, capítulo 11: libro online.
6. Lo que la ortogonalidad nos va a dar
\(\boldsymbol{\mathop{\widehat{e}}}\) es ortogonal a todo el plano \(\mathcal{L}(\boldsymbol{1},\boldsymbol{x})\).
En particular, es ortogonal a cada uno de sus generadores:
\[ \langle\boldsymbol{\mathop{\widehat{e}}},\boldsymbol{1}\rangle_s=0 \qquad (\text{el residuo $\boldsymbol{\mathop{\widehat{e}}}$ tiene media cero}) \] y \[ \langle\boldsymbol{\mathop{\widehat{e}}},\boldsymbol{x}\rangle_s=0 \quad ({\tiny\text{junto con } \langle\boldsymbol{\mathop{\widehat{e}}},\boldsymbol{1}\rangle_s=0}) \implies\boldsymbol{\mathop{\widehat{e}}} \text{ tiene covarianza cero con } \boldsymbol{x}. \] Dos ecuaciones, dos incógnitas (\(\hat\beta_1,\hat\beta_2\))\(\ldots\) (la próxima lección resuelve el sistema).
Lo que la ortogonalidad nos va a dar
Esta transparencia es, en cierto sentido, el destino de toda la lección, aunque dejemos su desarrollo completo para la siguiente.
La propiedad definitoria de una proyección ortogonal —ya la usamos en la lección 4 con un único vector generador— es que el residuo es ortogonal a todo el subespacio sobre el que proyectamos, no solo a alguno de sus vectores. En la lección 4, como el subespacio era una simple recta \(\mathcal{L}(\boldsymbol{1})\), esto se traducía en una única condición: \(\big\langle(\boldsymbol{y}-\mu_{\boldsymbol{y}}\boldsymbol{1}) , \boldsymbol{1}\big\rangle_s=0\), de la cual salía la fórmula para calcular la media \(\mu_{\boldsymbol{y}}\).
Ahora que el subespacio es un plano generado por dos vectores, la misma exigencia —que \(\boldsymbol{\mathop{\widehat{e}}}\) sea ortogonal a todo el plano— se traduce, de manera natural, en dos condiciones: \(\boldsymbol{\mathop{\widehat{e}}}\) debe ser ortogonal tanto a \(\boldsymbol{1}\) como a \(\boldsymbol{x}\) (los dos generadores del plano): basta con que un vector sea ortogonal a los generadores de un subespacio para que sea ortogonal a cualquier combinación lineal de ellos (y por tanto, a todo el subespacio).
Merece la pena leer con detenimiento qué significa cada condición por separado:
- \(\langle\boldsymbol{\mathop{\widehat{e}}} , \boldsymbol{1}\rangle_s=0\) es exactamente la misma condición que ya vimos en la lección 4 para la media: dice que la media de las componentes de \(\boldsymbol{\mathop{\widehat{e}}}\) es cero, es decir, \(\sum_i\hat e_i=0\). Por tanto, el ajuste \(\boldsymbol{\mathop{\widehat{y}}}\), sea cual sea, no puede sistemáticamente sobrestimar ni subestimar los datos \(\boldsymbol{y}\) en promedio (pues la suma de los errores necesariamente se cancela).
\(\langle\boldsymbol{\mathop{\widehat{e}}} , \boldsymbol{x}\rangle_s=0\) es una condición nueva, que no tenía sentido cuando solo disponíamos de \(\boldsymbol{1}\).
En conjunción con la primera condición (que \(\boldsymbol{\mathop{\widehat{e}}}\) es ortogonal a los vectores constantes, y por tanto ya está en desviaciones), arroja una propiedad algebraica sobre la que merece la pena detenerse, pues la usaremos repetidas veces. Si calculamos el producto escalar de \(\boldsymbol{\mathop{\widehat{e}}}\) con otro vector en desviaciones respecto a su media, aplicando las propiedades tenemos \[ \sigma_{\boldsymbol{\mathop{\widehat{e}}}\boldsymbol{x}} \quad=\quad \Big\langle\boldsymbol{\mathop{\widehat{e}}} , (\boldsymbol{x} - \mu_{\boldsymbol{x}}\boldsymbol{1})\Big\rangle_s \quad=\quad \langle\boldsymbol{\mathop{\widehat{e}}} , \boldsymbol{x}\rangle_s - \underbrace{\Big\langle\boldsymbol{\mathop{\widehat{e}}} , (\mu_{\boldsymbol{x}}\boldsymbol{1})\Big\rangle_s}_{=0;\;\; \boldsymbol{\mathop{\widehat{e}}}\perp\mathcal{L}(\boldsymbol{1})} \quad=\quad \langle\boldsymbol{\mathop{\widehat{e}}} , \boldsymbol{x}\rangle_s. \] ¡Este es un principio general que será muy útil! Si un vector tiene media cero, su producto escalar con cualquier otro vector resulta ser la covarianza.
Retomando el vocabulario de la lección 5: cuando \(\boldsymbol{\mathop{\widehat{e}}}\) ya está centrado (cuando su media es nula), decir que \(\langle\boldsymbol{\mathop{\widehat{e}}} , \boldsymbol{x}\rangle_s=0=\frac{1}{n}\sum\mathop{\widehat{e}_i}x_i\) es lo mismo que decir que \(\boldsymbol{\mathop{\widehat{e}}}\) y \(\boldsymbol{x}\) tienen covarianza cero. Por tanto, cuando el residuo no es nulo4, esto equivale a que \(\boldsymbol{\mathop{\widehat{e}}}\) y \(\boldsymbol{x}\) están incorrelados (correlación cero).
Recapitulando, tenemos dos ecuaciones y dos incógnitas (\(\hat\beta_1\) y \(\hat\beta_2\)). En principio esto debería bastar para determinar \(\hat\beta_1\) y \(\hat\beta_2\) de forma única5 —tal como ocurría con una sola ecuación y una sola incógnita en la lección 4—. Resolver explícitamente ese sistema, y obtener fórmulas cerradas para \(\hat\beta_1\) y \(\hat\beta_2\) en función de los datos, es precisamente la tarea de la lección 7.
Para profundizar:
- Wooldridge, J. M. (2020), cap. 2, sección 2.2: las condiciones de primer orden del problema de mínimos cuadrados, que son estas mismas dos ortogonalidades escritas como sumatorios.
7. Vocabulario: regresor
Definición (regresor). Llamamos regresor a cada uno de los vectores que entran en la combinación lineal del ajuste (cada vector que multiplica a un coeficiente \(\hat\beta_j\)).
\(\mbox{ }\)
En la regresión lineal simple hay dos regresores: \(\boldsymbol{1}\) y \(\boldsymbol{x}\).
(Postponemos deliberadamente el término ``variable explicativa'': ese término trae consigo un matiz causal que aún no estamos en condiciones de justificar.)
Vocabulario: regresor
Formalizamos aquí, de forma deliberadamente aséptica, el término que va a acompañarnos durante el resto del curso: regresor. Un regresor es, simplemente, cualquiera de los vectores que aparecen multiplicados por un coeficiente \(\hat\beta_j\) en la combinación lineal que estamos ajustando. En el modelo de esta lección hay exactamente dos: el vector de unos \(\boldsymbol{1}\) y el vector de datos \(\boldsymbol{x}\).
Es importante no confundir ``regresor'' con ``variable explicativa''. Un regresor es: un vector concreto que entra en la combinación lineal. Una variable explicativa, en cambio, es un concepto sustantivo (por ejemplo, ``la educación de una persona'', o ``la superficie de una vivienda''), que puede entrar en el modelo mediante uno o varios regresores. Por ejemplo, si quisiéramos explicar el salario usando tanto los años de educación como el cuadrado de dichos años, tendríamos dos regresores (la columna de años de educación y la columna con esos años al cuadrado), pero seguiría siendo una sola variable explicativa (la educación), que entra en el modelo a través de dos columnas distintas.
Por ahora, con solo dos regresores (\(\boldsymbol{1}\) y \(\boldsymbol{x}\)), esta distinción es casi anecdótica. Pero conviene fijar el vocabulario desde ahora, porque en lecciones posteriores construiremos modelos con varios regresores a la vez, y esta distinción entre ``columna de la matriz de regresores'' y ``concepto económico involucrado'' será relevante para leer correctamente los resultados.
Nótese, además, que en esta lección ``regresor'' es un término puramente estructural, sin ninguna connotación causal: decir que \(\boldsymbol{x}\) es un regresor no presupone que \(\boldsymbol{x}\) ``cause'' \(\boldsymbol{y}\), ni ninguna otra relación de tipo teórico. Es, sencillamente, uno de los vectores generadores del plano sobre el que proyectamos. La discusión sobre qué podemos —y qué NO podemos— concluir causalmente a partir de un ajuste como este llegará más adelante, cuando dispongamos de más herramientas con las que plantear esa pregunta con más rigor.
Para profundizar:
- Wooldridge, J. M. (2020), cap. 2, sección 2.1: la terminología habitual (variable dependiente e independiente, regresando y regresor) y sus sinónimos en la literatura.
8. Recapitulación y guiño a la lección siguiente
Qué hemos hecho:
- Generalizado ``proyección sobre una recta'' (lección 4) a ``proyección sobre un plano''.
- La media: el caso con un solo regresor (\(\boldsymbol{1}\)); ahora generalizamos a dos.
- Visto que \(\boldsymbol{1}\) y \(\boldsymbol{x}\) no son ortogonales en general (es decir, normalmente \(\mu_{\boldsymbol{x}}\neq0\)).
- Identificado dos condiciones de ortogonalidad: \(\langle\boldsymbol{\mathop{\widehat{e}}} , \boldsymbol{1}\rangle_s=0\;\) y \(\;\langle\boldsymbol{\mathop{\widehat{e}}} , \boldsymbol{x}\rangle_s=0\).
- Fijado el vocabulario: regresor.
Qué falta (Lección 7):
- Resolver el sistema: fórmulas cerradas para \(\hat\beta_1\) y \(\hat\beta_2\).
``Dos ecuaciones de ortogonalidad, dos incógnitas: solo falta determinarlas.''
Recapitulación y guiño a la lección siguiente
Recapitulemos el camino recorrido en esta lección. Partimos de una pregunta de la lección 4 —¿cuál es la combinación más próxima a nuestros datos \(\boldsymbol{y}\)?— y la generalizamos añadiendo un segundo vector generador, \(\boldsymbol{x}\). Vimos que esto nos lleva de una recta, \(\mathcal{L}(\boldsymbol{1})\), a un plano, \(\mathcal{L}(\boldsymbol{1},\boldsymbol{x})\).
Vimos, con ayuda de la figura de tres vistas, cómo se organiza geométricamente el ajuste: el vector \(\boldsymbol{y}\) (verde) se descompone en dos componentes ortogonales: \(\boldsymbol{\mathop{\widehat{y}}}\) (rojo) en el plano y el vector con los errores de ajuste \(\boldsymbol{\mathop{\widehat{e}}}\) (gris) que es perpendicular a dicho plano. Además, el vector \(\boldsymbol{\mathop{\widehat{y}}}\) (la proyección, roja en la figura) se descompone en sus dos componentes sobre los ejes \(\mathcal{L}(\boldsymbol{1})\) y \(\mathcal{L}(\boldsymbol{x})\) del plano.
Y llegamos al resultado central, que dejamos planteado pero sin resolver: esa perpendicularidad de los residuos \(\boldsymbol{\mathop{\widehat{e}}}\) respecto del plano se traduce en dos condiciones de ortogonalidad simultáneas, \(\langle\boldsymbol{\mathop{\widehat{e}}} , \boldsymbol{1}\rangle_s=0\) y \(\langle\boldsymbol{\mathop{\widehat{e}}} , \boldsymbol{x}\rangle_s=0\) — dos ecuaciones para dos incógnitas, \(\hat\beta_1\) y \(\hat\beta_2\).
En la lección 7 resolveremos explícitamente ese sistema. Veremos que la fórmula que se obtiene para \(\hat\beta_2\) (la pendiente) tiene una lectura muy natural en términos de lo que ya sabemos de la lección 5: guarda una relación directa con la covarianza entre \(\boldsymbol{x}\) e \(\boldsymbol{y}\), y con la correlación \(\rho_{\boldsymbol{x}\boldsymbol{y}}\). Y la fórmula para \(\hat\beta_1\) (la constante) se apoyará, a su vez, en las medias de \(\boldsymbol{x}\) e \(\boldsymbol{y}\) — de manera que, en cierto sentido, todo lo que construimos en las lecciones 4 y 5 sobre medias, varianzas, covarianzas y correlaciones reaparecerá aquí, ahora como ingredientes de un ajuste más rico.
Como siempre, quiero insistir en el punto de partida de esta lección: todo lo que hemos hecho es geometría pura sobre un vector de datos concreto, \(\boldsymbol{y}\), y dos vectores generadores concretos, \(\boldsymbol{1}\) y \(\boldsymbol{x}\). No hemos necesitado hablar de modelos poblacionales, ni de supuestos sobre cómo se generaron los datos, ni de si \(\boldsymbol{x}\) ``causa'' \(\boldsymbol{y}\). Esa discusión —necesaria para poder interpretar el ajuste— llegará más adelante en el curso, cuando dispongamos de las herramientas adecuadas para plantearla con cuidado.
Para profundizar:
- Strang, G. (2016). Introduction to Linear Algebra, cap. 4 (mínimos cuadrados como proyección).
9. Preguntas de repaso (sesión 8) htmlonly
Te propongo 12 preguntas. Las marco con un nivel orientativo: [B] básica, [M] media, [D] discriminadora.
Comentario
Las preguntas 9 y 11 son quizá las más valiosas: obligan al alumno a entender por qué basta la ortogonalidad frente a los generadores para tener ortogonalidad frente a todo el subespacio (9), y a la vez a no sobre-generalizar creyendo que las dos condiciones son ``la misma cosa'' (11). La pregunta 10 merece atención en clase, porque anticipa de forma muy natural el problema de colinealidad sin necesidad de introducir todavía ninguna maquinaria nueva.
Pregunta 1 [B] — El plano \(\mathcal{L}(\boldsymbol{1},\boldsymbol{x})\)
¿Cuál de las siguientes expresiones describe el conjunto \(\mathcal{L}(\boldsymbol{1},\boldsymbol{x})\)?
- Solo los múltiplos de \(\boldsymbol{1}\).
- Solo los múltiplos de \(\boldsymbol{x}\).
- Todas las combinaciones lineales \(\beta_1\boldsymbol{1}+\beta_2\boldsymbol{x}\), con \(\beta_1,\beta_2\in\mathbb{R}\).
- Solo el vector \(\boldsymbol{1}+\boldsymbol{x}\).
Pregunta 2 [B] — Ortogonalidad entre \(\boldsymbol{1}\) y \(\boldsymbol{x}\)
Si \(\mu_{\boldsymbol{x}}\neq0\), ¿qué podemos afirmar sobre \(\boldsymbol{1}\) y \(\boldsymbol{x}\)?
- Que son el mismo vector.
- Que no son ortogonales.
- Que son ortogonales.
- No podemos afirmar nada especial sobre su relación geométrica.
Pregunta 3 [B] — Número de regresores
¿Cuántos regresores tiene el modelo presentado en esta lección?
- Uno.
- Dos.
- Tres.
- Depende del tamaño de la muestra \(n\).
Pregunta 4 [B] — Regresor vs. variable explicativa
Según la distinción introducida en esta lección, si un modelo usa como regresores tanto los años de educación como su cuadrado, ¿cuántas variables explicativas hay?
- Dos: la constante y la educación.
- Una: la educación (entra mediante dos regresores).
- Tres: la constante, la educación y la educación al cuadrado.
- Depende de si el modelo tiene término constante.
Pregunta 5 [M] — Identificación de \(\boldsymbol{\mathop{\widehat{y}}}\)
El vector \(\boldsymbol{\mathop{\widehat{y}}}\) de la figura es:
- El residuo del ajuste.
- La proyección ortogonal de \(\boldsymbol{y}\) sobre \(\mathcal{L}(\boldsymbol{1},\boldsymbol{x})\).
- El vector \(\boldsymbol{x}\) reescalado.
- La media de \(\boldsymbol{y}\).
Pregunta 6 [M] — Generadores alternativos del plano
¿Cuál de las siguientes afirmaciones describe correctamente \(\mathcal{L}(\boldsymbol{1},\boldsymbol{x})=\mathcal{L}(\boldsymbol{1},\boldsymbol{x}-\mu_{\boldsymbol{x}}\boldsymbol{1})\)?
- Es el mismo plano, aunque generado por dos vectores distintos, uno de los cuales sí es ortogonal a \(\boldsymbol{1}\).
- Son dos planos distintos que resulta que contienen los mismos puntos por casualidad.
- Es falso en general; solo se cumple si \(\boldsymbol{x}\) ya es ortogonal a \(\boldsymbol{1}\).
- Es una identidad que solo vale cuando \(n=2\).
Pregunta 7 [M] — Primera condición de ortogonalidad
La condición \(\langle\boldsymbol{\mathop{\widehat{e}}} , \boldsymbol{1}\rangle_s=0\) es equivalente a:
- Que \(\boldsymbol{\mathop{\widehat{e}}}\) sea el vector nulo.
- Que la media de las componentes de \(\boldsymbol{\mathop{\widehat{e}}}\) sea cero.
- Que \(\boldsymbol{\mathop{\widehat{e}}}\) y \(\boldsymbol{x}\) sean ortogonales.
- Que \(\hat\beta_2=0\).
Pregunta 8 [M] — Lectura de la vista cenital
En la vista cenital de la figura (perpendicular al plano de los regresores), ¿qué se aprecia con más claridad?
- Que \(\boldsymbol{\mathop{\widehat{e}}}\) es ortogonal al plano.
- Que los ejes \(\mathcal{L}(\boldsymbol{1})\) y \(\mathcal{L}(\boldsymbol{x})\) no son perpendiculares entre sí.
- El teorema de Pitágoras entre \(\boldsymbol{\mathop{\widehat{y}}}\), \(\boldsymbol{\mathop{\widehat{e}}}\) y \(\boldsymbol{y}\).
- Que \(\boldsymbol{y}\) pertenece al plano de los regresores.
Pregunta 9 [D] — Ortogonalidad frente a los generadores
Si un vector \(\boldsymbol{v}\) es ortogonal tanto a \(\boldsymbol{1}\) como a \(\boldsymbol{x}\), ¿qué podemos concluir sobre su relación con el plano \(\mathcal{L}(\boldsymbol{1},\boldsymbol{x})\)?
- Que \(\boldsymbol{v}\) es ortogonal a cualquier combinación lineal de \(\boldsymbol{1}\) y \(\boldsymbol{x}\), es decir, a todo el plano.
- No podemos concluir nada sin conocer más datos.
- Que \(\boldsymbol{v}\) pertenece al plano.
- Que \(\boldsymbol{v}\) es el vector nulo.
Pregunta 10 [D] — Caso degenerado (colinealidad)
¿Qué ocurre si, en el ajuste de esta lección, \(\boldsymbol{x}\) resulta ser un múltiplo de \(\boldsymbol{1}\) (todos sus datos son idénticos)?
- No cambia nada; los parámetros \(\hat\beta_1\) y \(\hat\beta_2\) siguen siendo únicos.
- \(\mathcal{L}(\boldsymbol{1},\boldsymbol{x})\) colapsa en una recta: no se gana ninguna dirección nueva respecto a \(\mathcal{L}(\boldsymbol{1})\).
- El residuo \(\boldsymbol{\mathop{\widehat{e}}}\) deja de ser ortogonal al plano.
- \(\hat\beta_1\) pasa a ser necesariamente cero.
Pregunta 11 [D] — Independencia de las dos condiciones
¿Por qué, en general, la condición \(\langle\boldsymbol{\mathop{\widehat{e}}} , \boldsymbol{1}\rangle_s=0\) NO garantiza, por sí sola, que también se cumpla \(\langle\boldsymbol{\mathop{\widehat{e}}} , \boldsymbol{x}\rangle_s=0\)?
- Porque ambas condiciones son en realidad la misma ecuación.
- Porque son dos condiciones independientes (una por cada generador del plano); satisfacer una no implica satisfacer la otra.
- Porque \(\boldsymbol{\mathop{\widehat{e}}}\) nunca puede ser ortogonal a \(\boldsymbol{1}\) y a \(\boldsymbol{x}\) simultáneamente.
- Porque \(\boldsymbol{x}\) siempre es ortogonal a \(\boldsymbol{1}\).
Pregunta 12 [D] — Relación con la lección 4
¿Cuál de estas afirmaciones resume mejor la relación entre esta lección y la lección 4?
- La media (lección 4) es el caso particular de este mismo problema de ajuste cuando solo hay un regresor, \(\boldsymbol{1}\).
- No tienen ninguna relación: son problemas geométricos distintos.
- La lección 4 ya resolvía el caso con dos regresores.
- Esta lección sustituye por completo la idea de proyección usada en la lección 4.
10. Respuestas htmlonly
- Pregunta 1 [B] — El plano \(\mathcal{L}(\boldsymbol{1},\boldsymbol{x})\)
Respuesta correcta: 3. Evalúa: reconocimiento de la definición de subespacio generado por dos vectores, generalizando \(\mathcal{L}(\boldsymbol{a})\) de la lección 4.
- Pregunta 2 [B] — Ortogonalidad entre \(\boldsymbol{1}\) y \(\boldsymbol{x}\)
Respuesta correcta: 2. Evalúa: conexión entre \(\mu_{\boldsymbol{x}}=\langle\boldsymbol{x},\boldsymbol{1}\rangle_s\) y la condición de ortogonalidad (producto escalar nulo).
- Pregunta 3 [B] — Número de regresores
Respuesta correcta: 2. Evalúa: identificación de los regresores del modelo (\(\boldsymbol{1}\) y \(\boldsymbol{x}\)).
- Pregunta 4 [B] — Regresor vs. variable explicativa
Respuesta correcta: 2. Evalúa: distinción regresor / variable explicativa.
- Pregunta 5 [M] — Identificación de \(\boldsymbol{\mathop{\widehat{y}}}\)
Respuesta correcta: 2. Evalúa: identificación correcta de \(\boldsymbol{\mathop{\widehat{y}}}\) como el ajuste (la proyección), no como el residuo ni como un escalar.
- Pregunta 6 [M] — Generadores alternativos del plano
Respuesta correcta: 1. Evalúa: comprensión de que un mismo subespacio puede generarse con distintos conjuntos de vectores (aquí, versión ``cruda'' vs. ``centrada'').
- Pregunta 7 [M] — Primera condición de ortogonalidad
Respuesta correcta: 2. Evalúa: conexión entre la condición de ortogonalidad frente a \(\boldsymbol{1}\) y la media nula del residuo, ya vista con la media en la lección 4.
- Pregunta 8 [M] — Lectura de la vista cenital
Respuesta correcta: 2. Evalúa: lectura correcta de las tres vistas de la figura, en particular la vista cenital.
- Pregunta 9 [D] — Ortogonalidad frente a los generadores
Respuesta correcta: 1. Evalúa: comprensión de por qué basta con la ortogonalidad frente a los generadores para garantizar ortogonalidad frente a todo el subespacio.
- Pregunta 10 [D] — Caso degenerado (colinealidad)
Respuesta correcta: 2. Evalúa: anticipación informal del problema de colinealidad (caso degenerado en que los dos generadores no aportan direcciones distintas).
- Pregunta 11 [D] — Independencia de las dos condiciones
Respuesta correcta: 2. Evalúa: comprensión de que, con dos generadores, se necesitan dos condiciones de ortogonalidad independientes, no una sola.
- Pregunta 12 [D] — Relación con la lección 4
Respuesta correcta: 1. Evalúa: visión de conjunto — la regresión simple como generalización directa (no como tema distinto) de la proyección sobre una recta.
Notas al pie de página:
recuerde que en estadística ``/centrar/'' un vector de datos significa restar la media a cada dato.
El ajuste de Mínimos Cuadrados Ordinarios; en inglés OLS (Ordinary Least Squares)
Los vectores \(\boldsymbol{1}\) y \(\boldsymbol{x}\) no están explícitamente representados en la figura para no complicarla más.
y el vector en desviaciones \(\boldsymbol{x}-\mu_{\boldsymbol{x}}\boldsymbol{1}\) tampoco es nulo; recuerde que para que la correlación esté definida, las desviaciones típicas (las normas) que dividen a la covarianza no pueden ser cero.
Siempre y cuando \(\mathcal{L}(\boldsymbol{1},\boldsymbol{x})\) sea un plano.