Lección 6. La regresión lineal simple como ajuste geométrico
Author: Marcos Bujosa
Generalizamos la proyección sobre una recta (la media, lección 4) a la proyección sobre un plano generado por dos vectores: $\boldsymbol{1}$ (de unos) y $\boldsymbol{x}$ (de datos). Todavía seguimos trabajando sin supuestos relacionados con la probabilidad: es el mismo problema geométrico de antes (buscar el vector más próximo a los datos $\boldsymbol{y}$), pero con una dirección de búsqueda adicional. Formalizamos aquí el término regresor (que ya asomó en la lección 3) y dejamos planteada, como tarea para la lección siguiente, la resolución del sistema que determina el ajuste.
``Después de una recta, un plano: la misma pregunta, un vector más.''
De dónde venimos: Proyección ortogonal sobre una recta
- En la lección 4 proyectamos el vector de datos $\boldsymbol{y}$ sobre la recta $\mathcal{L}(\boldsymbol{1})$ buscando el múltiplo de $\boldsymbol{1}$ más próximo. El escalar por el que multiplicar $\boldsymbol{1}$ resultó ser la media.
- La pregunta era geométrica: ¿cuál es el múltiplo de $\boldsymbol{1}$ más cercano a $\boldsymbol{y}$?
En esta lección:
- Hacemos la misma pregunta, pero añadimos una segunda dirección.
- Proyectaremos sobre el plano generado por $\boldsymbol{1}$ y un segundo vector de datos $\boldsymbol{x}$.
Aún no hay variables aleatorias, ni perturbaciones, ni causalidad: sigue siendo pura geometría en $\mathbb{R}^n$.
El plano $\mathcal{L}(\boldsymbol{1},\boldsymbol{x})$
- Un vector generador $\boldsymbol{a}$ $\Rightarrow$ $\mathcal{L}(\boldsymbol{a})$: una recta.
- Dos vectores generadores $\boldsymbol{a},\boldsymbol{b}$ (no alineados) $\Rightarrow$ $\mathcal{L}(\boldsymbol{a},\boldsymbol{b})$: un plano.
Un matiz importante: $\boldsymbol{1}$ y $\boldsymbol{x}$ no son ortogonales
Recordamos de la lección 4: $$ \mu_{\boldsymbol{x}} = \langle\boldsymbol{x},\boldsymbol{1}\rangle_s. $$
Si $\mu_{\boldsymbol{x}}\neq0$ (el caso habitual), entonces $\boldsymbol{1}$ y $\boldsymbol{x}$ no son ortogonales.
Los ejes $\mathcal{L}(\boldsymbol{1})$ y $\mathcal{L}(\boldsymbol{x})$ generalmente se cortan oblicuamente, no en ángulo recto.
El problema de ajuste
Buscamos $\hat\beta_1,\hat\beta_2$ tales que $$ \|\boldsymbol{y}-(\beta_1\boldsymbol{1}+\beta_2\boldsymbol{x})\|_s $$ sea mínima.
$\boldsymbol{\mathop{\widehat{y}}} = \hat\beta_1\boldsymbol{1}+\hat\beta_2\boldsymbol{x} \quad$ (el ajuste: la proyección)
$\boldsymbol{\mathop{\widehat{e}}} = \boldsymbol{y}-\boldsymbol{\mathop{\widehat{y}}} \quad$ (el residuo o vector de residuos del ajuste)
La geometría del ajuste
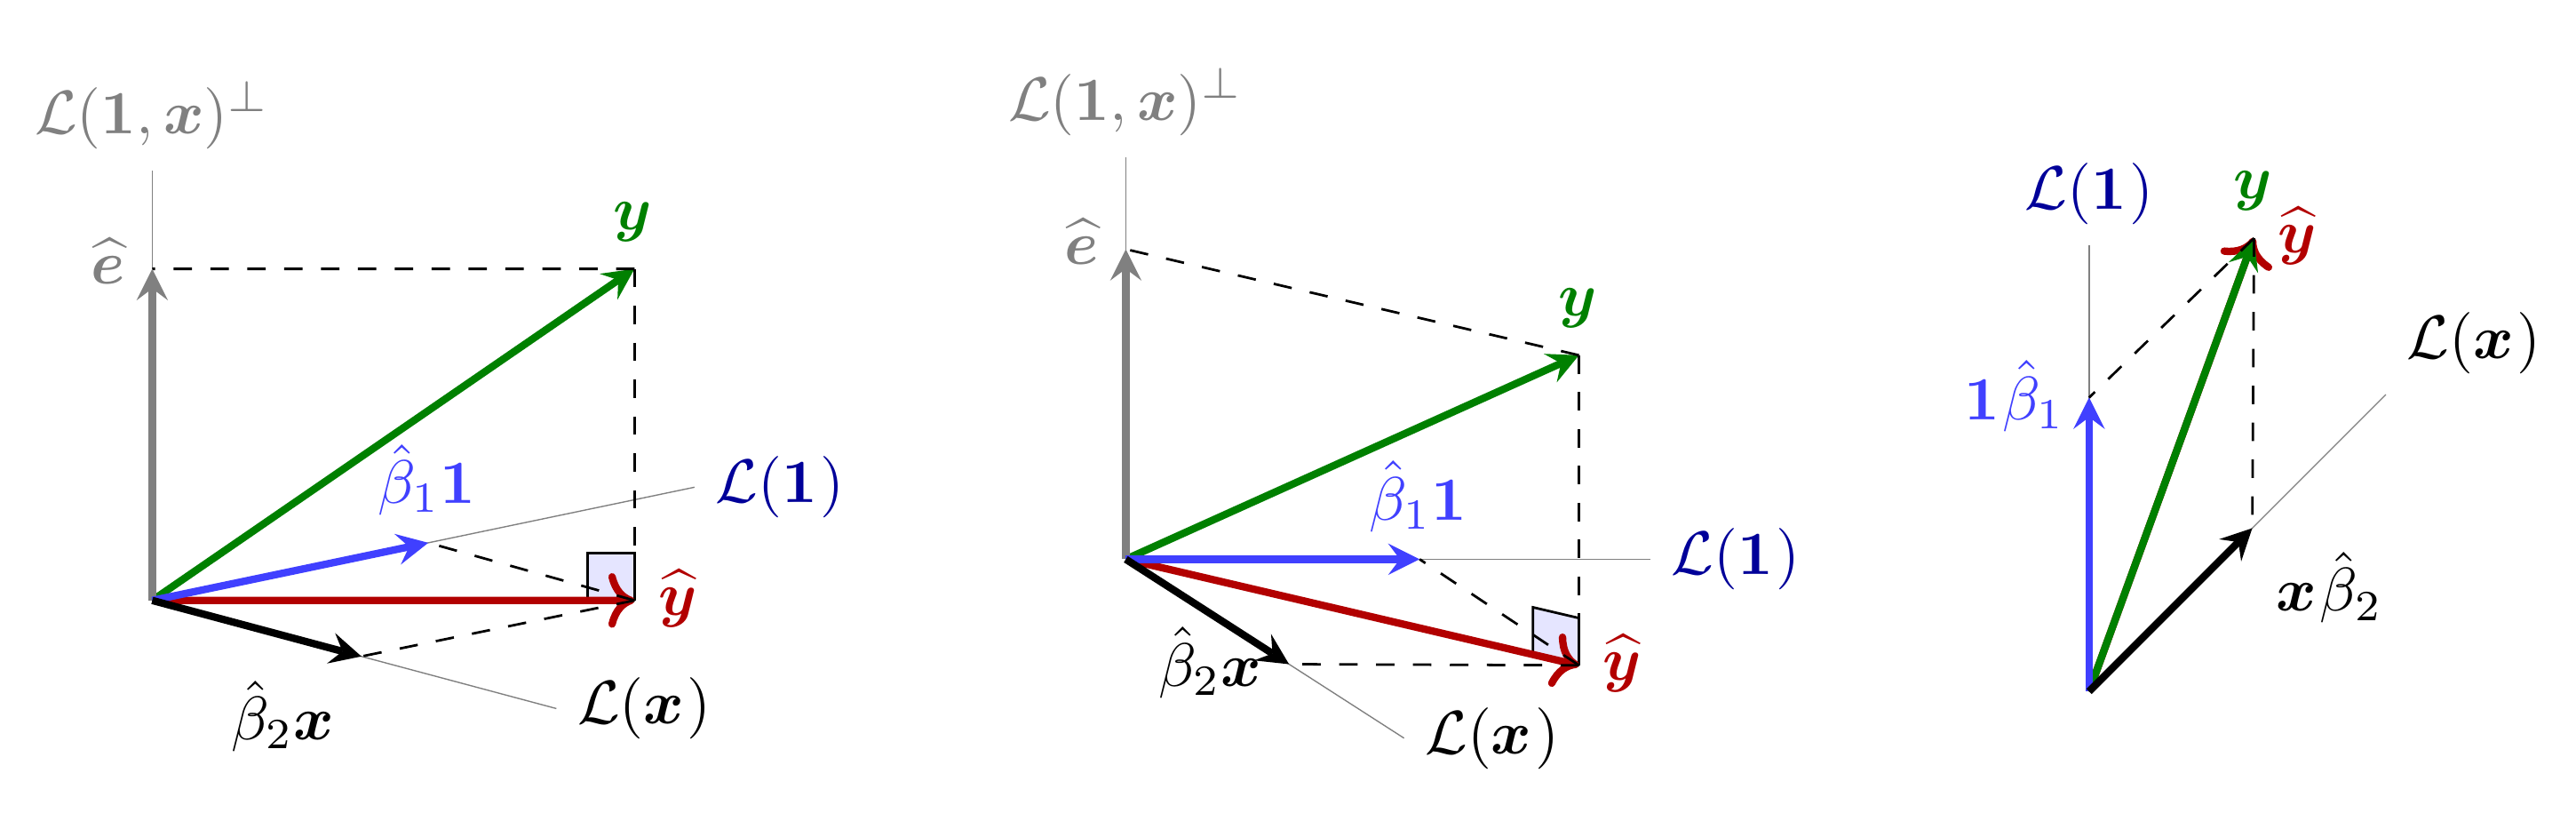
Versión interactiva: cuaderno 2 en MyBinder, parte 1 (el plano, el ajuste y el residuo, rotables).
Lo que la ortogonalidad nos va a dar
$\boldsymbol{\mathop{\widehat{e}}}$ es ortogonal a todo el plano $\mathcal{L}(\boldsymbol{1},\boldsymbol{x})$.
En particular, es ortogonal a cada uno de sus generadores:
$$ \langle\boldsymbol{\mathop{\widehat{e}}},\boldsymbol{1}\rangle_s=0 \qquad (\text{el residuo $\boldsymbol{\mathop{\widehat{e}}}$ tiene media cero}) $$y $$ \langle\boldsymbol{\mathop{\widehat{e}}},\boldsymbol{x}\rangle_s=0 \quad ({\tiny\text{junto con } \langle\boldsymbol{\mathop{\widehat{e}}},\boldsymbol{1}\rangle_s=0}) \implies\boldsymbol{\mathop{\widehat{e}}} \text{ tiene covarianza cero con } \boldsymbol{x}. $$ Dos ecuaciones, dos incógnitas ($\hat\beta_1,\hat\beta_2$)$\ldots$ (la próxima lección resuelve el sistema).
Vocabulario: regresor
Definición (regresor). Llamamos regresor a cada uno de los vectores que entran en la combinación lineal del ajuste (cada vector que multiplica a un coeficiente $\hat\beta_j$).$\mbox{ }$
En la regresión lineal simple hay dos regresores: $\boldsymbol{1}$ y $\boldsymbol{x}$.
(Postponemos deliberadamente el término ``variable explicativa'': ese término trae consigo un matiz causal que aún no estamos en condiciones de justificar.)
Recapitulación y guiño a la lección siguiente
Qué hemos hecho:
- Generalizado ``proyección sobre una recta'' (lección 4) a ``proyección sobre un plano''.
- La media: el caso con un solo regresor ($\boldsymbol{1}$); ahora generalizamos a dos.
- Visto que $\boldsymbol{1}$ y $\boldsymbol{x}$ no son ortogonales en general (es decir, normalmente $\mu_{\boldsymbol{x}}\neq0$).
- Identificado dos condiciones de ortogonalidad: $\langle\boldsymbol{\mathop{\widehat{e}}} , \boldsymbol{1}\rangle_s=0\;$ y $\;\langle\boldsymbol{\mathop{\widehat{e}}} , \boldsymbol{x}\rangle_s=0$.
- Fijado el vocabulario: regresor.
Qué falta (Lección 7):
- Resolver el sistema: fórmulas cerradas para $\hat\beta_1$ y $\hat\beta_2$.
``Dos ecuaciones de ortogonalidad, dos incógnitas: solo falta determinarlas.''