Sesión 16 (C) — Dos sorpresas: lo que no hace falta suponer y lo que sí
Índice
- Descripción de la práctica
- Actividad 1 - Tres perturbaciones muy distintas, la misma esperanza y la misma varianza
- Actividad 2 - La forma sí depende de la distribución de \(U\)
- Actividad 3 - Forzar la ortogonalidad exactamente
- Preguntas de interpretación para la clase
- Código completo de la práctica
- Respuestas
Descripción de la práctica
Cerramos la sesión con tres experimentos que responden a dos preguntas.
La primera se planteó al final de la práctica A (actividad 5 (html)): el histograma de \(\hat\beta_2\) tenía forma de campana, y dijimos que no debíamos sacar conclusiones de ello porque habíamos impuesto esa forma al generar las perturbaciones con una normal. Ahora lo comprobamos: ¿qué ocurre si las generamos con distribuciones muy alejadas de la normal?
La segunda es más antigua. En el ejemplo de juguete de la lección 7, aquel \(\boldsymbol u=(1,-2,0,2,-1)\), MCO recuperaba los coeficientes verdaderos exactamente, y advertimos que era una casualidad de diseño. La lección 11 explicó por qué: porque \(\hat\beta_2=\beta_2\,\mathit 1+\sum_iW_iU_i\), y aquel \(\boldsymbol u\) estaba construido para que ese segundo término, evaluado sobre los datos (\(\sum_iw_iu_i\)), se anulase. Vamos a fabricar esa casualidad a propósito, miles de veces seguidas, y ver qué le ocurre al histograma.
Objetivos
- Comprobar que la insesgadez y la fórmula de la varianza se cumplen con perturbaciones uniformes y con perturbaciones muy asimétricas, igual que con perturbaciones normales.
- Entender por qué eso tenía que ocurrir: repasar la demostración de la lección 11 y localizar en qué paso se usa la distribución de \(U\) (en ninguno).
- Ver que la forma de la distribución de \(\hat\beta_2\), en cambio, sí depende de la distribución de \(U\), y averiguar qué papel juegan, además, el tamaño muestral y el diseño del regresor, separando un efecto del otro.
- Forzar a la muestra de perturbaciones a ser exactamente ortogonal al regresor, no solo en esperanza, y observar el resultado.
- Dejar planteada, con datos delante, la pregunta que abre la lección 12.
Comandos nuevos de esta práctica. Seguimos con el aparato de las prácticas A (actividad 3 (html)) y B (actividad 1 (html)): mundo artificial, loop --progressive, store, apertura del fichero de réplicas con open "@workdir/…" justo antes de cada bloque que calcula sobre ellas, y smpl 12 --random. Lo nuevo:
randgen(X, k)- serie de sorteos de una distribución chi-cuadrado con
kgrados de libertad; la letra del primer argumento indica la distribución (Xes la chi-cuadrado). uniform(0,1)reescalada-a + 2*a*uniform(0,1)convierte un sorteo uniforme en \([0,1]\) en uno uniforme en \([-a,a]\).series x = 6yx[1] = 14- la primera da el valor 6 a todas las observaciones; la segunda cambia solo la primera:
x[1]es la observación número 1 de la seriex. $uhat- los residuos de la última regresión estimada (actividad 2 (html) de la práctica A de la sesión 11).
%10.2f,%8.3f- en
printf, un número con dos (o tres) decimales dentro de un campo de diez (u ocho) caracteres, para que las columnas queden alineadas.
Actividad 1 - Tres perturbaciones muy distintas, la misma esperanza y la misma varianza
Vamos a repetir el experimento de la práctica A (actividad 3 (html)) tres veces en paralelo, cambiando únicamente cómo se sortea la perturbación. Las tres tendrán esperanza cero y varianza \(\sigma^2\); en todo lo demás son muy diferentes:
- Normal: la de la práctica A, simétrica y con colas ligeras.
- Uniforme: simétrica también, pero sin colas en absoluto; todos los valores de un intervalo son igual de probables. Para que su varianza sea \(\sigma^2\) hay que tomar el intervalo \([-\sigma\sqrt3,\;\sigma\sqrt3]\).
- Chi-cuadrado centrada: marcadamente asimétrica. Una \(\chi^2\) con 4 grados de libertad tiene esperanza 4 y varianza 8; restándole su esperanza y dividiendo por \(\sqrt8\) queda con esperanza cero y varianza uno, y basta multiplicar por \(\sigma\).
Un solo bucle que hace tres experimentos por vuelta. Antes del bucle: el mundo artificial de la práctica A (actividad 1 (html)) y a_unif, la semiamplitud del intervalo de la uniforme. Dentro, tres perturbaciones: la normal, como en la práctica A; la uniforme, -a_unif + 2*a_unif*uniform(0,1), un sorteo en \([0,1]\) reescalado al intervalo \([-a,a]\); y la chi-cuadrado, randgen(X,4), a la que se resta su esperanza \(4\), se divide por su desviación típica \(\sqrt8\) y se multiplica por sigma. Cada perturbación da su regresando, su regresión y su coeficiente, y store guarda los tres por réplica en repC.gdt.
en línea de comandos:
open hprice2.gdt --quiet
ols price const rooms --quiet
scalar b1_true = $coeff(const)
scalar b2_true = $coeff(rooms)
scalar sigma   = sqrt($ess/$df)
scalar Sxx     = sum((rooms-mean(rooms))^2)
scalar var_teo = sigma^2 / Sxx
scalar a_unif  = sigma*sqrt(3)          # semiamplitud de la uniforme

scalar R = 2000
set seed 20261030
loop R --progressive --quiet
    series u_nor = normal(0, sigma)
    series y1 = b1_true + b2_true*rooms + u_nor
    ols y1 const rooms --quiet
    scalar b_nor = $coeff(rooms)

    series u_uni = -a_unif + 2*a_unif*uniform(0,1)
    series y2 = b1_true + b2_true*rooms + u_uni
    ols y2 const rooms --quiet
    scalar b_uni = $coeff(rooms)

    series u_chi = (randgen(X,4) - 4)/sqrt(8) * sigma
    series y3 = b1_true + b2_true*rooms + u_chi
    ols y3 const rooms --quiet
    scalar b_chi = $coeff(rooms)

    store "@workdir/repC.gdt" b_nor b_uni b_chi
endloop
Los tres bloques siguientes imprimen la teoría, con los escalares aún disponibles; abren repC.gdt (AbrirRepC); e imprimen la media y la varianza (divisor \(n\)) de las tres series de estimaciones. Los formatos %10.2f y %12.2f reservan campos de anchura fija para que las columnas queden alineadas.
y ahora comparamos los tres casos con lo que predice la lección 11:
printf "=== LO QUE PREDICE LA LECCION 11 ===\n"
printf "beta_2     = %.4f\n", b2_true
printf "Var[b2|X]  = %.2f   (desv. tipica %.2f)\n\n", var_teo, sqrt(var_teo)
=== LO QUE PREDICE LA LECCION 11 ===
beta_2     = 9119,5484
Var[b2|X]  = 175844,80   (desv. tipica 419,34)
open "@workdir/repC.gdt" --quiet
printf "=== LO QUE SALE DE %d REPLICAS, SEGUN COMO SEA LA PERTURBACION ===\n", $nobs
printf "perturbacion normal    : media = %10.2f    varianza = %12.2f\n", mean(b_nor), sum((b_nor-mean(b_nor))^2)/$nobs
printf "perturbacion uniforme  : media = %10.2f    varianza = %12.2f\n", mean(b_uni), sum((b_uni-mean(b_uni))^2)/$nobs
printf "perturbacion chi2(4)   : media = %10.2f    varianza = %12.2f\n", mean(b_chi), sum((b_chi-mean(b_chi))^2)/$nobs
=== LO QUE SALE DE 2000 REPLICAS, SEGUN COMO SEA LA PERTURBACION ===
perturbacion normal    : media =    9130,35    varianza =    178188,26
perturbacion uniforme  : media =    9125,71    varianza =    170057,83
perturbacion chi2(4)   : media =    9118,59    varianza =    178413,11
Lo que debe observar
Las tres medias quedan cerca de \(\beta_2\) y las tres varianzas cerca de \(\sigma^2/\mathrm{Sxx}\). Cambiar radicalmente la distribución de la perturbación (de simétrica con colas a simétrica sin colas, y de ahí a marcadamente asimétrica) no cambia ni el valor esperado ni la varianza.
Es lo que la lección 11 demostró. Merece la pena volver sobre aquella demostración y comprobar qué se usó en cada paso.
- Para la insesgadez se usó \(E[U_i\mid\boldsymbol X]=\mathit 0\) (exogeneidad estricta) y el lema para sacar los \(W_i\) fuera de la esperanza condicionada.
- Para la varianza se usó, además, \(Var[U_i\mid\boldsymbol X]=\sigma^2\,\mathit 1\) (homocedasticidad) y \(Cov[U_i,U_j\mid\boldsymbol X]=\mathit 0\) para \(i\neq j\).
En ningún punto se dijo qué distribución tiene \(U\). Solo se usaron su esperanza condicional, su varianza condicional y la ausencia de covarianzas cruzadas. Y esas tres condiciones las cumplen por igual una normal, una uniforme y una chi-cuadrado centrada. La demostración era más general de lo que parecía.
Actividad 2 - La forma sí depende de la distribución de \(U\)
Que el valor esperado y la varianza no dependan de la distribución de \(U\) no significa que nada dependa de ella. Veamos los histogramas. freq b_chi --normal dibuja, como en la práctica A (actividad 5 (html)), el histograma de las estimaciones obtenidas con perturbación chi-cuadrado, con la normal superpuesta y el contraste de normalidad.
en línea de comandos:
freq b_chi --normal
Distribución de frecuencias para b_chi, observaciones 1-2000
número de cajas = 29, Media = 9118,59, Desv.típ.=422,495

      intervalo     punto medio   frecuencia  rel     acum.

           < 7771,7    7721,3         2      0,10%    0,10%
    7771,7 - 7872,3    7822,0         1      0,05%    0,15%
    7872,3 - 7973,0    7922,7         2      0,10%    0,25%
    7973,0 - 8073,7    8023,4         9      0,45%    0,70%
    8073,7 - 8174,4    8124,0        12      0,60%    1,30%
    8174,4 - 8275,1    8224,7        19      0,95%    2,25%
    8275,1 - 8375,7    8325,4        36      1,80%    4,05%
    8375,7 - 8476,4    8426,1        43      2,15%    6,20%
    8476,4 - 8577,1    8526,8        70      3,50%    9,70% *
    8577,1 - 8677,8    8627,4       103      5,15%   14,85% *
    8677,8 - 8778,5    8728,1       137      6,85%   21,70% **
    8778,5 - 8879,1    8828,8       144      7,20%   28,90% **
    8879,1 - 8979,8    8929,5       159      7,95%   36,85% **
    8979,8 - 9080,5    9030,1       189      9,45%   46,30% ***
    9080,5 - 9181,2    9130,8       205     10,25%   56,55% ***
    9181,2 - 9281,8    9231,5       172      8,60%   65,15% ***
    9281,8 - 9382,5    9332,2       161      8,05%   73,20% **
    9382,5 - 9483,2    9432,9       140      7,00%   80,20% **
    9483,2 - 9583,9    9533,5       127      6,35%   86,55% **
    9583,9 - 9684,6    9634,2        92      4,60%   91,15% *
    9684,6 - 9785,2    9734,9        65      3,25%   94,40% *
    9785,2 - 9885,9    9835,6        40      2,00%   96,40%
    9885,9 - 9986,6    9936,3        31      1,55%   97,95%
    9986,6 - 10087,    10037,        13      0,65%   98,60%
    10087, - 10188,    10138,        18      0,90%   99,50%
    10188, - 10289,    10238,         5      0,25%   99,75%
    10289, - 10389,    10339,         4      0,20%   99,95%
    10389, - 10490,    10440,         0      0,00%   99,95%
          >= 10490,    10540,         1      0,05%  100,00%

Contraste de la hipótesis nula de distribución Normal:
Chi-cuadrado(2) = 0,230 con valor p 0,89142
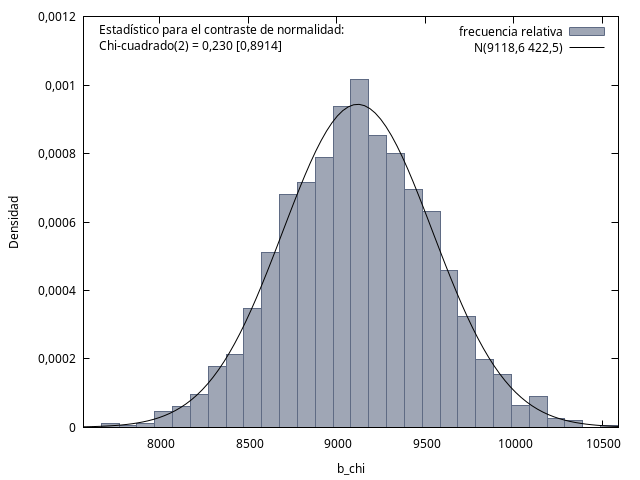
Figura 1: Distribución de \(\hat\beta_2\) con perturbaciones \(\chi^2\) (asimétricas) y \(n=506\).
Con las 506 observaciones de hprice2, el histograma de \(\hat\beta_2\) sigue pareciendo una campana aunque las perturbaciones sean muy asimétricas.
Antes de sacar conclusiones, probemos con una muestra pequeña y una asimetría mayor: doce viviendas y perturbaciones \(\chi^2\) con un grado de libertad.
Cuatro bloques, y un quinto para el histograma. El primero reabre hprice2, recupera los parámetros y se queda con doce viviendas: con set seed 160 y smpl 12 --random, las mismas doce de la práctica B (actividad 1 (html)). El segundo es el bucle: 4000 réplicas con una perturbación chi-cuadrado de un grado de libertad, centrada (se le resta su esperanza, \(1\)) y reescalada (se divide por su desviación típica, \(\sqrt2\), y se multiplica por sigma), guardando b_peq. El tercero, AbrirRepCpeq, abre repCpeq.gdt, y el cuarto calcula la media, la desviación típica y el coeficiente de asimetría escrito con sumas: la media de los cubos de las desviaciones dividida por el cubo de la desviación típica. El quinto, freq b_peq --normal, dibuja el histograma e imprime la tabla de frecuencias y el contraste de normalidad.
en línea de comandos:
open hprice2.gdt --quiet
ols price const rooms --quiet
scalar b1_true = $coeff(const)
scalar b2_true = $coeff(rooms)
scalar sigma   = sqrt($ess/$df)

set seed 160
smpl 12 --random
set seed 99
loop 4000 --progressive --quiet
    series u_p = (randgen(X,1) - 1)/sqrt(2) * sigma     # chi2 con 1 g.l., muy asimetrica
    series y_p = b1_true + b2_true*rooms + u_p
    ols y_p const rooms --quiet
    scalar b_peq = $coeff(rooms)
    store "@workdir/repCpeq.gdt" b_peq
endloop
open "@workdir/repCpeq.gdt" --quiet
scalar m_p = mean(b_peq)
scalar s_p = sqrt(sum((b_peq-m_p)^2)/$nobs)
printf "n = 12, perturbacion chi2 con 1 g.l.\n"
printf "  media     = %.1f\n", m_p
printf "  varianza  = %.1f\n", s_p^2
printf "  asimetria = %.3f\n", (sum((b_peq-m_p)^3)/$nobs)/s_p^3
n = 12, perturbacion chi2 con 1 g.l.
  media     = 9208,6
  varianza  = 12853823,5
  asimetria = -0,082
freq b_peq --normal
Distribución de frecuencias para b_peq, observaciones 1-4000
número de cajas = 29, Media = 9208,57, Desv.típ.=3585,67

      intervalo     punto medio   frecuencia  rel     acum.

           < -7504,5   -8144,9        1      0,03%    0,03%
   -7504,5 - -6223,7   -6864,1        2      0,05%    0,08%
   -6223,7 - -4942,9   -5583,3        1      0,03%    0,10%
   -4942,9 - -3662,1   -4302,5        4      0,10%    0,20%
   -3662,1 - -2381,3   -3021,7        4      0,10%    0,30%
   -2381,3 - -1100,5   -1740,9       13      0,33%    0,62%
   -1100,5 -  180,35   -460,06       26      0,65%    1,27%
    180,35 -  1461,2    820,75       32      0,80%    2,08%
    1461,2 -  2742,0    2101,6       83      2,08%    4,15%
    2742,0 -  4022,8    3382,4      120      3,00%    7,15% *
    4022,8 -  5303,6    4663,2      186      4,65%   11,80% *
    5303,6 -  6584,4    5944,0      326      8,15%   19,95% **
    6584,4 -  7865,2    7224,8      477     11,93%   31,88% ****
    7865,2 -  9146,0    8505,6      678     16,95%   48,83% ******
    9146,0 -  10427,    9786,5      660     16,50%   65,33% *****
    10427, -  11708,    11067,      543     13,57%   78,90% ****
    11708, -  12988,    12348,      324      8,10%   87,00% **
    12988, -  14269,    13629,      249      6,22%   93,22% **
    14269, -  15550,    14910,      126      3,15%   96,38% *
    15550, -  16831,    16191,       67      1,68%   98,05%
    16831, -  18112,    17471,       37      0,93%   98,97%
    18112, -  19393,    18752,       14      0,35%   99,32%
    19393, -  20673,    20033,       10      0,25%   99,57%
    20673, -  21954,    21314,       11      0,28%   99,85%
    21954, -  23235,    22595,        3      0,07%   99,92%
    23235, -  24516,    23875,        1      0,03%   99,95%
    24516, -  25797,    25156,        1      0,03%   99,98%
    25797, -  27077,    26437,        0      0,00%   99,98%
          >=  27077,    27718,        1      0,03%  100,00%

Contraste de la hipótesis nula de distribución Normal:
Chi-cuadrado(2) = 243,019 con valor p 0,00000
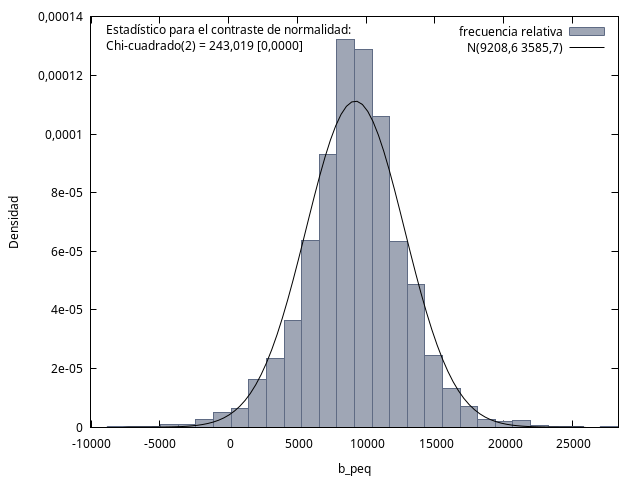
Figura 2: Distribución de \(\hat\beta_2\) con perturbaciones \(\chi^2\) de un grado de libertad y solo \(n=12\). Sigue pareciendo simétrica.
Por qué el histograma sigue siendo simétrico
Aunque la perturbación es muy asimétrica y la muestra es muy pequeña, el histograma de \(\hat\beta_2\) sigue pareciendo simétrico, y el coeficiente de asimetría que acabamos de calcular sale prácticamente nulo. (El contraste de normalidad de freq --normal sí rechaza, pero lo hace por las colas, la curtosis, no por la asimetría.)
La explicación está, una vez más, en la fórmula de la lección 11: \[ \hat\beta_2=\beta_2\,\mathit 1+\sum_iW_iU_i,\qquad W_i\ \text{proporcional a}\ (X_i-\overline{X}). \] Los pesos \(W_i\) son proporcionales a las desviaciones del regresor respecto a su media, y esas desviaciones son negativas para aproximadamente la mitad de las observaciones. Así que \(\sum_iW_iU_i\) suma perturbaciones asimétricas hacia la derecha con peso positivo y perturbaciones asimétricas hacia la derecha con peso negativo, que al cambiarles el signo quedan asimétricas hacia la izquierda. Las dos asimetrías se compensan en buena medida, y el resultado sale casi simétrico.
¿Perturbación o regresor?
Hay dos causas posibles y todavía no las hemos separado. Cuando el histograma salga asimétrico, ¿será por la distribución de la perturbación o por la del regresor?
Para separarlos hace falta cambiar una cosa cada vez. Montamos los cuatro experimentos que resultan de combinar dos perturbaciones (normal y \(\chi^2\) con un grado de libertad) con dos regresores: uno equilibrado (las mismas doce viviendas reales de la práctica B) y otro con una observación dominante, en el que once viviendas comparten el mismo valor y una toma un valor muy alejado de ellas.
Cuatro bloques. El primero recupera las mismas doce viviendas y define los dos regresores: x_eq es una copia de rooms; series x_pal = 6 da el valor 6 a las doce observaciones y x_pal[1] = 14 cambia solo la primera. El segundo es un bucle de 8000 vueltas con dos perturbaciones por réplica, normal y chi-cuadrado de un grado de libertad, y cuatro regresiones, una por cada combinación de perturbación y regresor; store guarda los cuatro coeficientes en repDD.gdt. El tercero, AbrirRepDD, abre ese fichero, y el cuarto calcula la media y la desviación típica de cada serie y la tabla de asimetrías, con %8.3f para alinear las columnas.
en línea de comandos:
open hprice2.gdt --quiet
ols price const rooms --quiet
scalar b1_true = $coeff(const)
scalar b2_true = $coeff(rooms)
scalar sigma   = sqrt($ess/$df)

set seed 160
smpl 12 --random            # las mismas doce viviendas de antes
series x_eq  = rooms        # regresor equilibrado: las doce viviendas
series x_pal = 6            # regresor con una observacion dominante:
x_pal[1]     = 14           #   once iguales y una que se sale
set seed 99
loop 8000 --progressive --quiet
    series u_nor = normal(0, sigma)                     # perturbacion normal
    series u_chi = (randgen(X,1) - 1)/sqrt(2) * sigma   # perturbacion chi2(1)

    series y1 = b1_true + b2_true*x_eq + u_nor
    ols y1 const x_eq --quiet
    scalar eq_nor = $coeff(x_eq)

    series y2 = b1_true + b2_true*x_pal + u_nor
    ols y2 const x_pal --quiet
    scalar pal_nor = $coeff(x_pal)

    series y3 = b1_true + b2_true*x_eq + u_chi
    ols y3 const x_eq --quiet
    scalar eq_chi = $coeff(x_eq)

    series y4 = b1_true + b2_true*x_pal + u_chi
    ols y4 const x_pal --quiet
    scalar pal_chi = $coeff(x_pal)

    store "@workdir/repDD.gdt" eq_nor pal_nor eq_chi pal_chi
endloop
open "@workdir/repDD.gdt" --quiet
scalar m1 = mean(eq_nor)
scalar s1 = sqrt(sum((eq_nor-m1)^2)/$nobs)
scalar m2 = mean(pal_nor)
scalar s2 = sqrt(sum((pal_nor-m2)^2)/$nobs)
scalar m3 = mean(eq_chi)
scalar s3 = sqrt(sum((eq_chi-m3)^2)/$nobs)
scalar m4 = mean(pal_chi)
scalar s4 = sqrt(sum((pal_chi-m4)^2)/$nobs)

printf "ASIMETRIA DE b2 ESTIMADO      regresor equilibrado   regresor con palanca\n"
printf "perturbacion NORMAL                %8.3f               %8.3f\n", (sum((eq_nor-m1)^3)/$nobs)/s1^3,  (sum((pal_nor-m2)^3)/$nobs)/s2^3
printf "perturbacion CHI2(1)               %8.3f               %8.3f\n", (sum((eq_chi-m3)^3)/$nobs)/s3^3,  (sum((pal_chi-m4)^3)/$nobs)/s4^3
ASIMETRIA DE b2 ESTIMADO      regresor equilibrado   regresor con palanca
perturbacion NORMAL                   0,024                  0,032
perturbacion CHI2(1)                 -0,070                  2,460
Y los dos histogramas de la columna de la derecha, los dos con el regresor de observación dominante, que es donde cabría esperar la asimetría:
freq pal_nor --normal
freq pal_chi --normal
Distribución de frecuencias para pal_nor, observaciones 1-8000
número de cajas = 29, Media = 9110,93, Desv.típ.=858,896

      intervalo     punto medio   frecuencia  rel     acum.

           < 6213,5    6101,2         1      0,01%    0,01%
    6213,5 - 6438,1    6325,8         3      0,04%    0,05%
    6438,1 - 6662,7    6550,4        18      0,23%    0,28%
    6662,7 - 6887,2    6774,9        18      0,23%    0,50%
    6887,2 - 7111,8    6999,5        33      0,41%    0,91%
    7111,8 - 7336,4    7224,1        71      0,89%    1,80%
    7336,4 - 7561,0    7448,7       138      1,73%    3,52%
    7561,0 - 7785,5    7673,2       201      2,51%    6,04%
    7785,5 - 8010,1    7897,8       300      3,75%    9,79% *
    8010,1 - 8234,7    8122,4       434      5,42%   15,21% *
    8234,7 - 8459,2    8347,0       576      7,20%   22,41% **
    8459,2 - 8683,8    8571,5       691      8,64%   31,05% ***
    8683,8 - 8908,4    8796,1       794      9,93%   40,97% ***
    8908,4 - 9133,0    9020,7       816     10,20%   51,17% ***
    9133,0 - 9357,5    9245,3       833     10,41%   61,59% ***
    9357,5 - 9582,1    9469,8       718      8,97%   70,56% ***
    9582,1 - 9806,7    9694,4       694      8,68%   79,24% ***
    9806,7 - 10031,    9919,0       530      6,62%   85,86% **
    10031, - 10256,    10144,       399      4,99%   90,85% *
    10256, - 10480,    10368,       295      3,69%   94,54% *
    10480, - 10705,    10593,       175      2,19%   96,72%
    10705, - 10930,    10817,       106      1,32%   98,05%
    10930, - 11154,    11042,        84      1,05%   99,10%
    11154, - 11379,    11266,        36      0,45%   99,55%
    11379, - 11603,    11491,        17      0,21%   99,76%
    11603, - 11828,    11716,        11      0,14%   99,90%
    11828, - 12052,    11940,         2      0,03%   99,93%
    12052, - 12277,    12165,         5      0,06%   99,99%
          >= 12277,    12389,         1      0,01%  100,00%

Contraste de la hipótesis nula de distribución Normal:
Chi-cuadrado(2) = 1,511 con valor p 0,46985


Distribución de frecuencias para pal_chi, observaciones 1-8000
número de cajas = 29, Media = 9115,8, Desv.típ.=850,548

      intervalo     punto medio   frecuencia  rel     acum.

           < 7445,1    7256,8         4      0,05%    0,05%
    7445,1 - 7821,7    7633,4        25      0,31%    0,36%
    7821,7 - 8198,3    8010,0       252      3,15%    3,51% *
    8198,3 - 8574,9    8386,6      1425     17,81%   21,32% ******
    8574,9 - 8951,6    8763,2      2736     34,20%   55,53% ************
    8951,6 - 9328,2    9139,9      1498     18,73%   74,25% ******
    9328,2 - 9704,8    9516,5       750      9,38%   83,62% ***
    9704,8 - 10081,    9893,1       436      5,45%   89,08% *
    10081, - 10458,    10270,       326      4,08%   93,15% *
    10458, - 10835,    10646,       174      2,17%   95,33%
    10835, - 11211,    11023,       127      1,59%   96,91%
    11211, - 11588,    11400,        71      0,89%   97,80%
    11588, - 11964,    11776,        62      0,78%   98,58%
    11964, - 12341,    12153,        44      0,55%   99,13%
    12341, - 12718,    12529,        13      0,16%   99,29%
    12718, - 13094,    12906,        18      0,23%   99,51%
    13094, - 13471,    13283,        15      0,19%   99,70%
    13471, - 13848,    13659,         3      0,04%   99,74%
    13848, - 14224,    14036,         4      0,05%   99,79%
    14224, - 14601,    14412,         5      0,06%   99,85%
    14601, - 14977,    14789,         3      0,04%   99,89%
    14977, - 15354,    15166,         3      0,04%   99,92%
    15354, - 15731,    15542,         1      0,01%   99,94%
    15731, - 16107,    15919,         3      0,04%   99,97%
    16107, - 16484,    16296,         0      0,00%   99,97%
    16484, - 16860,    16672,         0      0,00%   99,97%
    16860, - 17237,    17049,         0      0,00%   99,97%
    17237, - 17614,    17425,         1      0,01%   99,99%
          >= 17614,    17802,         1      0,01%  100,00%

Contraste de la hipótesis nula de distribución Normal:
Chi-cuadrado(2) = 7609,261 con valor p 0,00000
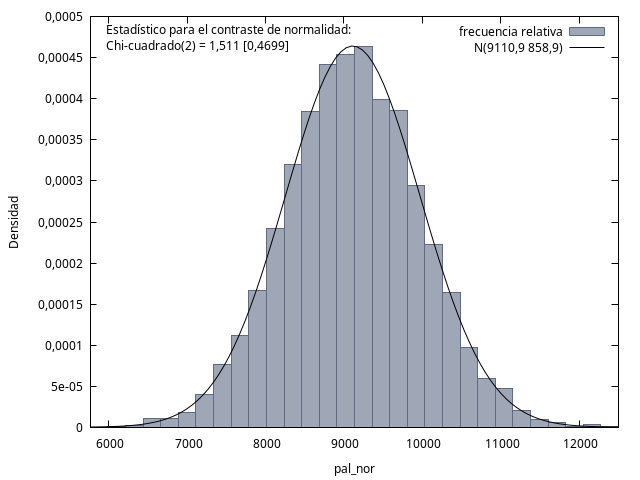
Figura 3: Regresor con observación dominante y perturbación normal: \(\hat\beta_2\) sale simétrico.
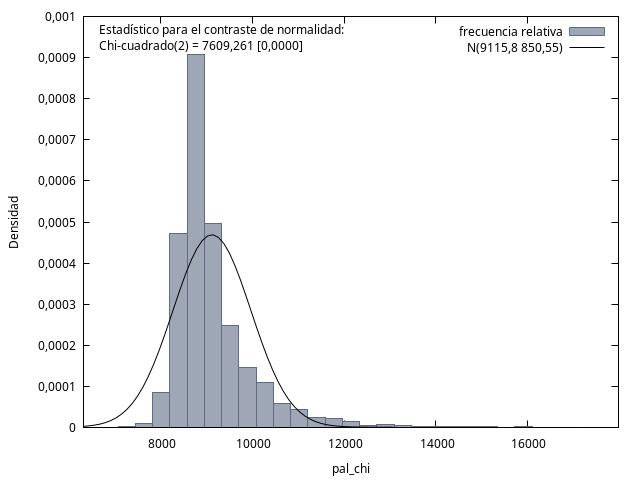
Figura 4: El mismo regresor, con perturbación \(\chi^2\) de un grado de libertad: ahora \(\hat\beta_2\) hereda la asimetría.
Lo que debe observar
Lea la tabla por filas, que es donde está la respuesta:
- Fila de arriba (perturbación normal): la asimetría es prácticamente nula en las DOS columnas. Por muy desequilibrado que sea el regresor, con perturbaciones normales \(\hat\beta_2\) sale simétrico.
- Fila de abajo (perturbación \(\chi^2\)): la asimetría es pequeña con el regresor equilibrado y grande con el de observación dominante.
De ahí la respuesta a la pregunta del epígrafe:
La asimetría procede de la distribución de la perturbación. El regresor no la crea: solo determina cuánta se conserva.
Que el regresor no pueda crearla se ve en la fórmula de la lección 11. En estos cuatro experimentos el regresor lo hemos fijado nosotros (x_eq y x_pal se construyen una vez y no vuelven a tocarse dentro del bucle), de modo que los pesos son números: son los \(w_i\) de la lección 7, proporcionales a \((x_i-\mu_{\boldsymbol x})\). Y entonces
\[
\hat\beta_2=\beta_2\,\mathit 1+\sum_iw_iU_i
\]
es, ahora sí, una auténtica combinación lineal de las perturbaciones, con coeficientes que son números.1 Si esas perturbaciones son normales, cualquier combinación lineal suya vuelve a ser normal, sean cuales sean los pesos. Por eso la fila de arriba es prácticamente nula: el diseño del regresor no puede introducir asimetría.
Lo que el regresor sí controla es cuánta de la asimetría de \(U\) llega al resultado. Con pesos repartidos, la suma mezcla muchas perturbaciones y sus asimetrías se compensan; con un peso que domina a los demás, \(\hat\beta_2\approx\beta_2\,\mathit1+w_1U_1\) (fijado el regresor, el peso es el número \(w_1\)) y el estimador reproduce casi exactamente la forma de una sola perturbación.
Recapitulando las dos preguntas
Conviene no confundir lo que hemos establecido con lo que solo hemos observado:
| Propiedad de \(\hat\beta_2\) | ¿Depende de la distribución de \(U\)? | ¿Depende del regresor? |
|---|---|---|
| Valor esperado (insesgadez) | No | No |
| Varianza | No | Sí (a través de Sxx) |
| Forma | Sí | Solo en qué medida |
Las dos primeras filas están demostradas en la lección 11 y verificadas en la Actividad 1. La tercera es lo que acabamos de explorar experimentalmente, y es también la razón por la que la lección 11 se detuvo en el valor esperado y la varianza: demostró exactamente lo que se podía demostrar sin suponer nada sobre la distribución de \(U\). Todo lo que dependa de la forma, y los intervalos de confianza y los contrastes de hipótesis dependen de ella, exige un supuesto adicional. Ese supuesto, y lo que se puede hacer con él, es el asunto de la lección 12.
Una observación. Habrá notado una regularidad: la asimetría se atenúa cuando hay muchas observaciones, o cuando ninguna domina. Hay un resultado general detrás de ese comportamiento, y explica por qué la econometría aplicada puede a menudo prescindir de supuestos sobre la distribución de \(U\). No lo vamos a abordar aquí: anótelo como pregunta pendiente para la próxima lección.
Actividad 3 - Forzar la ortogonalidad exactamente
Tanto los supuestos del modelo como el corolario de la exogeneidad se enuncian en esperanza: \(E[U_i\mid\boldsymbol X]=\mathit 0\) dice que la perturbación vale cero en promedio, no que valga cero en ninguna muestra concreta. En cualquier muestra real, el vector de perturbaciones tendrá una media que no será cero y no será ortogonal al regresor.
¿Y si lo forzáramos? Podemos construir un vector de perturbaciones a medida: se sortea al azar, se le quita su proyección sobre los regresores, con lo que queda exactamente ortogonal a \(\boldsymbol 1\) y a \(\boldsymbol x\), y se reescala para que su varianza sea exactamente \(\sigma^2\). El truco es el mismo que usamos en el ejemplo de juguete de la lección 7, ahora automatizado.
Antes del bucle, el mundo artificial. En cada vuelta: u0 es un sorteo normal estándar; ols u0 const rooms --quiet lo regresa sobre la constante y el regresor, y $uhat devuelve el residuo de esa regresión, que por construcción es ortogonal a \(\boldsymbol 1\) y a rooms; la línea siguiente divide ese residuo por su norma estadística, \(\sqrt{\sum_i u_i^2/n}\), y lo multiplica por sigma, con lo que su varianza con divisor \(n\) es exactamente \(\sigma^2\). Con esa perturbación se construye y_e, se estima y se guarda b_exa. Los tres bloques finales imprimen \(\beta_2\), abren repExacta.gdt (AbrirRepExacta) e imprimen la media, la varianza y el recorrido (min y max) de las estimaciones.
en línea de comandos:
open hprice2.gdt --quiet
ols price const rooms --quiet
scalar b1_true = $coeff(const)
scalar b2_true = $coeff(rooms)
scalar sigma   = sqrt($ess/$df)

set seed 20261030
loop 2000 --progressive --quiet
    series u0  = normal(0,1)
    ols u0 const rooms --quiet
    series uex = $uhat                                    # ortogonal EXACTAMENTE a 1 y a rooms
    series uex = uex / sqrt(sum(uex^2)/$nobs) * sigma      # y con varianza exactamente sigma^2
    series y_e = b1_true + b2_true*rooms + uex
    ols y_e const rooms --quiet
    scalar b_exa = $coeff(rooms)
    store "@workdir/repExacta.gdt" b_exa
endloop
printf "beta_2 verdadero = %.6f\n", b2_true
beta_2 verdadero = 9119,548390
open "@workdir/repExacta.gdt" --quiet
printf "media de las 2000 estimaciones = %.6f\n", mean(b_exa)
printf "varianza de las estimaciones   = %.10f\n", sum((b_exa-mean(b_exa))^2)/$nobs
printf "minimo = %.6f    maximo = %.6f\n", min(b_exa), max(b_exa)
media de las 2000 estimaciones = 9119,548390
varianza de las estimaciones   = 0,0000000000
minimo = 9119,548390    maximo = 9119,548390
Lo que debe observar
Las dos mil estimaciones son el mismo número, y ese número es \(\beta_2\). La varianza es cero. El histograma, si lo dibujara, sería una única barra.
La explicación es inmediata a partir de la lección 11, que estableció \[ \hat\beta_2=\beta_2\,\mathit 1+\sum_iW_iU_i, \] y los pesos \(W_i\) son proporcionales a \((X_i-\overline{X})\). Ahora bien, una vez fijada la muestra concreta con la que trabajamos, esos pesos son números, los \(w_i\) de la lección 7. Si hemos construido \(\boldsymbol u\) exactamente ortogonal al regresor centrado, entonces \(\sum_iw_iu_i=0\) en esa muestra, no solo en promedio. El segundo sumando desaparece y lo que queda es \(\beta_2\) exactamente, en cada réplica y por construcción.
La dispersión de \(\hat\beta_2\) no procede de ningún defecto de MCO. Procede de que, en una muestra real, la perturbación realizada no es ortogonal, en \(\mathbb R^n\), al regresor; el supuesto solo dice que lo es en \(\langle\cdot,\cdot\rangle_P\), es decir, en promedio sobre las muestras.
Dicho de otro modo: si viviéramos en un mundo en el que en cada muestra la perturbación realizada fuese exactamente ortogonal al regresor, MCO recuperaría los parámetros exactamente y no haría falta ninguna inferencia estadística. Toda la teoría que viene a continuación (errores estándar, intervalos, contrastes) existe porque ese mundo no es el nuestro. Este experimento lo hace visible fabricándolo artificialmente.
Es el caso del ejemplo de la lección 7: aquel \(\boldsymbol u=(1,-2,0,2,-1)\) era una perturbación exactamente ortogonal a la constante y al regresor. Advertimos entonces que recuperar \(\hat\beta_2=3\) exactamente ``no era lo habitual''. Ahora sabemos decir con precisión qué lo hacía posible, y podemos reproducirlo a voluntad.
Preguntas de interpretación para la clase
- Un compañero afirma: ``para que MCO sea insesgado hace falta que las perturbaciones sean normales''. A la vista de la Actividad 1, ¿qué le respondería? ¿En qué paso concreto de la demostración de la lección 11 se apoyaría?
- En la Actividad 2, con \(n=506\) el histograma parecía normal aunque \(U\) no lo fuera. ¿Diría entonces que la normalidad de \(U\) es irrelevante para todo? Distinga entre lo que la práctica demuestra y lo que solo sugiere.
- ¿Por qué la varianza de \(\hat\beta_2\) es cero en la Actividad 3? ¿Contradice eso la fórmula de la lección 11?
- En la Actividad 3 hemos forzado los supuestos construyendo perturbaciones ortogonales al regresor. ¿Podría un investigador hacer lo mismo con datos reales? ¿Por qué?
- Suponga que en una muestra real la perturbación resultara, por pura casualidad, casi ortogonal al regresor. ¿Sería su estimación especialmente buena? ¿Podría saberlo mirando los datos?
Para profundizar:
- Lección 11 (lección 11), sección ``Sustituyendo el modelo poblacional'', donde se obtiene \(\hat\beta_2=\beta_2\,\mathit 1+\sum_iW_iU_i\).
- Lección 7 (lección 7), ejemplo numérico con \(\boldsymbol u\) diseñado ortogonal a los regresores.
- Wooldridge, J. M. (2020). Introductory Econometrics, cap. 2, sección 2.5 y cap. 4, sección 4.1 (donde aparece, por primera vez, el supuesto de normalidad).
Código completo de la práctica
| Enlace al guión: | S16-Prct-C-sorpresas.inp |
Respuestas
- ¿Hace falta normalidad para la insesgadez? No, y el experimento lo confirma: con perturbaciones uniformes y con perturbaciones muy asimétricas la media de las estimaciones sigue quedando en \(\beta_2\). La razón está en la demostración de la lección 11: la insesgadez sale de tomar esperanza condicional en \(\hat\beta_2=\beta_2\,\mathit 1+\sum_iW_iU_i\), usar el lema para sacar los \(W_i\) fuera, y aplicar \(E[U_i\mid\boldsymbol X]=\mathit 0\). Ese supuesto habla de la esperanza condicional de \(U\), no de su distribución. Una uniforme y una chi-cuadrado centrada tienen esperanza condicional cero igual que una normal, y eso es cuanto se necesita.
- ¿Es irrelevante la normalidad? Hay que separar dos cosas. Lo que la práctica demuestra es que la insesgadez y la fórmula de la varianza no requieren normalidad: se cumplen con las tres distribuciones ensayadas. Lo que la práctica solo sugiere, y no prueba, es algo sobre la forma: con muchas observaciones el histograma de \(\hat\beta_2\) tiende a parecer una campana aunque \(U\) no sea normal, mientras que con pocas observaciones el contraste de normalidad puede rechazar (en la Actividad 2 lo hace por la curtosis, aunque el histograma siga pareciendo simétrico) y, cuando una observación domina el regresor, el histograma hereda la asimetría de \(U\). De ahí no se puede concluir que la normalidad sea innecesaria. Puede concluirse, como mucho, que el papel de ese supuesto es más sutil de lo que parecía, y que hace falta un resultado teórico, que aquí no tenemos, para saber cuándo cabe prescindir de él. El apéndice (html) separa las dos cosas en dos resultados: insesgadez y varianza solo usan que las coordenadas del ruido son ortogonales y de la misma longitud (Resultados 1 y 2), y eso vale para la uniforme y para la \(\chi^2\); la forma exacta \(t_{n-k}\) o \(F_{q,n-k}\) usa que sean independientes (Resultado 3), y eso solo lo da la normal.
- Varianza cero. Porque hemos construido cada perturbación de modo que \(\sum_iw_iu_i=0\) exactamente en cada muestra, de forma que \(\hat\beta_2=\beta_2\) siempre, sin variabilidad alguna. No contradice la fórmula de la lección 11, sino que ilustra su alcance: aquella fórmula calcula la varianza de \(\hat\beta_2\) bajo los supuestos del modelo, entre los cuales está que \(\boldsymbol U\) sea aleatoria con \(E[U_i\mid\boldsymbol X]=\mathit 0\). Nuestras perturbaciones fabricadas no cumplen ese modelo: no son un sorteo libre, sino un sorteo al que después le hemos impuesto una restricción que depende de \(\boldsymbol X\). Al condicionar el sorteo a esa restricción hemos salido del marco en el que la fórmula era válida.
- ¿Podría hacerse con datos reales? No. Para restar a \(\boldsymbol u\) su proyección sobre los regresores hay que conocer \(\boldsymbol u\), y la perturbación es justamente lo que no se observa: sabemos \(\boldsymbol y\) y sabemos \(\boldsymbol x\), pero \(\boldsymbol u\) solo existe en el modelo. Lo que sí observamos son los residuos \(\boldsymbol{\mathop{\widehat e}}\), que por construcción siempre son exactamente ortogonales a los regresores: es una identidad algebraica de MCO, no un supuesto. Precisamente por eso los residuos no sirven para detectar si la perturbación realizada era o no ortogonal al regresor en esa muestra: lo son siempre, se cumpla o no el supuesto de exogeneidad, que habla de \(\langle\cdot,\cdot\rangle_P\) y no de una muestra.
- Una muestra favorable. Sí sería una estimación especialmente buena: si \(\sum_iw_iu_i\) resultara casi nulo, \(\hat\beta_2\) quedaría casi en \(\beta_2\). Pero no hay forma de saberlo mirando los datos, por lo dicho en la respuesta anterior: la cantidad que habría que mirar, \(\sum_iw_iu_i\), depende de \(\boldsymbol u\), que es inobservable. Este es el motivo de ser de toda la inferencia estadística: como nunca sabremos si en nuestra muestra concreta ese término resultó pequeño o grande, lo único que podemos hacer es cuantificar su dispersión esperada, y eso es lo que mide un error estándar.
Notas al pie de página:
Conviene no generalizar este paso. En la lección 11 el regresor es aleatorio, los pesos \(W_i\) son variables aleatorias, y no se convierten en números por condicionar en \(\boldsymbol X\): lo que autoriza allí a sacarlos fuera de la esperanza es el Lema. Aquí el paso es legítimo por otro motivo: el regresor está fijado de antemano, así que los \(w_i\) son números desde el principio.