Lección 11. ¿Es \(\boldsymbol{\mathop{\widehat{\beta}}}\) un buen estimador? Insesgadez y varianza
Índice
- 1. De dónde venimos: una pregunta pendiente
- 2. El marco: muestra aleatoria
- 3. \(\hat\beta_2\): la misma fórmula, aplicada a variables aleatorias
- 4. Dos propiedades de los pesos
- 5. Sustituyendo el modelo poblacional
- 6. Insesgadez: \(\mathrm{E}(\hat\beta_2)=\beta_2\)
- 7. Varianza: cuán dispersas están las estimaciones
- 8. MCO es BLUE; estimando \(\sigma^2\)
- 9. ¿Y con más regresores?
- 10. Recapitulación y guiño a la sesión siguiente
- 11. Apéndice: lanzar una moneda infinitas veces
- 12. Preguntas de repaso (sesión 15) htmlonly
- 13. Respuestas htmlonly
¿Es \(\boldsymbol{\mathop{\widehat{\beta}}}\) un buen estimador de \(\boldsymbol\beta\)? Para el modelo lineal simple: \(\hat\beta_2\) es insesgado y calculamos su varianza, reutilizando la fórmula de la lección 7 sobre variables aleatorias.
``¿Es bueno un estimador? ¿Está bien centrado? ¿Cuánto se dispersa?''
1. De dónde venimos: una pregunta pendiente
Recordemos cómo cerraba la lección 10: ``¿es \(\boldsymbol{\mathop{\widehat{\beta}}}\) un buen estimador del verdadero \(\boldsymbol\beta\)?''
\(\hat\beta_1,\hat\beta_2\), calculados primero con argumentos geométricos sobre los vectores de datos, se reinterpretaron después como estimadores de \(\beta_1,\beta_2\) por el método de los momentos.
Hoy, para el modelo lineal simple (constante \(\mathit1\) más un regresor no constante \(X\)), demostraremos dos propiedades de \(\hat\beta_2\):
- Insesgadez: \(\mathrm{E}(\hat\beta_2)=\beta_2\).
- Varianza: una fórmula exacta de \(Var[\hat\beta_2\mid\boldsymbol X]\).
Nos centramos en \(\hat\beta_2\) (la pendiente, de mayor interés económico); los mismos argumentos, sobre la fórmula \(\hat\beta_1\), permiten probar la insesgadez de \(\hat\beta_1\); no los desarrollamos aquí para no ser repetitivos.
Ningún ingrediente geométrico nuevo: la fórmula de \(\hat\beta_2\) que obtuvimos por geometría, la reutilizamos hoy sin cambios, evaluada sobre variables aleatorias en lugar de sobre datos: una fórmula aritmética vieja, aplicada sobre un objeto nuevo.
De dónde venimos: una pregunta pendiente
Esta sesión responde a una pregunta que quedó abierta en las lecciones 9 y 10. En la lección 9 (``El puente'') dimos sentido, por primera vez, a la pregunta ``¿\(\hat\beta_2\) estima bien al verdadero \(\beta_2\) poblacional?'', al construir el modelo poblacional \(Y=\beta_1\,\mathit1+\beta_2X+U\) y reinterpretar las fórmulas de la lección 7 como estimadores por el método de los momentos. En la lección 10 (regresión múltiple) esa misma pregunta se generalizó a \(k\) regresores, pero se dejó sin respuesta: una sola frase en la recapitulación, sin fórmula ni supuestos generalizados. Hoy la retomamos en detalle en el caso más sencillo, \(k=2\): la constante \(\mathit1\) y un único regresor no constante \(X\).
La estrategia de esta sesión no introduce ninguna geometría nueva. Vamos a reutilizar, sin cambios, la fórmula de \(\hat\beta_2\) de la lección 7, covarianza sobre varianza, obtenida de las dos condiciones del residuo: media cero y ortogonalidad al regresor. Esa fórmula, una vez concluido el cálculo geométrico, quedó escrita como una expresión puramente aritmética: una suma de productos dividida por una suma de cuadrados. Precisamente por ser aritmética, y ya no geométrica, podemos evaluarla en cualquier conjunto de argumentos siempre que las operaciones estén bien definidas. Hoy evaluaremos la fórmula, en lugar de con datos fijos \(x_1,\ldots,x_n,y_1,\ldots,y_n\), con la muestra aleatoria \(X_1,\ldots,X_n,Y_1,\ldots,Y_n\). El resultado de esa sustitución ya no es un número: es una nueva variable aleatoria, el estimador \(\hat\beta_2(\boldsymbol X,\boldsymbol Y)\).
Conviene advertir que la lección de hoy no añade geometría sobre los datos. Lo único que hacemos con la fórmula de la lección 7 es sustituir números por variables aleatorias, y esa sustitución no exige comprobar ninguna propiedad de producto escalar: es la diferencia entre demostrar un teorema y usar en otro contexto la fórmula que el teorema produjo. La geometría que sí usamos es la del espacio de las variables aleatorias de la lección 9, al condicionar en \(\boldsymbol X\).
También conviene precisar el alcance de esta sesión: demostramos insesgadez y la expresión de la varianza solo para \(\hat\beta_2\) en la regresión con dos regresores (modelo lineal simple). La generalización a \(k\) regresores existe: la citaremos al final de la sesión en su forma matricial, sin demostrarla, porque requiere álgebra que este curso no desarrolla; la insesgadez y la varianza de cada coeficiente por separado sí están demostradas sin matrices en el apéndice (sección 7.1) (html). Lo que sí haremos, como cierre, es comprobar que la fórmula general, evaluada en el caso particular \(k=2\), coincide con lo que aquí probamos sin matrices.
Para profundizar: Wooldridge, J. M. (2020), cap. 2, sección 2.5: insesgadez y varianza de los estimadores MCO en regresión simple (Teoremas 2.1 y 2.2).
2. El marco: muestra aleatoria
Recordemos (lección 9): los \(n\) datos son la realización de \(n\) copias idénticas e independientes de \(Y\); hoy, del par \((X,U)\).
\(\boldsymbol X\): la versión aleatoria de \(\boldsymbol{\mathsf X}=[\boldsymbol 1;\;\boldsymbol x]\), con columnas \(\mathit 1\) (\(n\) copias) y \(X_1,\ldots,X_n\). Análogamente \(\boldsymbol Y=(Y_1,\ldots,Y_n)\) y \(\boldsymbol U=(U_1,\ldots,U_n)\). Para cada \(i\): \(\;Y_i=\beta_1\,\mathit1+\beta_2X_i+U_i\), con los tres supuestos de la lección 9, condicionando ahora en \(\boldsymbol X\).
Lo nuevo es usar el muestreo aleatorio: las \(n\) copias \((X_i,U_i)\) son independientes entre sí. Dos consecuencias:
- \(E[U_i\mid\boldsymbol X]=\mathit0\): \(U_i\perp\) funciones de \(X_i\) (por definición) y de las demás copias (por independencia).
- Perturbaciones de observaciones distintas, incorreladas: \(Cov[U_i,U_j\mid\boldsymbol X]=\mathit 0\) \(\;(i\neq j)\).
Condicionar en \(\boldsymbol X\): la esperanza condicional de la lección 9, sobre las \(n\) copias a la vez.
El marco: muestra aleatoria
La lección 9 introdujo, sin desarrollarla, una frase que hoy se convierte en el ingrediente central de la sesión: ``asumiremos que nuestros \(n\) datos son el resultado de observar la realización de \(n\) copias idénticas e independientes de esa variable \(Y\)''. Allí solo servía para interpretar cada dato \(y_i\) como la realización de una variable aleatoria. Hoy hace falta más, porque para hablar de la distribución de \(\hat\beta_2\), de cuánto varía de una muestra a otra, hay que imaginar que la muestra podría haber sido distinta.
Formalicemos esa idea. Desde la lección 4 venimos usando \(\boldsymbol x=(x_1,\ldots,x_n)\) para el vector de datos observados (y, desde la lección 6, para el vector de datos observados de un regresor), y en la lección 10 los agrupamos en la matriz de regresores \(\boldsymbol{\mathsf X}\), una columna por regresor (en el modelo lineal simple, \(\boldsymbol{\mathsf X}=[\boldsymbol1;\;\boldsymbol x]\)). Hoy introducimos su análogo aleatorio: la matriz1 \(\boldsymbol X\). Este es el objeto sobre el que condicionaremos todos los momentos a lo largo de la sesión. Cada columna de \(\boldsymbol X\) corresponderá al muestreo de uno de los regresores poblacionales. En el modelo lineal simple son \(\mathit 1\) y \(X\); por tanto, la segunda columna de \(\boldsymbol X\) está formada por las \(n\) variables aleatorias \(X_1,\ldots,X_n\): cada una es una copia idéntica e independiente de la variable poblacional \(X\) de la lección 9,2 y la primera está formada por \(n\) copias de \(\mathit 1\). Es la relación dato/variable aleatoria de la lección 9, entre \(y_i\) e \(Y\), aplicada a cada componente de cada columna.
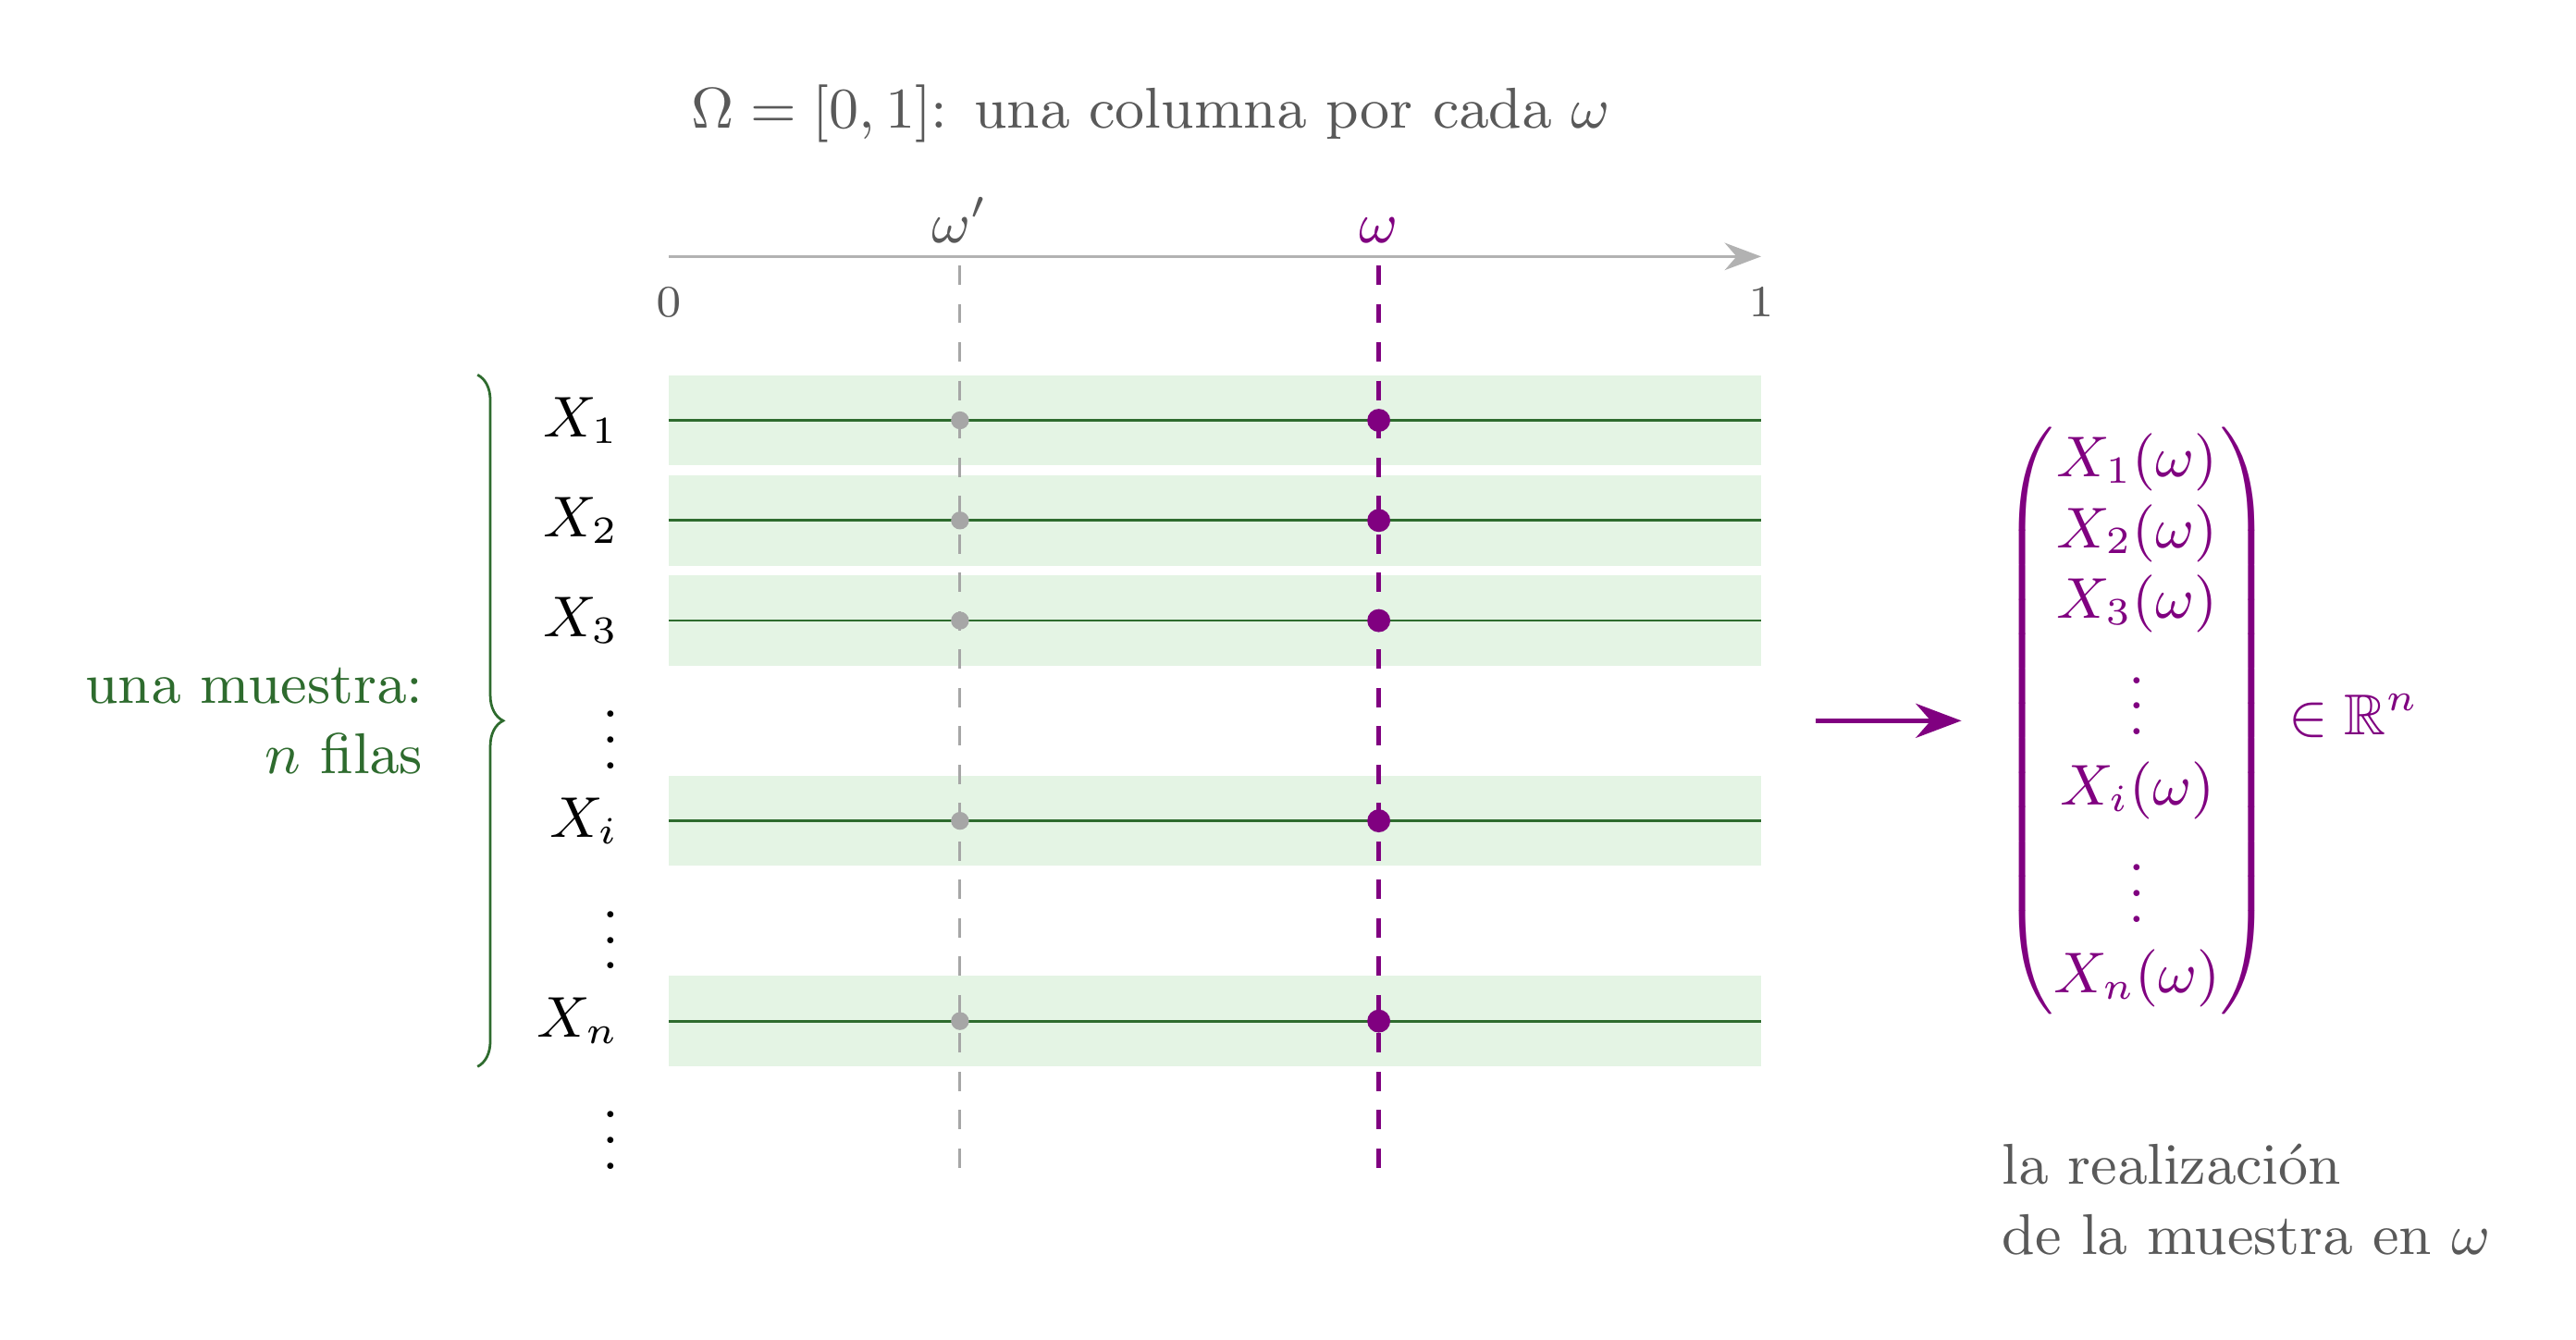
Figura 1: La matriz de copias. Cada fila es una copia de la variable aleatoria \(X\), una función sobre \(\Omega\); la matriz continúa hacia abajo indefinidamente. Elegir \(n\) filas es fijar la muestra aleatoria; elegir una sección vertical (una ``columna'') es fijar un suceso elemental \(\omega\) donde evaluar las infinitas copias; las dos cosas a la vez (elegir \(n\) copias y evaluarlas en \(\omega\)) dan el vector de \(\mathbb R^n\) de la derecha: la muestra, es decir, una realización de la muestra aleatoria en ese \(\omega\). Los datos observados son dicha muestra, y aparecen dispuestos en el vector \(\boldsymbol x\) de la derecha.
Mire la figura de la matriz de copias como lo que es: una tabla. Cada fila es una copia de la variable \(X\), es decir, una función que a cada suceso elemental \(\omega\) le asigna un número. Una sección vertical corresponde a la evaluación de las variables aleatorias en un mismo suceso elemental \(\omega\). La casilla donde se cruzan la fila \(i\) y la sección vertical por \(\omega\) contiene el número \(X_i(\omega)\), el valor que la copia \(i\) toma en ese suceso elemental \(\omega\). Como hay tantas copias de \(X\) como se quiera, la tabla continúa hacia abajo sin fin.
Con esa lectura, los dos objetos de la sesión se ven en la tabla. Elegir \(n\) filas es elegir \(n\) copias, \(X_1,\ldots,X_n\): esa lista de \(n\) funciones es la muestra aleatoria. No es un vector de \(\mathbb R^n\), porque los componentes de la lista son funciones, no números. Evaluar esas \(n\) funciones en un mismo suceso elemental \(\omega\) es seleccionar una sección vertical de la figura, que podemos entender como una ``columna'': se obtienen \(n\) números, \(X_1(\omega),\ldots,X_n(\omega)\), que son las componentes del vector de \(\mathbb R^n\) dibujado a la derecha. Ese vector es la muestra: los datos observados del regresor, el \(\boldsymbol x\) de las lecciones anteriores.
Otras \(n\) filas evaluadas en ese mismo \(\omega\) dan otro vector de datos: la tabla tiene infinitas filas, y en lo que sigue ``otra muestra'' es siempre otro bloque de \(n\) filas en la misma columna. Y cuando en el laboratorio de la sesión siguiente repitamos un experimento dos mil veces (actividad 3 (html) de la práctica A de la sesión 16), lo leeremos así: Gretl consume una única secuencia de números pseudoaleatorios, un solo \(\omega\), y toma de ella dos mil bloques sucesivos de \(n\) filas; como los bloques son copias independientes, el histograma de las dos mil estimaciones aproxima la distribución de \(\hat\beta_2\). El apéndice (sección 3) (html) desarrolla esta lectura.
Una precisión de uso. Durante casi toda la sesión no haremos ninguna operación matricial con \(\boldsymbol X\): bastarán sumatorios sobre las \(X_i\), y ``condicionar en \(\boldsymbol X\)'' significará proyectar sobre el espacio de las funciones de todas las variables aleatorias de \(\boldsymbol X\) a la vez. La estructura de matriz reaparece al justificar el divisor \(n-k\) y en la generalización final a \(k\) regresores.
Para cada observación \(i\), el modelo poblacional de la lección 9 se aplica sin ningún cambio, con subíndice \(i\) añadido: \[ Y_i=\beta_1\,\mathit1+\beta_2X_i+U_i, \qquad i=1,\ldots,n, \] con los tres supuestos del Modelo Clásico de Regresión Lineal aplicados a cada par \((X_i,U_i)\): linealidad, independencia lineal (\(\mathrm{Var}(X)\neq0\)) y homocedasticidad \(Var[U_i\mid\boldsymbol X]=\sigma^2\,\mathit1\); más la exogeneidad estricta \(E[U_i\mid\boldsymbol X]=\mathit0\), que en la lección 9 obteníamos sin supuesto adicional.3
Sobre el supuesto \(\mathrm{Var}(X)\neq0\) conviene una precisión, porque es fácil que el símbolo ``\(X\)'' induzca a confusión una vez que ya solo hablamos de \(X_1,\ldots,X_n\). La letra \(X\), sin subíndice, sigue denotando, como en la lección 9, la variable poblacional de la que \(X_1,\ldots,X_n\) son copias. El supuesto \(\mathrm{Var}(X)\neq0\) se enuncia sobre esa variable poblacional, y se aplica a cada copia \(X_i\) porque, al ser copias idénticas, cada \(X_i\) tiene la misma distribución que \(X\) (y, en particular, la misma varianza).
Fíjese que la exogeneidad estricta tampoco es introducida aquí como un supuesto adicional, aunque hoy descansa sobre dos propiedades del modelo (en lugar de solo una): en primer lugar, la definición de \(U_i\) da \(U_i\perp\) funciones de \(X_i\); y, en segundo lugar, el muestreo aleatorio da \(U_i\perp\) funciones de las demás copias \(X_j\) con \(j\ne i\) (la independencia, con el producto escalar del curso, es ortogonalidad entre funciones centradas: apéndice, sección 1.5 (html)). Esta es la primera consecuencia que extraemos del muestreo aleatorio; la segunda viene a continuación.
La segunda consecuencia del muestreo aleatorio es aún más directa: si \((X_i,U_i)\) y \((X_j,U_j)\) son independientes para \(i\neq j\), entonces, en particular, \(U_i\) y \(U_j\) son independientes, y dos variables independientes tienen covarianza cero. Condicionando en \(\boldsymbol X\) hace falta el mismo argumento que para la exogeneidad estricta, y está en el apéndice, sección 6.1 (html):4 \[ Cov[U_i,U_j\mid\boldsymbol X]=\mathit 0 \qquad (i\neq j). \] No se trata, por tanto, de un supuesto añadido ex novo: es la traducción, en términos de covarianzas, de algo que ya habíamos dado por sentado desde la lección 9 al hablar de copias ``idénticas e independientes'' (lo que su curso de Estadística, el curso anterior, llamaba muestreo aleatorio simple). Hoy es la primera vez que necesitamos esta consecuencia de forma explícita, porque es la primera vez que trabajamos con varias perturbaciones \(U_1,\ldots,U_n\) simultáneamente, en lugar de con una sola \(U\) genérica. Con el producto escalar de la lección 9: las perturbaciones \(U_1,\ldots,U_n\) son ortogonales dos a dos y todas de longitud \(\sigma\), una familia ortogonal de variables aleatorias. Es todo lo que usan la insesgadez y la varianza de esta sesión; la independencia completa, que es más, solo hará falta en la lección 12 (apéndice, secciones 6.1 (html) y 7.1).
Por último, al enunciar el supuesto de homocedasticidad, la varianza de cada \(U_i\) se condiciona a toda la matriz \(\boldsymbol X\), no solo a \(X_i\). Es la forma que hace falta para todo lo que sigue y, como la exogeneidad estricta, se deduce de la homocedasticidad poblacional de la lección 9 y del muestreo aleatorio: \(U_i^2-\sigma^2\,\mathit1\) es una función centrada de la copia \(i\), ortogonal a toda función de las demás copias (apéndice, sección 6.1 (html)).
Para profundizar: Wooldridge, J. M. (2020), cap. 2, sección 2.5, supuesto SLR.2 (muestreo aleatorio).
3. \(\hat\beta_2\): la misma fórmula, aplicada a variables aleatorias
Estimación vs. estimador (distinción hoy imprescindible):
- \(\hat\beta_2(\boldsymbol x,\boldsymbol y)\), la estimación: un número.
- \(\hat\beta_2(\boldsymbol X,\boldsymbol Y)\), el estimador: una variable aleatoria, la MISMA fórmula sobre la muestra aleatoria.
Recordando la lección 7 (\(\hat\beta_2=\sigma_{\boldsymbol x\boldsymbol y}/\sigma_{\boldsymbol x}^2\), escrita con sumatorios): \[ \hat\beta_2(\boldsymbol x,\boldsymbol y)=\frac{\sum_i(x_i-\mu_{\boldsymbol x})y_i}{\sum_j(x_j-\mu_{\boldsymbol x})^2}=\sum_i w_i y_i; \quad\text{donde } w_i=\frac{(x_i-\mu_{\boldsymbol x})}{\sum_j(x_j-\mu_{\boldsymbol x})^2}. \]
Sustituimos \(x_i,y_i\) por \(X_i,Y_i\):
\[ \hat\beta_2(\boldsymbol X,\boldsymbol Y)=\frac{\sum_i(X_i-\overline{X})Y_i}{\sum_j(X_j-\overline{X})^2}=\sum_i {W_i}Y_i; \quad\text{donde } W_i = \frac{(X_i-\overline{X})}{\sum_j(X_j-\overline{X})^2}. \] donde \(\overline{X}=\frac1n\sum_iX_i\) es la media muestral; y \(\sum_i (X_i - \overline{X}) = \mathit 0\).
\(\hat\beta_2\): la misma fórmula, aplicada a variables aleatorias
Antes de seguir, conviene fijar una distinción que hasta ahora el curso no había requerido. Cuando escribimos \(\hat\beta_2=\frac{\sigma_{\boldsymbol{x}\boldsymbol{y}}}{\sigma_{\boldsymbol{x}}^2}=\frac{\sum_i(x_i-\mu_{\boldsymbol x})y_i}{\sum_j(x_j-\mu_{\boldsymbol x})^2}\) (lección 7 (html)) y evaluamos esa fórmula con dos vectores de datos concretos \(\boldsymbol x\) e \(\boldsymbol y\), obtenemos un número: la estimación \(\hat\beta_2\) de \(\beta_2\). Si aplicamos la misma fórmula a las muestras aleatorias \(\boldsymbol X\) y \(\boldsymbol Y\), el resultado es una función de variables aleatorias, es decir, una variable aleatoria5: el estimador \(\hat\beta_2\) de \(\beta_2\).6
Su curso de Estadística ya hizo esta distinción con la media: sus tablas tenían tres columnas, parámetro, estimador y estimación, con \(\mu\), la media muestral y el número calculado con los datos. Hoy es la misma tabla con \(\beta_2\), \(\hat\beta_2(\boldsymbol X,\boldsymbol Y)\) y \(\hat\beta_2(\boldsymbol x,\boldsymbol y)\). Una diferencia de escritura: allí la media muestral se escribía casi siempre \(\bar x\), fuese un número o una variable aleatoria; aquí la variable aleatoria se escribe con mayúscula, \(\overline X\), y la minúscula, \(\mu_{\boldsymbol x}\), es siempre un número.
Precisemos qué significa ``sustituir datos por variables aleatorias en una fórmula''. Una fórmula como \(\mu_{\boldsymbol x}=f(x_1,\ldots,x_n)=\frac1n\sum_ix_i\) es, matemáticamente, una función que toma \(n\) números y devuelve un solo número: la media. Pero nada impide evaluar esa MISMA fórmula con otro tipo de argumento (si la operación sigue estando bien definida): si en lugar de \(n\) números sus argumentos son \(n\) variables aleatorias \(X_1,\ldots,X_n\), el resultado \(f(X_1,\ldots,X_n)=\frac1n\sum_iX_i\) ya no es un número, ahora es una variable aleatoria. A esta nueva variable aleatoria la llamamos media muestral, y la denotamos con \({\overline{X}}\); es el estimador natural del valor esperado \(\mathrm{E}(X)\). Su definición emplea la MISMA fórmula aritmética que en la lección 4 usamos para definir la media de un vector de datos, pero ahora la fórmula es aplicada a la muestra aleatoria, las \(n\) variables aleatorias \(X_1,\ldots,X_n\) (de ahí el nombre de media muestral).
Esta observación guía toda la sesión, y no encierra más complejidad que la enunciada: nos limitamos a definir nuevas variables aleatorias mediante la aplicación de fórmulas preexistentes (desarrolladas en su momento en \(\mathbb{R}^n\)) a una muestra aleatoria. Dichas variables aleatorias se conocen como estadísticos o estadísticos muestrales.
Con esto aclarado, retomamos la fórmula de la pendiente de la lección 7, \(\hat\beta_2=\sigma_{\boldsymbol x\boldsymbol y}/\sigma_{\boldsymbol x}^2\), obtenida de las dos condiciones del residuo. La vía alternativa (html) de esa lección la escribió como cociente de productos escalares, cambiando a los generadores ortogonales \(\boldsymbol 1\) y \(\boldsymbol x-\mu_{\boldsymbol x}\boldsymbol 1\): para dos vectores de datos \(\boldsymbol x\) e \(\boldsymbol y\), \[ \hat\beta_2(\boldsymbol x,\boldsymbol y)=\frac{\langle\boldsymbol y,(\boldsymbol x-\mu_{\boldsymbol x}\boldsymbol1)\rangle_s}{\langle(\boldsymbol x-\mu_{\boldsymbol x}\boldsymbol1),(\boldsymbol x-\mu_{\boldsymbol x}\boldsymbol1)\rangle_s}=\frac{\sum_i(x_i-\mu_{\boldsymbol x})y_i}{\sum_j(x_j-\mu_{\boldsymbol x})^2}. \] El lado izquierdo de esta igualdad (\(\langle\cdot,\cdot\rangle_s\)) es geometría: un cociente de dos productos escalares, con todo su significado y papel en la proyección ortogonal. El lado derecho, en cambio, ya no necesita esos conceptos para ser evaluado: es una simple expresión aritmética (los factores \(1/n\) de cada producto escalar se cancelan al dividir, así que ni siquiera hace falta escribirlos). Hoy nos quedamos con esta expresión aritmética, prescindiendo de la geometría subyacente, y sustituimos directamente las observaciones \(x_i, y_i\) por las variables aleatorias \(X_i, Y_i\); y reescribimos la expresión como una suma ponderada:7 \[ \hat\beta_2(\boldsymbol X,\boldsymbol Y)=\frac{\sum_i(X_i-\overline{X})Y_i}{\sum_j(X_j-\overline{X})^2}=\sum_{i=1}^n\underbrace{\left(\frac{(X_i-\overline{X})}{\sum_j(X_j-\overline{X})^2}\right)}_{W_i}Y_i =\sum_{i=1}^n {W_i}Y_i. \] Escribimos los pesos aleatorios \(W_i\) con mayúscula por ser estadísticos (i.e., variables aleatorias).
Respecto a la media muestral, fijémonos que como \(\overline{X}=\frac1n\sum_iX_i\), entonces, por una parte, \(\sum_i X_i=n\overline{X}\) y por otra \(\sum_{i=1}^n \overline{X}=\underbrace{\overline{X}+\dots+\overline{X}}_{n\text{ veces}}=n\overline{X}\); así \[ \sum_i (X_i - \overline{X}) = \sum_i X_i - \sum_i \overline{X} = n\overline{X} - n\overline{X} = \mathit 0. \] Usaremos esta propiedad de la media muestral en ``Dos propiedades de los pesos''.
Para profundizar: Wooldridge, J. M. (2020), cap. 2, sección 2.5 (donde \(\hat\beta_2\) se escribe, con la misma idea, como \(\sum w_iy_i\) mediante sumatorios).
4. Dos propiedades de los pesos
Dos identidades algebraicas sobre los pesos. Ninguna es nueva.
Ambas valen para cualquier lista de números y, por tanto, siguen siendo ciertas al sustituir \(x_i\) por \(X_i\): son hechos aritméticos, no probabilísticos:
- la primera es la condición \(\sum_i(X_i-\overline{X})=\mathit0\) de la transparencia anterior (la misma cuenta que en la lección 4 daba media cero al vector en desviaciones);
\[ \sum_iW_i=\mathit 0; \]
- la segunda es la razón por la que, en la ``vía alternativa'' de la lección 7, el coeficiente de \(\boldsymbol x-\mu_{\boldsymbol x}\boldsymbol1\) resultaba ser \(\hat\beta_2\).
\[ \sum_iW_iX_i=\mathit 1 \qquad\Big(\text{pues } \textstyle\frac{\sum_i(X_i-{\overline{X}})X_i}{\sum_j(X_j-{\overline{X}})^2}=\frac{\sum_i(X_i-{\overline{X}})^2}{\sum_j(X_j-{\overline{X}})^2}\Big). \]
Dos propiedades de los pesos
Antes de sustituir el modelo poblacional en \(\hat\beta_2=\sum_iW_iY_i\), necesitamos las dos propiedades de los pesos \(W_i\) que enuncia la transparencia: \(\sum_iW_i=\mathit0\) y \(\sum_iW_iX_i=\mathit1\). Las dos se obtienen dividiendo una suma por el denominador común de los pesos, \(\sum_j(X_j-\overline{X})^2\): la primera, la suma \(\sum_i(X_i-\overline{X})=\mathit0\) de ``\(\hat\beta_2\): la misma fórmula, aplicada a variables aleatorias''; la segunda, la suma \(\sum_i(X_i-\overline{X})X_i\), que vale \(\sum_i(X_i-\overline{X})^2\), como se comprueba más abajo. Ninguna de las dos es nueva, como dice la transparencia: son las mismas sumas que ya hicimos con datos en las lecciones 4 y 7, y lo que se traslada de los datos a las copias es la cuenta aritmética, no la geometría, como explica el párrafo siguiente.
Un punto clave, para no perder la distinción entre estimador y estimación de ``\(\hat\beta_2\): la misma fórmula, aplicada a variables aleatorias'': estas dos propiedades no son afirmaciones probabilísticas, sino identidades algebraicas. Tome \(n\) números cualesquiera \(x_1,\ldots,x_n\), su media \(\mu_{\boldsymbol x}\) y los pesos \(w_i=(x_i-\mu_{\boldsymbol x})\big/\sum_j(x_j-\mu_{\boldsymbol x})^2\). Las igualdades \(\sum_iw_i=0\) y \(\sum_iw_ix_i=1\) se cumplen sea cual sea la elección de esos números, iguales o distintos entre sí, positivos o negativos, porque se deducen solo de las definiciones de \(\mu_{\boldsymbol x}\) y \(w_i\), sin usar ninguna propiedad estadística de los números. Por eso, cuando en lugar de \(n\) números ponemos las \(n\) copias \(X_1,\ldots,X_n\), con \(\overline{X}\) en el lugar de \(\mu_{\boldsymbol x}\) y \(W_i\) en el de \(w_i\), las igualdades siguen siendo ciertas sin ningún argumento adicional: en cada suceso elemental \(\omega\) las copias toman \(n\) números, y para ellos la identidad se cumple.8 Conviene retener la regla, porque se usará muchas veces: por este camino solo pasan las identidades, las igualdades ciertas para toda lista de números. Las tres sumas que usa la lección, \(\sum_iW_i\), \(\sum_iW_iX_i\) y, más adelante, \(\sum_iW_i^2\), pasan por él.
Primera propiedad: \(\sum_iW_i=\mathit 0\). Como \(W_i=\frac{(X_i-\overline{X})}{\sum_j(X_j-\overline{X})^2}\) y el denominador es común a todos los términos, \(\sum_iW_i=\frac{\sum_i(X_i-\overline{X})}{\sum_j(X_j-\overline{X})^2}\); y el numerador es nulo: \(\sum_i(X_i-\overline{X})=\mathit 0\).
Segunda propiedad: \(\sum_iW_iX_i=\mathit 1\). Usando de nuevo que \(\sum_i(X_i-{\overline{X}})=\mathit 0\) \[ \sum_i(X_i-{\overline{X}})X_i=\sum_i(X_i-{\overline{X}})(X_i-\overline{X}+\overline{X})=\sum_i (X_i-{\overline{X}})(X_i-\overline{X})+\overline{X}\underbrace{\sum_i(X_i-{\overline{X}})}_{=\mathit 0}; \] donde hemos sacado factor común \(\overline{X}\) en el sumatorio \(\sum_i(X_i-{\overline{X}})\overline{X}\) para comprobar que es cero.
Por tanto \(\sum_iW_iX_i=\frac{\sum_i(X_i-{\overline{X}})X_i}{\sum_j(X_j-{\overline{X}})^2}=\frac{\sum_i(X_i-{\overline{X}})^2}{\sum_j(X_j-{\overline{X}})^2}=\mathit 1\).
Esta segunda identidad es la que la vía alternativa (html) de la lección 7 usaba sin nombrarla. Allí el coeficiente de \(\boldsymbol x-\mu_{\boldsymbol x}\boldsymbol1\) era \(c_2=\langle\boldsymbol y,\boldsymbol x-\mu_{\boldsymbol x}\boldsymbol1\rangle_s\big/\Vert\boldsymbol x-\mu_{\boldsymbol x}\boldsymbol1\Vert_s^2\), y el denominador es también \(\langle\boldsymbol x,\boldsymbol x-\mu_{\boldsymbol x}\boldsymbol1\rangle_s\): es la cuenta de arriba, con datos en lugar de copias. Aplicada a \(\boldsymbol y=\boldsymbol x\), la fórmula de la pendiente devuelve \(1\); eso es \(\sum_iw_ix_i=1\).
Para profundizar: Wooldridge, J. M. (2020), cap. 2, sección 2.5 (donde estas dos propiedades se verifican mediante sumatorios, sin distinguir explícitamente su estatus puramente algebraico).
5. Sustituyendo el modelo poblacional
\[ \hat\beta_2(\boldsymbol X,\boldsymbol Y)=\sum_iW_iY_i=\sum_iW_i(\beta_1\,\mathit1+\beta_2X_i+U_i) \]
\[ =\beta_1\underbrace{\sum_iW_i}_{=\mathit0}+\beta_2\underbrace{\sum_iW_iX_i}_{=\mathit1}+\sum_iW_iU_i \]
\[ \boxed{\;\hat\beta_2(\boldsymbol X,\boldsymbol U)=\beta_2\,\mathit{1}+\sum_{i=1}^nW_iU_i\;} \] (escrito ahora en función de \(\boldsymbol U\), pues \(\boldsymbol Y\) ha sido sustituida).
Mediante manipulación algebraica (sustitución y las dos identidades de la transparencia anterior): el estimador es el parámetro verdadero MÁS una ``suma ponderada'' de las perturbaciones. Todo lo que sigue sale de estudiar ese segundo término.
Sustituyendo el modelo poblacional
Gracias a las ``Dos propiedades de los pesos'', el cálculo que resta es puramente mecánico. Partimos de \(\hat\beta_2=\sum_iW_iY_i\) (sección ``\(\hat\beta_2\): la misma fórmula, aplicada a variables aleatorias'') y sustituimos el modelo poblacional \(Y_i=\beta_1\,\mathit1+\beta_2X_i+U_i\) (sección ``El marco: muestra aleatoria'') en cada sumando: \[ \hat\beta_2(\boldsymbol X,\boldsymbol U)=\sum_iW_i(\beta_1\,\mathit1+\beta_2X_i+U_i)=\beta_1\sum_iW_i+\beta_2\sum_iW_iX_i+\sum_iW_iU_i. \] El primer término se anula (\(\sum_iW_i=\mathit 0\)); el segundo se reduce a \(\beta_2\,\mathit1\) (\(\sum_iW_iX_i=\mathit 1\)): \[ \hat\beta_2(\boldsymbol X,\boldsymbol U)=\beta_2\,\mathit1+\sum_{i=1}^nW_iU_i. \]
Esta identidad es el núcleo algebraico de la sesión: dice que el estimador \(\hat\beta_2\) es la variable aleatoria constante \(\beta_2\,\mathit1\) (donde \(\beta_2\) es el verdadero parámetro poblacional) más una ``suma ponderada'' de las perturbaciones \(U_1,\ldots,U_n\), con los pesos \(W_i\) que ya conocemos. Todo lo que necesitamos demostrar sobre \(\hat\beta_2\) (que su valor esperado sea \(\beta_2\), y que su dispersión sea tal o cual) se reduce, a partir de aquí, a estudiar el comportamiento de esa suma ponderada \(\sum_iW_iU_i\). Los \(W_i\) son funciones de \(X_1,\ldots,X_n\), como acabamos de comprobar. Por eso, al condicionar en \(\boldsymbol X\), podremos sacarlos fuera de la esperanza y de la varianza condicionales. Conviene ser preciso sobre qué autoriza ese paso, porque es tentador decir que ``condicionar en \(\boldsymbol X\) convierte los \(W_i\) en números'': no es así. Los \(W_i\) siguen siendo variables aleatorias, funciones de \(\omega\), antes y después de condicionar; lo que ocurre es que son funciones de aquello sobre lo que se condiciona, y el Lema de ``Insesgadez'' demuestra que tales factores salen fuera del operador \(E[\,\cdot\mid\boldsymbol X]\). El resultado se parece al de una combinación lineal con coeficientes fijos, pero la justificación no es esa: es el Lema, que a su vez sale de la caracterización geométrica de la esperanza condicional (lección 9 (html)).
El ejemplo numérico de la lección 7 es coherente con esta descomposición: allí, con \(\boldsymbol u=(1,-2,0,2,-1)\) diseñado deliberadamente con \(\sum w_iu_i=0\) (covarianza nula con el regresor), obtuvimos la estimación \(\hat\beta_2=\beta_2\) exactamente. La fórmula de hoy explica por qué ese resultado se debía al diseño del ejemplo y no es lo esperable en general: \(\hat\beta_2=\beta_2\,\mathit1+\sum_iW_iU_i\), y solo cuando esa suma se anula por construcción (como en aquel ejemplo, ya con datos y no con variables aleatorias) coinciden estimador y parámetro. Sobre la muestra aleatoria, \(\sum_iW_iU_i\) no es cero, sino una variable aleatoria con su propio valor esperado y su propia varianza, que es lo que estudiamos en ``Insesgadez'' y ``Varianza''.
Para profundizar: Wooldridge, J. M. (2020), cap. 2, ecuación (2.35) y comentario adyacente.
6. Insesgadez: \(\mathrm{E}(\hat\beta_2)=\beta_2\)
Cambiemos de pregunta:
- de ``¿Cuánto vale la estimación \(\hat\beta_2\) con los datos disponibles \(\boldsymbol x\) e \(\boldsymbol y\)?''
- a ``¿cuánto vale el estimador \(\hat\beta_2\), en promedio, sobre todas las muestras posibles?'' (su proyección sobre \(\mathit1\), lección 9).
Lema (demostrado en el apéndice): si \(c(\boldsymbol X)\) es una función de \(\boldsymbol X\), \[ E\big[c(\boldsymbol X)Z\mid\boldsymbol X\big]=c(\boldsymbol X)E[Z\mid\boldsymbol X]. \]
\(\mbox{ }\)
Aplicándolo con \(c(\boldsymbol X)=W_i\) (pues cada \(W_i\) es función de \(\boldsymbol X\), sección anterior): \[ E[\hat\beta_2\mid\boldsymbol X]=\beta_2\,\mathit1+\sum_iW_i\,E[U_i\mid\boldsymbol X]=\beta_2\,\mathit1+\sum_iW_i\,\mathit0=\beta_2\,\mathit1. \]
Ley de las esperanzas iteradas: Como \(E[Z\mid\boldsymbol X]\) es la proyección ortogonal de \(Z\) sobre el espacio de las funciones de \(\boldsymbol X\) (y \(\mathit1\) es una de ellas), entonces \(Z-E[Z\mid\boldsymbol X]\perp\mathit1\). Por tanto, \[\mathrm{E}(Z)=\mathrm{E}\big(E[Z\mid\boldsymbol X]\big).\]
\(\mbox{ }\)
\[ \boxed{\;\mathrm{E}(\hat\beta_2)=\mathrm{E}\big(E[\hat\beta_2\mid\boldsymbol X]\big)=\beta_2.\;} \]
\(\hat\beta_2\) no coincide con \(\beta_2\) en cada muestra, pero no se desvía sistemáticamente en ninguna dirección.
Insesgadez: \(\mathrm{E}(\hat\beta_2)=\beta_2\)
Partimos de \(\hat\beta_2=\beta_2\,\mathit1+\sum_iW_iU_i\) (``Sustituyendo el modelo poblacional'') y tomamos esperanza condicionada a \(\boldsymbol X\): el primer paso de la sesión que usa probabilidad.
La herramienta es la definición de \(E[Z\mid\boldsymbol X]\) de la lección 9, la función de \(\boldsymbol X\) que minimiza la distancia \(\|Z-g(\boldsymbol X)\|_P\), escrita como se escribe toda proyección: por la ortogonalidad del resto (lección 4 para una recta, lección 6 para un plano).
Caracterización de \(E[Z\mid\boldsymbol X]\). Es la única variable aleatoria (salvo, como advertimos en la lección 9, en un conjunto de sucesos de probabilidad nula) que cumple, a la vez:
- Pertenencia: es una función de \(\boldsymbol X\).
- Ortogonalidad del residuo: \(\mathrm{E}\Big((Z-E[Z\mid\boldsymbol X])h(\boldsymbol X)\Big)=0\) para toda función \(h(\boldsymbol X)\).
De esta caracterización salen, comprobando en cada caso que el candidato es función de \(\boldsymbol X\) y que el resto es ortogonal, las reglas que usaremos de aquí en adelante; las demostraciones están en el apéndice, sección 1.3 (html), y la linealidad de la esperanza sin condicionar es la regla 1 del apéndice, sección 1.6 (html). Linealidad: \(E[aZ+bW\mid\boldsymbol X]=a\,E[Z\mid\boldsymbol X]+b\,E[W\mid\boldsymbol X]\). Las funciones de \(\boldsymbol X\) quedan fijas: \(E[g(\boldsymbol X)\mid\boldsymbol X]=g(\boldsymbol X)\); en particular, \(E[\beta_2\,\mathit1\mid\boldsymbol X]=\beta_2\,\mathit1\). Y el Lema de la transparencia, que generaliza la anterior:
Lema (sacar fuera de la esperanza condicionada las funciones de variables sobre las que se condiciona). Si \(c(\boldsymbol X)\) es una función de la lista de variables aleatorias \(\boldsymbol X\), \[ E[c(\boldsymbol X)Z\mid\boldsymbol X]=c(\boldsymbol X)E[Z\mid\boldsymbol X]. \]
Aplicamos el Lema con \(c(\boldsymbol X)=W_i\) y con \(Z=U_i\): \[ E[\hat\beta_2\mid\boldsymbol X]=\beta_2\,\mathit1+\sum_iE[W_iU_i\mid\boldsymbol X]=\beta_2\,\mathit1+\sum_iW_i\,E[U_i\mid\boldsymbol X]=\beta_2\,\mathit1+\sum_iW_i\,\mathit0=\beta_2\,\mathit1, \] donde hemos usado la exogeneidad estricta \(E[U_i\mid\boldsymbol X]=\mathit0\) de la sección ``El marco: muestra aleatoria''.
Falta pasar de la esperanza condicional a la incondicional: queremos \(\mathrm{E}(\hat\beta_2)\), no \(E[\hat\beta_2\mid\boldsymbol X]\). Es la Ley de las Esperanzas Iteradas de la transparencia, \(\mathrm{E}\big(E[Z\mid\boldsymbol X]\big)=\mathrm{E}(Z)\) para cualquier \(Z\), que sale de la caracterización con \(h(\boldsymbol X)=\mathit1\): la constante es una función de \(\boldsymbol X\), así que el resto es ortogonal a \(\mathit1\) y las dos esperanzas coinciden. Es la misma idea con la que la lección 9 dedujo \(\mathrm{E}(U)=0\) de \(U\perp\mathit1\); en el apéndice, sección 1.3 (html) se lee como proyectar en dos pasos sobre subespacios anidados: primero sobre las funciones de \(\boldsymbol X\) y después sobre la recta de las constantes.
Aplicándola a \(Z=\hat\beta_2\), y usando que \(E[\hat\beta_2\mid\boldsymbol X]=\beta_2\,\mathit1\) es constante: \[ \mathrm{E}(\hat\beta_2)=\mathrm{E}\big(E[\hat\beta_2\mid\boldsymbol X]\big)=\mathrm{E}(\beta_2\,\mathit1)=\beta_2. \] \(\hat\beta_2\) es, por tanto, un estimador insesgado de \(\beta_2\): en promedio, sobre todas las muestras posibles que podríamos haber observado, ni sobreestima ni subestima el verdadero parámetro poblacional.
Para profundizar: Wooldridge, J. M. (2020), cap. 2, Teorema 2.1 (insesgadez de \(\hat\beta_1,\hat\beta_2\)).
7. Varianza: cuán dispersas están las estimaciones
Desarrollando el cuadrado (apuntes) y aplicando el Lema anterior: \[ Var[\hat\beta_2\mid\boldsymbol X]=Var\Big[\textstyle\sum_iW_iU_i\,\Big|\,\boldsymbol X\Big]=\sum_iW_i^2\,Var[U_i\mid\boldsymbol X]+\sum_{i\neq j}W_iW_j\,Cov[U_i,U_j\mid\boldsymbol X] \]
Homocedasticidad + \(Cov[U_i,U_j\mid\boldsymbol X]=\mathit 0\) (``El marco'') \(\;\Longrightarrow\;\) \[ Var[\hat\beta_2\mid\boldsymbol X]=\sigma^2\sum_iW_i^2. \]
\[ \boxed{\;Var[\hat\beta_2\mid\boldsymbol X]=\frac{\sigma^2}{\sum_i(X_i-{\overline{X}})^2}=\frac{\sigma^2}{n\,S^2}.\;} \] donde \(S^2=\frac1n\sum_i(X_i-\overline{X})^2\) es la varianza muestral del regresor (divisor \(n\), como en la lección 5).
Más dispersión en \(X\), o más observaciones: más precisión. Mayor varianza de \(U\) (\(\sigma^2\)): menos precisión.
Versión interactiva: cuaderno 4 en MyBinder (muchas muestras, muchas rectas; el histograma de \(\hat\beta_2\) y el efecto de la dispersión de \(\boldsymbol x\)).
Varianza: cuán dispersas están las estimaciones
La insesgadez nos dice que \(\hat\beta_2\) está bien ``centrado'' en \(\beta_2\). Pero un estimador insesgado puede, aun así, ser muy poco fiable en una muestra concreta si su dispersión es grande. Necesitamos, por tanto, calcular \(Var[\hat\beta_2\mid\boldsymbol X]\).
Partimos de \(\hat\beta_2=\beta_2\,\mathit1+\sum_iW_iU_i\). Como \(\beta_2\,\mathit1\) es una variable aleatoria constante: \(Var[\hat\beta_2\mid\boldsymbol X]=Var\big[\sum_iW_iU_i\mid\boldsymbol X\big]\). Nos queda, por tanto, desarrollar la varianza de una suma de \(n\) sumandos. Si su curso de Estadística no llegó a la varianza de una suma, lea antes la regla 3 del apéndice, sección 1.6 (html): aquí se hace la misma cuenta con la esperanza condicional. Lo haremos en dos pasos: primero calculamos la varianza y la covarianza de cada sumando por separado (aquí interviene el Lema), y después desarrollamos la suma completa.
Calculemos primero, para un único sumando, \(Var[W_iU_i\mid\boldsymbol X]\). Ya vimos que \(E[W_iU_i\mid\boldsymbol X]=\mathit0\) (Lema, con \(c(\boldsymbol X)=W_i\)). Por tanto, la definición de varianza condicional (\(Var[Z\mid\boldsymbol X]=E[(Z-E[Z\mid\boldsymbol X])^2\mid\boldsymbol X]\)) se simplifica como en la lección 9 (\(Var[U\mid X]=E[U^2\mid X]\), porque también allí \(E[U\mid X]=\mathit0\)): \[ Var[W_iU_i\mid\boldsymbol X]=E[(W_iU_i)^2\mid\boldsymbol X]=E[W_i^2U_i^2\mid\boldsymbol X]=W_i^2\,E[U_i^2\mid\boldsymbol X]=W_i^2\,Var[U_i\mid\boldsymbol X], \] donde la penúltima igualdad es, de nuevo, el Lema (con \(c(\boldsymbol X)=W_i^2\), sobre \(Z=U_i^2\)), y la última vuelve a usar que \(E[U_i\mid\boldsymbol X]=\mathit0\).
Por el mismo argumento, para \(i\neq j\) (usando la covarianza condicional definida en ``El marco: muestra aleatoria'', \(Cov[Z,W\mid\boldsymbol X]=E[(Z-E[Z\mid\boldsymbol X])(W-E[W\mid\boldsymbol X])\mid\boldsymbol X]\), análoga a la varianza): \[ Cov[W_iU_i,W_jU_j\mid\boldsymbol X]=E[W_iU_iW_jU_j\mid\boldsymbol X]=W_iW_j\,E[U_iU_j\mid\boldsymbol X]=W_iW_j\,Cov[U_i,U_j\mid\boldsymbol X], \] usando el Lema con \(c(\boldsymbol X)=W_iW_j\).
Con estas dos piezas ya podemos desarrollar la suma entera. Abreviando \(Z_i=W_iU_i\) (de modo que \(E[Z_i\mid\boldsymbol X]=\mathit0\) para todo \(i\), como acabamos de comprobar), la definición de varianza condicional da \[ Var\Big[\sum_iZ_i\,\Big|\,\boldsymbol X\Big]=E\Big[\Big(\sum_iZ_i\Big)^2\,\Big|\,\boldsymbol X\Big]=E\Big[\sum_i\sum_jZ_iZ_j\,\Big|\,\boldsymbol X\Big]=\sum_i\sum_jE[Z_iZ_j\mid\boldsymbol X], \] donde solo hemos desarrollado el cuadrado de la suma y usado después la linealidad de la esperanza condicional (recordada junto al Lema, en la sección ``Insesgadez''), aplicada ahora a una suma de \(n^2\) términos. Basta ya con separar los términos de la diagonal (\(i=j\)) del resto: como todas las \(Z_i\) tienen esperanza condicional nula, \(E[Z_iZ_j\mid\boldsymbol X]\) es \(Var[Z_i\mid\boldsymbol X]\) cuando \(i=j\), y \(Cov[Z_i,Z_j\mid\boldsymbol X]\) cuando \(i\neq j\). Sustituyendo en ambos casos las dos piezas calculadas más arriba: \[ Var\Big[\sum_iW_iU_i\,\Big|\,\boldsymbol X\Big]=\sum_iW_i^2\,Var[U_i\mid\boldsymbol X]+\sum_{i\neq j}W_iW_j\,Cov[U_i,U_j\mid\boldsymbol X]. \]
Ahora intervienen, por primera vez en la sesión, la homocedasticidad (\(Var[U_i\mid\boldsymbol X]=\sigma^2\,\mathit 1\) para todo \(i\), supuesto de la lección 9) y la ausencia de covarianza cruzada (\(Cov[U_i,U_j\mid\boldsymbol X]=\mathit 0\) para \(i\neq j\), consecuencia del muestreo aleatorio, sección ``El marco: muestra aleatoria''). Con ambas, la doble suma se reduce a \[ Var[\hat\beta_2\mid\boldsymbol X]=\sigma^2\sum_iW_i^2. \]
Calculemos \(\sum_iW_i^2\). Como \(W_i=\frac{X_i-{\overline{X}}}{\sum_j(X_j-{\overline{X}})^2}\): \[ \sum_iW_i^2=\sum_i\left(\frac{X_i-{\overline{X}}}{\sum_j(X_j-{\overline{X}})^2}\right)^2=\frac{\sum_i(X_i-{\overline{X}})^2}{\left(\sum_j(X_j-{\overline{X}})^2\right)^2}=\frac{1}{\sum_j(X_j-{\overline{X}})^2}. \] Sustituyendo: \[ Var[\hat\beta_2\mid\boldsymbol X]=\frac{\sigma^2}{\sum_i(X_i-{\overline{X}})^2}. \]
Esta expresión admite una segunda lectura, útil para su interpretación. Como \(\sum_i(X_i-{\overline{X}})^2=n\cdot\frac1n\sum_i(X_i-{\overline{X}})^2=n\,S^2\) (la varianza muestral del regresor, con la convención estadística del curso, \(S^2=\frac1n\sum_i(X_i-{\overline{X}})^2\)), podemos escribir, equivalentemente, \[ Var[\hat\beta_2\mid\boldsymbol X]=\frac{\sigma^2}{n\,S^2}. \] Esta segunda forma hace explícitos los tres ingredientes que determinan la precisión de \(\hat\beta_2\). (i) Cuanto mayor sea \(\sigma^2\) (mayor varianza de la perturbación), menor será la precisión. (ii) Cuanto mayor sea \(n\) (más observaciones), mayor será la precisión. (iii) Cuanto mayor sea \(S^2\) (más dispersión en los valores del regresor), mayor será la precisión: una muestra donde \(X\) apenas varía impide medir la pendiente con precisión. Evaluada en la muestra observada, esta varianza es \(\sigma^2\) dividido por \(\|\boldsymbol x-\mu_{\boldsymbol x}\boldsymbol 1\|_e^2\), la longitud euclídea al cuadrado del regresor en desviaciones, el mismo vector con el que la lección 7 calculó la pendiente: cuanto más largo, menor la varianza. Es la forma que usará la lección 12 para el error estándar.
Su curso de Estadística enunció sin demostrar dos propiedades de la media muestral: \(\mathrm{E}(\bar x)=\mu\) y \(\sigma_{\bar x}=\sigma/\sqrt n\), el ``error de muestreo''. El argumento de hoy las demuestra. Tome el modelo con un único regresor, la constante: \(Y_i=\beta_1\,\mathit1+U_i\). Su ajuste es el vector de medias (lección 4), así que el estimador de \(\beta_1\) es la media muestral \(\overline Y=\sum_i\frac1nY_i\): una suma ponderada con pesos \(1/n\), que son números y no variables aleatorias. Sustituyendo el modelo, \(\overline Y=\beta_1\,\mathit1+\sum_i\frac1nU_i\). Su esperanza es \(\beta_1\), porque cada \(U_i\) tiene esperanza cero; y su varianza, por la misma cuenta de esta transparencia con \(W_i=1/n\) y sin necesidad de condicionar, es \(\sum_i\frac1{n^2}\sigma^2=\sigma^2/n\). Son las dos propiedades de su curso con \(\beta_1\) en el papel de \(\mu\). Las dos varianzas tienen la misma forma: la de la media muestral es \(\sigma^2/\Vert\boldsymbol 1\Vert_e^2\), porque \(n=\Vert\boldsymbol 1\Vert_e^2\); la de la pendiente, evaluada en la muestra observada, es \(\sigma^2/\Vert\boldsymbol x-\mu_{\boldsymbol x}\boldsymbol 1\Vert_e^2\). En los dos casos, \(\sigma^2\) dividido por la longitud euclídea al cuadrado de la parte del regresor ortogonal a los demás regresores: en la media muestral, \(\boldsymbol 1\) es el único regresor y esa parte es él entero; en la pendiente, es \(\boldsymbol x-\mu_{\boldsymbol x}\boldsymbol 1\), la parte de \(\boldsymbol x\) ortogonal a \(\boldsymbol 1\). La lección 12 enunciará esta forma para cualquier número de regresores.
Nótese, por último, que \(Var[\hat\beta_2\mid\boldsymbol X]\) es una variable aleatoria, una función de \(\boldsymbol X\): en cada suceso elemental \(\omega\) toma un valor, el número \(\sigma^2\big/\sum_i\big(X_i(\omega)-\overline X(\omega)\big)^2\), mayor o menor según cuánto se dispersen en ese \(\omega\) los valores de las copias. El número que informa un programa es el de la muestra observada. La varianza incondicional, un único número para todas las muestras, sale de la descomposición de la varianza del apéndice, sección 1.3 (html), el Pitágoras de la lección 9 aplicado a \(\hat\beta_2\) condicionando en \(\boldsymbol X\): \[ \mathrm{Var}(\hat\beta_2)=\mathrm{E}\big(Var[\hat\beta_2\mid\boldsymbol X]\big)+\mathrm{Var}\big(E[\hat\beta_2\mid\boldsymbol X]\big). \] El segundo sumando es cero, porque \(E[\hat\beta_2\mid\boldsymbol X]=\beta_2\,\mathit1\) es constante (sección ``Insesgadez''); el primero, \(\mathrm{E}\big(\sigma^2/(nS^2)\big)\), depende de la distribución de \(X\) y no tiene una fórmula general. Por eso, en la práctica y en el resto del curso, se trabaja con la fórmula condicional evaluada en la muestra observada: es lo que hace cualquier programa estadístico al informar del error estándar de un coeficiente.
Para profundizar: Wooldridge, J. M. (2020), cap. 2, Teorema 2.2 (varianza de \(\hat\beta_1,\hat\beta_2\) bajo los supuestos SLR.1-SLR.5).
8. MCO es BLUE; estimando \(\sigma^2\)
Enunciado (Gauss–Markov; demostración en el apéndice): de entre todos los estimadores lineales e insesgados de \(\beta_2\), \(\hat\beta_2\) tiene la menor varianza: MCO es BLUE (Best Linear Unbiased Estimator).
\(\sigma^2\) (desconocido) se estima con la cuasivarianza de los residuos, un tercer producto escalar, tras el euclídeo y el estadístico: \[ \langle\cdot,\cdot\rangle_{n-k}=\frac1{n-k}\langle\cdot,\cdot\rangle_{e}, \qquad \mathfrak{s}^2=\langle\boldsymbol{\mathop{\widehat{e}}},\boldsymbol{\mathop{\widehat{e}}}\rangle_{n-k}=\frac{\mathrm{SRC}}{n-k}. \]
Por qué \(n-k\): el residuo vive en un subespacio de dimensión \(n-k\) (lección 10); en una base ortonormal, \(\mathrm{SRC}\) es una suma de \(n-k\) cuadrados, cada uno de esperanza \(\sigma^2\) (apéndice, sección 7.2). Con \(k=1\): el divisor \(n-1\) de su curso de Estadística.
Tres divisores, tres motivos distintos: \(1\) (geometría euclídea), \(n\) (para que \(\|\boldsymbol1\|_s=1\), lección 4), \(n-k\) (para que \(\mathfrak s^2\) sea un estimador insesgado de \(\sigma^2\)).
MCO es BLUE; estimando \(\sigma^2\)
Con insesgadez y varianza ya establecidas, cerramos con dos observaciones que esta sesión enuncia y el apéndice demuestra, y que conviene conocer.
La primera es el Teorema de Gauss–Markov: bajo los tres supuestos del Modelo Clásico de Regresión Lineal (y el muestreo aleatorio de esta sesión), \(\hat\beta_2\) no es solo insesgado; es, además, el estimador de menor varianza entre todos los estimadores lineales e insesgados. Lineal quiere decir de la forma \(\sum_iC_iY_i\), donde \(Y_1,\ldots,Y_n\) son la muestra aleatoria (no los datos observados \(y_1,\ldots,y_n\)) y los pesos \(C_i\) no dependen de \(\boldsymbol Y\) (van con mayúscula porque, igual que los \(W_i\), pueden ser funciones de \(\boldsymbol X\)). Este resultado se resume con el acrónimo BLUE (Best Linear Unbiased Estimator, ``el mejor estimador lineal insesgado''). La demostración está en el apéndice (sección 7.3) (html) y no necesita matrices. Aquí basta con lo que dice: cualquier otra regla que combine linealmente las \(Y_i\) y esté centrada en \(\beta_2\) tiene más varianza que \(\hat\beta_2\). Es la justificación teórica de la elección de mínimos cuadrados entre los estimadores lineales e insesgados.
La segunda observación es más práctica: la fórmula \(Var[\hat\beta_2\mid\boldsymbol X]=\sigma^2/\sum_i(X_i-{\overline{X}})^2\) depende de \(\sigma^2\), la varianza de la perturbación poblacional, que no conocemos. Para usarla en la práctica (algo que haremos en la lección 12, al construir errores estándar) necesitamos estimar \(\sigma^2\) a partir de los residuos \(\boldsymbol{\mathop{\widehat e}}\). Estos residuos observados se interpretan aquí como la realización, sobre nuestra muestra concreta, de la lista de residuos \((\hat E_1,\ldots,\hat E_n)\), con \(\hat E_i=Y_i-\hat\beta_1\,\mathit1-\hat\beta_2X_i\); es el mismo paso de variable aleatoria a dato que hemos dado varias veces en esta sesión. Esas componentes aproximan, sin ser idénticas a ellas, a las perturbaciones \(U_i\) del modelo poblacional.9
La estimación natural sería \(\langle\boldsymbol{\mathop{\widehat e}},\boldsymbol{\mathop{\widehat e}}\rangle_s=\mathrm{SRC}/n\), la varianza de los residuos con nuestra convención habitual. Pero ese estimador, la misma fórmula evaluada sobre la lista de residuos \((\hat E_1,\ldots,\hat E_n)\), es sesgado: subestima \(\sigma^2\) en promedio.10 La razón es geométrica. Véala primero en el caso que su curso de Estadística ya usaba. Con la constante como único regresor, el residuo es el vector en desviaciones, que vive en \(\mathcal L(\boldsymbol 1)^\perp\), de dimensión \(n-1\) (lección 4); \(\mathrm{SRC}=\sum_i(U_i-\overline U)^2\) tiene esperanza \((n-1)\sigma^2\) (apéndice, sección 7.2 (html)), y dividir por \(n-1\) da un estimador insesgado: es el divisor \(n-1\) con el que su curso de Estadística definía la varianza de la muestra. Allí se dio sin motivo; el motivo es este. Con \(k\) regresores, por las ecuaciones normales (lección 10), los residuos viven en el subespacio ortogonal a las columnas de \(\boldsymbol{\mathsf X}\), que tiene dimensión \(n-k\) (apéndice, sección 5.1 (html)); en una base ortonormal de ese subespacio, \(\mathrm{SRC}\) es una suma de \(n-k\) cuadrados, y cada uno, evaluado sobre la muestra aleatoria, tiene esperanza \(\sigma^2\) (de nuevo el apéndice, sección 7.2). Así que \(\mathrm{SRC}\) tiene esperanza \((n-k)\sigma^2\), \(\mathrm{SRC}/n\) subestima \(\sigma^2\), y dividir por \(n-k\) es lo que da un estimador insesgado.
Ese divisor introduce un tercer producto escalar en la familia que el curso construye desde la lección 2: junto al euclídeo \(\langle\cdot,\cdot\rangle_e\) (divisor \(1\)) y al estadístico \(\langle\cdot,\cdot\rangle_s=\langle\cdot,\cdot\rangle_n\) (divisor \(n\)), definimos \[ \langle\boldsymbol v,\boldsymbol w\rangle_{n-k}=\frac{1}{n-k}\langle\boldsymbol v,\boldsymbol w\rangle_e. \] Sigue siendo un producto escalar (multiplicar por una constante positiva conserva la simetría, la linealidad y la positividad),11 y con él definimos la cuasivarianza de los residuos \[ \mathfrak s^2=\langle\boldsymbol{\mathop{\widehat e}},\boldsymbol{\mathop{\widehat e}}\rangle_{n-k}=\frac{\mathrm{SRC}}{n-k}, \] que es un estimador insesgado de \(\sigma^2\), por el argumento del apéndice (sección 7.2) resumido más arriba. Los tres divisores tienen motivos distintos. El \(1\) es la geometría euclídea. El \(n\) se eligió en la lección 4 para que \(\|\boldsymbol1\|_s=1\), un motivo geométrico. El \(n-k\) se elige por un motivo estadístico, la insesgadez, y su lectura geométrica es la razón: la dimensión del subespacio donde vive \(\boldsymbol{\mathop{\widehat e}}\), el número de coordenadas del vector de residuos que entran en \(\mathrm{SRC}\). Los manuales de estadística escriben esta cantidad \(s^2\). Aquí usamos la ese gótica, \(\mathfrak s^2\), para que no se confunda con la varianza muestral \(S^2\) de esta lección, que divide por \(n\).
La expresión \(n-k\) recibe, en la terminología habitual de la estadística, el nombre de grados de libertad del modelo: el número de observaciones menos el número de parámetros ya estimados. En esta sesión, con dos regresores en total, \(k=2\), así que \(\mathfrak s^2=\mathrm{SRC}/(n-2)\). Volveremos sobre los grados de libertad, con más detalle, en la lección 12.
Para profundizar:
- Wooldridge, J. M. (2020), cap. 2, Teorema 2.2 (parte final: BLUE) y cap. 3, sección 3.5 (Teorema de Gauss-Markov, versión general con \(k\) regresores).
- Wooldridge, J. M. (2020), cap. 3, sección 3.4 (estimación insesgada de \(\sigma^2\), grados de libertad).
9. ¿Y con más regresores?
Sin demostrarlo (generalización matricial de lo probado hoy; recordando la notación de la lección 10 y su extensión aleatoria de ``El marco''): \[ E[\boldsymbol{\mathop{\widehat{\beta}}}\mid\boldsymbol X]=\boldsymbol\beta\,\mathit1,\qquad Var[\boldsymbol{\mathop{\widehat{\beta}}}\mid\boldsymbol X]=\sigma^2(\boldsymbol X^\top\boldsymbol X)^{-1}. \]
En la diagonal de esta matriz están \(Var[\hat\beta_1\mid\boldsymbol X],\ldots,Var[\hat\beta_k\mid\boldsymbol X]\); fuera de la diagonal, las covarianzas \(Cov[\hat\beta_i,\hat\beta_j\mid\boldsymbol X]\).
Para \(k=2\), el elemento \((2,2)\) de esta fórmula matricial se reduce a lo que hoy hemos demostrado sin matrices (y los otros tres elementos dan lo que no hemos calculado).
Evaluada en la muestra observada (\(\boldsymbol X\) en el \(\omega\) que ocurrió es \(\boldsymbol{\mathsf X}\)) y con \(\sigma^2\) sustituida por su estimación \(\mathfrak s^2\) (transparencia anterior), es la fórmula que calculan los programas estadísticos: \[ \mathfrak s^2(\boldsymbol{\mathsf X}^\top\boldsymbol{\mathsf X})^{-1}. \]
¿Y con más regresores?
Todo lo demostrado en esta sesión se ha limitado, deliberadamente, al caso con dos regresores: la constante \(\mathit1\) y un único regresor no constante \(X\). Con \(k\) regresores (lección 10), el resultado análogo existe, y su enunciado, sin demostración, es la generalización matricial natural de lo que hoy hemos probado: \[ E[\boldsymbol{\mathop{\widehat{\beta}}}\mid\boldsymbol X]=\boldsymbol\beta\,\mathit1,\qquad Var[\boldsymbol{\mathop{\widehat{\beta}}}\mid\boldsymbol X]=\sigma^2(\boldsymbol X^\top\boldsymbol X)^{-1}. \] Aquí \(\boldsymbol X\) es la misma matriz aleatoria de regresores que fijamos al abrir la sesión, solo que ahora con \(k\) columnas en lugar de dos; \(\boldsymbol{\mathsf X}\) sigue denotando, como en la lección 10, la matriz de regresores observada. La primera igualdad generaliza la insesgadez de la sección ``Insesgadez'': \(\boldsymbol\beta\,\mathit1\) denota el vector cuyas componentes son las variables aleatorias constantes \(\beta_1\,\mathit1,\ldots,\beta_k\,\mathit1\), el análogo, para un vector de parámetros, de la constante \(\beta_2\,\mathit1\) que obtuvimos en la sección ``Insesgadez''. La segunda generaliza la varianza de la sección ``Varianza'': es una matriz \(k\times k\) que ocupa el lugar que antes ocupaba el escalar \(1/\sum_i(X_i-{\overline{X}})^2\); en su diagonal contiene las varianzas \(Var[\hat\beta_1\mid\boldsymbol X],\ldots,Var[\hat\beta_k\mid\boldsymbol X]\) (con \(Var[\hat\beta_2\mid\boldsymbol X]\) como caso particular, ya conocido, en la posición \((2,2)\)), y fuera de la diagonal, las covarianzas \(Cov[\hat\beta_i,\hat\beta_j\mid\boldsymbol X]\) entre cada par de coeficientes. Esta fórmula matricial se enuncia sin demostrar. Lo que sí está demostrado con material del curso, en el apéndice, sección 7.1 (html), es su diagonal: la insesgadez y la varianza de cada coeficiente por separado, con cualquier número de regresores, usando la parte propia del regresor que define la lección 14.
Al evaluar esta fórmula en una muestra ya observada, la matriz aleatoria \(\boldsymbol X\) toma su valor en el \(\omega\) que ocurrió, la matriz de regresores observada \(\boldsymbol{\mathsf X}\), con lo que queda por calcular \((\boldsymbol{\mathsf X}^\top\boldsymbol{\mathsf X})^{-1}\). Multiplicada por \(\mathfrak s^2\) (la estimación de \(\sigma^2\) de ``MCO es BLUE; estimando \(\sigma^2\)'', pues \(\sigma^2\) sigue siendo desconocido) da \(\mathfrak s^2(\boldsymbol{\mathsf X}^\top\boldsymbol{\mathsf X})^{-1}\): la fórmula que Gretl (y cualquier otro programa estadístico) usa internamente para calcular los errores estándar que veremos en la lección 12.
Es razonable preguntarse si esta fórmula, presentada aquí sin demostración, es compatible con lo que sí hemos demostrado hoy. La respuesta es sí, y podemos comprobarlo con un cálculo elemental. Para \(k=2\) (constante más un único regresor no constante), la matriz \(\boldsymbol{X}^\top\boldsymbol{X}\) (análogo aleatorio de la \(\boldsymbol{\mathsf X}^\top\boldsymbol{\mathsf X}\) de la lección 10) es \[ \boldsymbol{X}^\top\boldsymbol{X}=\begin{pmatrix}n\,\mathit1 & n\overline{X}\\ n\overline{X} & \sum_iX_i^2\end{pmatrix}. \] Usando la fórmula general para invertir una matriz \(2\times2\), obtenemos12 \[ (\boldsymbol{X}^\top\boldsymbol{X})^{-1}=\frac{1}{n\sum_i(X_i-\overline{X})^2}\begin{pmatrix}\sum_iX_i^2 & -n\overline{X}\\ -n\overline{X} & n\,\mathit1\end{pmatrix}. \] El elemento \((2,2)\) de esta matriz, el que corresponde a la varianza condicional del segundo coeficiente, \(\hat\beta_2\), vale \(n\,\mathit1\big/\big(n\sum_i(X_i-\overline{X})^2\big)=\mathit1\big/\sum_i(X_i-\overline{X})^2\). Multiplicando por \(\sigma^2\): \[ \sigma^2\big[(\boldsymbol{X}^\top\boldsymbol{X})^{-1}\big]_{22}=\frac{\sigma^2}{\sum_i(X_i-\overline{X})^2}, \] la fórmula de la sección ``Varianza''. Además, la misma matriz da las otras dos cantidades que esta sesión no ha llegado a calcular, al habernos centrado, como anunciamos en la primera transparencia, en \(\hat\beta_2\): el elemento \((1,1)\), multiplicado por \(\sigma^2\), da \(Var[\hat\beta_1\mid\boldsymbol{X}]=\sigma^2\sum_iX_i^2\big/\big(n\sum_i(X_i-\overline{X})^2\big)\); y el elemento \((1,2)=(2,1)\), multiplicado por \(\sigma^2\), da \(Cov[\hat\beta_1,\hat\beta_2\mid\boldsymbol{X}]=-\sigma^2\overline{X}\big/\sum_i(X_i-\overline{X})^2\). La generalización matricial, aunque no la hayamos demostrado, es consistente con todo lo que sí hemos probado en esta sesión, y añade dos fórmulas más que no habíamos calculado en la lección.
Para profundizar: Wooldridge, J. M. (2020), Apéndice E.2 (fórmulas matriciales de insesgadez y varianza para el modelo de regresión múltiple).
10. Recapitulación y guiño a la sesión siguiente
| Propiedad | Resultado (regresión simple, \(k=2\)) | Supuestos usados |
|---|---|---|
| Insesgadez | \(\mathrm{E}(\hat\beta_2)=\beta_2\) | Linealidad + \(\mathrm{Var}(X)\neq0\) + muestreo aleatorio |
| Varianza | \(Var[\hat\beta_2\mid\boldsymbol X]=\frac{\sigma^2}{\sum_i(X_i-{\overline{X}})^2}\) | + Homocedasticidad (+ \(Cov[U_i,U_j\mid\boldsymbol X]=\mathit0\), del muestreo aleatorio) |
| Eficiencia | MCO es BLUE (mejor entre los lineales e insesgados) | Los tres + muestreo aleatorio (Gauss–Markov, apéndice) |
Casi nada nuevo: la fórmula de la pendiente (lección 7), la esperanza condicional y la independencia entre observaciones (lección 9). Lo único nuevo: evaluar la fórmula sobre variables aleatorias, no sobre datos; eso, y solo eso, convierte \(\hat\beta_2\) en un estimador.
Nota: los mismos argumentos, sobre \(\hat\beta_1=\overline{Y}-\hat\beta_2{\overline{X}}\), prueban la insesgadez de \(\hat\beta_1\).
Lección 12: ya conocemos el valor esperado y la varianza de \(\hat\beta_2\); para intervalos de confianza y contrastes hace falta algo más: la forma de su distribución.
Recapitulación y guiño a la sesión siguiente
Esta sesión tiene pocos ingredientes nuevos. Hemos demostrado dos propiedades, insesgadez y varianza de \(\hat\beta_2\), con piezas que ya teníamos. La fórmula de la pendiente de la lección 7, covarianza sobre varianza, nos dio \(\hat\beta_2\) como suma ponderada de los datos, \(\sum_iw_iy_i\). La esperanza condicional de la lección 9 nos permitió tomar esperanzas y varianzas ``condicionando en \(\boldsymbol X\)''. Y la independencia entre observaciones, anunciada en esa misma lección 9 (``copias idénticas e independientes''), nos dio la incorrelación entre perturbaciones.
Lo único nuevo es esto: tomar una fórmula ARITMÉTICA ya obtenida (geométricamente, en la lección 7, sobre datos fijos) y evaluarla en variables aleatorias en lugar de en datos. Eso es lo que convierte una estimación (un número, calculado a partir de una muestra concreta) en un estimador (una variable aleatoria, cuya distribución depende de qué muestra hubiéramos observado). Hemos sustituido números por variables aleatorias dentro de una fórmula ya conocida, y hemos reservado la herramienta probabilística de la lección 9 (esperanza condicional, independencia) para el momento en que era necesaria: al tomar esperanzas y varianzas de esa expresión calculada sobre una muestra aleatoria.
La tabla resume las dos propiedades centrales, junto con los supuestos exactos que cada una requiere: la insesgadez solo necesita linealidad y \(\mathrm{Var}(X)\neq0\) (más el muestreo aleatorio, que es lo que eleva la exogeneidad estricta al condicionamiento en toda la matriz \(\boldsymbol X\)); la varianza necesita, además, homocedasticidad y la ausencia de covarianza cruzada entre perturbaciones (también consecuencia del muestreo aleatorio). Conviene tener presente esta jerarquía: cada propiedad exige un subconjunto distinto de los tres supuestos del Modelo Clásico. Si se pusiera en duda alguno de ellos (la homocedasticidad, por ejemplo), sabríamos qué propiedad de \(\hat\beta_2\) deja de estar garantizada y cuál sigue intacta.
Queda, sin embargo, una limitación importante que esta sesión no resuelve. Saber que \(\hat\beta_2\) está bien centrado en \(\beta_2\) (insesgadez) y saber cuánto se dispersa alrededor de ese centro (varianza) NO basta para responder preguntas del tipo ``si \(\beta_2\) valiese cero, ¿sería \(\hat\beta_2=0{,}5\) una estimación demasiado rara?'' o ``¿en qué rango de valores podemos confiar razonablemente que está el verdadero \(\beta_2\)?''. Para responderlas (son los contrastes de hipótesis y los intervalos de confianza que ocuparán buena parte del resto del curso) no basta con el valor esperado y la varianza de \(\hat\beta_2\): hace falta conocer, además, la forma completa de su distribución. Esa es la tarea de la lección 12: enunciar, apoyándonos en un supuesto adicional sobre la distribución de la perturbación \(U\), la distribución de \(\hat\beta_2\) (la demostración está en el apéndice (sección 9) (html)), y a partir de ella construir el error estándar, el intervalo de confianza y el contraste \(t\).
Para profundizar: Wooldridge, J. M. (2020), cap. 2, sección 2.5 (Teoremas 2.1 y 2.2) y cap. 3, secciones 3.3 y 3.4 (los mismos resultados con \(k\) regresores).
11. Apéndice: lanzar una moneda infinitas veces
Material complementario. Este apartado respondía a una pregunta que la lección 9 dejó abierta y que esta lección ha usado sin discutir: de dónde salen las copias idénticas e independientes de una variable aleatoria, y qué significa, en el lenguaje geométrico del curso, que sean independientes. La respuesta, con el ejemplo de la moneda (el intervalo \([0,1]\) con la longitud como probabilidad, y la moneda \(n\)-ésima como la cifra binaria \(n\)-ésima de \(\omega\)), está ahora en el apéndice ``Estructura geométrica de la probabilidad y de la inferencia en el modelo de regresión'' (html), secciones 1.5 (independientes es ``a escuadra''), 2 (la moneda) y 3 (la matriz de copias: filas, columnas y vectores de \(\mathbb R^n\)). Lo esencial cabe en dos frases: ``\(n\) copias idénticas e independientes'' no es un supuesto sobre el mundo, sino una construcción, porque dada cualquier variable existe un \(\Omega\) en el que caben tantas copias como se quiera; lo que sí es un supuesto es que nuestros datos sean una realización de esas copias, y ese supuesto es el muestreo aleatorio de esta lección.
12. Preguntas de repaso (sesión 15) htmlonly
Le propongo 12 preguntas. Las marco con un nivel orientativo: [B] básica, [M] media, [D] discriminadora.
Comentario
Las preguntas que más le conviene trabajar son la 7 (la Ley de las Esperanzas Iteradas es una consecuencia inmediata de la definición geométrica de esperanza condicional de la lección 9) y la 9 (la incorrelación entre perturbaciones es una consecuencia del muestreo aleatorio anunciado en esa misma lección). La 12 le pide distinguir qué se ha demostrado hoy y qué se ha enunciado solo por analogía matricial. Repase también la 8: la lectura de la fórmula de la varianza (qué la hace grande o pequeña) es la que más usará en las prácticas de laboratorio.
Pregunta 1 [B] — Estimador vs. estimación
La distinción entre \(\hat\beta_2(\boldsymbol X,\boldsymbol Y)\) y \(\hat\beta_2(\boldsymbol x,\boldsymbol y)\) es:
- Una diferencia sin importancia, ambas notaciones significan siempre lo mismo.
- \(\hat\beta_2(\boldsymbol X,\boldsymbol Y)\) es el estimador (variable aleatoria); \(\hat\beta_2(\boldsymbol x,\boldsymbol y)\) es la estimación (un número).
- \(\hat\beta_2(\boldsymbol X,\boldsymbol Y)\) es la estimación; \(\hat\beta_2(\boldsymbol x,\boldsymbol y)\) es el estimador.
- Solo tiene sentido hablar de \(\hat\beta_2(\boldsymbol x,\boldsymbol y)\); el estimador no existe como objeto matemático.
Pregunta 2 [B] — El supuesto de muestreo aleatorio
La condición \(Cov[U_i,U_j\mid\boldsymbol X]=\mathit 0\) para \(i\neq j\) es:
- Un supuesto completamente nuevo, no relacionado con nada visto antes.
- Consecuencia de la homocedasticidad.
- Consecuencia de la independencia entre observaciones (``copias idénticas e independientes''), ya anunciada en la lección 9.
- Una consecuencia de la insesgadez de \(\hat\beta_2\).
Pregunta 3 [M] — Origen de los pesos \(W_i\)
Los pesos \(W_i=(X_i-{\overline{X}})/\sum_j(X_j-{\overline{X}})^2\) que aparecen en \(\hat\beta_2(\boldsymbol X,\boldsymbol Y)=\sum_iW_iY_i\) provienen de:
- Una definición completamente nueva, exclusiva de esta sesión.
- Evaluar, sobre la muestra aleatoria, la MISMA fórmula aritmética que la lección 7 obtuvo geométricamente sobre datos fijos.
- El teorema de Gauss-Markov.
- La cuasivarianza de los residuos.
Pregunta 4 [M] — Las dos propiedades de los pesos
La propiedad \(\sum_iW_i=\mathit 0\) se deduce de:
- La homocedasticidad de la perturbación.
- Que \(X_i-{\overline{X}}\) suma cero por pura aritmética: la misma cuenta que en la lección 4, aplicada ahora a \(n\) variables aleatorias en lugar de a \(n\) datos.
- Que \(\hat\beta_2\) es insesgado.
- La independencia entre \(U_i\) y \(U_j\).
Pregunta 5 [M] — El paso de sustitución
Al sustituir \(Y_i=\beta_1\,\mathit1+\beta_2X_i+U_i\) en \(\hat\beta_2=\sum_iW_iY_i\), el término con \(\beta_1\) desaparece porque:
- \(\beta_1\) siempre vale cero.
- \(\sum_iW_i=\mathit 0\).
- \(\sum_iW_iX_i=\mathit 1\).
- \(W_i\) no depende de \(\beta_1\).
Pregunta 6 [M] — ``Sacar lo que se conoce''
La propiedad \(E[c(\boldsymbol X)Z\mid\boldsymbol X]=c(\boldsymbol X)E[Z\mid\boldsymbol X]\), usada para justificar que \(W_i\) ``sale'' de la esperanza condicionada, se demuestra (en el apéndice):
- Citando un teorema de un curso de probabilidad más avanzado, no visto en esta asignatura.
- A partir de la propia definición de \(E[Z\mid\boldsymbol X]\) como proyección ortogonal sobre las funciones de \(\boldsymbol X\).
- Solo es válida si \(Z\) es independiente de \(\boldsymbol X\).
- Es una consecuencia de la homocedasticidad.
Pregunta 7 [D] — Ley de las esperanzas iteradas
La igualdad \(\mathrm{E}\big(E[Z\mid\boldsymbol X]\big)=\mathrm{E}(Z)\) se justifica en esta sesión porque:
- Es un axioma que se acepta sin más.
- \(\mathit1\) es una función de \(\boldsymbol X\), y \(E[Z\mid\boldsymbol X]\) se define como la proyección de \(Z\) sobre todas las funciones de \(\boldsymbol X\); por tanto \(Z-E[Z\mid\boldsymbol X]\perp\mathit1\).
- Solo es cierta cuando \(Z=\hat\beta_2\).
- Es consecuencia de la homocedasticidad.
Pregunta 8 [M] — Lectura de la fórmula de la varianza
Según \(Var[\hat\beta_2\mid\boldsymbol X]=\sigma^2/(nS^2)\), la precisión de \(\hat\beta_2\) (menor varianza) aumenta cuando:
- \(\sigma^2\) aumenta.
- \(n\) disminuye.
- \(S^2\) (la varianza muestral del regresor) aumenta.
- \(\beta_2\) aumenta.
Pregunta 9 [D] — Por qué hace falta la incorrelación entre perturbaciones
Si \(Cov[U_i,U_j\mid\boldsymbol X]\neq\mathit0\) para algún \(i\neq j\), ¿qué parte de la derivación de esta sesión dejaría de ser válida?
- La insesgadez de \(\hat\beta_2\).
- Nada; todo el desarrollo es independiente de este supuesto.
- La fórmula de la varianza, \(Var[\hat\beta_2\mid\boldsymbol X]=\sigma^2/\sum_i(X_i-{\overline{X}})^2\), que dejaría de reducirse a esa expresión tan simple.
- La propia definición de \(\hat\beta_2\) como combinación lineal de los datos.
Pregunta 10 [M] — El tercer producto escalar
El divisor \(n-k\) de \(\langle\cdot,\cdot\rangle_{n-k}\) se elige, a diferencia del divisor \(n\) de \(\langle\cdot,\cdot\rangle_s\), por un motivo:
- Geométrico, igual que el divisor \(n\) (para que \(\|\boldsymbol1\|_s=1\)).
- Estadístico: para que \(\mathfrak s^2=\mathrm{SRC}/(n-k)\) sea un estimador insesgado de \(\sigma^2\).
- Arbitrario, sin ninguna justificación.
- Relacionado con el teorema de Gauss-Markov.
Pregunta 11 [B] — Gauss-Markov
Que MCO sea BLUE significa que:
- \(\hat\beta_2\) acierta siempre el verdadero valor de \(\beta_2\).
- \(\hat\beta_2\) tiene la menor varianza entre todos los estimadores lineales e insesgados de \(\beta_2\).
- \(\hat\beta_2\) es el único estimador insesgado posible.
- \(\hat\beta_2\) no depende de los supuestos del modelo clásico.
Pregunta 12 [D] — Qué está demostrado y qué no
Respecto a la generalización a \(k\) regresores (\(E[\boldsymbol{\mathop{\widehat{\beta}}}\mid\boldsymbol X]=\boldsymbol\beta\,\mathit1\), \(Var[\boldsymbol{\mathop{\widehat{\beta}}}\mid\boldsymbol X]=\sigma^2(\boldsymbol X^\top\boldsymbol X)^{-1}\)), esta sesión:
- La demuestra íntegramente, generalizando paso a paso el argumento de los pesos \(W_i\).
- La presenta como aserción, sin demostrarla, y solo verifica, con un cálculo elemental de una inversa \(2\times2\), que es consistente con lo demostrado para \(k=2\).
- No la menciona en absoluto.
- La demuestra solo para el caso \(k=3\).
13. Respuestas htmlonly
- Pregunta 1 [B] — Estimador vs. estimación
Respuesta correcta: 2. Evalúa: retención de la distinción notacional introducida al abrir la sesión, necesaria para hablar con propiedad de la distribución de \(\hat\beta_2\).
- Pregunta 2 [B] — El supuesto de muestreo aleatorio
Respuesta correcta: 3. Evalúa: reconocimiento de que la incorrelación entre perturbaciones no es un supuesto añadido, sino consecuencia de algo ya anunciado en la lección 9.
- Pregunta 3 [M] — Origen de los pesos \(W_i\)
Respuesta correcta: 2. Evalúa: comprensión de que hoy no se repite ninguna demostración geométrica; se reutiliza, sobre variables aleatorias, la fórmula aritmética que la lección 7 ya obtuvo.
- Pregunta 4 [M] — Las dos propiedades de los pesos
Respuesta correcta: 2. Evalúa: reconocimiento de que \(\sum_iW_i=\mathit 0\) es un hecho algebraico (la misma cuenta que ya vimos en la lección 4), no una propiedad geométrica de un supuesto ``espacio de variables aleatorias-vector''.
- Pregunta 5 [M] — El paso de sustitución
Respuesta correcta: 2. Evalúa: seguimiento del paso algebraico central de la sección ``Sustituyendo el modelo poblacional''.
- Pregunta 6 [M] — ``Sacar lo que se conoce''
Respuesta correcta: 2. Evalúa: comprensión de que esta propiedad, aunque parezca un resultado estándar, se deduce, en el apéndice (sección 1.3), de nuestra propia definición geométrica de esperanza condicional.
- Pregunta 7 [D] — Ley de las esperanzas iteradas
Respuesta correcta: 2. Evalúa: comprensión de que la Ley de las Esperanzas Iteradas no es un teorema citado desde fuera, sino consecuencia inmediata de la definición de esperanza condicional como proyección (lección 9).
- Pregunta 8 [M] — Lectura de la fórmula de la varianza
Respuesta correcta: 3. Evalúa: interpretación correcta de los tres ingredientes (\(\sigma^2\), \(n\), \(S^2\)) de la fórmula de la varianza, clave para las prácticas de laboratorio venideras.
- Pregunta 9 [D] — Por qué hace falta la incorrelación entre perturbaciones
Respuesta correcta: 3. Evalúa: identificación precisa de qué parte de la demostración depende de qué supuesto (la insesgadez se mantiene; la simplicidad de la fórmula de varianza, no).
- Pregunta 10 [M] — El tercer producto escalar
Respuesta correcta: 2. Evalúa: distinción entre los motivos geométrico y estadístico de los tres divisores usados en el curso.
- Pregunta 11 [B] — Gauss-Markov
Respuesta correcta: 2. Evalúa: comprensión de qué garantiza y qué no garantiza el teorema de Gauss-Markov.
- Pregunta 12 [D] — Qué está demostrado y qué no
Respuesta correcta: 2. Evalúa: el alcance exacto de la sesión: qué se demuestra con detalle (k=2) y qué se asevera por generalización, con una única verificación puntual (la diagonal de la matriz sí está demostrada, sin matrices, en el apéndice, sección 7.1).
Notas al pie de página:
Denotada en negrita cursiva pero sin letra de palo seco (reservada para las matrices con números).
Copias idénticas quiere decir con la misma distribución, no la misma función sobre \(\Omega\): dos copias independientes toman, en general, valores distintos en un mismo suceso elemental. Qué son las copias y de dónde salen está en el apéndice, secciones 2 (html) y 3.
Ese ``sin supuesto adicional'' merece hoy una precisión, que da el párrafo que sigue a la fórmula. La demostración, que obtiene del mismo modo la homocedasticidad y la incorrelación condicionadas a \(\boldsymbol X\), está en el apéndice, sección 6.1 (html).
Notación. Esta es la primera vez en el curso que aparece una covarianza condicionada. Sigue el mismo convenio que ya fijamos en la lección 9 para la esperanza y la varianza: \(\mathrm{Cov}(\cdot,\cdot)\), con paréntesis y en recta, es un número (la covarianza no condicionada); \(Cov[\cdot,\cdot\mid\cdot]\), con corchetes y en cursiva, es una variable aleatoria, una función de aquello sobre lo que se condiciona. Su definición es la análoga de la varianza condicional: \(Cov[Z,W\mid\boldsymbol X]=E\big[(Z-E[Z\mid\boldsymbol X])(W-E[W\mid\boldsymbol X])\mid\boldsymbol X\big]\). La usaremos efectivamente al calcular la varianza de \(\hat\beta_2\).
Una función de \(\omega\in\Omega\), donde \(\Omega\) es el espacio de sucesos.
En la literatura estadística y econométrica es costumbre usar la misma notación para ambos objetos (la estimación y el estimador), pero recuerde que son muy distintos (un número el primero y una variable aleatoria el segundo).
El nombre de suma ponderada es abusivo: en \(\sum_{i=1}^n {W_i}Y_i\) las ponderaciones \(W_i\) no son números sino variables aleatorias. Por el mismo motivo lo es ``combinación lineal de las \(Y_i\)'', que los manuales usan al hablar de estimadores lineales (transparencia ``MCO es BLUE; estimando \(\sigma^2\)''); mantenemos ese nombre sabiendo lo que son los \(W_i\).
Con una salvedad: en los sucesos elementales \(\omega\) en los que las \(n\) copias toman el mismo valor, \(X_1(\omega)=\cdots=X_n(\omega)\), el denominador \(\sum_j\big(X_j(\omega)-\overline{X}(\omega)\big)^2\) vale \(0\) y \(W_i(\omega)\) no está definido. No es que las copias sean iguales como funciones, son copias distintas; es que en esa muestra han tomado todas el mismo valor. Todo lo que sigue se entiende condicionado a que el regresor varíe en la muestra observada, igual que un programa estadístico no calcula la pendiente cuando no varía.
Esta es la posición de Eros con la que abríamos la lección 9: ni conocemos \(U_i\) (eso sería la posición del dios), ni carecemos de toda información sobre ella (la posición del ignorante); \(\hat E_i\) es lo que tenemos en lugar de \(U_i\): una función de la muestra aleatoria, cuya realización, el residuo \(\hat e_i\), sí se calcula con los datos, y que bajo los supuestos del modelo tiene, como \(U_i\), esperanza condicional nula.
Seguimos la convención del resto de esta sección: escribimos las fórmulas con los residuos observados \(\boldsymbol{\mathop{\widehat e}}\) aunque hablemos de propiedades, como el sesgo, que son del estimador. Es el abuso de notación ya señalado al distinguir estimador de estimación.
El subíndice indica por qué número se divide. Con ese criterio los tres productos escalares del curso admiten una notación unificada: \(\langle\cdot,\cdot\rangle_e=\langle\cdot,\cdot\rangle_1\), \(\langle\cdot,\cdot\rangle_s=\langle\cdot,\cdot\rangle_n\) y \(\langle\cdot,\cdot\rangle_{n-k}\). Mantendremos los subíndices \(e\) y \(s\), ya habituales, pero conviene saber que la familia es una sola.
\(\begin{pmatrix}a&b\\c&d\end{pmatrix}^{-1}=\dfrac{1}{ad-bc}\begin{pmatrix}d&-b\\-c&a\end{pmatrix}\), con \(a=n\,\mathit1\), \(b=c=n\overline{X}\), \(d=\sum_iX_i^2\), y usando que \(ad-bc=n\sum_iX_i^2-n^2\overline{X}^2=n\sum_i(X_i-\overline{X})^2\) (la ``fórmula de cálculo'' de la varianza, lección 5, evaluada sobre \(\boldsymbol{X}\) y multiplicada por \(n\)).