Lección 10. Regresión múltiple: de dos ortogonalidades a $k$
Author: Marcos Bujosa
Generalizamos la regresión a cualquier número de regresores. La geometría sigue siendo idéntica (la ortogonalidad lo gobierna todo), pero el sistema de ecuaciones crece. Para no asfixiarnos en sumatorios, introducimos una notación matricial natural basada en un operador selector. Descubriremos que el álgebra de matrices es solo una compresión elegante de los productos escalares y las combinaciones lineales que ya conocemos, y dejamos planteado, para desarrollar con datos reales en el laboratorio, el concepto de efecto parcial o ceteris paribus.
``Cuantos más regresores, mayor el espacio de búsqueda; la pregunta —¿qué punto del subespacio está más cerca de $\boldsymbol{y}$?— no cambia.''
De dónde venimos y a dónde vamos: del plano al hiperplano
En la lección 6 proyectamos el vector de datos $\boldsymbol{y}$ sobre el plano generado por $\boldsymbol{1}$ y $\boldsymbol{x}$. La ortogonalidad del residuo frente a todo el plano se tradujo en dos condiciones.
En economía rara vez un fenómeno depende de un solo factor $\boldsymbol{x}$.
El paso natural: Añadir más regresores. Proyectaremos $\boldsymbol{y}$ sobre el subespacio generado por $k$ regresores: $$ \mathcal{L}(\boldsymbol{1}, \boldsymbol{x}_2, \boldsymbol{x}_3, \dots, \boldsymbol{x}_k) $$ El ajuste será una combinación lineal de todos ellos: $$ \boldsymbol{\mathop{\widehat{y}}} \;=\; \hat\beta_1\boldsymbol{1} + \hat\beta_2\boldsymbol{x}_2 + \hat\beta_3\boldsymbol{x}_3 + \dots + \hat\beta_k\boldsymbol{x}_k. $$
Y, recordando la ecuación con la que abríamos la lección 7, el residuo sigue siendo, sencillamente, la diferencia entre los datos y el ajuste: $$ \boldsymbol{y} \;=\; \boldsymbol{\mathop{\widehat{y}}} + \boldsymbol{\mathop{\widehat{e}}}. $$
El subespacio sobre el que proyectamos los datos ya no es ni una recta ni un plano; es un subespacio de dimensión $k$. Pero la geometría es la misma.
La geometría es la misma
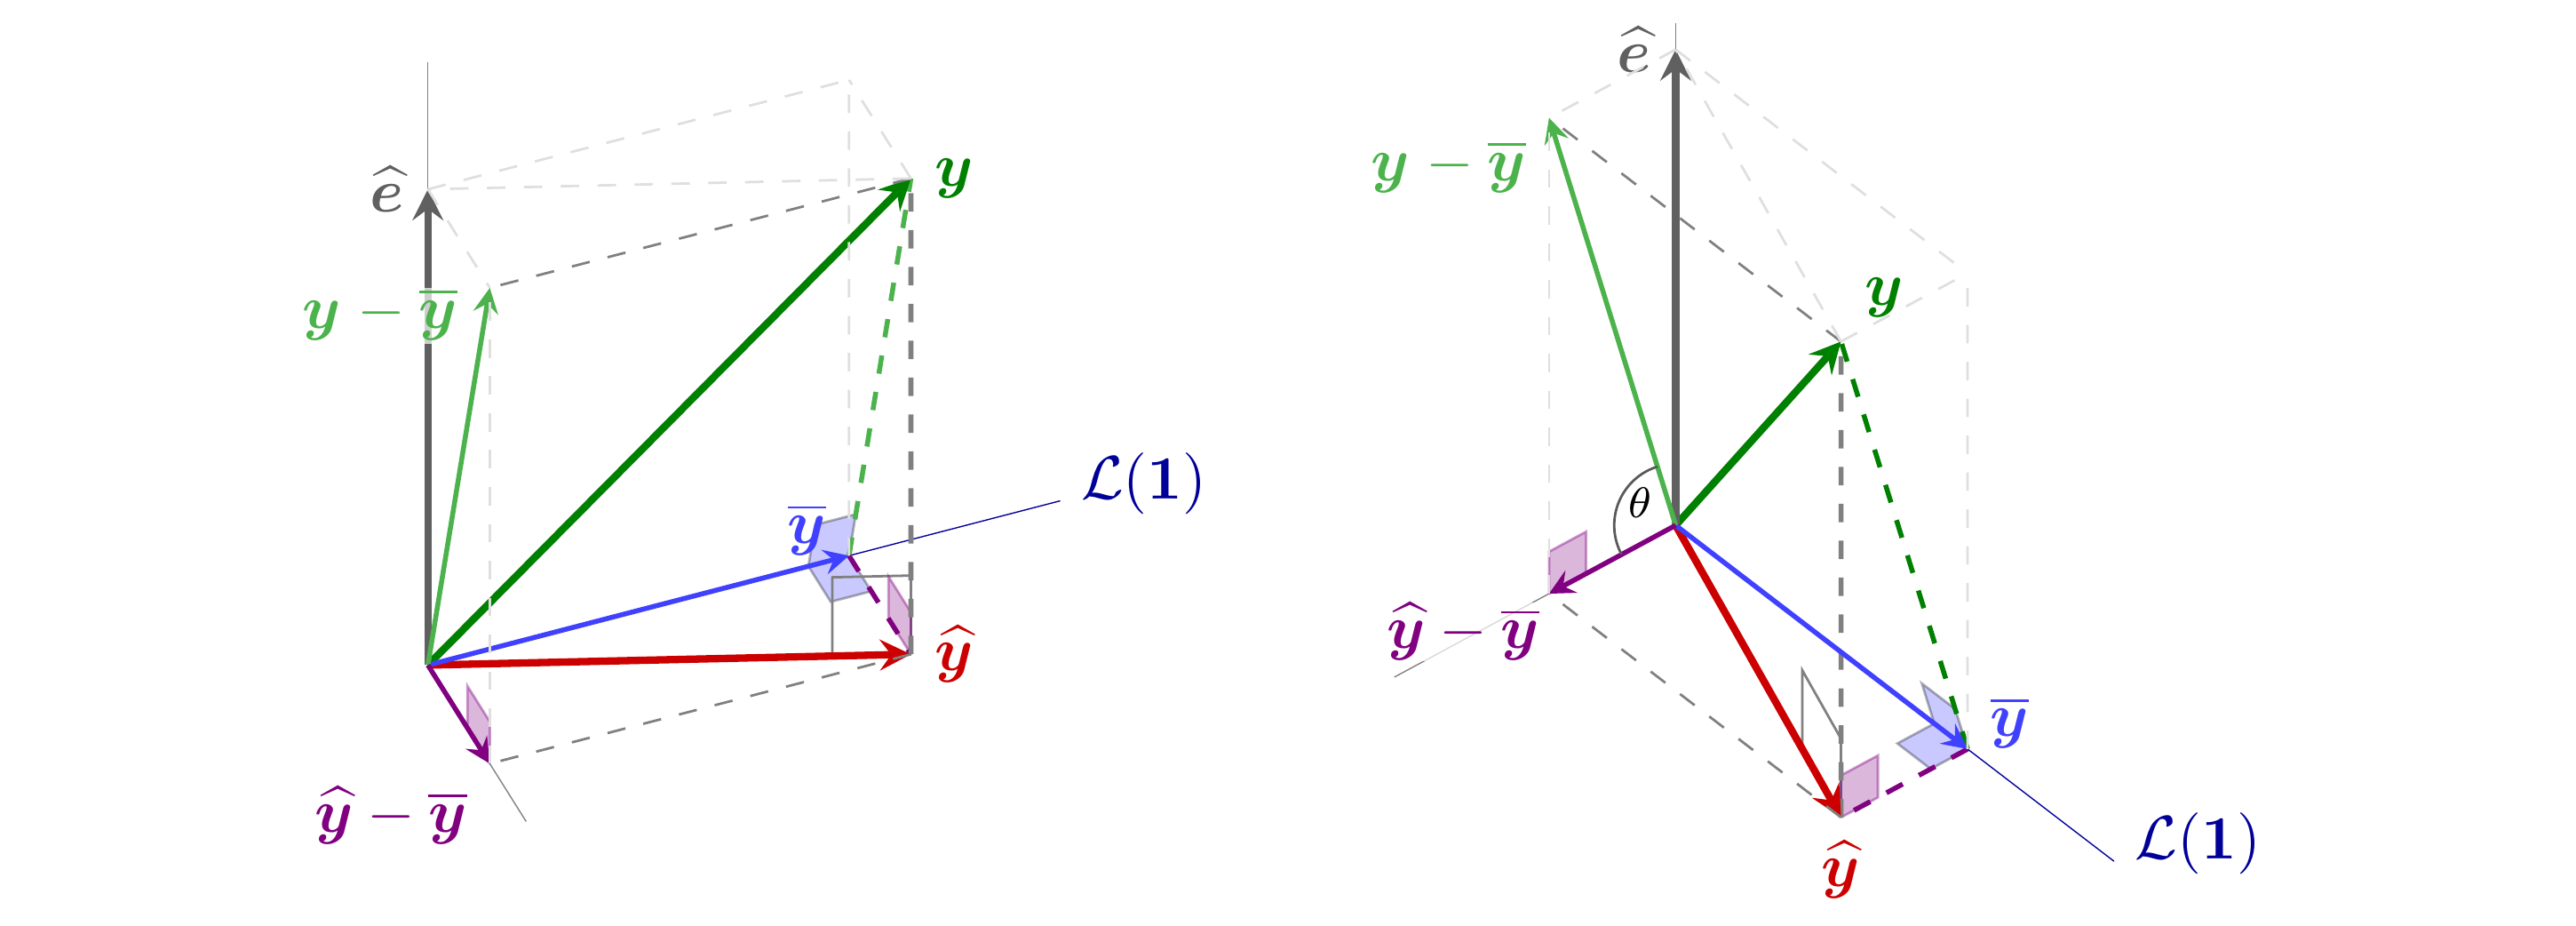
- $\boldsymbol{\mathop{\widehat{y}}}$ sigue siendo la ``sombra'' de $\boldsymbol{y}$ sobre el subespacio de los regresores.
- $\boldsymbol{\mathop{\widehat{e}}}$ sigue siendo perpendicular a todas las direcciones de dicho subespacio.
El problema aritmético: demasiadas ecuaciones
La exigencia de que $\boldsymbol{\mathop{\widehat{e}}}$ sea ortogonal a TODO el subespacio implica que debe ser ortogonal a cada uno de sus generadores.
Tendremos $k$ condiciones de ortogonalidad simultáneas:
\begin{align*} \langle\boldsymbol{\mathop{\widehat{e}}} , \boldsymbol{1}\rangle_s &= 0 \quad \implies \textstyle\frac{1}{n}\sum \hat e_i = 0 \\ \langle\boldsymbol{\mathop{\widehat{e}}} , \boldsymbol{x}_2\rangle_s &= 0 \quad \implies \textstyle\frac{1}{n}\sum x_{i2} \hat e_i = 0 \\ \langle\boldsymbol{\mathop{\widehat{e}}} , \boldsymbol{x}_3\rangle_s &= 0 \quad \implies \textstyle\frac{1}{n}\sum x_{i3} \hat e_i = 0 \\ &\dots \\ \langle\boldsymbol{\mathop{\widehat{e}}} , \boldsymbol{x}_k\rangle_s &= 0 \quad \implies \textstyle\frac{1}{n}\sum x_{ik} \hat e_i = 0 \end{align*}(donde $x_{ij}$ denota la observación $i$-ésima del regresor $j$: fila $i$, columna $j$).
Recordando que $\hat e_i = y_i - (\hat\beta_1 + \hat\beta_2 x_{i2} + \dots + \hat\beta_k x_{ik})$, solo queda encontrar los $k$ parámetros $\hat\beta_j$ que satisfacen estas $k$ condiciones.
Pero escribir y resolver este sistema con sumatorios es agotador. Necesitamos comprimir la notación.
La matriz de datos y el operador selector
En lugar de tener $k$ vectores sueltos, los agrupamos como columnas en una matriz de datos $\boldsymbol{\mathsf{X}}$. Las matrices se escriben en palo seco negrita ($\boldsymbol{\mathsf{X}}$). $$ \boldsymbol{\mathsf{X}} \;=\; [\boldsymbol{1};\;\boldsymbol{x}_2;\;\dots\;; \boldsymbol{x}_k] $$
Para ``navegar'' por la matriz usaremos un operador selector (la barra vertical $|$):
- Actuando por la derecha, selecciona la columna $j$: $$ \boldsymbol{\mathsf{X}}_{|j} \quad \text{es el } j\text{-ésimo regresor.} $$
- Actuando por la izquierda, selecciona la fila $i$: $$ {}_{i|}\boldsymbol{\mathsf{X}} \quad \text{son los datos del } i\text{-ésimo individuo.} $$
El selector sobre un vector: siempre extrae su componente $i$-ésima: $$ \boldsymbol{v}_{|i} \;=\; {}_{i|}\boldsymbol{v} \;=\; v_i $$
Vector por Matriz y las Condiciones de Ortogonalidad
Definiremos la operación vector $\times$ matriz ($\boldsymbol{v}\boldsymbol{\mathsf{X}}$) de forma que el resultado sea un nuevo vector, cuya componente $j$-ésima sea el producto escalar entre $\boldsymbol{v}$ y la columna $j$ de la matriz: $$ (\boldsymbol{v}\boldsymbol{\mathsf{X}})_{|j} \;=\; \boldsymbol{v} \cdot \boldsymbol{\mathsf{X}}_{|j}\,; \quad\text{es decir}\quad \langle\boldsymbol{v},\,\boldsymbol{\mathsf{X}}_{|j}\rangle_e $$
Aplicando esto a nuestro problema, la enorme lista de $k$ productos escalares $\boldsymbol{\mathop{\widehat{e}}} \cdot \boldsymbol{\mathsf{X}}_{|j} = 0$ (euclídeos: como $\boldsymbol{\mathop{\widehat{e}}}\cdot\boldsymbol{x}_j=n\langle\boldsymbol{\mathop{\widehat{e}}},\boldsymbol{x}_j\rangle_s$, valen $0$ igualmente) se comprime en una única y elegante ecuación: $$ \boxed{\; \boldsymbol{\mathop{\widehat{e}}}\boldsymbol{\mathsf{X}} \;=\; \boldsymbol{0} \;} $$ (donde $\boldsymbol{0}$ es el vector formado por $k$ ceros), pues $$ \boldsymbol{\mathop{\widehat{e}}}\boldsymbol{\mathsf{X}} \;=\; \boldsymbol{\mathop{\widehat{e}}}\,[\boldsymbol{1};\;\boldsymbol{x}_2;\;\dots\;; \boldsymbol{x}_k] \;=\; (\boldsymbol{\mathop{\widehat{e}}}\cdot\boldsymbol{1},\; \boldsymbol{\mathop{\widehat{e}}}\cdot\boldsymbol{x}_2,\dots\;, \boldsymbol{\mathop{\widehat{e}}}\cdot\boldsymbol{x}_k) \;=\; (0,\;0,\dots,\; 0). $$
Simplificación de la notación: Como $(\boldsymbol{v}\boldsymbol{\mathsf{X}})_{|j} = \boldsymbol{v}\cdot(\boldsymbol{\mathsf{X}}_{|j})$, podemos prescindir de los paréntesis y el punto y escribir sencillamente $\boldsymbol{v}\boldsymbol{\mathsf{X}}_{|j}$ para denotar ambas operaciones. Lo re-interpretamos como: ``el selector sobre la matriz tiene precedencia sobre el producto''.
Matriz por Vector (El Ajuste) y la Doble Lectura
Por otro lado, listamos los parámetros a estimar en un vector: $\boldsymbol{\mathop{\widehat{\beta}}} = (\hat\beta_1, \hat\beta_2, \dots, \hat\beta_k)$.
Definiremos la operación matriz $\times$ vector ($\boldsymbol{\mathsf{X}}\boldsymbol{a}$) como la combinación lineal de las columnas de la matriz $\boldsymbol{\mathsf{X}}$, usando los elementos del vector $\boldsymbol{a}$ como ponderadores:
$$ \boldsymbol{\mathsf{X}}\boldsymbol{\mathop{\widehat{\beta}}} \;=\; \hat\beta_1 \boldsymbol{\mathsf{X}}_{|1} + \hat\beta_2 \boldsymbol{\mathsf{X}}_{|2} + \dots + \hat\beta_k \boldsymbol{\mathsf{X}}_{|k} $$Primera lectura
Esta combinación lineal de las columnas es la definición que dimos de nuestro vector de ajuste $\boldsymbol{\mathop{\widehat{y}}}$ en la transparencia 1: $$ \boxed{\; \boldsymbol{\mathop{\widehat{y}}} \;=\; \boldsymbol{\mathsf{X}}\boldsymbol{\mathop{\widehat{\beta}}} \;} $$
Así, la descomposición $\boldsymbol{y}=\boldsymbol{\mathop{\widehat{y}}}+\boldsymbol{\mathop{\widehat{e}}}$ se expresa en una sola línea del siguiente modo: $$ \boxed{\; \boldsymbol{y} \;=\; \boldsymbol{\mathsf{X}}\boldsymbol{\mathop{\widehat{\beta}}} + \boldsymbol{\mathop{\widehat{e}}} \;} \qquad\Longleftrightarrow\qquad \boldsymbol{\mathop{\widehat{e}}} \;=\; \boldsymbol{y} - \boldsymbol{\mathsf{X}}\boldsymbol{\mathop{\widehat{\beta}}}. $$
Segunda lectura
Y ¿cuál es el valor ajustado para el individuo $i$?
Recordando que el operador por la izquierda selecciona la $i$-ésima componente del ajuste (y la precedencia del selector): $$ {}_{i|}\boldsymbol{\mathop{\widehat{y}}} \;=\; {}_{i|}\boldsymbol{\mathsf{X}}\boldsymbol{\mathop{\widehat{\beta}}} \;=\; {}_{i|}\boldsymbol{\mathsf{X}} \cdot \boldsymbol{\mathop{\widehat{\beta}}} $$ El ajuste para un individuo es el producto punto de sus datos (la fila ${}_{i|}\boldsymbol{\mathsf{X}}$) por los parámetros ajustados $\boldsymbol{\mathop{\widehat{\beta}}}$.
Transposición
La transposición de una matriz ($\boldsymbol{\mathsf{X}}^\top$) convierte sus filas en columnas (y viceversa). Su definición rigurosa usando el selector es: $$ {}_{i|}\boldsymbol{\mathsf{X}} \;=\; (\boldsymbol{\mathsf{X}}^\top)_{|i} \quad\Big(\text{o equivalentemente}\quad \boldsymbol{\mathsf{X}}_{|i} \;=\; {}_{i|}(\boldsymbol{\mathsf{X}}^\top)\;\Big). $$
Por tanto, $\boldsymbol{v}\boldsymbol{\mathsf{X}}$ y $\boldsymbol{\mathsf{X}}^\top\boldsymbol{v}$ son el mismo vector: $$ (\boldsymbol{v}\boldsymbol{\mathsf{X}})_{|j} \;=\; \boldsymbol{v} \cdot \boldsymbol{\mathsf{X}}_{|j} \;=\; \boldsymbol{\mathsf{X}}_{|j} \cdot \boldsymbol{v} \;=\; {}_{j|}(\boldsymbol{\mathsf{X}}^\top) \cdot \boldsymbol{v} \;=\; {}_{j|}(\boldsymbol{\mathsf{X}}^\top\boldsymbol{v}) $$ Así, la condición de ortogonalidad $\boldsymbol{\mathop{\widehat{e}}}\boldsymbol{\mathsf{X}} = \boldsymbol{0}$ puede escribirse de forma equivalente como: $$ \boxed{\; \boldsymbol{\mathsf{X}}^\top\boldsymbol{\mathop{\widehat{e}}} \;=\; \boldsymbol{0}. \;} $$
Ecuaciones normales
Sustituyendo $\quad\boldsymbol{\mathop{\widehat{e}}}=\boldsymbol{y}-\boldsymbol{\mathsf{X}}\boldsymbol{\mathop{\widehat{\beta}}}\quad$ en $\quad\boldsymbol{\mathsf{X}}^\top\boldsymbol{\mathop{\widehat{e}}}=\boldsymbol{0}$: $$ \boldsymbol{\mathsf{X}}^\top\big(\boldsymbol{y}-\boldsymbol{\mathsf{X}}\boldsymbol{\mathop{\widehat{\beta}}}\big)=\boldsymbol{0} \;\Longrightarrow\; \boxed{\;\boldsymbol{\mathsf{X}}^\top\boldsymbol{\mathsf{X}}\,\boldsymbol{\mathop{\widehat{\beta}}} \;=\; \boldsymbol{\mathsf{X}}^\top\boldsymbol{y}.\;} $$ (Hemos usado que $\boldsymbol{\mathsf{X}}^\top$ distribuye sobre la resta.) Aquí aparece (por primera vez en el curso) un producto de matrices: $\boldsymbol{\mathsf{X}}^\top\boldsymbol{\mathsf{X}};\;$ baste saber que es otra matriz.
La expresión del recuadro es el sistema de ecuaciones normales.
Cuando los $k$ regresores son linealmente independientes (ninguno es combinación lineal de los demás), este sistema tiene una única solución, cuya expresión matricial es: $$ \boldsymbol{\mathop{\widehat{\beta}}} = (\boldsymbol{\mathsf{X}}^\top\boldsymbol{\mathsf{X}})^{-1}\boldsymbol{\mathsf{X}}^\top\boldsymbol{y}. $$
No se preocupe por la expresión, los ordenadores saben calcularla. Lo importante es que dicha solución garantiza que $\boldsymbol{\mathsf{X}}^\top\boldsymbol{\mathop{\widehat{e}}}=\boldsymbol{0}$; es decir, que al usar $\boldsymbol{\mathop{\widehat{\beta}}}$ para calcular $\boldsymbol{\mathop{\widehat{y}}}=\boldsymbol{\mathsf{X}}\,\boldsymbol{\mathop{\widehat{\beta}}}$, obtenemos la combinación lineal de los regresores más cercana a $\boldsymbol y$.
Familia ortogonal
Recordemos (lección 3, Cauchy–Schwarz) la fórmula de proyección sobre un generador: $\alpha=\langle\boldsymbol{a},\boldsymbol{b}\rangle/\langle\boldsymbol{a},\boldsymbol{a}\rangle$. Y (lección 7) la ``vía alternativa'' con dos generadores ortogonales.
Si $\{\boldsymbol{1},\boldsymbol{z}_2,\ldots,\boldsymbol{z}_k\}$ son mutuamente ortogonales (nótese que $\boldsymbol{1}\perp\boldsymbol{z}_j$ significa $\mu_{\boldsymbol{z}_j}=0$), cada coeficiente se calcula por separado, sin resolver ningún sistema: $$ \hat\beta_1=\frac{\langle\boldsymbol{y},\boldsymbol{1}\rangle_s}{\langle\boldsymbol{1},\boldsymbol{1}\rangle_s} = \mu_{\boldsymbol{y}}, \qquad \hat\beta_j = \frac{\langle\boldsymbol{y},\boldsymbol{z}_j\rangle_s}{\langle\boldsymbol{z}_j,\boldsymbol{z}_j\rangle_s} = \frac{\sigma_{\boldsymbol{y}\boldsymbol{z}_j}}{\sigma^2_{\boldsymbol{z}_j}} \quad (j=2,\ldots,k). $$ (aplicando, una vez más, el truco del vector de media nula de la lección 6: como $\boldsymbol z_j$ tiene media cero, su producto escalar con $\boldsymbol y$ coincide con la covarianza entre ambos).
Este extraordinario caso es la excepción: con datos económicos reales, los regresores prácticamente nunca son ortogonales entre sí. El caso general exige resolver las ecuaciones normales de la transparencia anterior.
$R^2$ en regresión múltiple
Como $\langle\boldsymbol{\mathop{\widehat{e}}},\boldsymbol{1}\rangle_s=0$ sigue siendo una de las $k$ condiciones: $\mu_{\boldsymbol{y}}=\mu_{\boldsymbol{\mathop{\widehat{y}}}}$ (lección 7) y $\mathrm{STC}=\mathrm{SEC}+\mathrm{SRC}$ (lección 8) siguen valiendo igual, sin importar $k$.
Pero (pregunta 5 de la práctica de regresión simple), en general: $\;R^2 \neq \rho_{\boldsymbol{x}_2\boldsymbol{y}}^2+\cdots+\rho_{\boldsymbol{x}_k\boldsymbol{y}}^2$.
¿Por qué? En la lección 8, $R^2=\rho_{\boldsymbol{x}\boldsymbol{y}}^2$ porque los vectores de $\mathcal{L}(\boldsymbol{1},\boldsymbol{x})$ con media cero forman una recta: todos alineados con $\boldsymbol{x}-\mu_{\boldsymbol{x}}\boldsymbol{1}$.
Con $k>2$ regresores ese subespacio tiene dimensión $k-1$: $\boldsymbol{\mathop{\widehat{y}}}-\boldsymbol{\mathop{\overline{y}}}$ ya no está alineado, en general, con ningún $\boldsymbol{x}_j-\mu_{\boldsymbol{x}_j}\boldsymbol{1}$.
Excepción (transparencia anterior): regresores en desviaciones mutuamente ortogonales $\implies R^2=\rho_{\boldsymbol{x}_2\boldsymbol{y}}^2+\cdots+\rho_{\boldsymbol{x}_k\boldsymbol{y}}^2$ (Pitágoras generalizado).
El modelo poblacional también se generaliza
Recordemos (lección 9): $Y=\beta_1\,\mathit{1}+\beta_2X+U$, con tres supuestos (linealidad, $\mathrm{Var}(X)\neq0$ y homocedasticidad) —más la exogeneidad estricta $E[U\mid X]=\mathit{0}$, que allí salía gratis por la definición de $U$—.
Lo generalizamos a $k-1$ regresores no constantes $X_2,\ldots,X_k$: $$ Y = \beta_1\,\mathit{1}+\beta_2X_2+\cdots+\beta_kX_k+U. $$ Los mismos tres supuestos, condicionando ahora sobre todos los regresores a la vez:
- $E[Y\mid X_2,\ldots,X_k]=\beta_1\,\mathit{1}+\beta_2X_2+\cdots+\beta_kX_k$
- $\mathit{1},X_2,\ldots,X_k$ linealmente independientes — generaliza $\mathrm{Var}(X)\neq0$.
- $Var[U\mid X_2,\ldots,X_k]=\sigma^2\,\mathit{1}$
Y el mismo corolario gratuito: $E[U\mid X_2,\ldots,X_k]=\mathit{0}$.
Y el método de los momentos se extiende tal cual: sustituir momentos poblacionales por muestrales reproduce las ecuaciones normales $\boldsymbol{\mathsf{X}}^\top\boldsymbol{\mathsf{X}}\boldsymbol{\mathop{\widehat{\beta}}}=\boldsymbol{\mathsf{X}}^\top\boldsymbol{y}$.
Condicionamos sobre una lista de variables más larga. Pero la estructura no cambia.
Recapitulación y guiño a las sesiones siguientes
| Regresión simple | Regresión múltiple |
|---|---|
| $\boldsymbol{y}=\hat\beta_1\boldsymbol{1}+\hat\beta_2\boldsymbol{x}+\boldsymbol{\mathop{\widehat{e}}}$ | $\boldsymbol{y}=\boldsymbol{\mathsf{X}}\boldsymbol{\mathop{\widehat{\beta}}}+\boldsymbol{\mathop{\widehat{e}}}$ |
| $\mathcal{L}(\boldsymbol{1},\boldsymbol{x})$, un plano (dim. 2) | $\mathcal{L}(\boldsymbol{1},\boldsymbol{x}_2,\ldots,\boldsymbol{x}_k)$, (dimensión $k$) |
| $2$ condiciones de ortogonalidad | $k$ condiciones, comprimidas en $\boldsymbol{\mathsf{X}}^\top\boldsymbol{\mathop{\widehat{e}}}=\boldsymbol{0}$ |
| $\hat\beta_1,\hat\beta_2$ (escalares) | $\boldsymbol{\mathop{\widehat{\beta}}}$ (vector), resolviendo $\;\boldsymbol{\mathsf{X}}^\top\boldsymbol{\mathsf{X}}\boldsymbol{\mathop{\widehat{\beta}}}=\boldsymbol{\mathsf{X}}^\top\boldsymbol{y}$ |
| $R^2=\rho_{\boldsymbol{x}\boldsymbol{y}}^2$ (caso particular) | $R^2=\rho_{\boldsymbol{y}\boldsymbol{\mathop{\widehat{y}}}}^2$ (siempre); $=\sum_j\rho_{\boldsymbol{x}_j\boldsymbol{y}}^2$ solo si ortogonales |
Como caso límite, obsérvese que $k=1$ (ningún regresor no constante, solo la columna de unos $\boldsymbol{1}$) recupera exactamente la proyección de las lecciones 4 y 5.[nil]
Con el modelo poblacional generalizado a $k$ regresores, aún queda pendiente la misma pregunta: ¿es $\boldsymbol{\mathop{\widehat{\beta}}}$ un buen estimador del verdadero $\boldsymbol{\beta}$ poblacional? En la lección 11 retomaremos la cuestión.
Respecto a la interpretación de parámetros: cada $\hat\beta_j$ mide un efecto parcial —``manteniendo constantes los demás regresores'' (ceteris paribus)—. En la práctica que sigue a esta lección lo veremos con datos reales. Además hablaremos del $R^2$ ajustado.