Lección 16. Variables indicadoras e interacciones: leer las diferencias entre grupos
Índice
- 1. De dónde venimos: la indicadora de un suceso como regresor
- 2. Una indicadora desplaza el intercepto: el río Charles
- 3. Con más regresores: la diferencia con lo demás fijo
- 4. En log-nivel: una diferencia porcentual
- 5. La trampa de las variables ficticias
- 6. Varias categorías: una indicadora menos que grupos
- 7. Interacciones: la pendiente cambia de grupo
- 8. El contraste de Chow: ¿la misma ecuación?
- 9. Qué dice y qué no dice el coeficiente de una indicadora
- 10. Recapitulación y guiño a la lección siguiente
- 11. Preguntas de repaso (sesión 24) htmlonly
- 12. Respuestas htmlonly
La indicadora de un suceso, \(\mathbb 1_A\) de la lección 12, es hoy un regresor más, que señala una característica de la unidad observada. Su coeficiente es una diferencia entre grupos, en unidades del regresando o porcentual si está en logaritmos. Dos indicadoras complementarias suman la constante, y de ahí la trampa de las variables ficticias. Una interacción permite que una pendiente cambie de grupo, y el contraste de Chow pregunta si los parámetros \(\beta\) del modelo son iguales en dos grupos.
``El coeficiente de una indicadora no es un efecto por unidad: es un salto entre grupos.''
1. De dónde venimos: la indicadora de un suceso como regresor
La lección 12 definió la indicadora de un suceso \(A\): \(\mathbb 1_A(\omega)=1\) si \(\omega\in A\) y \(0\) si no; su esperanza es la probabilidad \(\mathrm P(A)\), y la variable aleatoria constante es la indicadora del suceso seguro, \(\mathit 1=\mathbb 1_\Omega\).
Hoy la indicadora señala una característica de la unidad observada. Si \(A\) es el suceso formado por los \(\omega\) en los que la persona observada es mujer, \(\mathbb 1_{\text{mujer}}=\mathbb 1_A\) vale \(1\) si es mujer y \(0\) si es hombre, y entra como un regresor más del modelo de la lección 10:
\[\log(\text{wage})=\beta_1\,\mathit 1+\beta_2\,\mathbb 1_{\text{mujer}}+\beta_3\,\text{educ}+\cdots+U.\]
En la muestra es la columna \(\boldsymbol d_{\text{mujer}}\), con un \(1\) en las filas de las mujeres y un \(0\) en las de los hombres. En los ficheros: female, chas.
Se llama también variable dicotómica, binaria, ficticia o dummy. Lo nuevo de hoy es la interpretación del parámetro que la acompaña, \(\beta_2\).
Hoy: qué dice el coeficiente de una indicadora, en niveles y en logaritmos; qué ocurre con dos indicadoras complementarias; cómo una interacción cambia una pendiente. Geometría nueva: solo una observación sobre dos indicadoras ortogonales.
De dónde venimos: la indicadora de un suceso como regresor
Muchas variables explicativas de interés no son cantidades sino categorías: el sexo de un trabajador, si está casado, si una vivienda tiene piscina, si un barrio limita con el río, la región, el sector de actividad. Para que una categoría entre en un modelo de regresión hay que convertirla en números, y la forma de hacerlo ya está en el curso. La lección 12, al definir la probabilidad condicional, introdujo la indicadora de un suceso \(A\): la variable aleatoria \(\mathbb 1_A\) que vale \(1\) en los sucesos elementales de \(A\) y \(0\) en los demás, con \(\mathrm E(\mathbb 1_A)=\mathrm P(A)\). Allí el suceso era \(\{U_i\le u\}\); hoy es el conjunto de los \(\omega\) en los que la unidad observada tiene una característica. Si \(A\) es el suceso de que la persona observada sea mujer, \(\mathbb 1_{\text{mujer}}=\mathbb 1_A\) vale \(1\) en los \(\omega\) en que lo es y \(0\) en los demás, y su esperanza es la probabilidad de ese suceso, \(\mathrm P(A)\).
Esa indicadora es una variable aleatoria como cualquier otro regresor, y entra en el modelo poblacional de la lección 10 multiplicada por su coeficiente: \(\log(\text{wage})=\beta_1\,\mathit 1+\beta_2\,\mathbb 1_{\text{mujer}}+\beta_3\,\text{educ}+\beta_4\,\text{exper}+\beta_5\,\text{tenure}+U\). En la muestra, la columna correspondiente de la matriz de regresores \(\boldsymbol{\mathsf X}\) es el vector \(\boldsymbol d_{\text{mujer}}\in\mathbb R^n\) con un \(1\) en las filas de las mujeres y un \(0\) en las de los hombres, de la misma manera que \(\boldsymbol x_j\) es el vector de los \(n\) valores observados de \(X_j\). Su media es la proporción de mujeres en la muestra, y estima \(\mathrm P(A)\). En los ficheros de datos esa columna lleva el nombre de la categoría que vale \(1\): female en wage1, chas en el Boston original. La constante del modelo, \(\mathit 1\), es también una indicadora, la del suceso seguro \(\Omega\): vale \(1\) para todas las unidades, y en la muestra es el vector \(\boldsymbol 1\).
Los nombres son varios. Esta lección dice variable indicadora, que es el término del curso; en los manuales y en los programas se encuentra también dicotómica o binaria, por tomar dos valores, ficticia, porque no mide una cantidad, que es el término de Gretl en español, y dummy, el término inglés. Todos designan lo mismo: una columna de ceros y unos que señala un grupo. En la estimación por mínimos cuadrados la indicadora es una columna más de \(\boldsymbol{\mathsf X}\): la proyección, los residuos, el \(R^2\), los errores estándar y los contrastes \(t\) y \(F\) se calculan igual, y todo lo demostrado en las lecciones 8 a 14 sigue valiendo. Lo que esta lección añade es la interpretación de su coeficiente, que no es un efecto por unidad, porque una indicadora no tiene unidades, sino una diferencia entre dos grupos. Hay una única pieza de geometría nueva, y es pequeña: dos indicadoras de grupos complementarios son vectores ortogonales que suman \(\boldsymbol 1\), y eso explica a la vez por qué sus coeficientes son medias de grupo y por qué no pueden entrar las dos en el modelo junto con la constante.
Para profundizar: Wooldridge, J. M. (2020), cap. 7, sección 7.1 (``Describing qualitative information''); lección 12 de este curso, apuntes de ``El supuesto nuevo: normalidad'', donde se definió \(\mathbb 1_A\).
2. Una indicadora desplaza el intercepto: el río Charles
Boston original (\(506\) barrios; medv, precio mediano en miles de dólares; chas, \(1\) en los \(35\) barrios que limitan con el río Charles):
\[\widehat{\text{medv}}=\underset{(0{,}42)}{22{,}09}+\underset{(1{,}59)}{6{,}35}\,\text{chas},\qquad t=4{,}00.\]
Los valores ajustados son las medias de cada grupo, y el coeficiente es su diferencia.
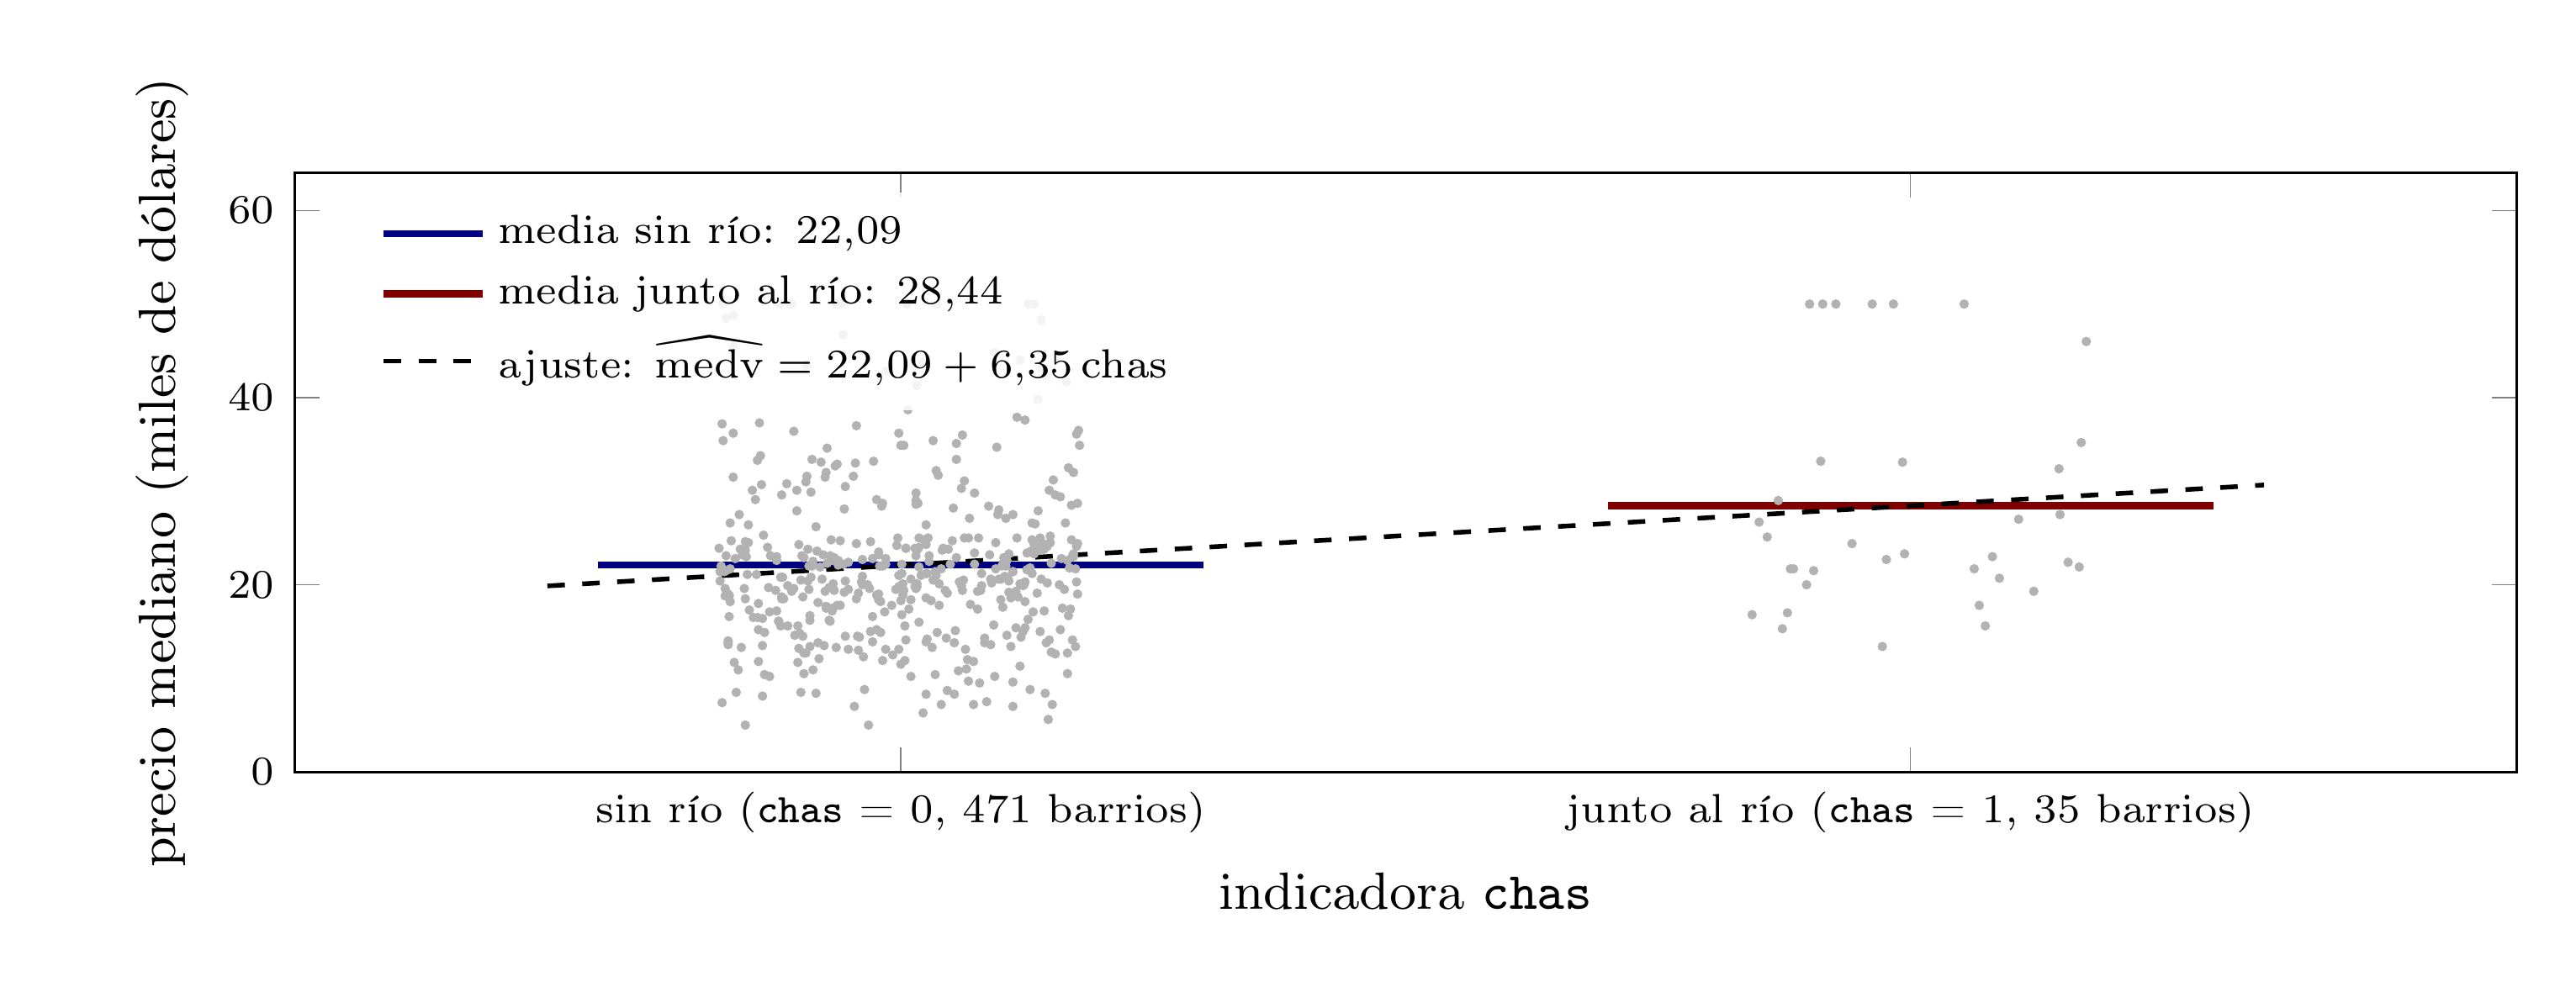
Figura 1: Los \(506\) barrios del Boston original. En el eje horizontal, la indicadora chas (con un desplazamiento horizontal aleatorio para que los puntos no se superpongan); en el vertical, el precio mediano en miles de dólares. El segmento azul es la media de los \(471\) barrios sin río, \(22{,}09\), y el rojo la media de los \(35\) barrios junto al río, \(28{,}44\). Esas dos medias son los dos únicos valores ajustados de medv sobre la constante y chas, y la flecha es el salto entre ellas: el coeficiente de la indicadora, \(6{,}35\). No hay pendiente que dibujar, porque chas solo toma los valores \(0\) y \(1\): el coeficiente de una indicadora es un salto entre dos grupos, no un efecto por unidad.
La geometría: \(\boldsymbol d_{\text{no río}}=\boldsymbol 1-\boldsymbol d_{\text{río}}\), así que \(\mathcal L(\boldsymbol 1,\boldsymbol d_{\text{río}})=\mathcal L(\boldsymbol d_{\text{río}},\boldsymbol d_{\text{no río}})\): el mismo subespacio con otra base.
Las dos indicadoras son ortogonales, \(\langle\boldsymbol d_{\text{río}},\boldsymbol d_{\text{no río}}\rangle_s=0\), porque ningún barrio está en los dos grupos a la vez. Como en la familia ortogonal de la lección 10, cada coeficiente se calcula por separado con la fórmula de la proyección sobre un generador, \(\langle\boldsymbol y,\boldsymbol d\rangle_s/\langle\boldsymbol d,\boldsymbol d\rangle_s\), que aquí es la media de su grupo: \[\boldsymbol{\mathop{\widehat y}}=28{,}44\,\boldsymbol d_{\text{río}}+22{,}09\,\boldsymbol d_{\text{no río}}=22{,}09\,\boldsymbol 1+6{,}35\,\boldsymbol d_{\text{río}}.\]
Con más regresores, medv sobre rm y chas:
\[\widehat{\text{medv}}=\underset{(2{,}62)}{-34{,}11}+\underset{(0{,}42)}{8{,}97}\,\text{rm}+\underset{(1{,}15)}{4{,}08}\,\text{chas},\qquad t=3{,}55.\]
El coeficiente de chas ya no es una diferencia de medias, sino la diferencia de precio entre barrios con el mismo número medio de habitaciones por vivienda.
Una indicadora desplaza el intercepto: el río Charles
El Boston original es el fichero boston.csv que se importó en la actividad 4 (html) de la práctica B de la sesión 4, porque contiene una variable que hprice2 no tiene: chas, la indicadora de los barrios que limitan con el río Charles. Allí se calculó su media, \(35/506=0{,}069\), y se vio que la media de una indicadora es la proporción de unidades del grupo: es la versión muestral de \(\mathrm E(\mathbb 1_A)=\mathrm P(A)\).
La regresión más simple con una indicadora es la del precio mediano sobre la constante y chas: \(\widehat{\text{medv}}=22{,}09+6{,}35\,\text{chas}\). Como chas solo toma los valores \(0\) y \(1\), el modelo solo produce dos valores ajustados: \(22{,}09\) para los barrios sin río y \(22{,}09+6{,}35=28{,}44\) para los barrios junto al río. Y esos dos valores son las medias de medv en cada grupo. Por eso el coeficiente de la indicadora, \(6{,}35\) mil dólares, es la diferencia entre las dos medias, y el contraste \(t\) de ese coeficiente, con \(t=4{,}00\), es el contraste de igualdad de medias entre los dos grupos. La figura dibuja los \(506\) barrios con la indicadora en el eje horizontal, las dos medias y el salto entre ellas. Entre \(0\) y \(1\) no hay ningún valor posible de chas, y hablar de ``una unidad más de chas'' no tiene sentido. El coeficiente de una indicadora es un salto entre grupos, un desplazamiento del intercepto, y no un efecto por unidad.
Que los coeficientes sean medias de grupo tiene una explicación geométrica, la única de esta lección. Sea \(\boldsymbol d_{\text{río}}\) la columna chas y \(\boldsymbol d_{\text{no río}}=\boldsymbol 1-\boldsymbol d_{\text{río}}\) la indicadora del grupo complementario. El subespacio generado por la constante y chas es el mismo que el generado por las dos indicadoras, porque \(\boldsymbol d_{\text{no río}}=\boldsymbol 1-\boldsymbol d_{\text{río}}\) y \(\boldsymbol 1=\boldsymbol d_{\text{río}}+\boldsymbol d_{\text{no río}}\): cada vector de un par se obtiene sumando o restando los del otro par, y por tanto \(\mathcal L(\boldsymbol 1,\boldsymbol d_{\text{río}})=\mathcal L(\boldsymbol d_{\text{río}},\boldsymbol d_{\text{no río}})\). Los dos pares de generadores son dos bases del mismo subespacio, como \(\boldsymbol 1,\boldsymbol x\) y \(\boldsymbol 1,\boldsymbol x-\mu_{\boldsymbol x}\boldsymbol 1\) en la lección 7. La proyección de \(\boldsymbol y\) es la misma con cualquiera de las dos bases; lo que cambia son los coeficientes. En la base de las dos indicadoras los coeficientes se calculan sin resolver ningún sistema: \(\boldsymbol d_{\text{río}}\) y \(\boldsymbol d_{\text{no río}}\) son ortogonales, \(\langle\boldsymbol d_{\text{río}},\boldsymbol d_{\text{no río}}\rangle_s=0\), porque en cada fila una de las dos vale cero. En las ecuaciones normales de la lección 10 el producto escalar de cada regresor con el otro es cero, así que cada ecuación contiene un solo coeficiente, y ese coeficiente es el de la proyección sobre un generador de las lecciones 3 y 4, \(\langle\boldsymbol y,\boldsymbol d\rangle_s/\langle\boldsymbol d,\boldsymbol d\rangle_s\). Es la misma situación que la familia ortogonal de la lección 10, con dos generadores que no están centrados pero sí son ortogonales entre sí. Para \(\boldsymbol d_{\text{río}}\), el factor \(1/n\) del producto escalar estadístico está en el numerador y en el denominador y se cancela. El cociente es entonces el de dos productos escalares euclídeos:
\[\frac{\langle\boldsymbol y,\boldsymbol d_{\text{río}}\rangle_s}{\langle\boldsymbol d_{\text{río}},\boldsymbol d_{\text{río}}\rangle_s}=\frac{\langle\boldsymbol y,\boldsymbol d_{\text{río}}\rangle_e}{\langle\boldsymbol d_{\text{río}},\boldsymbol d_{\text{río}}\rangle_e}=\frac{\sum_{i=1}^n d_i\,y_i}{\sum_{i=1}^n d_i^2}=\frac{\sum_{i:\,d_i=1} y_i}{\sum_{i=1}^n d_i},\]
donde \(d_i\) es la componente \(i\) de \(\boldsymbol d_{\text{río}}\). En el numerador, los ceros de la indicadora anulan los términos de los barrios sin río, y solo se suman los precios de los barrios junto al río. En el denominador, como \(d_i^2=d_i\), se suman los unos de la indicadora: se cuentan los barrios junto al río, \(35\). El cociente es la media de ese grupo, \(28{,}44\). Con \(\boldsymbol d_{\text{no río}}\) se obtiene del mismo modo la media de los \(471\) barrios sin río, \(22{,}09\). Cambiar a la base \(\{\boldsymbol 1,\boldsymbol d_{\text{río}}\}\) reescribe el mismo vector ajustado. Basta sustituir \(\boldsymbol d_{\text{no río}}=\boldsymbol 1-\boldsymbol d_{\text{río}}\):
\[\boldsymbol{\mathop{\widehat y}}=28{,}44\,\boldsymbol d_{\text{río}}+22{,}09\,(\boldsymbol 1-\boldsymbol d_{\text{río}})=22{,}09\,\boldsymbol 1+(28{,}44-22{,}09)\,\boldsymbol d_{\text{río}}=22{,}09\,\boldsymbol 1+6{,}35\,\boldsymbol d_{\text{río}}.\]
En esta base los barrios sin río no tienen indicadora propia: son la categoría base, el grupo en el que \(\boldsymbol d_{\text{río}}\) vale cero. Por eso el coeficiente de la constante es la media de la categoría base, \(22{,}09\), que es el valor ajustado de cualquier barrio sin río. El coeficiente de \(\boldsymbol d_{\text{río}}\) ya no es una media, sino la diferencia entre la media de su grupo y la de la categoría base. A los barrios junto al río les corresponde, en promedio, un precio \(6{,}35\) mil dólares mayor que el de los barrios sin río. Si la base hubiera sido \(\{\boldsymbol 1,\boldsymbol d_{\text{no río}}\}\), la categoría base serían los barrios junto al río. La constante valdría entonces \(28{,}44\), y el coeficiente de \(\boldsymbol d_{\text{no río}}\), \(-6{,}35\), sería la diferencia entre la media de los barrios sin río y la de los barrios junto al río.
Con más regresores el coeficiente de la indicadora deja de ser una diferencia de medias. Si al modelo se añade el número medio de habitaciones por vivienda del barrio, rm, la estimación es la siguiente:
medv sobre… |
coef. | \(\mathrm{ee}\) | \(t\) |
|---|---|---|---|
| constante | \(-34{,}11\) | \(2{,}62\) | \(-12{,}99\) |
rm |
\(8{,}97\) | \(0{,}42\) | \(21{,}55\) |
chas |
\(4{,}08\) | \(1{,}15\) | \(3{,}55\) |
El coeficiente de chas, \(4{,}08\) mil dólares, es la diferencia de precio mediano entre dos barrios con el mismo número medio de habitaciones por vivienda, uno junto al río y otro no. La comparación es entre barrios, no entre viviendas: el modelo no dice cuánto más vale una vivienda concreta por estar junto al río. Es la lectura ceteris paribus de la lección 10, aplicada a un salto entre grupos. La diferencia bruta de medias, \(6{,}35\), recoge además que los barrios junto al río tienen viviendas algo mayores: \(6{,}52\) habitaciones de media, frente a \(6{,}27\) en los demás. Al incluir rm como regresor, parte de esa diferencia queda recogida en el término de rm: con cuatro decimales en las medias, \(8{,}967\times(6{,}5196-6{,}2672)=2{,}263\) mil dólares. Lo que queda, \(6{,}346-2{,}263=4{,}083\), es el coeficiente de chas. La transparencia ``Con más regresores: la diferencia con lo demás fijo'' vuelve sobre esta distinción con los salarios.
Para profundizar: Wooldridge, J. M. (2020), cap. 7, sección 7.2 (``A single dummy independent variable''); Harrison, D. y Rubinfeld, D. L. (1978), ``Hedonic housing prices and the demand for clean air'', Journal of Environmental Economics and Management 5, 81–102, origen de los datos.
3. Con más regresores: la diferencia con lo demás fijo
wage1 (\(526\) trabajadores, salario por hora en dólares de 1976; \(274\) hombres y \(252\) mujeres). Medias: \(7{,}10\) dólares los hombres, \(4{,}59\) las mujeres. wage sobre la constante y female: coeficiente \(-2{,}51\), la diferencia de medias.
wage sobre… |
coef. | \(\mathrm{ee}\) | \(t\) |
|---|---|---|---|
| constante | \(-1{,}568\) | \(0{,}725\) | \(-2{,}16\) |
female |
\(-1{,}811\) | \(0{,}265\) | \(-6{,}84\) |
educ |
\(0{,}572\) | \(0{,}049\) | \(11{,}58\) |
exper |
\(0{,}025\) | \(0{,}012\) | \(2{,}20\) |
tenure |
\(0{,}141\) | \(0{,}021\) | \(6{,}66\) |
Lectura: entre un hombre y una mujer con la misma educación, experiencia y antigüedad, el salario de la mujer es \(1{,}81\) dólares por hora menor, en promedio. De la diferencia bruta de \(2{,}51\), los \(0{,}70\) restantes corresponden a diferencias en esas tres variables (antigüedad media: \(6{,}5\) años los hombres, \(3{,}6\) las mujeres).
``Lo demás fijo'' solo cubre lo que está en el modelo.
Con más regresores: la diferencia con lo demás fijo
El fichero wage1 de Wooldridge es el de la transparencia ``Log-nivel: salarios y educación'' de la lección 15: \(526\) trabajadores de la encuesta de población de Estados Unidos de 1976, con el salario por hora en dólares, los años de educación (educ), de experiencia potencial (exper: la edad menos los años de educación menos seis, es decir, los años transcurridos desde el fin de los estudios) y de antigüedad en la empresa (tenure), y la indicadora female, que vale \(1\) para las \(252\) mujeres y \(0\) para los \(274\) hombres.
El salario medio es \(7{,}10\) dólares por hora entre los hombres y \(4{,}59\) entre las mujeres. La regresión de wage sobre la constante y female devuelve esas dos cifras:
\[\widehat{\text{wage}}=\underset{(0{,}21)}{7{,}10}-\underset{(0{,}30)}{2{,}51}\,\text{female},\qquad t=-8{,}28,\]
con el error estándar de cada coeficiente entre paréntesis debajo de él, como en la lección 15.
La constante es la media de los hombres, la categoría base, y el coeficiente de female es la diferencia entre la media de las mujeres y la de los hombres. Es la misma situación que la de los barrios junto al río: con una sola indicadora, el coeficiente es la diferencia de medias entre grupos.
La tabla de la transparencia añade los tres regresores cuantitativos:
\[\begin{aligned}\widehat{\text{wage}}&=\underset{(0{,}725)}{-1{,}568}-\underset{(0{,}265)}{1{,}811}\,\text{female}+\underset{(0{,}049)}{0{,}572}\,\text{educ}\\&\quad+\underset{(0{,}012)}{0{,}025}\,\text{exper}+\underset{(0{,}021)}{0{,}141}\,\text{tenure}.\end{aligned}\]
El coeficiente de female pasa a \(-1{,}81\), con error estándar \(0{,}27\) y \(t=-6{,}84\). La lectura es la de la lección 10: con lo demás fijo, es decir, entre un hombre y una mujer con los mismos años de educación, de experiencia y de antigüedad, el salario de la mujer es \(1{,}81\) dólares por hora menor, en promedio. El intervalo al 95 % va de \(-2{,}33\) a \(-1{,}29\): datos como estos serían muy raros si no hubiera diferencia salarial entre sexos con las tres variables fijas. Los otros coeficientes se leen en las unidades del salario, como en la lección 12: un año más de educación se acompaña de \(57\) centavos más por hora, y un año más de antigüedad, de \(14\).
La diferencia entre las dos cifras, \(-2{,}51\) y \(-1{,}81\), se explica por cómo difieren los dos grupos en las variables del modelo. La diferencia bruta de medias mezcla dos cosas: la diferencia salarial entre hombres y mujeres con la misma educación, experiencia y antigüedad, y el hecho de que los dos grupos no son comparables en las variables del modelo. Las mujeres de la muestra tienen una antigüedad media de \(3{,}6\) años frente a \(6{,}5\) los hombres, algo menos de experiencia (\(16{,}4\) frente a \(17{,}6\)) y casi la misma educación (\(12{,}3\) frente a \(12{,}8\)). Como la antigüedad se acompaña de un salario mayor, parte de la diferencia bruta queda recogida en los términos de educ, exper y tenure, y el salto que queda al fijar las tres variables es menor. La descomposición es una identidad: la diferencia bruta es el coeficiente de female más, para cada regresor, su coeficiente por la diferencia de medias de ese regresor entre mujeres y hombres,
\[\begin{aligned}-2{,}512&=-1{,}811+0{,}572\times(-0{,}471)+0{,}0254\times(-1{,}130)+0{,}141\times(-2{,}859)\\&=-1{,}811-0{,}269-0{,}029-0{,}403.\end{aligned}\]
De los \(0{,}70\) dólares que separan las dos cifras, \(0{,}40\) corresponden a la antigüedad. Es la parte propia de la lección 14: el coeficiente de female es el de lo que la indicadora no comparte con educ, exper y tenure, y recoge solo la parte de la diferencia salarial que no corresponde a las diferencias de educación, experiencia y antigüedad entre los dos grupos.
Hay que ser preciso con lo que el coeficiente no dice. ``Lo demás fijo'' se refiere a lo que el modelo incluye: tres variables. Hay muchas otras que difieren entre hombres y mujeres y que el modelo no contiene, como la ocupación, el sector, las horas trabajadas o las interrupciones de la carrera laboral. El coeficiente \(-1{,}81\) mide la diferencia salarial entre hombres y mujeres con igual educación, experiencia y antigüedad observadas; no mide la discriminación, que exigiría comparar trabajadores iguales en todo lo relevante, ni dice qué parte de la diferencia se debe a cada causa. La transparencia ``Qué dice y qué no dice el coeficiente de una indicadora'' recoge esta cautela entre las lecturas incorrectas más frecuentes.
Para profundizar: Wooldridge, J. M. (2020), cap. 7, sección 7.2, ejemplo 7.1 (``Hourly wage equation'') y la discusión sobre la interpretación del coeficiente de female.
4. En log-nivel: una diferencia porcentual
El mismo modelo con el logaritmo del salario (lwage) como regresando:
lwage sobre… |
coef. | \(\mathrm{ee}\) | \(t\) |
|---|---|---|---|
| constante | \(0{,}501\) | \(0{,}102\) | \(4{,}92\) |
female |
\(-0{,}301\) | \(0{,}037\) | \(-8{,}09\) |
educ |
\(0{,}0875\) | \(0{,}0069\) | \(12{,}60\) |
exper |
\(0{,}0046\) | \(0{,}0016\) | \(2{,}85\) |
tenure |
\(0{,}0174\) | \(0{,}0030\) | \(5{,}84\) |
Aproximación (lección 15): con lo demás fijo, el salario de una mujer es menor en la fracción \(0{,}30\), un \(30\) %. Cálculo exacto: \(e^{-0{,}301}-1=-0{,}260\), un \(26\) % menor; para un cambio grande, la aproximación se aleja del valor exacto. Intervalo al 95 % para el coeficiente de female: \([-0{,}374,\,-0{,}228]\), del \(-31\) % al \(-20\) % en diferencia exacta.
La lectura depende de la categoría base: el salario de un hombre es un \(35\) % mayor que el de una mujer con la misma educación, experiencia y antigüedad, porque \(e^{0{,}301}-1=0{,}351\). El mismo coeficiente da dos porcentajes, porque cada uno se calcula sobre el salario de un grupo distinto.
En log-nivel: una diferencia porcentual
La lección 15 explicó por qué la ecuación de salarios se estima con el logaritmo del salario como regresando: el rendimiento de la educación se enuncia en porcentaje, y la hipótesis de que cada año multiplica el salario por un factor es más verosímil que la de que le suma una cantidad fija. Lo mismo vale para la diferencia entre sexos: es más natural pensar que las mujeres cobran un cierto porcentaje menos que los hombres que una cantidad fija de dólares, sea el salario de \(3\) o de \(20\) dólares por hora. La tabla de la transparencia estima el modelo de la transparencia ``Con más regresores: la diferencia con lo demás fijo'' con lwage en lugar de wage.
El coeficiente de female es \(-0{,}301\). La aproximación de la lección 15, \(\log(1+p)\approx p\), da la lectura rápida: con la misma educación, experiencia y antigüedad, el salario de una mujer es menor en la fracción \(0{,}30\), un \(30\) %. Pero el coeficiente es grande, y para cambios grandes la aproximación se aleja del valor exacto, como se vio con los cuatro años de educación en la lección 15. El cálculo exacto se hace como allí, deshaciendo el logaritmo: el modelo predice para una mujer un salario \(e^{-0{,}301}=0{,}740\) veces el de un hombre con los mismos regresores, es decir, menor en \(e^{-0{,}301}-1=-0{,}260\), un \(26\) %. En general, si el coeficiente de una indicadora en un modelo log-nivel es \(\beta\), el salario del grupo señalado es \(e^{\beta}\) veces el de la categoría base, con lo demás fijo, y la diferencia porcentual exacta es \(e^{\beta}-1\). La aproximación \(\beta\) sirve cuando el coeficiente es pequeño, por debajo de \(0{,}1\) en valor absoluto; para \(0{,}3\) la diferencia entre \(30\) % y \(26\) % ya importa al informar.
Con la versión exacta aparece una asimetría que con la aproximación pasa inadvertida. La misma estimación dice que una mujer cobra un \(26\) % menos que un hombre con la misma educación, experiencia y antigüedad, y que ese hombre cobra un \(35\) % más que ella, porque \(e^{0{,}301}-1=0{,}351\). Las dos frases son correctas y describen el mismo cociente de salarios, \(0{,}740\) o su inverso \(1{,}351\); difieren en el salario sobre el que se calcula el porcentaje. Con la aproximación las dos lecturas darían \(30\) %, lo que oculta la diferencia. Al informar una diferencia porcentual entre grupos hay que decir respecto de qué grupo se calcula, y la indicadora lo fija: el coeficiente de female compara a las mujeres con los hombres, que son el grupo con valor \(0\), la categoría base.
El intervalo de confianza se construye como en la lección 12 para el coeficiente, de \(-0{,}374\) a \(-0{,}228\), y después se transforma: los extremos de la diferencia exacta son \(e^{-0{,}374}-1=-0{,}312\) y \(e^{-0{,}228}-1=-0{,}204\), así que los valores de la diferencia porcentual entre sexos, con las tres variables fijas, que el contraste al 5 % no rechaza van del \(-31\) % al \(-20\) %. La transformación se aplica a los extremos y no al error estándar, porque la exponencial no es lineal; el intervalo transformado deja de ser simétrico alrededor de la estimación puntual, \(-0{,}260\).
Los demás coeficientes se leen como en la lección 15. Un año más de educación se acompaña de un salario mayor en la fracción \(0{,}0875\), un \(8{,}75\) % aproximado y un \(9{,}1\) % exacto; un año más de antigüedad, en un \(1{,}7\) %. Son cifras algo distintas de las de la lección 15, donde el modelo tenía educ como único regresor; al añadir female, exper y tenure, el coeficiente de educ pasa a ser el de la parte de educ que no comparte con los tres regresores nuevos, la parte propia de la lección 14.
El modelo impone que la diferencia entre sexos sea la misma para cualquier valor de los demás regresores. La figura lo muestra con un modelo más pequeño, para que quepa en un plano: lwage sobre la constante, female y exper, sin educ ni tenure,
\[\widehat{\log(\text{wage})}=\underset{(0{,}041)}{1{,}748}-\underset{(0{,}043)}{0{,}393}\,\text{female}+\underset{(0{,}0016)}{0{,}0038}\,\text{exper}.\]
Para los hombres, female vale \(0\) y la recta es \(1{,}748+0{,}0038\,\text{exper}\); para las mujeres vale \(1\) y la recta es \((1{,}748-0{,}393)+0{,}0038\,\text{exper}=1{,}355+0{,}0038\,\text{exper}\). La indicadora solo cambia el intercepto; la pendiente de la experiencia es la misma para los dos sexos, y las rectas son paralelas. Por eso la distancia vertical entre ellas, la diferencia entre sexos en logaritmos, es \(-0{,}393\) con cualquier experiencia. Que esa distancia no cambie con la experiencia es una restricción del modelo, no un resultado de los datos; la transparencia ``Interacciones: la pendiente cambia de grupo'' la levanta.
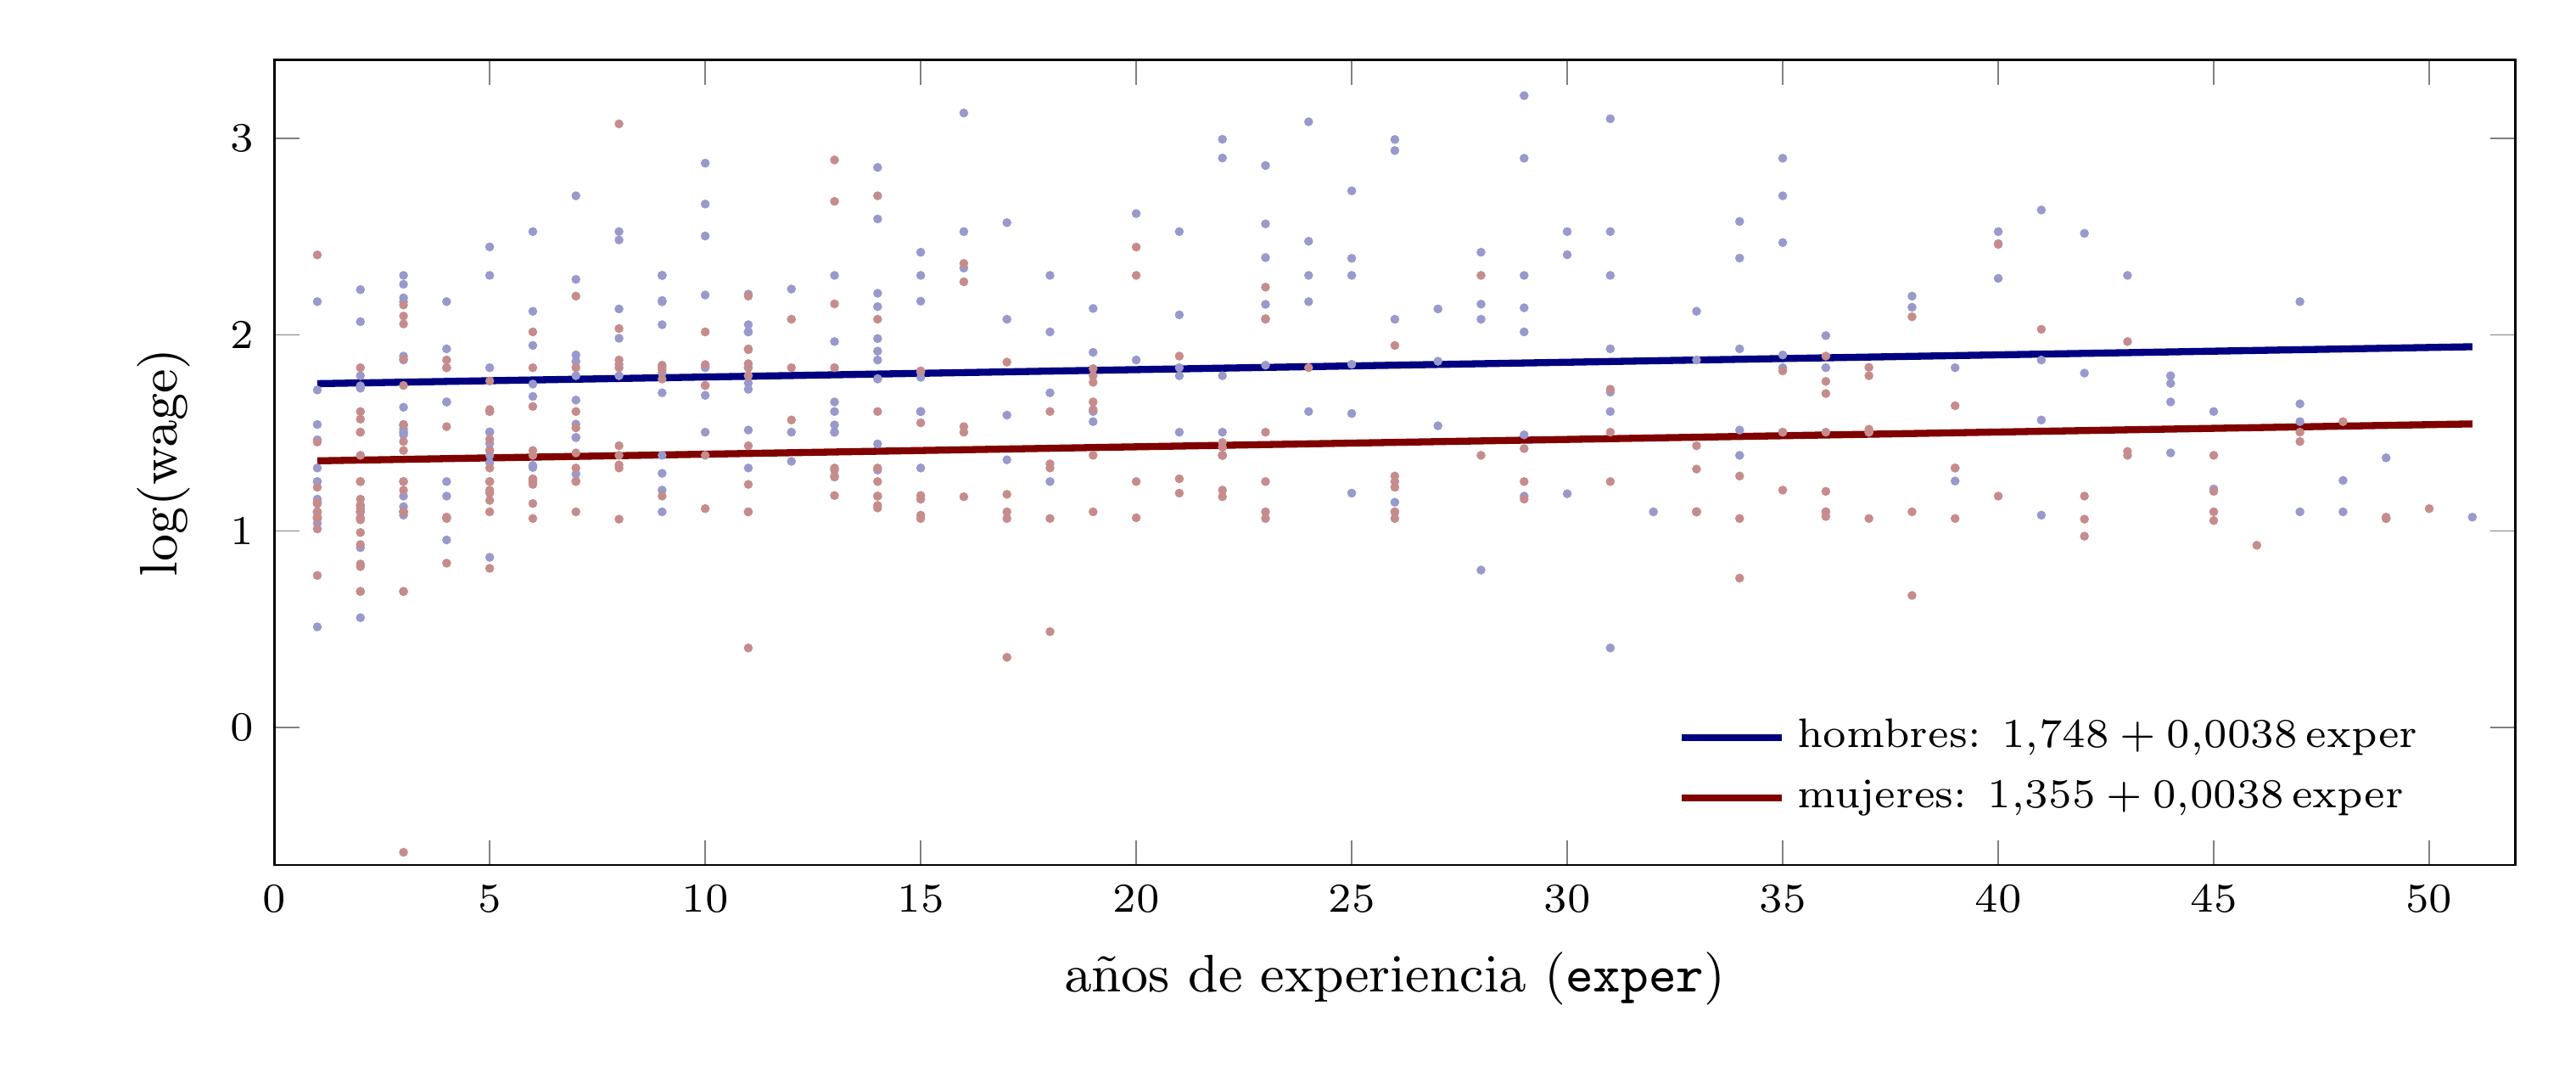
Figura 2: Los \(526\) trabajadores de wage1: logaritmo del salario por hora frente a los años de experiencia, los hombres en azul y las mujeres en rojo. Las dos rectas son el ajuste de lwage sobre la constante, female y exper: la indicadora separa las ordenadas en el origen, \(1{,}748\) y \(1{,}355\), y las dos rectas tienen la misma pendiente, \(0{,}0038\).
Para profundizar: Wooldridge, J. M. (2020), cap. 7, sección 7.2, apartado ``Interpreting coefficients on dummy explanatory variables when the dependent variable is log(y)'', con el ejemplo 7.4; Halvorsen, R. y Palmquist, R. (1980), ``The interpretation of dummy variables in semilogarithmic equations'', American Economic Review 70, 474–475, el artículo que fijó la lectura exacta \(e^{\beta}-1\).
5. La trampa de las variables ficticias
La indicadora de ser hombre es \(\mathbb 1_{\text{hombre}}=\mathit 1-\mathbb 1_{\text{mujer}}\): las dos suman la indicadora del suceso seguro, \(\mathbb 1_{\text{mujer}}+\mathbb 1_{\text{hombre}}=\mathbb 1_\Omega=\mathit 1\). En la muestra, \(\boldsymbol d_{\text{mujer}}+\boldsymbol d_{\text{hombre}}=\boldsymbol 1\).
Poner las tres columnas en \(\boldsymbol{\mathsf X}\) es la colinealidad exacta de la lección 10: tres columnas que generan un subespacio de dimensión dos. Gretl avisa: «Omitidas debido a colinealidad exacta: =male=».
Tres escrituras del mismo modelo, lwage sobre el sexo (sin otros regresores):
| Regresores | Coeficientes | Lectura |
|---|---|---|
constante, female |
\(1{,}814\); \(-0{,}397\) | media de los hombres; diferencia mujeres \(-\) hombres |
constante, male |
\(1{,}416\); \(+0{,}397\) | media de las mujeres; diferencia hombres \(-\) mujeres |
female, male |
\(1{,}416\); \(1{,}814\) | media de cada grupo |
El mismo subespacio y el mismo ajuste (\(\mathrm{SRC}=127{,}6\)) con otra base: cambia la categoría base de la lectura. En la tercera, \(\boldsymbol 1\) no es columna, pero está en el subespacio (lección 10).
La trampa de las variables ficticias
La lección 14 dejó anunciada esta transparencia: si se incluyen en el modelo una indicadora de mujer, otra de hombre y la constante, hay colinealidad exacta. La razón está en la definición de la lección 12. La indicadora del suceso ``ser hombre'' es la del complementario de ``ser mujer'', \(\mathbb 1_{\text{hombre}}=\mathit 1-\mathbb 1_{\text{mujer}}\), de modo que las dos indicadoras suman la indicadora del suceso seguro: \(\mathbb 1_{\text{mujer}}+\mathbb 1_{\text{hombre}}=\mathbb 1_\Omega=\mathit 1\), que es la constante del modelo. En la muestra, cada fila tiene un \(1\) en una de las dos columnas y un \(0\) en la otra, y \(\boldsymbol d_{\text{mujer}}+\boldsymbol d_{\text{hombre}}=\boldsymbol 1\). Si \(\boldsymbol{\mathsf X}\) contiene las tres columnas, una de ellas es combinación lineal de las otras dos: es la colinealidad exacta de la lección 10, y la actividad 6 (html) de la práctica D de la sesión 14 la construyó a propósito. Las tres columnas generan un subespacio de dimensión dos, la proyección de \(\boldsymbol y\) sobre él existe y es única, pero hay infinitas maneras de escribirla como combinación lineal de tres vectores que no son linealmente independientes, y las ecuaciones normales no tienen solución única. Gretl lo detecta al estimar y elimina una de las columnas, con el aviso «Omitidas debido a colinealidad exacta: =male=» en la cabecera de la tabla de resultados. Este error recibe en los manuales el nombre de trampa de las variables ficticias.
La solución es omitir una de las tres columnas, y las tres opciones estiman el mismo modelo. La tabla de la transparencia lo muestra con lwage sobre el sexo, sin otros regresores, para que los coeficientes sean medias. Con la constante y female, la constante es la media del logaritmo del salario de los hombres, \(1{,}814\), y el coeficiente de female es la diferencia entre la media de las mujeres y la de los hombres, \(-0{,}397\). Con la constante y male, la constante es la media de las mujeres, \(1{,}416\), y el coeficiente de male la misma diferencia con el signo cambiado. Con las dos indicadoras y sin constante, cada coeficiente es la media de su grupo, por la ortogonalidad de las dos indicadoras que explicó la transparencia ``Una indicadora desplaza el intercepto: el río Charles''. Los tres ajustes son el mismo vector \(\boldsymbol{\mathop{\widehat y}}\), con la misma suma de cuadrados de los residuos, \(127{,}6\), porque las tres parejas de columnas generan el mismo subespacio de dimensión dos: \(\mathcal L(\boldsymbol 1,\boldsymbol d_{\text{mujer}})=\mathcal L(\boldsymbol 1,\boldsymbol d_{\text{hombre}})=\mathcal L(\boldsymbol d_{\text{mujer}},\boldsymbol d_{\text{hombre}})\). Lo que cambia es la base y, con ella, el significado de cada coeficiente.
La tercera escritura ilustra una observación que la lección 10 hizo al presentar la matriz de regresores: lo que necesita el ajuste no es que \(\boldsymbol 1\) sea una de las columnas de \(\boldsymbol{\mathsf X}\), sino que \(\boldsymbol 1\) pertenezca al subespacio que generan. En el modelo con female y male ninguna columna es constante, pero su suma es \(\boldsymbol 1\), así que \(\boldsymbol 1\in\mathcal L(\boldsymbol d_{\text{mujer}},\boldsymbol d_{\text{hombre}})\) y todo lo que depende de ello sigue valiendo: los residuos suman cero, la media de los valores ajustados es la media de \(\boldsymbol y\) y el \(R^2\) se calcula como en la lección 8. Gretl lo tiene en cuenta: si se estima un modelo sin la constante pero con las dos indicadoras, el \(R^2\) que imprime es el habitual.
En la práctica, la escritura que se usa es la primera, con la constante y una indicadora por cada grupo menos uno. El grupo sin indicadora es la categoría base, y todos los coeficientes de indicadoras se leen como diferencias respecto de ella. Elegir la categoría base es una decisión de presentación, no de modelo: cambiarla no altera el ajuste ni ningún contraste sobre el modelo completo, solo reordena qué diferencias aparecen directamente como coeficientes, con su error estándar y su \(t\). La transparencia ``Varias categorías: una indicadora menos que grupos'' usa este recurso para comparar dos grupos que no son la categoría base.
Para profundizar: Wooldridge, J. M. (2020), cap. 7, sección 7.2 (``the dummy variable trap'') y cap. 3, sección 3.3 (colinealidad perfecta); lección 10 de este curso, apuntes de ``La matriz de regresores y el operador selector''.
6. Varias categorías: una indicadora menos que grupos
Con female y married de wage1 se construyen cuatro indicadoras, una por grupo: \(86\) hombres solteros, \(188\) casados, \(120\) mujeres solteras y \(132\) casadas. Suman \(\boldsymbol 1\): con la constante entran tres; categoría base, los hombres solteros.
lwage sobre… |
coef. | \(\mathrm{ee}\) | \(t\) | \(e^{\beta}-1\) |
|---|---|---|---|---|
| hombre casado | \(0{,}292\) | \(0{,}055\) | \(5{,}27\) | \(+34\) % |
| mujer casada | \(-0{,}120\) | \(0{,}058\) | \(-2{,}07\) | \(-11\) % |
| mujer soltera | \(-0{,}097\) | \(0{,}057\) | \(-1{,}68\) | \(-9\) % |
educ, exper, tenure |
\(0{,}0835\); \(0{,}0032\); \(0{,}0157\) |
Lectura: con la misma educación, experiencia y antigüedad, y respecto de lo que cobra un hombre soltero, un hombre casado cobra un \(34\) % más, una mujer casada un \(11\) % menos y una mujer soltera un \(9\) % menos.
Comparar dos grupos que no son la categoría base: una mujer casada frente a una soltera. La diferencia es la resta de sus coeficientes, \(-0{,}120-(-0{,}097)=-0{,}023\): la casada cobra un \(2\) % menos. Su \(\mathrm{ee}\) no está en la tabla. Se obtiene estimando de nuevo con las mujeres solteras como categoría base: \(\mathrm{ee}=0{,}053\) y \(t=-0{,}45\). Datos como estos no serían raros si casadas y solteras cobrasen lo mismo.
Varias categorías: una indicadora menos que grupos
Una variable cualitativa puede tener más de dos categorías: la región, el sector o el nivel de estudios por tramos. Se trata igual que el sexo. Cada categoría tiene su indicadora. Si cada unidad pertenece a una y solo a una de las \(g\) categorías, en cada fila de la muestra una de las \(g\) columnas indicadoras vale \(1\) y las demás valen \(0\). Por eso las \(g\) columnas suman \(\boldsymbol 1\), igual que \(\boldsymbol d_{\text{mujer}}+\boldsymbol d_{\text{hombre}}=\boldsymbol 1\).
Si el modelo tiene constante, no puede incluir las \(g\) indicadoras, sino solo \(g-1\). Con las \(g\), la columna \(\boldsymbol 1\) sería la suma de otras \(g\) columnas de \(\boldsymbol{\mathsf X}\): los regresores serían linealmente dependientes y los coeficientes no estarían determinados (la colinealidad exacta de la transparencia ``La trampa de las variables ficticias''). La categoría que se queda sin indicadora es la categoría base. El coeficiente de cada indicadora mide la diferencia entre su categoría y la categoría base cuando se comparan unidades con los mismos valores de los demás regresores (en el ejemplo, la misma educación, experiencia y antigüedad).
El modelo también puede escribirse sin constante y con las \(g\) indicadoras. Entonces el coeficiente de cada una es el valor ajustado para esa categoría cuando los demás regresores valen cero. Las dos formulaciones proyectan el regresando sobre el mismo subespacio, porque cada columna de una matriz de regresores es combinación lineal de las columnas de la otra: \(\boldsymbol 1\) es la suma de las \(g\) indicadoras, y la indicadora de la categoría base es \(\boldsymbol 1\) menos las otras \(g-1\). Por tanto dan el mismo ajuste y los mismos residuos; solo cambia lo que mide cada coeficiente.
El ejemplo de la transparencia combina dos variables de dos categorías, el sexo y el estado civil, en una de cuatro: hombres solteros, hombres casados, mujeres solteras y mujeres casadas, con \(86\), \(188\), \(120\) y \(132\) trabajadores. El fichero wage1 no trae las cuatro indicadoras; trae dos, female, que vale \(1\) para las mujeres, y married, que vale \(1\) para los casados. Las cuatro se construyen con dos identidades entre indicadoras que se comprueban \(\omega\) a \(\omega\), recogidas en la sección 1.4 del apéndice (pdf) (html). La primera: la indicadora del complementario es \(\mathit 1\) menos la indicadora, así que 1-female señala a los hombres y 1-married a los solteros. La segunda: el producto de dos indicadoras vale \(1\) solo cuando las dos valen \(1\), así que es la indicadora de la intersección de los dos sucesos. Por ejemplo, married*(1-female) vale \(1\) en las filas de los hombres casados y \(0\) en las demás. Las cuatro indicadoras son estas:
| hombres solteros | (1-female)*(1-married) |
| hombres casados | (1-female)*married |
| mujeres solteras | female*(1-married) |
| mujeres casadas | female*married |
En Gretl cada una se crea con una orden series, por ejemplo series hcasado = (1-female)*married, y del mismo modo mcasada y msoltera. En cada fila vale \(1\) una y solo una de las cuatro, porque cada trabajador está en uno y solo un grupo, y su suma es \(\boldsymbol 1\). Con los hombres solteros como categoría base, el modelo tiene la constante, tres indicadoras y educ, exper y tenure. La ecuación estimada es
\[\begin{aligned}\widehat{\log(\text{wage})}&=\underset{(0{,}102)}{0{,}388}+\underset{(0{,}055)}{0{,}292}\,\text{hcasado}-\underset{(0{,}058)}{0{,}120}\,\text{mcasada}-\underset{(0{,}057)}{0{,}097}\,\text{msoltera}\\&\quad+\underset{(0{,}0069)}{0{,}0835}\,\text{educ}+\underset{(0{,}0017)}{0{,}0032}\,\text{exper}+\underset{(0{,}0029)}{0{,}0157}\,\text{tenure}.\end{aligned}\]
Cada coeficiente de indicadora mide la diferencia, en logaritmos, entre su grupo y los hombres solteros con la misma educación, experiencia y antigüedad, y la columna \(e^{\beta}-1\) de la tabla de la transparencia la convierte en diferencia porcentual exacta. Respecto de lo que cobra un hombre soltero con la misma educación, experiencia y antigüedad, un hombre casado cobra un \(34\) % más, una mujer casada un \(11\) % menos y una mujer soltera un \(9\) % menos. Para preguntar si cada una de esas diferencias podría ser nula se contrasta que su parámetro vale cero, con el estadístico \(t\), el coeficiente dividido por su error estándar. Para los hombres casados, \(t=5{,}27\): datos como estos serían muy raros si los hombres casados cobrasen lo mismo que los solteros con la misma educación, experiencia y antigüedad, y el contraste al 5 % rechaza. Para las mujeres casadas, \(t=-2{,}07\), y el contraste al 5 % también rechaza, porque \(|t|\) supera el valor crítico, \(1{,}96\). Para las mujeres solteras, \(t=-1{,}68\): datos como estos no serían demasiado raros si cobrasen lo mismo que los hombres solteros, y el contraste al 5 % no rechaza.
La ecuación estimada da directamente las tres diferencias con la categoría base, pero no las diferencias entre dos grupos que no son la categoría base. La diferencia entre mujeres casadas y solteras es la resta de los dos coeficientes, \(-0{,}120-(-0{,}097)=-0{,}023\) (un \(2\) % menos), y su error estándar no se obtiene de los de la ecuación. La varianza de una diferencia de dos estimadores, aquí los coeficientes \(\hat\beta_3\) de mcasada y \(\hat\beta_4\) de msoltera, es \(\mathrm{Var}(\hat\beta_3-\hat\beta_4)=\mathrm{Var}(\hat\beta_3)+\mathrm{Var}(\hat\beta_4)-2\,\mathrm{Cov}(\hat\beta_3,\hat\beta_4)\), la varianza de una diferencia de variables aleatorias de la asignatura de Estadística, y la tabla de resultados de Gretl no imprime la covarianza. Aquí la covarianza no es despreciable. Los dos coeficientes son diferencias respecto del mismo grupo, los hombres solteros, y un error al estimar lo que cobra ese grupo desplaza a los dos en el mismo sentido. La covarianza estimada es positiva, \(0{,}0019\), y el error estándar de la diferencia es \(\sqrt{0{,}058^2+0{,}057^2-2\times0{,}0019}=0{,}053\); sin la covarianza saldría \(\sqrt{0{,}058^2+0{,}057^2}=0{,}081\). Hay una forma de evitar el cálculo: cambiar la categoría base. Si se estima el mismo modelo con las mujeres solteras como categoría base, es decir, con las indicadoras de hombres solteros, hombres casados y mujeres casadas (hsoltero = (1-female)*(1-married), hcasado y mcasada), la ecuación estimada es
\[\begin{aligned}\widehat{\log(\text{wage})}&=\underset{(0{,}099)}{0{,}291}+\underset{(0{,}057)}{0{,}097}\,\text{hsoltero}+\underset{(0{,}050)}{0{,}389}\,\text{hcasado}-\underset{(0{,}053)}{0{,}023}\,\text{mcasada}\\&\quad+\underset{(0{,}0069)}{0{,}0835}\,\text{educ}+\underset{(0{,}0017)}{0{,}0032}\,\text{exper}+\underset{(0{,}0029)}{0{,}0157}\,\text{tenure}.\end{aligned}\]
El coeficiente de mcasada es ahora directamente la diferencia buscada, \(-0{,}023\), con su error estándar, \(0{,}053\), y su \(t\), \(-0{,}45\): datos como estos no serían raros si las mujeres casadas y las solteras cobrasen lo mismo, con lo demás fijo. Los coeficientes de las otras dos indicadoras son también diferencias respecto de las mujeres solteras, y se obtienen de la primera ecuación restándoles el de msoltera, \(-0{,}097\): \(0-(-0{,}097)=0{,}097\) para los hombres solteros y \(0{,}292-(-0{,}097)=0{,}389\) para los casados. La constante, en cambio, le suma ese coeficiente: \(0{,}388+(-0{,}097)=0{,}291\). El ajuste y los coeficientes de educ, exper y tenure no cambian al cambiar la categoría base; solo cambia qué diferencias se leen directamente.
Hay otra forma de poner el sexo y el estado civil en el modelo: dos indicadoras, female y married, en lugar de tres. La ecuación estimada es
\[\begin{aligned}\widehat{\log(\text{wage})}&=\underset{(0{,}101)}{0{,}490}-\underset{(0{,}037)}{0{,}286}\,\text{female}+\underset{(0{,}040)}{0{,}126}\,\text{married}\\&\quad+\underset{(0{,}0070)}{0{,}0839}\,\text{educ}+\underset{(0{,}0017)}{0{,}0031}\,\text{exper}+\underset{(0{,}0030)}{0{,}0169}\,\text{tenure}.\end{aligned}\]
Ese modelo es más restrictivo. El coeficiente de married, \(0{,}126\) en logaritmos, es la diferencia entre casados y solteros, y el modelo impone que sea la misma para hombres y para mujeres. En el modelo de los cuatro grupos las dos diferencias estimadas son muy distintas. En la primera ecuación de esta sección, la diferencia entre casados y solteros es \(0{,}292\) entre los hombres (el coeficiente de hcasado, porque la categoría base son los hombres solteros) y \(-0{,}120-(-0{,}097)=-0{,}023\) entre las mujeres. El modelo de los cuatro grupos es el de las dos indicadoras más su producto, femmar = female*married, y ese producto es una interacción: permite que la diferencia entre casados y solteros dependa del sexo. Estimado así,
\[\begin{aligned}\widehat{\log(\text{wage})}&=\underset{(0{,}102)}{0{,}388}-\underset{(0{,}057)}{0{,}097}\,\text{female}+\underset{(0{,}055)}{0{,}292}\,\text{married}-\underset{(0{,}074)}{0{,}316}\,\text{femmar}\\&\quad+\underset{(0{,}0069)}{0{,}0835}\,\text{educ}+\underset{(0{,}0017)}{0{,}0032}\,\text{exper}+\underset{(0{,}0029)}{0{,}0157}\,\text{tenure},\end{aligned}\]
da el mismo ajuste que el de los cuatro grupos, con la misma constante y la misma suma de cuadrados de los residuos, \(85{,}46\), porque los dos generan el mismo subespacio. Cambia lo que mide cada coeficiente, siempre respecto de los hombres solteros. El de married mide la diferencia entre casados y solteros entre los hombres, \(0{,}292\). El de female, la diferencia entre mujeres solteras y hombres solteros, \(-0{,}097\). El de la interacción, cuánto cambia la diferencia entre casados y solteros al pasar de los hombres a las mujeres: \(-0{,}316\), la resta \(-0{,}023-0{,}292\) salvo redondeo. Su \(t\) es \(-4{,}27\): datos como estos serían muy raros si la diferencia entre casados y solteros fuese la misma para hombres y mujeres, que es la restricción del modelo de dos indicadoras. Es la idea de la transparencia ``Interacciones: la pendiente cambia de grupo'', aplicada a dos indicadoras.
Para profundizar: Wooldridge, J. M. (2020), cap. 7, sección 7.3 (``Using dummy variables for multiple categories''), con el ejemplo 7.6, que es este modelo con dos regresores cuadráticos más; sección 7.4 para la interacción entre dos indicadoras.
7. Interacciones: la pendiente cambia de grupo
Una indicadora desplaza el intercepto; su producto por otro regresor, la interacción, desplaza una pendiente:
\[\log(\text{wage})=\beta_1\,\mathit 1+\beta_2\,\mathbb 1_{\text{mujer}}+\beta_3\,\text{educ}+\beta_4\,\text{exper}+\beta_5\,\mathbb 1_{\text{mujer}}\cdot\text{exper}+\beta_6\,\text{tenure}+U.\]
Pendiente de exper: \(\beta_4\) para los hombres, \(\beta_4+\beta_5\) para las mujeres. Diferencia de interceptos: \(\beta_2\).
lwage sobre… |
coef. | \(\mathrm{ee}\) | \(t\) |
|---|---|---|---|
female |
\(-0{,}190\) | \(0{,}059\) | \(-3{,}25\) |
exper |
\(0{,}0084\) | \(0{,}0022\) | \(3{,}76\) |
female*exper |
\(-0{,}0067\) | \(0{,}0027\) | \(-2{,}44\) |
educ, tenure |
\(0{,}0896\); \(0{,}0158\) |
Lectura, con la misma educación y antigüedad: un año más de experiencia se acompaña de un salario un \(0{,}84\) % mayor para los hombres y un \(0{,}84+(-0{,}67)=0{,}17\) % para las mujeres. Con la misma experiencia, la diferencia de la mujer respecto del hombre es \(-0{,}190-0{,}0067\,\text{exper}\) en logaritmos, y \(e^{-0{,}190-0{,}0067\,\text{exper}}-1\) en porcentaje exacto. Con \(t=-2{,}44\), datos como estos serían raros si las dos pendientes fuesen iguales.
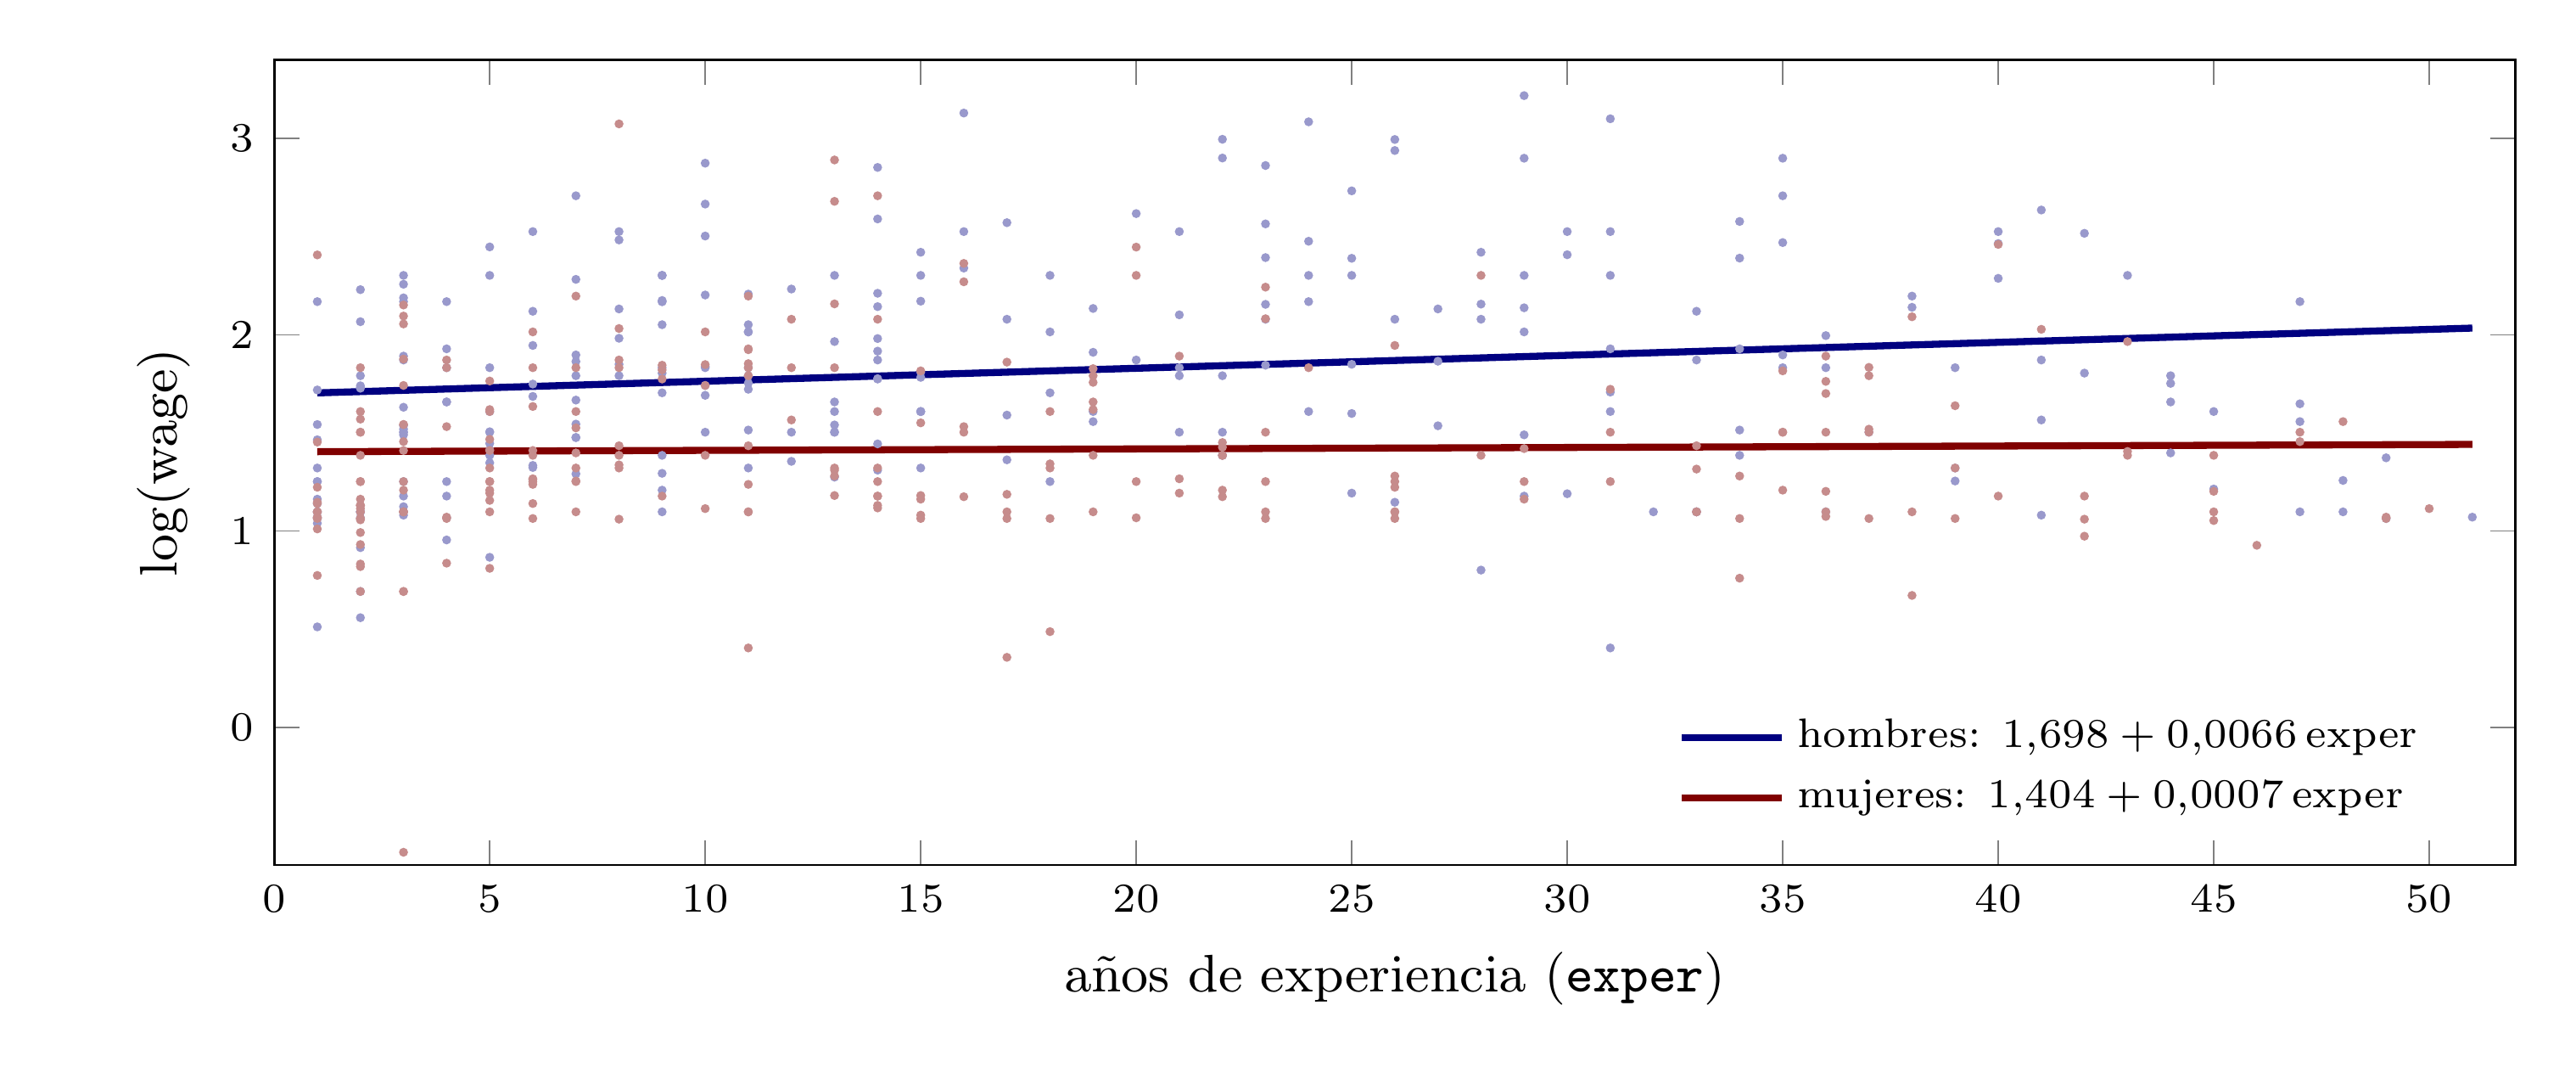
Figura 3: Los \(526\) trabajadores de wage1: logaritmo del salario por hora frente a los años de experiencia, los hombres en azul y las mujeres en rojo. Las dos rectas son el ajuste de lwage sobre la constante, female, exper y su producto, sin educ ni tenure para que la figura sea plana: la de los hombres tiene ordenada en el origen \(1{,}698\) y pendiente \(0{,}0066\); la de las mujeres, \(1{,}404\) y \(0{,}0007\). La indicadora separa las dos ordenadas en el origen y la interacción separa las dos pendientes: la distancia vertical entre las rectas crece con la experiencia. Los coeficientes de la tabla de la transparencia, con educ y tenure, son algo distintos de los de la figura.
Una indicadora: dos rectas paralelas. Una indicadora y una interacción: dos rectas distintas. Sin ninguna de las dos: una sola recta para todos.
Interacciones: la pendiente cambia de grupo
El modelo de la transparencia ``En log-nivel: una diferencia porcentual'' impone que la diferencia salarial entre sexos sea la misma a cualquier nivel de experiencia: la indicadora desplaza el intercepto y nada más, así que las dos rectas del salario frente a la experiencia, una para cada sexo, son paralelas. Es una restricción, y los datos pueden no cumplirla. Para permitir que la pendiente de exper sea distinta en cada grupo se añade al modelo el producto de la indicadora por el regresor, \(\mathbb 1_{\text{mujer}}\cdot\text{exper}\), que se llama interacción entre las dos variables. En la muestra es una columna más de \(\boldsymbol{\mathsf X}\): vale exper en las filas de las mujeres y \(0\) en las de los hombres; Gretl la construye con series femexper = female*exper. Es un regresor en el sentido de la lección 15, una función de dos variables explicativas, y se estima como cualquier otro regresor.
La lectura se obtiene escribiendo el modelo por grupos. Para un hombre, \(\mathbb 1_{\text{mujer}}=0\), y la parte sistemática es \(\beta_1+\beta_3\,\text{educ}+\beta_4\,\text{exper}+\beta_6\,\text{tenure}\): la pendiente de la experiencia es \(\beta_4\). Para una mujer, \(\mathbb 1_{\text{mujer}}=1\), y queda \((\beta_1+\beta_2)+\beta_3\,\text{educ}+(\beta_4+\beta_5)\,\text{exper}+\beta_6\,\text{tenure}\): el intercepto se desplaza en \(\beta_2\) y la pendiente de la experiencia pasa a ser \(\beta_4+\beta_5\). El coeficiente de la interacción, \(\beta_5\), es por tanto la diferencia entre las pendientes de los dos grupos, y la hipótesis de que las dos rectas son paralelas es \(H_0\!:\beta_5=0\), que se contrasta con el \(t\) de la lección 12.
Con los datos, la ecuación estimada es
\[\begin{aligned}\widehat{\log(\text{wage})}&=\underset{(0{,}107)}{0{,}417}-\underset{(0{,}059)}{0{,}190}\,\text{female}+\underset{(0{,}0070)}{0{,}0896}\,\text{educ}+\underset{(0{,}0022)}{0{,}0084}\,\text{exper}\\&\quad-\underset{(0{,}0027)}{0{,}0067}\,\text{femexper}+\underset{(0{,}0030)}{0{,}0158}\,\text{tenure}.\end{aligned}\]
La pendiente de la experiencia es \(0{,}0084\) para los hombres: un año más de experiencia se acompaña de un salario mayor en un \(0{,}84\) %, con lo demás fijo. Para las mujeres es \(\hat\beta_4+\hat\beta_5=0{,}0084+(-0{,}0067)=0{,}0017\), un \(0{,}17\) % por año. El \(t\) de la interacción es \(-2{,}44\): datos como estos serían raros si las dos pendientes fuesen iguales, y el contraste al 5 % rechaza que lo sean. El coeficiente de female, \(-0{,}190\), es ahora la diferencia de interceptos, es decir, la diferencia en logaritmos entre una mujer y un hombre sin experiencia y con la misma educación y antigüedad. Para verlo, se restan las partes sistemáticas de una mujer y de un hombre con la misma educación, la misma experiencia y la misma antigüedad. Los términos \(\beta_1\), \(\beta_3\,\text{educ}\), \(\beta_4\,\text{exper}\) y \(\beta_6\,\text{tenure}\) son iguales para los dos y se anulan en la resta, y quedan los de la indicadora y la interacción: \(\beta_2+\beta_5\,\text{exper}\). La diferencia no depende, por tanto, de cuánta educación y antigüedad tengan, con tal de que sean las mismas para los dos; sí depende de la experiencia. Con \(\text{exper}=0\) es \(\hat\beta_2=-0{,}190\), y cada año de experiencia le suma \(\hat\beta_5=-0{,}0067\), así que la brecha se amplía. A los diez años es \(-0{,}190+10\cdot(-0{,}0067)=-0{,}257\), y a los veinte, \(-0{,}324\). En diferencia porcentual exacta, con la fórmula \(e^{\beta}-1\) de la transparencia ``En log-nivel: una diferencia porcentual'', son \(e^{-0{,}190}-1=-0{,}173\), \(e^{-0{,}257}-1=-0{,}227\) y \(e^{-0{,}324}-1=-0{,}277\): con la misma educación y antigüedad, una mujer cobra un \(17\) % menos que un hombre si ninguno de los dos tiene experiencia, un \(23\) % menos si los dos tienen diez años y un \(28\) % menos si tienen veinte. La figura dibuja esta situación con el modelo simple sin educ ni tenure: la recta de los hombres sube con la experiencia y la de las mujeres apenas, y la distancia entre las dos crece de izquierda a derecha. Sin la interacción, el mismo modelo daba las dos rectas paralelas de la figura de ``En log-nivel: una diferencia porcentual''.
La misma construcción se aplica a cualquier regresor, y el resultado no siempre es una pendiente distinta. Con la interacción female*educ en lugar de female*exper, el coeficiente de la interacción es \(-0{,}0072\) con error estándar \(0{,}0136\) y \(t=-0{,}53\): datos como estos no serían raros si el rendimiento de la educación fuese el mismo para hombres y mujeres, y el contraste no sugiere pendientes distintas en educ. Al añadir la interacción female*educ cambia también la lectura del coeficiente de female. Por el mismo argumento que con la experiencia, la diferencia entre una mujer y un hombre con la misma educación, experiencia y antigüedad es \(\beta_2+\beta_5\,\text{educ}\), con \(\beta_5\) ahora el coeficiente de female*educ. El coeficiente de female, \(\beta_2\), es esa diferencia con \(\text{educ}=0\): entre una mujer y un hombre sin ningún año de educación. En la muestra solo dos trabajadores tienen cero años de educación, así que los datos apenas informan sobre esa diferencia. El coeficiente se obtiene prolongando hasta cero años de educación las rectas de hombres y mujeres, que están estimadas con trabajadores de entre \(8\) y \(18\) años de educación en su gran mayoría. Por eso su error estándar es grande: el coeficiente estimado es \(-0{,}21\) con error estándar \(0{,}17\).
Cuando interesa la diferencia entre sexos en un punto con datos, se elige ese punto como el cero del regresor. Lo habitual es la media. Se construye el regresor centrado educc = educ - mean(educ), que vale cero en la media de la educación, \(12{,}56\) años, y su interacción female*educc. Centrar solo traslada el origen del regresor: \(\boldsymbol x_{\text{educc}}=\boldsymbol x_{\text{educ}}-12{,}56\,\boldsymbol 1\) y \(\boldsymbol d_{\text{mujer}}\odot\boldsymbol x_{\text{educc}}=\boldsymbol d_{\text{mujer}}\odot\boldsymbol x_{\text{educ}}-12{,}56\,\boldsymbol d_{\text{mujer}}\), con \(\odot\) el producto componente a componente de la lección 7, así que las columnas nuevas son combinaciones lineales de las antiguas y generan el mismo subespacio. El ajuste, la pendiente de la educación y el coeficiente de la interacción, con su \(t\), no cambian. Cambian la constante y el coeficiente de female, que pasa a ser \(\beta_2+\beta_5\cdot12{,}56\): la diferencia entre una mujer y un hombre con la educación media. Estimado así, vale \(-0{,}301\) con error estándar \(0{,}037\). Con la educación media, y la misma experiencia y antigüedad, una mujer cobra un \(26\) % menos que un hombre, porque \(e^{-0{,}301}-1=-0{,}260\). Con \(t=-8{,}09\), datos como estos serían muy raros si no hubiese diferencia. El error estándar es casi cinco veces menor que el de \(-0{,}21\), porque ahora la diferencia se mide donde están los datos.
Para profundizar: Wooldridge, J. M. (2020), cap. 7, sección 7.4 (``Interactions involving dummy variables''), apartados ``Interactions among dummy variables'' y ``Allowing for different slopes'', con el ejemplo 7.10 (female*educ) y la observación sobre centrar el regresor.
8. El contraste de Chow: ¿la misma ecuación?
Para que cada sexo tenga su propio intercepto y sus propias pendientes, se añaden al modelo común (lwage sobre educ, exper y tenure) female y su producto por cada regresor: female*educ, female*exper y female*tenure. El ajuste es el de dos regresiones separadas, una por sexo. \(H_0\): los coeficientes de female y de las tres interacciones valen cero (\(q=4\)). Es el \(F\) de la lección 13:
\[F=\frac{(\mathrm{SRC}_r-\mathrm{SRC})/q}{\mathrm{SRC}/(n-k)},\qquad \mathrm{SRC}=\mathrm{SRC}_{\text{hombres}}+\mathrm{SRC}_{\text{mujeres}}.\]
Modelo común, \(\mathrm{SRC}_r=101{,}46\); hombres (\(n=274\)), \(49{,}55\); mujeres (\(n=252\)), \(39{,}04\). Así, \(F=\dfrac{(101{,}46-88{,}58)/4}{88{,}58/518}=18{,}8\), frente a \(F_c=2{,}39\) al 5 %.
Lectura: datos como estos serían muy raros si hombres y mujeres compartiesen la ecuación. El contraste dice que algo difiere, no qué: con las ocho columnas ningún \(t\) supera \(2\), porque female y female*educ tienen correlación \(0{,}96\) (lección 14).
El uso original: con datos ordenados en el tiempo, si la relación cambia a partir de una fecha (cambio estructural); los grupos son el antes y el después.
El contraste de Chow: ¿la misma ecuación?
Las transparencias ``En log-nivel: una diferencia porcentual'' e ``Interacciones: la pendiente cambia de grupo'' han dejado que difieran entre sexos primero el intercepto y después una pendiente. El caso general es dejar que difieran todos los coeficientes: el intercepto y las pendientes de educ, exper y tenure. El modelo que lo permite tiene la constante, los tres regresores, la indicadora female y las tres interacciones female*educ, female*exper y female*tenure, ocho columnas. Escrito por grupos, es una ecuación con cuatro coeficientes para los hombres y otra, con otros cuatro, para las mujeres, sin nada en común: las ocho columnas generan el mismo subespacio que las cuatro columnas del modelo común multiplicadas componente a componente por \(\boldsymbol d_{\text{hombre}}\) junto con las mismas cuatro multiplicadas por \(\boldsymbol d_{\text{mujer}}\), y cada vector del primer grupo es ortogonal a cada uno del segundo, porque en cada fila de la muestra uno de los dos vale cero. La proyección sobre el subespacio se hace, por tanto, grupo a grupo, y el ajuste coincide con el de dos regresiones separadas, una con los \(274\) hombres y otra con las \(252\) mujeres: la suma de cuadrados de los residuos del modelo con las interacciones, \(88{,}58\), es la suma de las de las dos regresiones separadas, \(49{,}55\) y \(39{,}04\).
La pregunta de si hombres y mujeres comparten la ecuación es la hipótesis nula de que los coeficientes de la indicadora y de las tres interacciones valen cero, cuatro restricciones lineales. Es el contraste \(F\) de la lección 13 sin ningún cambio: el modelo restringido es el modelo común, lwage sobre la constante, educ, exper y tenure, con \(\mathrm{SRC}_r=101{,}46\); el modelo completo es el de las ocho columnas, con \(\mathrm{SRC}=88{,}58\) y \(n-k=526-8=518\) grados de libertad. El estadístico es \(F=\frac{(101{,}46-88{,}58)/4}{88{,}58/518}=18{,}8\), frente a un valor crítico al 5 % de \(2{,}39\); el valor \(p\) es del orden de \(10^{-14}\). Como \(F\) supera con mucho el valor crítico, datos como estos serían muy raros si hombres y mujeres compartiesen la ecuación, y el contraste rechaza que la compartan. Este uso del \(F\), con un modelo restringido común y uno sin restringir que equivale a dos regresiones separadas, se llama contraste de Chow, por Chow (1960).
El contraste dice que la ecuación no es la misma, pero no dice en qué difiere. El modelo con las ocho columnas, estimado, es
\[\begin{aligned}\widehat{\log(\text{wage})}&=\underset{(0{,}135)}{0{,}322}+\underset{(0{,}199)}{0{,}034}\,\text{female}+\underset{(0{,}0090)}{0{,}0963}\,\text{educ}+\underset{(0{,}0024)}{0{,}0081}\,\text{exper}+\underset{(0{,}0036)}{0{,}0182}\,\text{tenure}\\&\quad-\underset{(0{,}0142)}{0{,}0162}\,\text{female}\cdot\text{educ}-\underset{(0{,}0033)}{0{,}0059}\,\text{female}\cdot\text{exper}-\underset{(0{,}0065)}{0{,}0079}\,\text{female}\cdot\text{tenure},\end{aligned}\]
y sus \(t\) tampoco lo dicen: ninguno supera \(2\) en valor absoluto (female, \(0{,}17\); las interacciones con educ, exper y tenure, \(-1{,}15\), \(-1{,}80\) y \(-1{,}21\)), y sin embargo el \(F\) conjunto es \(18{,}8\). Es el caso de la lección 13, un \(F\) conjunto alto con \(t\) individuales pequeños, y la causa es la de la lección 14: la indicadora y sus tres interacciones están muy correlacionadas. La columna female*educ vale educ para las mujeres y cero para los hombres, y como educ varía poco respecto de su media (\(12{,}6\) años, con desviación típica \(2{,}8\)), esa columna es casi proporcional a female, con correlación \(0{,}96\); el VIF de female en ese modelo es \(30\). Cada una de las cuatro columnas tiene poca variación propia y su \(t\) es pequeño, aunque entre las cuatro aporten mucho al ajuste. Para averiguar qué difiere hay que preguntar una cosa cada vez, como hizo la transparencia ``Interacciones: la pendiente cambia de grupo'' con la pendiente de exper, cuya interacción, sola, tiene \(t=-2{,}44\). Una variante útil pregunta solo por las pendientes. Permite que cada sexo tenga su propio intercepto, porque mantiene female en el modelo, y contrasta si las pendientes de educ, exper y tenure son las mismas para hombres y mujeres, es decir, si los coeficientes de las tres interacciones valen cero. Para ello se estima el modelo con las ocho columnas y se imponen esas tres restricciones con restrict, como en la actividad 2 (html) de la práctica A de la sesión 20. El modelo restringido es entonces el de la transparencia ``En log-nivel: una diferencia porcentual'': interceptos distintos para cada sexo y pendientes comunes, con rectas paralelas como las de su figura. Con estos datos, \(F(3,518)=3{,}04\) y valor \(p\) \(0{,}028\): el contraste rechaza al 5 %, y datos como estos serían raros si las tres pendientes fuesen comunes. Y el caso más simple, \(q=1\), es el de la transparencia ``En log-nivel: una diferencia porcentual'': si solo puede diferir el intercepto, el \(F\) con una restricción es el cuadrado del \(t\) de female, \(8{,}09^2=65{,}4\), como se vio en la lección 13.
El uso original del contraste de Chow es con datos ordenados en el tiempo: la pregunta es si la relación cambia a partir de una fecha, un cambio estructural, y los dos grupos son las observaciones anteriores y posteriores a esa fecha. La mecánica es la misma, con la indicadora del periodo posterior en lugar de la del sexo.
Para profundizar: Wooldridge, J. M. (2020), cap. 7, sección 7.4, apartado ``Testing for differences in regression functions across groups'' (el contraste de Chow como \(F\) de las interacciones); Chow, G. C. (1960), ``Tests of equality between sets of coefficients in two linear regressions'', Econometrica 28, 591–605; lección 13 de este curso, ``El contraste \(F\)''.
9. Qué dice y qué no dice el coeficiente de una indicadora
| Modelo | El coeficiente mide… | Lectura, con los demás regresores fijos |
|---|---|---|
| \(y\) en niveles | la diferencia entre el grupo señalado y la categoría base | el grupo señalado tiene \(\beta\) unidades de \(y\) más que la categoría base |
| \(\log y\) | esa diferencia en logaritmos | tiene un \(100(e^{\beta}-1)\) % más, aproximadamente \(100\beta\) % si \(\beta\) es pequeño |
| varias categorías | la diferencia de cada grupo con la categoría base | la diferencia entre dos grupos que no son la categoría base es la resta de sus coeficientes |
| interacción \(\mathbb 1\cdot x\) | la diferencia entre las pendientes de \(x\) | la pendiente de \(x\) es \(\beta_x\) en la categoría base y \(\beta_x+\beta\) en el grupo señalado |
Lo que no dice. Una indicadora no tiene unidades: su coeficiente no es el efecto de ``una unidad más'', sino la diferencia entre dos grupos. Qué grupo vale \(1\) lo decide quien codifica los datos; cambiarlo cambia el signo y la categoría base, no el ajuste. Una indicadora no se transforma logarítmicamente: su logaritmo no existe en \(0\).
``Con los demás regresores fijos'' quiere decir con los del modelo, y nada más. El \(26\) % entre sexos compara trabajadores con la misma educación, experiencia y antigüedad; no mide la discriminación, porque faltan variables como la ocupación o la jornada.
Qué dice y qué no dice el coeficiente de una indicadora
La tabla de la transparencia reúne las cuatro lecturas de la lección. Las tres primeras son la misma idea en tres formas: el coeficiente de una indicadora es la diferencia entre el grupo señalado y la categoría base, con los demás regresores fijos. En un modelo en niveles, la diferencia está en las unidades del regresando: \(1{,}81\) dólares por hora, \(4{,}08\) mil dólares. En un modelo con el regresando en logaritmos, la diferencia es relativa: la fracción \(e^{\beta}-1\), que para coeficientes pequeños se aproxima por \(\beta\), y que se calcula respecto de la categoría base, de modo que el porcentaje cambia al cambiar la categoría base. Con varias categorías, cada coeficiente compara su grupo con la categoría base, y la diferencia entre dos grupos que no son la categoría base es la resta de sus coeficientes; su error estándar se obtiene cambiando la categoría base. La cuarta lectura es distinta: el coeficiente de una interacción es la diferencia entre la pendiente del regresor en el grupo señalado y su pendiente en la categoría base, de modo que la pendiente en el grupo señalado es la de la categoría base más el coeficiente de la interacción.
Las lecturas incorrectas más frecuentes son tres. La primera es tratar la indicadora como una variable con unidades y hablar de ``una unidad más de female''. Una indicadora solo toma dos valores, y su coeficiente compara los dos grupos; no hay nada entre \(0\) y \(1\). La segunda es olvidar que la codificación es una decisión. Que las mujeres valgan \(1\) y los hombres \(0\), y no al revés, lo decidió quien preparó el fichero; con la codificación contraria el coeficiente sería \(+0{,}301\), el ajuste sería el mismo y la lectura, la misma diferencia vista desde la otra categoría base. Lo que se compara son grupos, no valores de una variable. Relacionado con esto, una indicadora nunca se transforma: no tiene sentido su logaritmo, que no existe en cero, ni su cuadrado, que es ella misma. La tercera lectura incorrecta es la que la transparencia ``Con más regresores: la diferencia con lo demás fijo'' ya señaló. ``Con lo demás fijo'' quiere decir con los regresores del modelo fijos, y nada más. La diferencia del \(26\) % entre sexos de la transparencia ``En log-nivel: una diferencia porcentual'' es una diferencia entre hombres y mujeres con la misma educación, experiencia y antigüedad observadas. No es una medida de la discriminación salarial, porque el modelo no contiene la ocupación, el sector, la jornada ni otras variables en las que los dos grupos difieren, y no dice qué parte de la diferencia se debe a cada una. Lo que un modelo con indicadoras puede decir es cuánto cambia la diferencia entre grupos al fijar las variables que incluye: de \(-2{,}51\) a \(-1{,}81\) dólares al fijar tres variables. Atribuir lo que queda a una causa concreta exige un argumento que la regresión no proporciona.
Para profundizar: Wooldridge, J. M. (2020), cap. 7, sección 7.2, la discusión del ejemplo 7.1 sobre lo que el coeficiente de female mide y lo que no; cap. 3, sección 3.3 (``omitted variable bias'') para el papel de las variables que faltan.
10. Recapitulación y guiño a la lección siguiente
| Pieza | Fórmula | Lectura |
|---|---|---|
| Indicadora como regresor | \(\mathbb 1_A\) en la población, \(\boldsymbol d\) en la muestra | su coeficiente es un salto entre grupos |
| Dos grupos complementarios | \(\boldsymbol d_A+\boldsymbol d_{A^c}=\boldsymbol 1\); \(\langle\boldsymbol d_A,\boldsymbol d_{A^c}\rangle_s=0\) | sin otros regresores, coeficientes = medias; con \(\boldsymbol 1\), trampa |
| Log-nivel | \(e^{\beta}-1\) | diferencia exacta respecto de la categoría base, en tanto por uno |
| Interacción | pendiente del grupo señalado: \(\beta_4+\beta_5\) en el ejemplo de exper |
pendiente de la categoría base más diferencia de pendientes |
| Contraste de Chow | \(F\) de la lección 13 con \(\mathrm{SRC}=\mathrm{SRC}_{\text{grupo 1}}+\mathrm{SRC}_{\text{grupo 2}}\) | ¿la misma ecuación en los dos grupos? |
Geometría nueva: solo la ortogonalidad de dos indicadoras complementarias. Nada enunciado sin demostrar. Lección 17: residuos de wage sobre female, educ, exper y tenure: desviación típica \(3{,}42\) en los hombres y \(2{,}32\) en las mujeres; con lwage, \(0{,}43\) y \(0{,}40\). Varianza de la perturbación distinta por grupo: heterocedasticidad.
Recapitulación y guiño a la lección siguiente
La lección ha añadido un tipo de regresor y una tabla de lecturas, la de la transparencia ``Qué dice y qué no dice el coeficiente de una indicadora''. El regresor es la indicadora de un grupo: la variable aleatoria \(\mathbb 1_A\) en la población, que la lección 12 definió para escribir una probabilidad como esperanza, y el vector \(\boldsymbol d\) de ceros y unos en la muestra. En la estimación por mínimos cuadrados la indicadora es una columna más de \(\boldsymbol{\mathsf X}\), y la proyección, los residuos y los contrastes se calculan como en las lecciones 8 a 14. Lo nuevo es la lectura de su coeficiente: la diferencia entre el grupo señalado y la categoría base, con los demás regresores fijos, en unidades del regresando si el regresando está en niveles y en la fracción \(e^{\beta}-1\) si está en logaritmos. El producto de una indicadora por otro regresor, la interacción, añade a la diferencia de interceptos una diferencia de pendientes: su coeficiente es la pendiente del grupo señalado menos la de la categoría base. Y la pregunta de si dos grupos comparten el intercepto y todas las pendientes se contrasta con el \(F\) de la lección 13, el contraste de Chow, cuyo modelo sin restringir equivale a dos regresiones separadas, una por grupo.
La única geometría nueva ha sido pequeña: dos indicadoras de grupos complementarios son ortogonales y suman \(\boldsymbol 1\). De la ortogonalidad se sigue que, sin otros regresores, el coeficiente de cada indicadora es la media de su grupo. De la suma se siguen dos cosas: que las dos indicadoras no pueden entrar en el modelo junto con la constante, porque las tres columnas son linealmente dependientes, y ese error es la trampa de las variables ficticias; y que la constante no necesita ser una columna de \(\boldsymbol{\mathsf X}\) para que los residuos sumen cero y el \(R^2\) se calcule como en la lección 8, porque basta con que \(\boldsymbol 1\) pertenezca al subespacio generado por las columnas, como la lección 10 había anticipado. Nada se ha enunciado sin demostrar: las lecturas son álgebra sobre el modelo escrito por grupos, y el contraste de Chow es el \(F\) de la lección 13 con el modelo común como modelo restringido y el de las interacciones como modelo sin restringir.
Lo que hay que retener para leer resultados son las tres cautelas de la transparencia ``Qué dice y qué no dice el coeficiente de una indicadora''. Primera: el coeficiente de una indicadora es una diferencia entre dos grupos, no un efecto por unidad de una variable. Segunda: qué grupo es la categoría base lo decide quien codifica los datos; cambiarlo cambia el signo del coeficiente y el grupo respecto del cual se lee la diferencia, pero no el ajuste. Tercera: ``con lo demás fijo'' quiere decir con los regresores del modelo fijos, y solo con ellos; las variables que el modelo no contiene no están fijas en la comparación. La diferencia salarial del \(26\) % entre sexos con la misma educación, experiencia y antigüedad es lo que el modelo estima con esta muestra, pero el modelo no dice cuál es la causa de esa diferencia.
La lección 17 parte de una observación que los datos de hoy ya permiten hacer. En el modelo en niveles de la transparencia ``Con más regresores: la diferencia con lo demás fijo'', wage sobre female, educ, exper y tenure, los residuos de los hombres tienen una desviación típica de \(3{,}42\) dólares y los de las mujeres de \(2{,}32\). Los residuos son la estimación de las perturbaciones, y el supuesto de homocedasticidad de las lecciones 9 y 11 dice que las \(n\) perturbaciones \(U_1,\ldots,U_n\) tienen la misma varianza condicional, \(Var[U_i\mid\boldsymbol X]=\sigma^2\,\mathit 1\) para todo \(i\). Bajo ese supuesto no cabe esperar que los residuos de un grupo sean sistemáticamente más dispersos que los del otro, y aquí lo son. Que la varianza de la perturbación sea distinta para distintas unidades, por ejemplo mayor en un grupo que en otro, es la heterocedasticidad. En el modelo con el logaritmo del salario las dos desviaciones típicas se acercan, \(0{,}43\) y \(0{,}40\): tomar logaritmos del regresando suele reducir la heterocedasticidad, y por eso la lección 15 dijo que es lo primero que se prueba antes de otros remedios. La lección 17 tratará cómo detectar la heterocedasticidad, qué consecuencias tiene para los errores estándar y cómo corregirlos. Y el laboratorio integrador volverá al Boston original con chas para estimar, con datos reales, un solo modelo con logaritmos, indicadoras e interacciones, y diagnosticarlo.
Para profundizar: Wooldridge, J. M. (2020), cap. 7, secciones 7.1 a 7.4 (resumen de la lección) y cap. 8, sección 8.1 (anticipo de la heterocedasticidad).
11. Preguntas de repaso (sesión 24) htmlonly
Le propongo 12 preguntas. Las marco con un nivel orientativo: [B] básica, [M] media, [D] discriminadora.
Comentario
Las preguntas que más le conviene trabajar son la 4 (la lectura exacta en log-nivel y la asimetría según la categoría base, que es lo que hay que hacer al informar un resultado), la 6 (por qué dos indicadoras complementarias no pueden entrar con la constante, y qué cambia al omitir una u otra) y la 9 (qué es el coeficiente de la indicadora cuando hay una interacción). Repase también la 2, que fija la relación entre el coeficiente y las medias de grupo, y la 11, que distingue lo que el contraste de Chow dice de lo que no dice.
Pregunta 1 [B] — La indicadora
En una muestra de \(200\) trabajadores hay \(80\) mujeres. ¿Cuánto vale la media del vector \(\boldsymbol d_{\text{mujer}}\) y qué estima?
- \(80\); el número de mujeres de la población.
- \(0{,}4\); la probabilidad de que la persona observada sea mujer, \(\mathrm P(\text{mujer})=\mathrm E(\mathbb 1_{\text{mujer}})\).
- \(0{,}5\); la probabilidad de que una persona sea mujer, que siempre es un medio.
- No tiene media, porque una indicadora no es una variable numérica.
Pregunta 2 [B] — Una sola indicadora
Se estima medv sobre la constante y chas y se obtiene \(\widehat{\text{medv}}=22{,}09+6{,}35\,\text{chas}\). ¿Cuál es la media de medv entre los barrios junto al río?
- \(6{,}35\).
- \(22{,}09\).
- \(28{,}44\).
- No se puede saber sin conocer cuántos barrios hay en cada grupo.
Pregunta 3 [M] — Con más regresores
La diferencia bruta de salario medio entre hombres y mujeres es de \(2{,}51\) dólares; al añadir educ, exper y tenure, el coeficiente de female es \(-1{,}81\). ¿Qué explica la diferencia entre las dos cifras?
- Un error de estimación: las dos deberían coincidir.
- Que los dos grupos difieren en las variables añadidas, y parte de la diferencia bruta se atribuye a ellas.
- Que el modelo con más regresores tiene menos grados de libertad.
- Que el coeficiente de una indicadora siempre se reduce al añadir regresores.
Pregunta 4 [M] — Log-nivel y la categoría base
En un modelo con \(\log(\text{wage})\) como regresando y los regresores educ, exper y tenure, el coeficiente de female es \(-0{,}30\). ¿Cuál de las siguientes lecturas es la exacta para un hombre y una mujer con los mismos valores de esos tres regresores?
- Las mujeres cobran un \(30\) % menos que los hombres, y los hombres un \(30\) % más que las mujeres.
- Las mujeres cobran un \(26\) % menos que los hombres, y los hombres un \(35\) % más que las mujeres.
- Las mujeres cobran \(0{,}30\) dólares menos por hora.
- Las mujeres cobran un \(26\) % menos y los hombres un \(26\) % más.
Pregunta 5 [B] — Intervalo transformado
El intervalo al 95 % para el coeficiente de una indicadora en un modelo log-nivel es \([-0{,}374,\,-0{,}228]\). ¿Cuál es el intervalo para la diferencia porcentual exacta?
- \([-37{,}4\ \%,\,-22{,}8\ \%]\).
- \([e^{-0{,}374}-1,\,e^{-0{,}228}-1]=[-31{,}2\ \%,\,-20{,}4\ \%]\).
- \([-26{,}0\ \%\pm3{,}7\ \%]\).
- No se puede transformar un intervalo; hay que recalcular el error estándar.
Pregunta 6 [D] — La trampa
Se incluyen en \(\boldsymbol{\mathsf X}\) la constante, \(\boldsymbol d_{\text{mujer}}\) y \(\boldsymbol d_{\text{hombre}}\). ¿Qué ocurre?
- Las tres columnas generan un subespacio de dimensión dos y las ecuaciones normales no tienen solución única; hay que omitir una de las tres.
- El ajuste es imposible porque la proyección de \(\boldsymbol y\) no existe.
- No ocurre nada: las tres columnas son distintas y el modelo se estima sin problema.
- El modelo se estima, pero el \(R^2\) sale mayor que \(1\).
Pregunta 7 [M] — Cambiar la categoría base
Con la constante y female, el ajuste es \(\widehat{\log(\text{wage})}=1{,}814-0{,}397\,\text{female}\). Si se estima con la constante y male en su lugar, ¿qué se obtiene?
- \(1{,}814+0{,}397\,\text{male}\).
- \(1{,}416+0{,}397\,\text{male}\).
- \(1{,}416-0{,}397\,\text{male}\).
- Otro ajuste, con distinta suma de cuadrados de los residuos.
Pregunta 8 [M] — Varias categorías
Una variable de región tiene cinco categorías excluyentes. En un modelo con constante, ¿cuántas indicadoras de región se incluyen y qué mide cada coeficiente?
- Cinco; cada coeficiente es el nivel medio de su región.
- Cuatro; cada coeficiente es la diferencia entre su región y la región omitida, con lo demás fijo.
- Cuatro; cada coeficiente es la diferencia entre su región y la media de todas.
- Una, con valores \(1\) a \(5\); su coeficiente es el efecto de pasar a la región siguiente.
Pregunta 9 [D] — La interacción
En \(\log(\text{wage})=\beta_1\,\mathit 1+\beta_2\,\mathbb 1_{\text{mujer}}+\beta_4\,\text{exper}+\beta_5\,\mathbb 1_{\text{mujer}}\cdot\text{exper}+U\), ¿qué miden \(\beta_2\) y \(\beta_5\)?
- \(\beta_2\) es la diferencia entre sexos para cualquier experiencia; \(\beta_5\) es el efecto de la experiencia para las mujeres.
- \(\beta_2\) es la diferencia entre sexos con cero años de experiencia; \(\beta_5\) es la diferencia entre la pendiente de las mujeres y la de los hombres.
- \(\beta_2\) es la pendiente de los hombres; \(\beta_5\) la de las mujeres.
- \(\beta_2\) y \(\beta_5\) miden lo mismo, porque las dos columnas son colineales.
Pregunta 10 [M] — Dos rectas
Se estima \(\log(\text{wage})\) sobre la constante, female, exper y female*exper, y el \(t\) de la interacción es \(-0{,}4\). ¿Qué modelo sugieren los datos?
- Dos rectas distintas, una por sexo.
- Dos rectas paralelas: la indicadora sin la interacción.
- Una sola recta para todos.
- Ninguno: el contraste no permite decidir nada sin conocer el \(t\) de
female.
Pregunta 11 [D] — El contraste de Chow
Un contraste de Chow entre dos grupos, con tres regresores, da \(F(4,518)=18{,}8\). ¿Qué se concluye?
- Que los cuatro coeficientes de la indicadora y de las interacciones son distintos de cero.
- Que datos como estos serían muy raros si los dos grupos compartiesen la ecuación; el contraste no dice qué coeficientes difieren.
- Que difieren los interceptos y no las pendientes.
- Que el modelo común tiene mejor ajuste que las dos regresiones separadas.
Pregunta 12 [M] — Lo que no dice
El coeficiente de female en el modelo log-nivel con educ, exper y tenure es \(-0{,}30\). ¿Cuál de estas afirmaciones es correcta?
- Las mujeres sufren una discriminación salarial del \(26\) %.
- Entre trabajadores con la misma educación, experiencia y antigüedad observadas, el salario de las mujeres es un \(26\) % menor en promedio; el modelo no dice a qué se debe.
- Una unidad más de
femalereduce el salario un \(30\) %. - El resultado cambiaría si se codificase a los hombres con \(1\), porque la diferencia sería distinta.
12. Respuestas htmlonly
- Pregunta 1 [B] — La indicadora
Respuesta correcta: 2. Evalúa: la definición de la lección 12 aplicada a un grupo: la media de la indicadora es la proporción del grupo en la muestra, la estimación de \(\mathrm E(\mathbb 1_A)=\mathrm P(A)\).
- Pregunta 2 [B] — Una sola indicadora
Respuesta correcta: 3. Evalúa: que con una sola indicadora los dos valores ajustados son las medias de grupo: la constante es la media del grupo con
chasigual a \(0\) y la suma \(22{,}09+6{,}35\) la del grupo conchasigual a \(1\). - Pregunta 3 [M] — Con más regresores
Respuesta correcta: 2. Evalúa: la lectura ceteris paribus de la lección 10. Las mujeres de la muestra tienen menos antigüedad; al fijarla, parte de la diferencia bruta se atribuye a ella. La opción 4 es falsa: el coeficiente puede aumentar si los grupos difieren en sentido contrario.
- Pregunta 4 [M] — Log-nivel y la categoría base
Respuesta correcta: 2. Evalúa: el cálculo exacto \(e^{\beta}-1\) y la asimetría según la categoría base: \(e^{-0{,}30}-1=-0{,}26\) y \(e^{0{,}30}-1=0{,}35\). La opción 1 es la aproximación, que para un coeficiente de \(0{,}30\) se aleja del valor exacto.
- Pregunta 5 [B] — Intervalo transformado
Respuesta correcta: 2. Evalúa: que la transformación se aplica a los extremos del intervalo, no al error estándar, y que el intervalo transformado no es simétrico alrededor de \(-0{,}26\).
- Pregunta 6 [D] — La trampa
Respuesta correcta: 1. Evalúa: la trampa de las variables ficticias como colinealidad exacta de la lección 10. La proyección existe y es única (la opción 2 es falsa); lo que no es único es el vector de coeficientes. Gretl omite una columna y avisa.
- Pregunta 7 [M] — Cambiar la categoría base
Respuesta correcta: 2. Evalúa: que cambiar la categoría base reescribe el mismo ajuste: la constante pasa a ser la media de las mujeres, \(1{,}814-0{,}397=1{,}416\), y el coeficiente de
malees la diferencia con el signo cambiado. La suma de cuadrados de los residuos no cambia. - Pregunta 8 [M] — Varias categorías
Respuesta correcta: 2. Evalúa: la regla de una indicadora menos que grupos cuando hay constante, y la lectura respecto de la categoría omitida. La opción 4 trata una variable cualitativa como si fuera cuantitativa, lo que impone que pasar de la región 1 a la 2 tenga el mismo efecto que pasar de la 4 a la 5.
- Pregunta 9 [D] — La interacción
Respuesta correcta: 2. Evalúa: escribir el modelo por grupos. Con una interacción, el coeficiente de la indicadora es la diferencia de interceptos, es decir, la diferencia entre grupos en \(\text{exper}=0\), y el de la interacción es la diferencia de pendientes; la pendiente de las mujeres es \(\beta_4+\beta_5\), no \(\beta_5\).
- Pregunta 10 [M] — Dos rectas
Respuesta correcta: 2. Evalúa: que un \(t\) pequeño en la interacción dice que datos como estos no serían raros con pendientes iguales, así que se conserva la indicadora y se omite la interacción. La opción 3 necesitaría además que el \(t\) de
femalefuese pequeño, y la 4 confunde los dos contrastes. - Pregunta 11 [D] — El contraste de Chow
Respuesta correcta: 2. Evalúa: qué contrasta el \(F\) conjunto y qué no. Rechazar la hipótesis conjunta no dice que las cuatro restricciones fallen (opción 1) ni cuáles fallan (opción 3); la opción 4 es imposible, porque el modelo común es el restringido y su \(\mathrm{SRC}\) nunca es menor. Los \(t\) del modelo con las interacciones tampoco lo dicen: con la indicadora y sus interacciones muy correlacionadas, ninguno supera \(2\) aunque \(F=18{,}8\).
- Pregunta 12 [M] — Lo que no dice
Respuesta correcta: 2. Evalúa: las tres cautelas de la transparencia ``Qué dice y qué no dice el coeficiente de una indicadora'': no hay unidades de una indicadora (opción 3), la codificación no cambia el ajuste ni la diferencia (opción 4) y ``lo demás fijo'' se limita a los regresores del modelo (opción 1).