Sesión 22 (A) — Dos regresores cada vez más alineados: un experimento de Monte Carlo
Índice
Descripción de la práctica
La lección 14 dijo que el error estándar de \(\hat\beta_j\) es \(\mathfrak s\) dividido por la longitud de la parte propia del regresor, y que esa longitud se encoge con el ángulo entre el regresor y los demás: \(\Vert\tilde{\boldsymbol x}_j\Vert_e=\Vert\boldsymbol x_j-\mu_{\boldsymbol x_j}\boldsymbol 1\Vert_e\sin\theta_j\). Con dos regresores no constantes, \(\sin^2\theta=1-\rho^2\) y la varianza del estimador se multiplica por \(\mathrm{VIF}=1/(1-\rho^2)\). Esta práctica lo comprueba repitiendo: construimos dos regresores con una correlación elegida, sorteamos la perturbación dos mil veces y miramos cuánto oscilan las estimaciones.
El mundo artificial tiene \(n=100\), \(y=1+x_2+x_3+u\) con \(u\) normal de desviación típica \(1\), y cuatro versiones del par de regresores: \(\rho=0\); \(0{,}9\); \(0{,}99\) y \(0{,}999\). Los regresores están fijos dentro de cada experimento; lo único que cambia de una réplica a otra es \(u\). Un detalle de construcción: \(\boldsymbol x_3=\rho\boldsymbol z_1+\sqrt{1-\rho^2}\,\boldsymbol z_2\) con \(\boldsymbol x_2=\boldsymbol z_1\), así que el subespacio generado por \(\boldsymbol 1\), \(\boldsymbol x_2\) y \(\boldsymbol x_3\) es el mismo para los cuatro valores de \(\rho\). Lo que cambia es el ángulo entre los generadores, no el plano que generan.
Objetivos
- Comprobar que la varianza empírica de \(\hat\beta_2\) crece como el VIF, y que coincide con \(\sigma^2/\Vert\tilde{\boldsymbol x}_2\Vert_e^2\).
- Ver que la \(\mathrm{SRC}\) no cambia con \(\rho\): el ajuste es el mismo punto, y solo cambian sus coordenadas.
- Ver que \(\hat\beta_2\) y \(\hat\beta_3\) oscilan juntos y al revés: covarianza negativa, y suma \(\hat\beta_2+\hat\beta_3\) tan estable como lo era \(\hat\beta_2\) sin colinealidad.
- Ver cómo un efecto verdadero deja de ser significativo cuando el regresor pierde parte propia.
Comandos nuevos de esta práctica. Seguimos con nulldata, set seed, normal(), series y scalar (sesión 7), ols con --quiet y los accesores $ess, $coeff y $stderr (sesiones 11 a 18), las matrices y mcov (práctica A de la sesión 16, apéndice (html)) y critical (sesión 18). Lo nuevo:
zeros(R, 2)- crea una matriz de
Rfilas y 2 columnas llena de ceros, para ir guardando en ella un resultado por réplica. B[i,] = {a, b}- escribe la fila
ide la matrizB; entre llaves, los dos valores que la rellenan. Al revés,B0[,1]es la primera columna entera deB0. loop i=1..R- repite el bloque hasta
endloopcon el índiceitomando los valores \(1, 2, \ldots, R\) (en la sesión 11 lo usamos con cuatro vueltas). Aquí hay dos bucles, uno dentro de otro: el exterior recorre las cuatro correlaciones y el interior las réplicas. elif- «si no, si…»: dentro de un
if, añade una segunda condición que solo se comprueba cuando la primera no se cumple. rhos[j]ymeanc(S[,1])- el elemento \(j\) de un vector, y la media de la primera columna de una matriz.
mcov(B)- matriz de varianzas y covarianzas de las columnas de
B, tratando cada columna como una variable y cada fila como una observación (divisor \(n-1\)).V[1,1]es la varianza de la primera columna yV[1,2]la covarianza entre las dos. series b = B0[,1]- convierte una columna de una matriz en una serie del conjunto de datos, para poder dibujarla con
freqygnuplot. El conjunto tiene que tener tantas observaciones como filas la matriz: de ahí elnulldata R --preserveprevio, con--preservepara no perder las matrices.
Actividad 1 - Cuatro experimentos, una tabla
Para cada \(\rho\): genere los regresores, mida la parte propia de \(\boldsymbol x_2\) con la regresión auxiliar, y repita \(2\,000\) veces la estimación guardando \(\hat\beta_2\), \(\hat\beta_3\), la \(\mathrm{SRC}\) y el \(R^2\). Después resuma: varianza empírica de \(\hat\beta_2\) frente a la teórica, covarianza, varianza de la suma, y fracción de réplicas en que el \(t\) de \(\boldsymbol x_2\) supera \(t_c\).
Léalo en tres partes. Preparación: un conjunto de 100 observaciones, los coeficientes verdaderos b1, b2 y b3 (los tres valen \(1\)), la desviación típica del ruido sig, el número de réplicas R, el valor crítico tc de la \(t\) con \(n-3\) grados de libertad (sesión 18) y el vector rhos con las cuatro correlaciones que se van a probar. El bloque siguiente empieza con dos printf: el primero imprime los parámetros del experimento y el segundo la cabecera de la tabla. Los regresores: el bucle exterior, loop j=1..4, toma en cada vuelta un \(\rho\) de rhos (rhos[j] es su elemento \(j\)) y, con la semilla fija, sortea z1 y z2, dos normales estándar independientes; x2 es z1 y x3 es la combinación \(\rho\boldsymbol z_1+\sqrt{1-\rho^2}\,\boldsymbol z_2\), que tiene correlación \(\rho\) con x2. La regresión auxiliar ols x2 const x3 --quiet deja en $ess la longitud al cuadrado de la parte propia de x2, y varTeorica es \(\sigma^2\) dividido por ella. Las réplicas: se fija otra semilla para el ruido y el bucle interior, en cada vuelta, sortea u, construye y con los coeficientes verdaderos, estima por MCO, guarda los dos coeficientes en la fila i de B y la \(\mathrm{SRC}\) y el \(R^2\) en la fila i de S, y suma un \(1\) a signif cuando el \(|t|\) de x2 supera tc (signif + …=). Al salir del bucle interior, mcov(B) da la varianza empírica de \(\hat\beta_2\) y su covarianza con \(\hat\beta_3\), meanc promedia cada columna de S, y el printf imprime la fila de la tabla. Los regresores no cambian dentro del bucle interior: solo cambia u. Las últimas líneas guardan en B0 y B99 las réplicas con \(\rho=0\) y con \(\rho=0{,}99\) para la Actividad 2 (if y endif: sesión 7; elif: véase la lista de comandos nuevos).
en línea de comandos:
nulldata 100
scalar n   = $nobs
scalar b1  = 1
scalar b2  = 1
scalar b3  = 1
scalar sig = 1
scalar R   = 2000
scalar tc  = critical(t, n-3, 0.025)
matrix rhos = {0, 0.9, 0.99, 0.999}
printf "n = %d, beta = (1, 1, 1), sigma = 1, %d replicas por cada rho\n\n", n, R
printf "%7s %8s %8s %10s %10s %10s %10s %8s %8s %8s\n", "rho", "corr", "VIF", "var(b2)", "teorica", "cov(b2,b3)", "var(b2+b3)", "SRC", "R2", "%|t|>tc"
loop j=1..4 --quiet
    scalar rho = rhos[j]
    set seed 2026
    series z1 = normal()
    series z2 = normal()
    series x2 = z1
    series x3 = rho*z1 + sqrt(1-rho^2)*z2
    ols x2 const x3 --quiet
    scalar longPropia2 = sqrt($ess)                 # || parte propia de x2 ||
    scalar varTeorica  = sig^2/longPropia2^2         # sigma^2 / ||x2 propia||^2
    matrix B = zeros(R, 2)
    matrix S = zeros(R, 2)
    scalar signif = 0
    set seed 20261120
    loop i=1..R --quiet
        series u = normal(0, sig)
        series y = b1 + b2*x2 + b3*x3 + u
        ols y const x2 x3 --quiet
        B[i,] = {$coeff(x2), $coeff(x3)}
        S[i,] = {$ess, $rsq}
        signif += abs($coeff(x2)/$stderr(x2)) > tc
    endloop
    matrix V = mcov(B)
    printf "%7.3f %8.4f %8.1f %10.4f %10.4f %10.4f %10.4f %8.2f %8.4f %8.3f\n", rho, corr(x2, x3), 1/(1-corr(x2,x3)^2), V[1,1], varTeorica, V[1,2], V[1,1]+V[2,2]+2*V[1,2], meanc(S[,1]), meanc(S[,2]), signif/R
    if j == 1
        matrix B0 = B
    elif j == 3
        matrix B99 = B
    endif
endloop
n = 100, beta = (1, 1, 1), sigma = 1, 2000 replicas por cada rho

    rho     corr      VIF    var(b2)    teorica cov(b2,b3) var(b2+b3)      SRC       R2  %|t|>tc
  0,000  -0,0191      1,0     0,0108     0,0104     0,0003     0,0228    96,56   0,6498    1,000
  0,900   0,9085      5,7     0,0583     0,0596    -0,0535     0,0115    96,56   0,7895    0,982
  0,990   0,9911     56,3     0,5698     0,5855    -0,5668     0,0109    96,56   0,7988    0,261
  0,999   0,9991    563,3     5,7069     5,8603    -5,7085     0,0108    96,56   0,7999    0,071
Lo que debe observar
Lea la tabla por columnas. La varianza empírica de \(\hat\beta_2\) coincide con \(\sigma^2/\Vert\tilde{\boldsymbol x}_2\Vert_e^2\) en los cuatro casos, con la oscilación propia de dos mil réplicas: el enunciado de la lección 12 y la fórmula de la 14 funcionan, y el apéndice (sección 6.5) (html) lo demuestra: \(\hat\beta_2\) es \(\beta_2\) más la coordenada del ruido en la dirección de la parte propia, dividida por la longitud de esa parte. Y crece como el VIF: de \(0{,}011\) con \(\rho=0\) a \(5{,}7\) con \(\rho=0{,}999\), un factor \(530\) que la columna del VIF anuncia.
La \(\mathrm{SRC}\) es la misma en las cuatro filas, con todos sus decimales. El subespacio es el mismo por construcción y las perturbaciones sorteadas también, así que el residuo es idéntico. El \(R^2\) sí cambia, porque cambia \(y\): con \(\beta_2=\beta_3=1\), dos regresores alineados suman sus efectos y la señal es mayor. La colinealidad no cambia el ajuste; dispersa las coordenadas.
La covarianza entre \(\hat\beta_2\) y \(\hat\beta_3\) es negativa y casi igual a la varianza en valor absoluto, salvo con \(\rho=0\), donde es prácticamente nula (\(0{,}0003\) frente a \(0{,}0108\)): cuando uno sube, el otro baja lo mismo. Por eso la varianza de la suma se queda en \(0{,}011\) para \(\rho=0{,}9\), \(0{,}99\) y \(0{,}999\): la suma se mide con la precisión que \(\hat\beta_2\) tenía sin colinealidad. Y la última columna dice lo que la colinealidad cuesta: un coeficiente que vale \(1\), con ruido de desviación típica \(1\) y cien datos, se detecta siempre con \(\rho=0\) y solo el \(7\%\) de las veces con \(\rho=0{,}999\).
Actividad 2 - Los histogramas y la nube
Compare la distribución de \(\hat\beta_2\) con \(\rho=0\) y con \(\rho=0{,}99\), y dibuje \(\hat\beta_3\) frente a \(\hat\beta_2\) en el segundo caso.
Las matrices B0 y B99 guardan las \(2\,000\) réplicas con \(\rho=0\) y con \(\rho=0{,}99\) (las guardó el bucle de la Actividad 1). Para dibujarlas hay que pasarlas a series: nulldata R --preserve abre un conjunto de R observaciones sin borrar las matrices, y cada series toma una columna; la cuarta serie, suma_rho99, es la suma de los dos coeficientes en cada réplica. Los cuatro printf resumen esas series: media, desviación típica, mínimo y máximo de \(\hat\beta_2\) con cada \(\rho\), la media y la desviación típica de la suma con \(\rho=0{,}99\), y la correlación entre \(\hat\beta_2\) y \(\hat\beta_3\). Después freq dibuja el histograma de cada serie y gnuplot la nube de \(\hat\beta_3\) frente a \(\hat\beta_2\) (la primera variable en el eje vertical, sesión 7). El guion completo añade a esas órdenes las opciones --plot y --output, que mandan cada gráfico a un fichero de la carpeta de trabajo.
en línea de comandos (con las matrices B0 y B99 de la Actividad 1):
nulldata R --preserve
series b2_rho0  = B0[,1]
series b2_rho99 = B99[,1]
series b3_rho99 = B99[,2]
series suma_rho99 = b2_rho99 + b3_rho99
printf "rho = 0     : b2 medio = %.4f   desv. tipica = %.4f   min = %.3f   max = %.3f\n", mean(b2_rho0), sd(b2_rho0), min(b2_rho0), max(b2_rho0)
printf "rho = 0,99  : b2 medio = %.4f   desv. tipica = %.4f   min = %.3f   max = %.3f\n", mean(b2_rho99), sd(b2_rho99), min(b2_rho99), max(b2_rho99)
printf "rho = 0,99  : b2 + b3 medio = %.4f   desv. tipica = %.4f\n", mean(suma_rho99), sd(suma_rho99)
printf "correlacion entre b2 y b3 con rho = 0,99: %.4f\n", corr(b2_rho99, b3_rho99)
rho = 0     : b2 medio = 1,0046   desv. tipica = 0,1037   min = 0,661   max = 1,357
rho = 0,99  : b2 medio = 1,0152   desv. tipica = 0,7549   min = -1,701   max = 3,318
rho = 0,99  : b2 + b3 medio = 2,0045   desv. tipica = 0,1042
correlacion entre b2 y b3 con rho = 0,99: -0,9905
freq b2_rho0
freq b2_rho99
gnuplot b3_rho99 b2_rho99
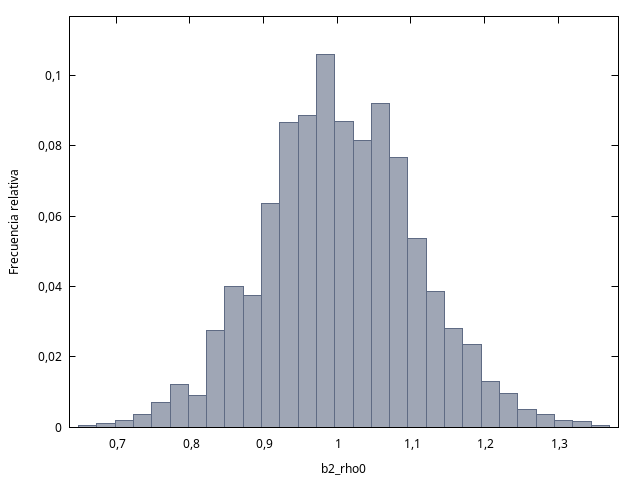
Figura 1: \(\hat\beta_2\) en las \(2\,000\) réplicas con \(\rho=0\). El eje horizontal va de \(0{,}66\) a \(1{,}36\).
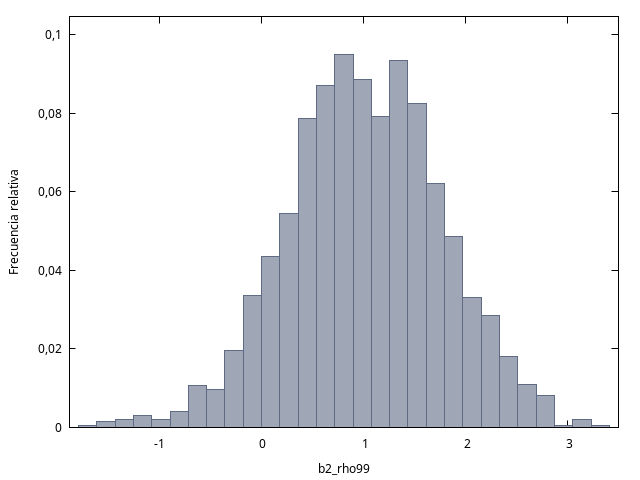
Figura 2: \(\hat\beta_2\) en las \(2\,000\) réplicas con \(\rho=0{,}99\). El eje horizontal va de \(-1{,}7\) a \(3{,}3\): la misma forma, siete veces más ancha.
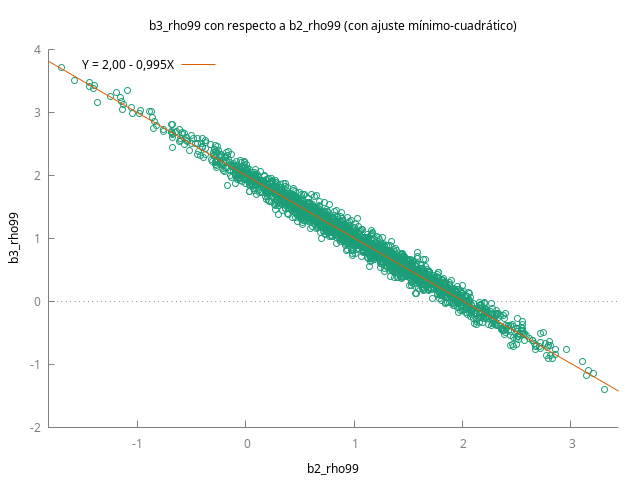
Figura 3: \(\hat\beta_3\) frente a \(\hat\beta_2\) con \(\rho=0{,}99\). Las \(2\,000\) réplicas se alinean sobre la recta \(\hat\beta_3=2-\hat\beta_2\): lo que una coordenada gana lo pierde la otra, y la suma apenas se mueve.
Lo que debe observar
Fíjese en los ejes antes que en las barras. Los dos histogramas tienen la misma forma y el mismo centro, \(1\): el estimador sigue siendo insesgado. Lo que cambia es la escala: con \(\rho=0{,}99\) la desviación típica es \(0{,}75\) en lugar de \(0{,}10\), el factor \(\sqrt{\mathrm{VIF}}\approx7\) de la lección 14, y hay réplicas en que \(\hat\beta_2\) sale negativo, con un verdadero valor de \(1\).
La nube es la figura de ``Por qué oscilan los coeficientes'' de la lección 14 vista dos mil veces: los pares \((\hat\beta_2,\hat\beta_3)\) no se dispersan en todas direcciones, sino a lo largo de una recta de pendiente \(-1\), con correlación \(-0{,}99\). Cada muestra reparte el efecto total, \(2\), entre dos regresores que casi no se distinguen, y el reparto es casi arbitrario; la suma no. Con datos reales solo se dispone de una réplica: un punto de esa nube, sin saber cuál.
Preguntas de interpretación para la clase
- ¿Por qué la \(\mathrm{SRC}\) es la misma en las cuatro filas de la tabla, y por qué el \(R^2\) no lo es? ¿Habría pasado lo mismo si \(\boldsymbol x_3\) se hubiera generado de forma independiente para cada \(\rho\)?
- Con \(\rho=0\) la varianza de \(\hat\beta_2+\hat\beta_3\) es \(0{,}023\), el doble que con \(\rho=0{,}99\). ¿Es que la colinealidad mejora la estimación de la suma? Razónelo con la parte propia del regresor \(\boldsymbol x_2+\boldsymbol x_3\).
- En la última columna, el efecto verdadero de \(\boldsymbol x_2\) solo se detecta el \(26\%\) de las veces con \(\rho=0{,}99\). Un investigador con una sola muestra obtiene \(t=0{,}9\) y concluye que \(\boldsymbol x_2\) no influye. ¿Qué diría usted, y qué pediría ver?
- La nube de la Actividad 2 está centrada en \((1,1)\). Si el investigador de la pregunta anterior obtiene \((\hat\beta_2,\hat\beta_3)=(-0{,}5;\,2{,}5)\), ¿son esos valores ``incorrectos''? ¿Qué es lo que sí está bien estimado en esa muestra?
- ¿Qué habría que cambiar en el experimento para que, con \(\rho=0{,}99\), el \(t\) de \(\boldsymbol x_2\) volviera a superar \(t_c\) en casi todas las réplicas? Diga dos cosas distintas y compare su coste.
Para profundizar
- Lección 14 (lección 14), en especial ``La parte propia de un regresor'' y ``Por qué oscilan los coeficientes''.
- Lección 11 (lección 11), la covarianza entre \(\hat\beta_1\) y \(\hat\beta_2\) con \(k=2\).
- Wooldridge, J. M. (2020). Introductory Econometrics, cap. 3, sección 3.4, ``Multicollinearity''.
- Manual de Gretl: funciones
mcov,corrysd; matrices en bucles.
Código completo de la práctica
| Enlace al guión: | S22-Prct-A-colinealidad-montecarlo.inp |
Respuestas
- La \(\mathrm{SRC}\) idéntica. El residuo es \(\boldsymbol y\) menos su proyección sobre el subespacio de los regresores, y ese subespacio es el mismo para los cuatro \(\rho\), porque \(\boldsymbol x_3\) es siempre una combinación de \(\boldsymbol z_1\) y \(\boldsymbol z_2\) y \(\boldsymbol x_2=\boldsymbol z_1\). Como además la perturbación sorteada es la misma (la semilla se fija antes de cada bucle), y \(\boldsymbol y\) es \(\boldsymbol u\) más un vector del subespacio, el residuo es el residuo de \(\boldsymbol u\), idéntico en las cuatro filas. El \(R^2\) cambia porque cambia la longitud de \(\boldsymbol{\mathop{\widehat y}}\): con los dos efectos positivos, alinear los regresores hace que se sumen. Con un \(\boldsymbol x_3\) generado por separado para cada \(\rho\), los subespacios serían distintos y la \(\mathrm{SRC}\) variaría un poco, sin que eso cambiara la conclusión: el ajuste es casi el mismo; las coordenadas, no.
- La suma se estima mejor con colinealidad. Sí. Como \(\hat\beta_2\boldsymbol x_2+\hat\beta_3\boldsymbol x_3=(\hat\beta_2+\hat\beta_3)\boldsymbol x_2+\hat\beta_3(\boldsymbol x_3-\boldsymbol x_2)\), la suma \(\hat\beta_2+\hat\beta_3\) es la coordenada de \(\boldsymbol x_2\) en la base \(\{\boldsymbol x_2,\ \boldsymbol x_3-\boldsymbol x_2\}\), y se mide con la parte propia de \(\boldsymbol x_2\) respecto de la diferencia \(\boldsymbol x_3-\boldsymbol x_2\). Cuando \(\boldsymbol x_2\) y \(\boldsymbol x_3\) están alineados, esa diferencia es casi ortogonal a \(\boldsymbol x_2\), la parte propia es casi todo \(\boldsymbol x_2\), y la varianza de \(\hat\beta_2+\hat\beta_3\) es la de un solo coeficiente sin colinealidad, \(0{,}011\); cuando son ortogonales, la suma de dos estimadores independientes tiene el doble de varianza. La colinealidad no destruye información: la concentra en la dirección compartida y la quita de la dirección que separa a los dos regresores.
- ``\(\boldsymbol x_2\) no influye''. Que un \(t\) no significativo es lo que se obtiene tres de cada cuatro veces con \(\rho=0{,}99\) aunque el efecto sea \(1\), así que no rechazar dice muy poco. Pediría ver el intervalo de confianza, que será ancho e incluirá valores tan grandes como \(2\), y el VIF, que dirá por cuánto se ha multiplicado el error estándar. Y pediría el \(F\) de excluir \(\boldsymbol x_2\) y \(\boldsymbol x_3\) a la vez, que será grande: el contraste rechaza que sobren los dos a la vez, aunque no permitan decir cuál de los dos influye.
- Valores ``incorrectos''. No: son una réplica posible, un punto de la nube, y el estimador que los produjo es insesgado y de varianza mínima entre los lineales. Lo que está mal es leerlos como el efecto separado de cada regresor, que la muestra no puede dar. Lo que sí está bien estimado es la suma, \(2{,}0\), y con ella el ajuste: la \(\mathrm{SRC}\) de esa réplica es la misma que tendría con cualquiera de los otros tres valores de \(\rho\), porque el subespacio es el mismo; lo mal determinado es el reparto entre las dos coordenadas, no el punto \(\boldsymbol{\mathop{\widehat y}}\). La predicción de \(y\) para una nueva observación en la que \(x_2\) y \(x_3\) vayan juntos, como en la muestra, es tan buena como sin colinealidad.
- Qué cambiar. Más observaciones: la parte propia crece como \(\sqrt n\), y para recuperar el factor \(7\) del error estándar haría falta multiplicar \(n\) por \(50\). O más variación propia: sortear \(\boldsymbol x_3\) con menos correlación es lo que un diseño experimental puede hacer y los datos observados no; con \(\rho=0{,}9\) bastaban cien observaciones. La segunda opción es mucho más barata cuando está disponible, y es lo que la lección 14 llamó regresores que varíen por separado.