Lección 14. Colinealidad: cuando los regresores casi se alinean
Índice
- 1. De dónde venimos: el caso
noxylnox - 2. Colinealidad exacta y colinealidad de grado
- 3. La parte propia de un regresor
- 4. Cuánto se acorta: el factor de inflación de la varianza
- 5. El caso
noxylnoxcon números - 6. Por qué oscilan los coeficientes
- 7. Síntomas y diagnóstico
- 8. Qué es y qué no es
- 9. Qué hacer y qué no
- 10. Recapitulación y guiño a las sesiones siguientes
- 11. Preguntas de repaso (sesión 21) htmlonly
- 12. Respuestas htmlonly
La lección 12 dejó enunciado que el error estándar de un coeficiente es \(\mathfrak s/\Vert\tilde{\boldsymbol x}_j\Vert_e\), con \(\tilde{\boldsymbol x}_j\) la parte propia del regresor. Hoy definimos esa parte propia, medimos cuánto se acorta cuando un regresor casi cae en el subespacio de los demás y leemos la consecuencia: coeficientes imprecisos e inestables, con un ajuste que no se mueve.
``El subespacio es estable; las coordenadas, no.''
1. De dónde venimos: el caso nox y lnox
La lección 13 dejó un caso sin explicar: en price sobre rooms, nox y lnox, los dos \(t\) de la contaminación eran pequeños y el \(F\) de excluirlas juntas, \(28{,}2\).
Lo que cambia al añadir lnox (hprice2, \(n=506\)):
Regresores, además de rooms |
coef. de nox |
\(\mathrm{ee}(\hat\beta_{\text{nox}})\) | \(\mathfrak s\) |
|---|---|---|---|
nox |
\(-1884{,}7\) | \(253{,}6\) | \(6291{,}0\) |
nox y lnox |
\(404{,}2\) | \(2198{,}9\) | \(6290{,}4\) |
El coeficiente pasa de \(-1884{,}7\) a \(404{,}2\) y cambia de signo; el error estándar se multiplica por \(8{,}7\); \(\mathfrak s\) apenas cambia. La lección 12 enunció \(\mathrm{ee}(\hat\beta_j)=\frac{\mathfrak s}{\Vert\tilde{\boldsymbol x}_j\Vert_e}\): lo que se ha acortado es \(\tilde{\boldsymbol x}_{\text{nox}}\), la parte propia de nox.
Hoy: qué es \(\tilde{\boldsymbol x}_j\), cuánto mide, qué le pasa al coeficiente y qué hacer.
De dónde venimos: el caso nox y lnox
La lección 13 terminó con un caso que supimos leer pero no medir. Con rooms y nox en el modelo, la contaminación tiene un \(t\) de \(-7{,}4\); con rooms, nox y lnox, los \(t\) de las dos medidas de contaminación caen a \(0{,}18\) y \(-1{,}05\), mientras que el \(F\) de excluirlas a la vez vale \(28{,}2\). Dijimos que era la firma de la colinealidad y que la lección 14 le pondría números.
La tabla de la transparencia aísla lo que cambia al añadir lnox. Al añadir lnox, el coeficiente de nox cambia de signo y su error estándar pasa de \(253{,}6\) a \(2198{,}9\). Lo que casi no cambia es \(\mathfrak s\): \(6291{,}0\) frente a \(6290{,}4\). El ruido estimado es similar, así que el cambio no viene del numerador del error estándar.
La lección 12 dejó enunciado, sin demostrar, que con varios regresores
\[
\mathrm{ee}(\hat\beta_j)=\frac{\mathfrak s}{\Vert\tilde{\boldsymbol x}_j\Vert_e},
\]
donde \(\tilde{\boldsymbol x}_j\) es lo que le queda de propio al regresor \(j\) tras descontar lo que comparte con los demás. Si \(\mathfrak s\) no ha cambiado y el error estándar se ha multiplicado por \(8{,}7\), la parte propia de nox se ha dividido por \(8{,}7\). Queda por entender qué es \(\tilde{\boldsymbol x}_j\), por qué se acorta y cuánto.
La sesión tiene tres partes. Las cuatro primeras transparencias definen la parte propia de un regresor y miden su longitud, con el resultado que hoy se demuestra y el error estándar que se lee a partir de él. Las dos siguientes ponen números al caso nox y lnox y explican por qué los coeficientes oscilan. Las tres últimas son de lectura: síntomas, qué es y qué no es la colinealidad, y qué hacer.
Para profundizar: Wooldridge, J. M. (2020), cap. 3, sección 3.4, apartado ``Multicollinearity'' (el planteamiento del problema con la fórmula de la varianza de \(\hat\beta_j\)).
2. Colinealidad exacta y colinealidad de grado
Exacta (lección 10): un regresor es combinación lineal de los demás. \(\boldsymbol{\mathsf X}^\top\boldsymbol{\mathsf X}\) no es invertible; infinitos \(\boldsymbol{\mathop{\widehat\beta}}\) dan el mismo ajuste. Ejemplo: temperatura en Celsius y en Fahrenheit.
De grado (hoy): un regresor forma un ángulo muy pequeño con el subespacio generado por los demás (constante incluida). Solución única, pero imprecisa e inestable.
Con dos regresores no constantes: \(\rho_{\boldsymbol x_2\boldsymbol x_3}\) próximo a \(\pm1\), es decir, \(\cos\theta\) próximo a \(\pm1\) y vectores en desviaciones casi alineados (lección 3). Con más: alguno forma un ángulo muy pequeño con el subespacio de los otros, y las correlaciones por parejas no bastan para verlo (lección 10).
Es una escala, no una frontera. La pregunta útil no es ``¿hay colinealidad?'' sino ``¿cuánto aumenta el error estándar de cada coeficiente?''.
Colinealidad exacta y colinealidad de grado
El curso ya conoce el caso extremo. En la lección 10, al deducir las ecuaciones normales, dijimos que si los regresores son linealmente dependientes la matriz \(\boldsymbol{\mathsf X}^\top\boldsymbol{\mathsf X}\) no es invertible y el sistema tiene infinitas soluciones: infinitos vectores \(\boldsymbol{\mathop{\widehat\beta}}\) producen el mismo ajuste \(\boldsymbol{\mathop{\widehat y}}\). Lo llamamos colinealidad exacta, y la práctica que siguió a esa lección lo comprobó (actividad 6 (html)) con la temperatura en grados Celsius y en grados Fahrenheit: Gretl omite una de las dos columnas y avisa. Es una situación que se detecta sola, porque no hay nada que estimar.
La colinealidad de grado es el caso próximo a ese: un regresor no es combinación lineal de los demás, pero forma un ángulo muy pequeño con el subespacio que generan (constante incluida). La solución existe y es única, pero el coeficiente de ese regresor se estima con poca precisión y cambia mucho ante cambios pequeños de los datos. Lo llamaremos colinealidad de grado, y la palabra ``grado'' indica que es una escala continua: lo que hay que medir es cuánto aumenta el error estándar de cada coeficiente por este motivo.
Con dos regresores no constantes la escala es la correlación. La lección 5 definió \(\rho_{\boldsymbol x_2\boldsymbol x_3}\) como el coseno del ángulo entre los vectores en desviaciones, y la lección 3 mostró que \(\cos\theta=\pm1\) exactamente cuando los vectores están alineados. Colinealidad exacta es \(\rho=\pm1\); colinealidad de grado es \(\rho\) cerca de \(\pm1\), vectores casi alineados. La lección 3 lo anunció: dos regresores muy correlacionados tienen sus vectores en desviaciones casi alineados.
Con tres o más regresores no constantes la correlación por parejas deja de bastar, por la razón que dio la lección 10: un regresor puede estar cerca del subespacio generado por los demás sin estar cerca de ninguno de ellos en particular. El ejemplo de aquella lección sirve: la renta total de un hogar frente a sus dos componentes, renta del trabajo y renta del capital. Las tres transparencias siguientes construyen la medida que sí sirve en todos los casos: la longitud de la parte propia de cada regresor.
Para profundizar: Wooldridge, J. M. (2020), cap. 3, sección 3.3 (supuesto MLR.3, no colinealidad perfecta) y sección 3.4 (la distinción con la colinealidad ``imperfecta'').
3. La parte propia de un regresor
Proyectamos \(\boldsymbol x_j\) sobre el subespacio de los demás regresores (constante incluida), como en la lección 10. El residuo de esa regresión auxiliar es la parte propia: \[ \boldsymbol x_j=\underbrace{\text{(combinación de los demás)}}_{\text{lo que comparte}}+\underbrace{\tilde{\boldsymbol x}_j}_{\text{lo propio}},\quad \tilde{\boldsymbol x}_j\perp\text{ los demás regresores.} \]
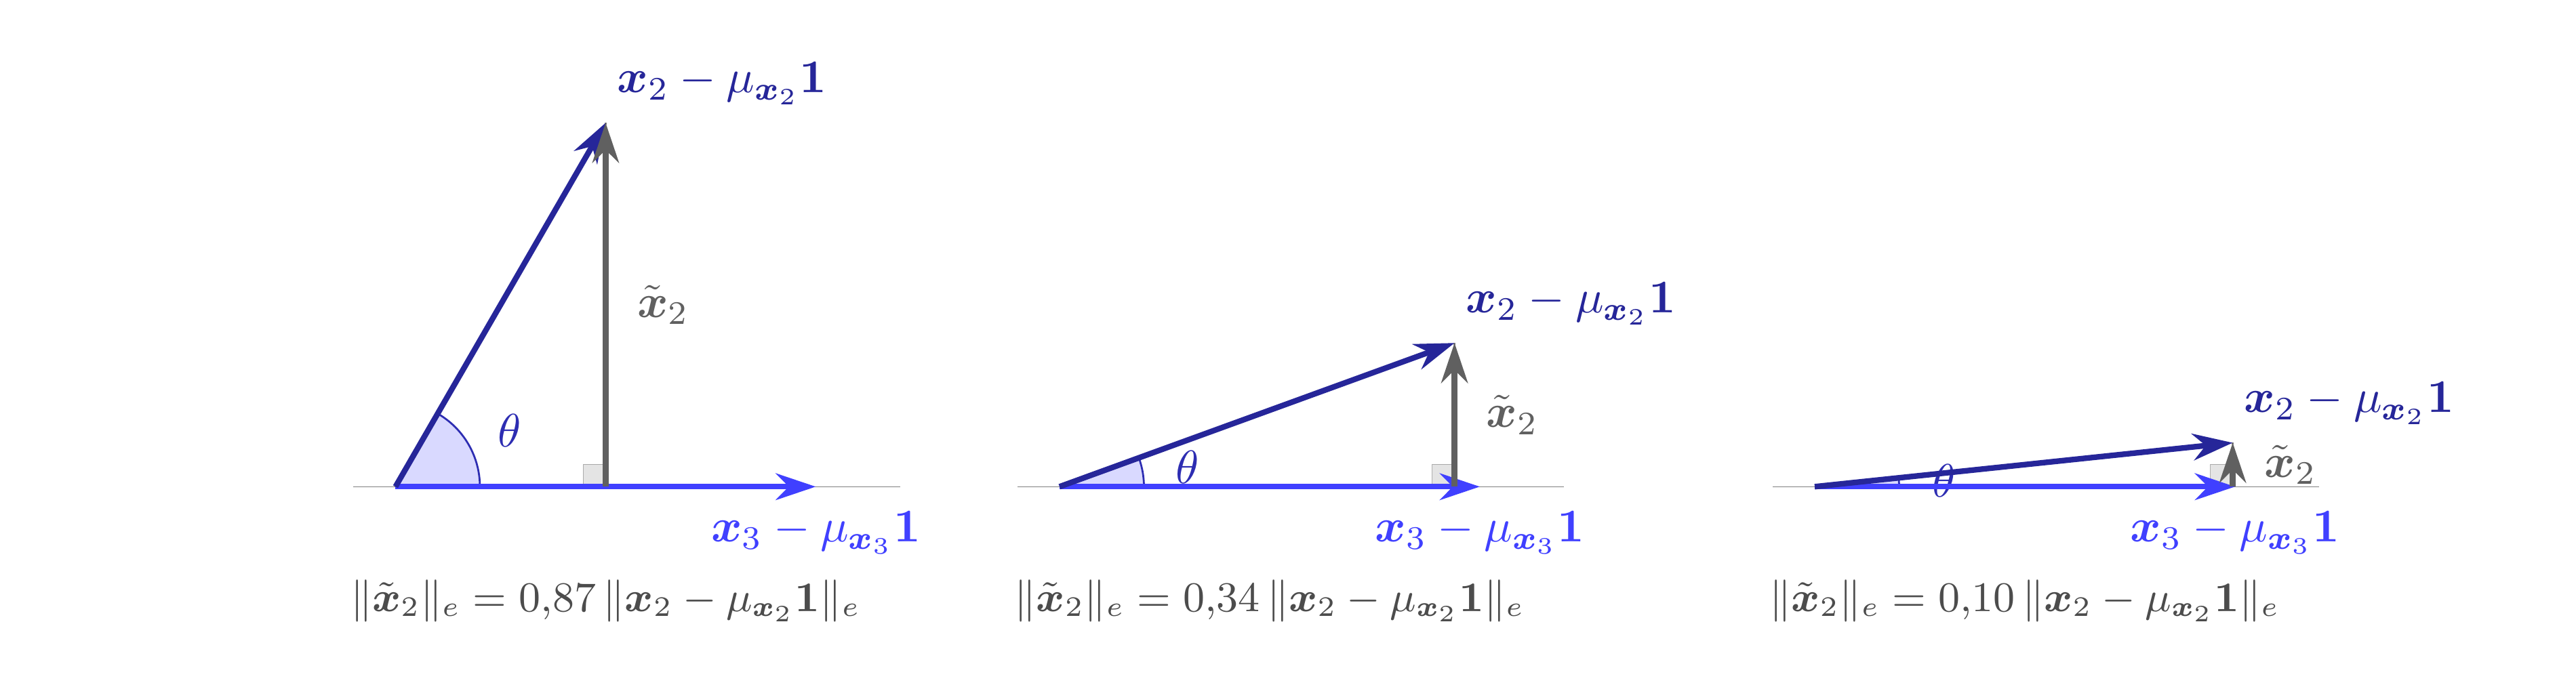
Figura 1: Dos regresores en desviaciones en el plano \(\mathcal L(\boldsymbol 1)^\perp\), con ángulo \(\theta\) de \(60^\circ\), \(20^\circ\) y \(6^\circ\). En azul, \(\boldsymbol x_2-\mu_{\boldsymbol x_2}\boldsymbol 1\) y \(\boldsymbol x_3-\mu_{\boldsymbol x_3}\boldsymbol 1\); el vector gris, que va desde la ``sombra'' del primero sobre la recta del segundo hasta la punta del primero, es \(\tilde{\boldsymbol x}_2\), la parte propia de \(\boldsymbol x_2\). Los dos regresores en desviaciones tienen la misma longitud en los tres paneles; la de la parte propia, cateto opuesto al ángulo \(\theta\), es \(\sin\theta\) veces esa longitud: \(0{,}87\), \(0{,}34\) y \(0{,}10\).
Enunciado en la lección 12 (demostración en el apéndice): \(\;\mathrm{ee}(\hat\beta_j)=\mathfrak s/\Vert\tilde{\boldsymbol x}_j\Vert_e\). Con un solo regresor no constante, \(\tilde{\boldsymbol x}_2=\boldsymbol x_2-\mu_{\boldsymbol x_2}\boldsymbol 1\) y se recupera la lección 12.
La parte propia de un regresor
La lección 12 habló de ``la parte del regresor \(j\) que no se puede reconstruir a partir de los demás''. Hoy le damos definición, y la definición es una proyección ortogonal de las de la lección 10, aplicada a un regresor en lugar de al regresando.
Tomemos el regresor \(\boldsymbol x_j\) y el subespacio generado por todos los demás, constante incluida: \(\mathcal L(\boldsymbol 1,\boldsymbol x_2,\ldots,\boldsymbol x_{j-1},\boldsymbol x_{j+1},\ldots,\boldsymbol x_k)\). Proyectar \(\boldsymbol x_j\) sobre ese subespacio es hacer una regresión, la regresión auxiliar de \(\boldsymbol x_j\) sobre los demás regresores. Esa regresión descompone \(\boldsymbol x_j\) en dos piezas ortogonales: el ajuste, que es la parte de \(\boldsymbol x_j\) que los demás regresores reproducen, y el residuo, que es la parte que no reproducen. A ese residuo lo llamamos parte propia del regresor y lo denotamos \(\tilde{\boldsymbol x}_j\). Por ser un residuo de la lección 10, \(\tilde{\boldsymbol x}_j\) es ortogonal a todos los generadores del subespacio: a \(\boldsymbol 1\) y a cada uno de los otros regresores. Tiene, en particular, media cero.
La figura lo muestra con dos regresores no constantes, en el plano de las desviaciones. Si solo hay otro regresor, \(\boldsymbol x_3\), el subespacio de ``los demás'' en desviaciones es la recta de \(\boldsymbol x_3-\mu_{\boldsymbol x_3}\boldsymbol 1\), y la parte propia de \(\boldsymbol x_2\) es la componente de \(\boldsymbol x_2-\mu_{\boldsymbol x_2}\boldsymbol 1\) perpendicular a esa recta: el cateto vertical del triángulo. Aquí aparece por primera vez en el curso el seno, y no hace falta nada nuevo para leerlo: en un triángulo rectángulo el cateto opuesto al ángulo \(\theta\) mide la hipotenusa por \(\sin\theta\), igual que el cateto contiguo mide la hipotenusa por \(\cos\theta\) (lección 3), y Pitágoras en ese mismo triángulo da \(\cos^2\theta+\sin^2\theta=1\), es decir, \(\sin\theta=\sqrt{1-\cos^2\theta}\). En los tres paneles los dos regresores en desviaciones tienen la misma longitud; solo cambia el ángulo \(\theta\) entre ellos. Con \(60^\circ\) la parte propia es casi todo el regresor; con \(6^\circ\) es una décima parte. La transparencia siguiente establece la fórmula.
Con esta definición, el enunciado de la lección 12 se lee así: el error estándar de \(\hat\beta_j\) es la longitud del ruido estimado, \(\mathfrak s\), por unidad de longitud de la parte propia del regresor. Es la misma lectura de la lección 12, ``longitud del ruido estimado por unidad de longitud del regresor en desviaciones'', con una corrección: con varios regresores no cuenta toda la longitud del regresor, solo la que no comparte con los demás. Cuando solo hay un regresor no constante no hay nada que compartir, la regresión auxiliar es la de \(\boldsymbol x_2\) sobre \(\boldsymbol 1\), su residuo es el vector en desviaciones \(\boldsymbol x_2-\mu_{\boldsymbol x_2}\boldsymbol 1\), y la fórmula es la de la lección 12. La demostración está en el apéndice (html) (sección 5.4 para la fórmula de \(\hat\beta_j\) con la parte propia; 6.5 y 7.1 para la insesgadez y la varianza con \(k\) regresores; la insesgadez de \(\mathfrak s^2\) con \(k\) regresores, que la lección 11 enunció, en 7.2); aquí basta con la lectura: con varios regresores no cuenta toda la longitud del regresor, solo la que no comparte con los demás. El resultado, \(\hat\beta_j\) como coeficiente de la regresión de \(\boldsymbol y\) sobre la parte propia de \(\boldsymbol x_j\), se conoce como teorema de Frisch–Waugh–Lovell, y es lo que usa la opción ``Ortogonalizar'' de ``Qué hacer y qué no''.
Para profundizar: Wooldridge, J. M. (2020), cap. 3, sección 3.2, apartado ``A partialling out interpretation of multiple regression'' (la regresión auxiliar y su residuo).
4. Cuánto se acorta: el factor de inflación de la varianza
Pitágoras en la regresión auxiliar (lección 8), con \(\mathrm{STC}_j=\Vert\boldsymbol x_j-\mu_{\boldsymbol x_j}\boldsymbol 1\Vert_e^2\), \(\mathrm{SRC}_j=\Vert\tilde{\boldsymbol x}_j\Vert_e^2\) y \(R_j^2=\cos^2\theta_j\) su coeficiente de determinación, de modo que \(1-R_j^2=1-\cos^2\theta_j=\sin^2\theta_j\): \[ \mathrm{STC}_j=\mathrm{SEC}_j+\mathrm{SRC}_j \;\Longrightarrow\; \boxed{\;\Vert\tilde{\boldsymbol x}_j\Vert_e=\Vert\boldsymbol x_j-\mu_{\boldsymbol x_j}\boldsymbol 1\Vert_e\,\sin\theta_j\;} \]
Sustituyendo en el error estándar: \[ \mathrm{ee}(\hat\beta_j)=\underbrace{\frac{\mathfrak s}{\Vert\boldsymbol x_j-\mu_{\boldsymbol x_j}\boldsymbol 1\Vert_e}}_{\text{como si estuviera solo}}\cdot\sqrt{\mathrm{VIF}_j}, \qquad \mathrm{VIF}_j=\frac{1}{1-R_j^2}=\frac{1}{\sin^2\theta_j}. \]
| \(\rho_{\boldsymbol x_2\boldsymbol x_3}\) (con \(k=3\), \(R_2^2=\rho_{\boldsymbol x_2\boldsymbol x_3}^2\)) | \(\theta\) | \(\mathrm{VIF}\) | \(\sqrt{\mathrm{VIF}}\) |
|---|---|---|---|
| \(0{,}5\) | \(60^\circ\) | \(1{,}3\) | \(1{,}2\) |
| \(0{,}9\) | \(26^\circ\) | \(5{,}3\) | \(2{,}3\) |
| \(0{,}99\) | \(8^\circ\) | \(50\) | \(7{,}1\) |
| \(0{,}999\) | \(2{,}6^\circ\) | \(500\) | \(22\) |
Cuánto se acorta: el factor de inflación de la varianza
La igualdad del recuadro, la longitud de la parte propia, sale de la lección 8 sin ningún ingrediente nuevo. La regresión auxiliar de \(\boldsymbol x_j\) sobre los demás regresores es una regresión como cualquier otra, con \(\boldsymbol x_j\) en el papel del regresando, así que tiene su triángulo rectángulo y su identidad \(\mathrm{STC}=\mathrm{SEC}+\mathrm{SRC}\). Escribamos las tres sumas con su subíndice \(j\) para recordar de qué regresión provienen. La suma total es la longitud al cuadrado del regresor en desviaciones, \(\mathrm{STC}_j=\Vert\boldsymbol x_j-\mu_{\boldsymbol x_j}\boldsymbol 1\Vert_e^2\). La suma residual es la longitud al cuadrado de la parte propia, \(\mathrm{SRC}_j=\Vert\tilde{\boldsymbol x}_j\Vert_e^2\), porque \(\tilde{\boldsymbol x}_j\) es el residuo de esa regresión. Y el coeficiente de determinación de la regresión auxiliar, que llamaremos \(R_j^2\), es \(\mathrm{SEC}_j/\mathrm{STC}_j=1-\mathrm{SRC}_j/\mathrm{STC}_j\). Despejando, \[ \Vert\tilde{\boldsymbol x}_j\Vert_e^2=\mathrm{SRC}_j=\mathrm{STC}_j\,(1-R_j^2)=\Vert\boldsymbol x_j-\mu_{\boldsymbol x_j}\boldsymbol 1\Vert_e^2\,(1-R_j^2). \] Tomando raíces, \(\Vert\tilde{\boldsymbol x}_j\Vert_e=\Vert\boldsymbol x_j-\mu_{\boldsymbol x_j}\boldsymbol 1\Vert_e\,\sqrt{1-R_j^2}\) (es Pitágoras en la regresión auxiliar, y así lo escribe el apéndice, sección 5.4 (html)). Y la lección 8 otra vez: \(R_j^2=\cos^2\theta_j\), con \(\theta_j\) el ángulo entre el regresor en desviaciones \((\boldsymbol x_j-\mu_{\boldsymbol x_j}\boldsymbol 1)\) y su ajuste en desviaciones en la regresión auxiliar, así que \(1-R_j^2=1-\cos^2\theta_j=\sin^2\theta_j\) (Pitágoras en el triángulo de la figura, como se explicó al presentarla) y queda la igualdad del recuadro, \(\Vert\tilde{\boldsymbol x}_j\Vert_e=\Vert\boldsymbol x_j-\mu_{\boldsymbol x_j}\boldsymbol 1\Vert_e\,\sin\theta_j\). Es lo que la figura de ``La parte propia de un regresor'' muestra: el cateto vertical mide la hipotenusa por el seno del ángulo. \(\blacksquare\)
Ahora sustituimos la longitud recién obtenida en la fórmula del error estándar, \(\mathrm{ee}(\hat\beta_j)=\mathfrak s/\Vert\tilde{\boldsymbol x}_j\Vert_e\), que queda escrita como producto de dos factores: \[ \mathrm{ee}(\hat\beta_j)=\frac{\mathfrak s}{\Vert\boldsymbol x_j-\mu_{\boldsymbol x_j}\boldsymbol 1\Vert_e\,\sqrt{1-R_j^2}}=\frac{\mathfrak s}{\Vert\boldsymbol x_j-\mu_{\boldsymbol x_j}\boldsymbol 1\Vert_e}\cdot\frac{1}{\sqrt{1-R_j^2}}. \] El primero, \(\mathfrak s/\Vert\boldsymbol x_j-\mu_{\boldsymbol x_j}\boldsymbol 1\Vert_e\), es el error estándar que tendría \(\hat\beta_j\) si el regresor no compartiera nada con los demás: la fórmula de la lección 12, con el \(\mathfrak s\) del modelo completo. El segundo, \(1/\sqrt{1-R_j^2}\), es el factor que añade compartir variación con los demás. Su cuadrado tiene nombre propio en los manuales: factor de inflación de la varianza, \(\mathrm{VIF}_j=1/(1-R_j^2)\), porque multiplica la varianza del estimador; al error estándar lo multiplica su raíz. En el lenguaje del curso, \(\mathrm{VIF}_j=1/\sin^2\theta_j\): cuanto más se cierra el ángulo entre un regresor y el subespacio de los demás, más se infla.
Con dos regresores no constantes la regresión auxiliar es simple, \(\boldsymbol x_2\) sobre \(\boldsymbol 1\) y \(\boldsymbol x_3\), y la lección 8 demostró que en regresión simple \(R^2=\rho^2\). Por tanto \(R_2^2=\rho_{\boldsymbol x_2\boldsymbol x_3}^2\) y \(\mathrm{VIF}_2=1/(1-\rho_{\boldsymbol x_2\boldsymbol x_3}^2)\), y lo mismo para \(\boldsymbol x_3\): con \(k=3\) los dos regresores tienen el mismo VIF. La tabla de la transparencia recorre la escala. Una correlación de \(0{,}5\) apenas se nota: el error estándar crece un \(15\,\%\). Una de \(0{,}9\) lo multiplica por \(2{,}3\). Una de \(0{,}99\), por \(7\); y con \(0{,}999\) el ángulo es de \(2{,}6^\circ\) y el error estándar se multiplica por \(22\). El crecimiento no es lineal en \(\rho\): casi todo el aumento se produce en los últimos grados antes de la alineación exacta. Por eso la colinealidad apenas se nota hasta que la correlación es muy alta.
Con más de dos regresores no constantes no hay atajo: \(R_j^2\) es el \(R^2\) de una regresión múltiple, y hay que estimarla. Gretl lo calcula con un comando, como veremos en la transparencia siguiente.
Para profundizar: Wooldridge, J. M. (2020), cap. 3, sección 3.4, ecuación de \(\mathrm{Var}(\hat\beta_j)\) con el factor \(1-R_j^2\) y la discusión del VIF que la sigue.
5. El caso nox y lnox con números
Regresión auxiliar de nox sobre rooms y lnox (hprice2): \(R_j^2=0{,}9879\), es decir, los otros dos regresores reproducen el \(98{,}8\,\%\) de la variación de nox.
| Cantidad | Valor |
|---|---|
\(\Vert\boldsymbol x_{\text{nox}}-\mu_{\text{nox}}\boldsymbol 1\Vert_e\) (longitud de nox en desviaciones de su media) |
\(26{,}03\) |
| \(\sqrt{1-R_j^2}=\sin\theta_j\) | \(0{,}1099\) |
| \(\Vert\tilde{\boldsymbol x}_{\text{nox}}\Vert_e\) (parte propia) | \(2{,}861\) |
| \(\mathrm{VIF}=1/(1-R_j^2)\); \(\sqrt{\mathrm{VIF}}\) | \(82{,}8;\ 9{,}10\) |
\(\mathfrak s/\Vert\tilde{\boldsymbol x}_{\text{nox}}\Vert_e=6290{,}37/2{,}861\) (error estándar de nox) |
\(\approx2198{,}9\) |
El último valor, \(2198{,}9\), es el error estándar de nox en la tabla de la lección 13 (modelo con rooms, nox y lnox). Sin lnox, la parte propia de nox medía \(24{,}81\); con lnox, \(2{,}861\) (se ha dividido por \(8{,}7\)).
En Gretl: comando vif tras estimar, o Análisis -> Colinealidad en la ventana del modelo. Devuelve \(82{,}8\) para nox, \(82{,}9\) para lnox y \(1{,}1\) para rooms.
El caso nox y lnox con números
Volvamos al modelo con que abrimos la sesión y hagamos la cuenta completa para nox. La regresión auxiliar es la de nox sobre la constante, rooms y lnox, y su coeficiente de determinación es \(R_j^2=0{,}9879\): los otros regresores reproducen el \(98{,}8\,\%\) de la variación de nox. Casi todo, como cabía esperar de una variable y su logaritmo, cuya correlación es \(0{,}9939\), un ángulo de \(6{,}3^\circ\).
Las longitudes salen de la fórmula de ``Cuánto se acorta: el factor de inflación de la varianza''. El regresor en desviaciones mide \(26{,}03\); \(\sqrt{1-R_j^2}=0{,}1099\); la parte propia mide \(26{,}03\cdot0{,}1099=2{,}861\). Y el error estándar es \(\mathfrak s\) dividido por esa longitud: \(6290{,}37/2{,}861\approx2198{,}9\) (con todos los decimales de Gretl, \(2198{,}85\)), la cifra que Gretl imprime en la tabla de apertura de la lección 13 (html). La fórmula del error estándar se cumple aquí con cuatro cifras.
Conviene leer también el factor por el que se ha multiplicado el error estándar. En el modelo sin lnox, la parte propia de nox es su residuo sobre \(\boldsymbol 1\) y rooms, y mide \(24{,}81\): casi toda su longitud en desviaciones, porque rooms apenas comparte nada con nox. Al entrar lnox, la parte propia baja a \(2{,}861\), un factor \(8{,}7\), y el error estándar sube en el mismo factor, de \(253{,}6\) a \(2198{,}9\). No ha cambiado el ruido ni el número de observaciones; solo la longitud propia de nox.
Gretl calcula los factores de inflación con el comando vif, que se ejecuta después de estimar el modelo, o desde el menú Análisis -> Colinealidad de la ventana del modelo. Para nuestro modelo devuelve \(82{,}8\) para nox, \(82{,}9\) para lnox y \(1{,}1\) para rooms: las dos medidas de contaminación comparten casi toda su variación y ninguna comparte casi nada con rooms. Con la salida de Gretl y esta lección, un VIF se lee así: es \(1/\sin^2\theta_j\), y su raíz es el factor por el que se ha multiplicado el error estándar del coeficiente respecto al que tendría si el regresor no compartiera variación con los demás regresores. Con \(82{,}8\), ese factor es \(9{,}10\); y en efecto \(241{,}6\cdot9{,}10\approx2198{,}9\), donde \(241{,}6\) es \(\mathfrak s\) dividido por la longitud completa del regresor en desviaciones.
Para profundizar: manual de Gretl, comando vif; Wooldridge, J. M. (2020), cap. 3, sección 3.4 (el VIF como estadístico de diagnóstico y sus límites).
6. Por qué oscilan los coeficientes
\(\boldsymbol{\mathop{\widehat y}}\) es la proyección de \(\boldsymbol y\) sobre el subespacio de los regresores y no depende de qué generadores lo describan. \(\hat\beta_2\) y \(\hat\beta_3\) son las coordenadas de \(\boldsymbol{\mathop{\widehat y}}\) respecto de los generadores, y sí dependen de ellos: con generadores casi alineados son inestables.
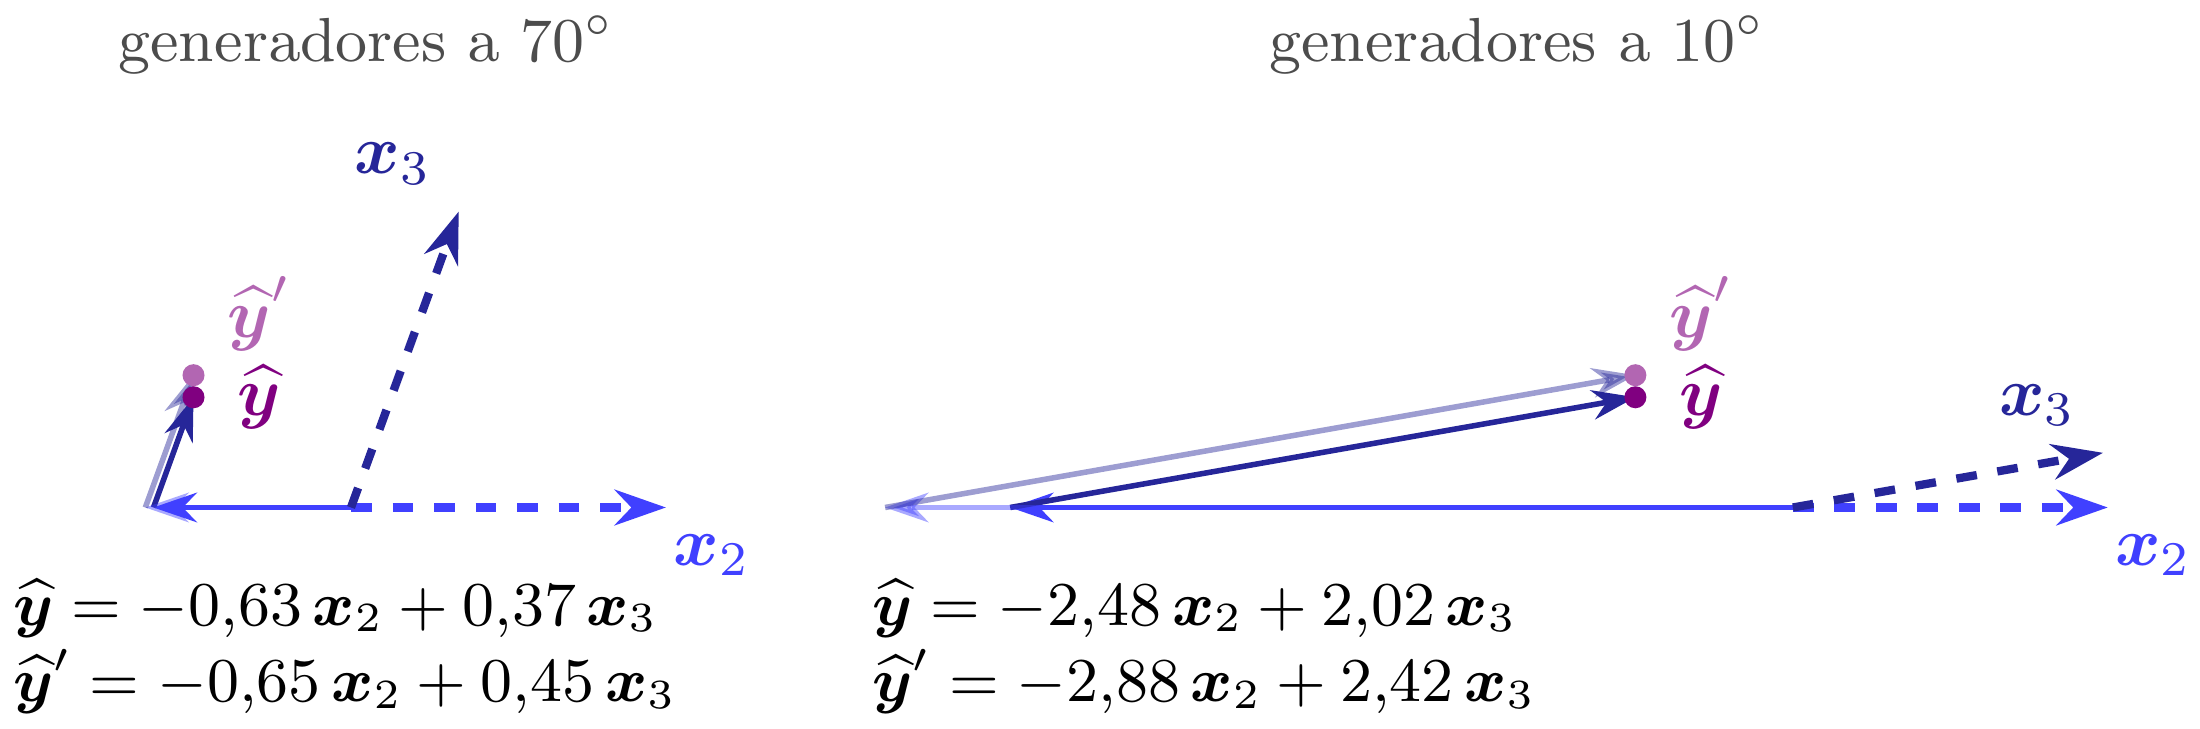
Figura 2: Dos regresores en desviaciones y de longitud \(1\) (a trazos), que forman \(70^\circ\) a la izquierda y \(10^\circ\) a la derecha, y el mismo punto \(\boldsymbol{\mathop{\widehat y}}\) en los dos paneles. Los tramos continuos son su descomposición \(\hat\beta_2\boldsymbol x_2+\hat\beta_3\boldsymbol x_3\): primero \(\hat\beta_2\boldsymbol x_2\), horizontal y hacia la izquierda porque \(\hat\beta_2<0\), y después \(\hat\beta_3\boldsymbol x_3\) hasta \(\boldsymbol{\mathop{\widehat y}}\). \(\boldsymbol{\mathop{\widehat y}}'\) es el ajuste que daría otra muestra: dista \(0{,}07\) de \(\boldsymbol{\mathop{\widehat y}}\) en la dirección perpendicular a \(\boldsymbol x_2\), y su descomposición va en color más claro. A \(70^\circ\) las coordenadas cambian poco, lo mismo que el ajuste; a \(10^\circ\) cambian \(0{,}40\) cada una y en sentidos opuestos, casi seis veces el desplazamiento del ajuste: el factor es \(1/\sin10^\circ\).
Un desplazamiento de \(\boldsymbol{\mathop{\widehat y}}\) perpendicular a \(\boldsymbol x_2\) cambia \(\hat\beta_3\) en \(1/\sin\theta=\sqrt{\mathrm{VIF}}\) veces ese desplazamiento, y \(\hat\beta_2\) lo compensa con signo contrario. \(\mathrm{SRC}\), \(R^2\) y \(F\) dependen de \(\boldsymbol{\mathop{\widehat y}}\), no de sus coordenadas: la colinealidad no los altera.
Por qué oscilan los coeficientes
El error estándar dice cuánto se dispersa un coeficiente de una muestra a otra. La figura dice por qué se dispersa tanto cuando los regresores casi se alinean, y lo dice sin probabilidad: es geometría de coordenadas.
Recordemos la lección 10: \(\boldsymbol{\mathop{\widehat y}}\) es la proyección de \(\boldsymbol y\) sobre el subespacio de los regresores, y \(\boldsymbol{\mathop{\widehat\beta}}\) son las coordenadas de esa proyección respecto de los generadores, lo que hay que avanzar en la dirección de cada regresor para llegar a \(\boldsymbol{\mathop{\widehat y}}\). La proyección depende del subespacio, no de qué generadores lo describan. Las coordenadas sí dependen de los generadores, y de cómo estén colocados.
La figura toma dos regresores en desviaciones de longitud \(1\) y un ajuste \(\boldsymbol{\mathop{\widehat y}}\) en el plano que generan. Si cambia muy ligeramente \(\boldsymbol y\), cambiará muy ligeramente el ajuste; vamos a representar esa idea con un segundo ajuste \(\boldsymbol{\mathop{\widehat y}}'\) próximo al primero (a distancia \(0{,}07\)). Con los generadores a \(70^\circ\), las coordenadas pasan de \((-0{,}63;\,0{,}37)\) a \((-0{,}65;\,0{,}45)\): cambios del mismo orden que el desplazamiento. Con los generadores a \(10^\circ\), pasan de \((-2{,}48;\,2{,}02)\) a \((-2{,}88;\,2{,}42)\): cada coordenada cambia \(0{,}40\), casi seis veces el desplazamiento, y una sube lo que la otra baja. La cuenta exacta es sencilla para un desplazamiento perpendicular a \(\boldsymbol x_2\): la coordenada de \(\boldsymbol x_3\) cambia \(1/\sin\theta\) veces el desplazamiento, y la de \(\boldsymbol x_2\) lo compensa con signo contrario. Ese factor \(1/\sin\theta\) es \(\sqrt{\mathrm{VIF}}\), el mismo de ``Cuánto se acorta: el factor de inflación de la varianza'': el error estándar mide con probabilidad lo que la figura muestra con geometría.
Dos consecuencias. La primera es que los coeficientes de regresores cuyos vectores en desviaciones casi se alinean no solo son imprecisos, sino que lo son simultáneamente y en sentidos opuestos: cuando el azar de la muestra aumenta uno, reduce el otro. La lección 11 dio, en su fórmula matricial y para \(k=2\), la covarianza entre \(\hat\beta_1\) y \(\hat\beta_2\), negativa cuando la media del regresor es positiva; con regresores alineados, la covarianza entre \(\hat\beta_2\) y \(\hat\beta_3\) es muy negativa, y así lo comprobaremos en el laboratorio de colinealidad con un experimento de Monte Carlo. Es lo que se veía en la tabla de la lección 13: nox con coeficiente \(404\) y lnox con \(-13262\), dos cifras enormes de signo opuesto que se reparten un efecto que, sumado, es el de siempre.
La segunda consecuencia es la que hay que retener para leer resultados. Lo que la colinealidad estropea son las coordenadas; no el ajuste. \(\boldsymbol{\mathop{\widehat y}}\) es el mismo punto se describa como se describa, así que \(\mathrm{SRC}\), \(R^2\), \(\mathfrak s\) y el \(F\) de significación conjunta no dependen de que los generadores estén alineados o no. Por eso la lección 13 podía decir que las dos variables juntas mejoran el ajuste y, a la vez, que no puede determinarse el efecto individual de cada una, porque la muestra no permite separarlos: el subespacio que generan es estable; pero la estimación de cómo se reparte el efecto entre ellas, no.
Para profundizar: Wooldridge, J. M. (2020), cap. 3, sección 3.4 (el ejemplo de gasto por alumno en varias partidas, en el que dos regresores con vectores en desviaciones casi alineados tienen coeficientes imprecisos mientras el conjunto está bien estimado).
7. Síntomas y diagnóstico
- \(F\) conjunto alto con \(t\) individuales bajos (lección 13), o \(R^2\) alto con casi nada significativo.
- Errores estándar que se disparan al añadir un regresor, sin que apenas cambie \(\mathfrak s\).
- Coeficientes muy sensibles a quitar unas pocas observaciones o a añadir un regresor.
- Correlaciones altas entre regresores (pero con \(k>3\) no bastan; mejor diagnóstico con el \(\mathrm{VIF}_j\) de cada uno).
Una distinción: que un coeficiente cambie al añadir un regresor es normal, es el efecto parcial de la lección 10. Colinealidad es que su error estándar se dispare y que cambie mucho con poca información nueva.
Qué mirar: \(\sqrt{\mathrm{VIF}_j}\), el factor por el que se ha multiplicado el error estándar de \(\hat\beta_j\). Es una escala, no un veredicto.
Síntomas y diagnóstico
La colinealidad de grado, a diferencia de la exacta, no es de inmediata detección: Gretl estima el modelo sin ningún aviso. Hay que reconocerla en la tabla, y los síntomas son los que las lecciones anteriores ya han producido.
El primero es el de la lección 13: un \(F\) de significación conjunta alto con \(t\) individuales bajos, o un \(R^2\) alto en un modelo donde casi ningún coeficiente es significativo. El \(F\) y el \(R^2\) miran el subespacio; los \(t\) miran las coordenadas. Que discrepen significa que los regresores juntos mejoran el ajuste, pero que la muestra no permite atribuir esa mejora a uno u otro: cada coordenada por separado está mal determinada.
El segundo es el de la tabla de apertura: un error estándar que se dispara al añadir un regresor mientras \(\mathfrak s\) no cambia. Conviene contrastar ese síntoma con lo que sí es normal. En la lección 10 y en su laboratorio (actividad 3 (html)) vimos que un coeficiente cambia de valor, y hasta de signo, al añadir un regresor. Es el efecto parcial: el significado del coeficiente cambia porque se mantiene fija otra variable. Eso no es colinealidad. Colinealidad es que, además, el error estándar se multiplique por un factor grande, y que el coeficiente se vuelva sensible a cambios pequeños de la muestra: quitar unas pocas observaciones y verlo saltar, como ocurría con las viviendas del laboratorio de regresión múltiple (actividad 6 (html)).
El tercero es la correlación entre regresores, el síntoma más usado y el menos fiable. Con dos regresores no constantes basta, porque \(\mathrm{VIF}=1/(1-\rho^2)\). Con más, la lección 10 explicó por qué no: un regresor puede formar un ángulo muy pequeño con el subespacio generado por otros dos sin estar muy correlado con ninguno. La medida que sirve en todos los casos es el VIF de cada regresor, que Gretl calcula con vif, y en particular su raíz, que es el factor por el que se ha multiplicado el error estándar.
Los manuales suelen dar una regla: un VIF mayor que \(10\) indica un problema. Conviene saberla, porque Gretl la imprime al pie de la salida de vif, y conviene saber también que es arbitraria: \(10\) significa que el error estándar se ha multiplicado por \(3{,}2\), y si ese factor es grave o no depende de para qué se quiera el coeficiente. Un VIF de \(5\) que convierte un intervalo estrecho en uno inservible es un problema; un VIF de \(50\) en un coeficiente que sigue siendo significativo y con un intervalo aceptable no lo es. Léase la escala, no el umbral.
Para profundizar: Wooldridge, J. M. (2020), cap. 3, sección 3.4 (por qué la regla del VIF mayor que \(10\) es arbitraria y qué debe mirarse en su lugar).
8. Qué es y qué no es
No es una violación de los supuestos: MCO sigue insesgado y BLUE (lección 11) y los contrastes siguen siendo válidos (lección 12). Los errores estándar grandes son correctos: describen la muestra.
No estropea el ajuste, el \(R^2\) ni la predicción: \(\boldsymbol{\mathop{\widehat y}}\) es el mismo.
Es una propiedad de la muestra: falta variación propia. Es el mismo problema que tener pocos datos.
Para estimar el efecto de una variable hace falta que esa variable varíe por su cuenta.
Qué es y qué no es
Los manuales tratan la colinealidad en el capítulo de ``problemas'' del modelo, y conviene precisar qué clase de problema es, porque no es del tipo de los que vendrán en las lecciones siguientes. En realidad es un problema de la muestra.
No es una violación de los supuestos. Los supuestos del Modelo Clásico hablan de la perturbación y del modelo poblacional; la colinealidad de grado habla de los regresores de la muestra, y ningún supuesto prohíbe que estén correlados. El único que los menciona, la independencia lineal de la lección 10, prohíbe solo el caso exacto. Con colinealidad de grado, todo lo demostrado sigue siendo válido: \(\hat\beta_j\) es insesgado, su varianza es la que dice la fórmula y, aunque aquí sea enorme, no hay estimador lineal insesgado con una varianza más pequeña (lección 11); los errores estándar de Gretl son correctos y los contrastes \(t\) y \(F\) valen (lección 12). Los errores estándar grandes informan de que esa muestra no permite estimar ese coeficiente con precisión.
Tampoco estropea el ajuste. ``Por qué oscilan los coeficientes'' lo dejó claro: \(\boldsymbol{\mathop{\widehat y}}\) es la proyección sobre el subespacio, y el subespacio no depende de cómo se le describa. \(\mathrm{SRC}\), \(R^2\), \(\mathfrak s\) y las predicciones son los mismos con generadores alineados que con generadores perpendiculares. Si lo que se quiere del modelo es predecir, la presencia de colinealidad es irrelevante.
Lo que sí es: una propiedad de la muestra, la falta de variación propia. Un regresor con parte propia corta es un regresor que, dentro de esta muestra, casi no varía por su cuenta; y sin variación propia no hay forma de medir su efecto separado. Es la misma situación que tener pocos datos: con doce viviendas el intervalo de rooms iba de \(1900\) a \(20000\) dólares porque el regresor en desviaciones era corto; con nox y lnox juntas, la parte propia de cada una es corta. En los dos casos falta longitud, y por eso el remedio ``más información'' de la transparencia siguiente es ese: más datos, o mejores datos.
La falta de variación propia es el punto de llegada de una idea que el curso repite desde la lección 11. Allí, la fórmula de la varianza decía ``más dispersión en \(X\), más precisión''. La lección 12 la dibujó con el regresor concentrado y el disperso: para estimar bien el efecto de una variable hace falta que esa variable varíe. Hoy, con varios regresores, la idea toma su forma definitiva: hace falta que varíe por su cuenta, no a la vez que las demás.
Para profundizar: Wooldridge, J. M. (2020), cap. 3, sección 3.4, la comparación entre colinealidad y tamaño muestral pequeño; Goldberger, A. S. (1991), A Course in Econometrics, cap. 23, donde acuñó ``micronumerosidad'' para subrayar que son el mismo problema.
9. Qué hacer y qué no
- Nada si el objetivo es predecir: el ajuste no depende de los generadores.
- Obtener más información: más datos o con mayor variación: rentas, tamaños, edades o países más dispares, con regresores que varíen por separado.
- Reformular: quedarse con una de las dos variables o con una combinación, o imponer una restricción y contrastarla con el \(F\) (lección 13). Se gana precisión y se pierde lo que aportaba al ajuste la que sale. Mirar qué cambia en las predicciones:
noxolnoxdescriben la realidad de forma distinta. - Ortogonalizar: sustituir un regresor por su parte propia (el residuo de su regresión auxiliar), que es ortogonal a los demás. El ajuste no cambia; cambia la interpretación de los coeficientes.
- Reconocerlo: si la pregunta exige separar los efectos y la muestra no lo permite, decirlo e informar sobre los intervalos de confianza.
- Lo que no: eliminar regresores uno a uno por su \(t\), sin realizar un contraste conjunto. Lo correcto: identificar los poco significativos y contrastar con el \(F\) que sobran a la vez.
Qué hacer y qué no
Antes de buscar remedios debemos hacernos una pregunta previa: para qué se quiere el modelo. Si es para predecir, ``Qué es y qué no es'' ya lo dijo: el ajuste es el mismo con cualquier descripción del subespacio; es decir, no hay nada que hacer dado que la colinealidad no supone un problema para la predicción. La predicción es la misma, con el mismo error estándar; la actividad 6 (html) de la práctica C del laboratorio lo comprueba con dos coches, antes y después de sustituir la edad por su parte propia. Lo que sí hay que vigilar es para qué combinación de regresores se predice. Con regresores alineados, un coche de \(300\) semanas y \(10\) mil millas está dentro del rango de cada variable y, sin embargo, lejos de la recta que forman las dos en la muestra: predecir ahí es extrapolar, y el error estándar de esa predicción es siete veces el de un coche típico. Los remedios que siguen son para cuando el objetivo es conocer el efecto de cada variable.
Si la colinealidad es falta de variación propia, el remedio de fondo es conseguirla, y solo hay una manera: más información. Las demás opciones no la crean. Reformular el modelo cambia la pregunta por otra que la muestra sí responde; sustituir un regresor por su parte propia cambia la interpretación de los coeficientes. Y, antes que cualquiera de ellas, hay una obligación: decir que la muestra no responde a la pregunta.
El primer remedio, más información, requiere precisar qué información. La fórmula del error estándar usa la longitud euclídea de la parte propia, \(\Vert\tilde{\boldsymbol x}_j\Vert_e\), la de la lección 2 que no divide por \(n\): su cuadrado es una suma de \(n\) sumandos, uno por observación, y ninguno es negativo. Por eso una observación nueva nunca acorta la parte propia; la alarga tanto más cuanto más se aparte, en el regresor \(j\), de lo que los demás regresores reproducen de ella.1 Cuánto se alarga depende de qué observaciones se añaden. Si son más observaciones de la misma población, nuevas copias de las mismas variables aleatorias, como las de la matriz de copias del apéndice de geometría (html), secciones 2 y 3, la varianza muestral de cada regresor y la correlación entre regresores apenas cambian, porque aproximan la varianza y la correlación de la población, que son las que son. El VIF se queda donde estaba, la longitud de la parte propia crece con \(\sqrt n\) y el error estándar baja a ese ritmo: para dividirlo por dos hay que cuadruplicar la muestra. Es el remedio contra tener pocos datos, y es caro.
La otra manera de obtener más información es cambiar la población de la que se muestrea, para que los regresores varíen por separado. En los coches de la práctica C, edad y millas van juntas porque los coches de la muestra tienen un uso parecido, y por eso quedan sobre una recta (figura de la actividad 1 (html)). Una muestra que incluyera coches viejos con poco uso y coches jóvenes con mucho (el segundo coche de un hogar, un taxi, una furgoneta de reparto) añadiría observaciones alejadas de esa recta, y bastan pocas para alargar la parte propia de cada regresor. Es la regla general con datos económicos: para separar el efecto de la renta del de la edad, o el del tamaño de una empresa del de su antigüedad, hace falta una muestra con rentas, edades, tamaños o antigüedades más dispares y, sobre todo, con combinaciones que no vayan siempre juntas: jóvenes con renta alta y mayores con renta baja, empresas grandes y jóvenes. Ampliar el ámbito de la muestra (más países, más sectores, más años) suele ser la manera de conseguirlo. Quien diseña un experimento elige esas combinaciones directamente, y en eso consistía la pregunta 4 (html) de la práctica B de la sesión 16; con datos reales observados en la economía (o en la sociedad), como la población es la que es, se suele perder la posibilidad de diseñar la muestra (ninguna, o casi ninguna, empresa joven es grande desde sus inicios); esa es la razón por la que la colinealidad es más difícil de evitar en economía aplicada.
El segundo remedio es reformular el modelo: quitar un regresor, o fundir dos en uno. Conviene distinguir tres casos, porque lo que se pierde no es lo mismo. Si dos variables miden la misma magnitud en dos escalas, como nox y lnox, la segunda no añade información sobre las viviendas; añade una forma funcional. Quedarse con una no pierde información, pero obliga a elegir entre dos descripciones distintas de la realidad: con nox en niveles, cada unidad más de contaminación resta lo mismo al precio; con lnox, resta cada vez menos (la interpretación de los regresores en logaritmos se verá en la lección 15). Las dos descripciones ajustan los datos de la muestra casi igual de bien, como mostró la lección 13 con el modelo con nox y el modelo con lnox: una recta y una curva logarítmica pasan casi por los mismos puntos allí donde hay muchos barrios, en los niveles de contaminación habituales. Se separan en los extremos, donde hay pocos barrios: para un barrio muy contaminado, la recta predice un precio mucho menor que la curva. Elegir una u otra es elegir qué se predice fuera de lo habitual, y la muestra apenas ayuda a decidirlo. El segundo caso es el de dos magnitudes distintas que en la muestra se mueven juntas, como la edad y las millas de un coche. Aquí quitar una sí pierde información: el modelo deja de distinguir lo que las dos distinguían. A cambio, el coeficiente de la que queda gana precisión, y cambia de significado. Con las dos variables, el coeficiente de la edad, \(28{,}02\), es el efecto de una semana más de edad a igual kilometraje. Con la edad sola, el coeficiente es \(7{,}34\), y es el efecto de una semana más de edad junto con el de las millas que esa semana trae consigo: en la muestra, por cada semana más de edad un coche tiene, en media, \(134\) millas más (\(0{,}134\) es la pendiente de la regresión de miles sobre age). La identidad de la actividad 2 (html) de la práctica C, \(7{,}34\approx28{,}02-154{,}6\cdot0{,}134\), lo descompone en el efecto de la edad a igual kilometraje más el efecto de esas \(134\) millas. Son dos preguntas distintas, y la muestra responde con más precisión a la segunda. Es un intercambio: precisión a cambio de una pregunta menos fina. El tercer caso es que la teoría diga algo sobre los coeficientes: si dos efectos deben ser iguales, o sumar uno, imponer esa restricción funde regresores y elimina la dirección compartida. La lección 13 enseñó a imponerla y a contrastarla con el estadístico \(F\); si el \(F\) no la rechaza, el modelo restringido reduce la colinealidad y permite una interpretación más clara de los resultados.
La operación que no crea variación propia deja el subespacio como está y cambia sus generadores: consiste en sustituir un regresor por su componente de variación propia \(\tilde{\boldsymbol x}_{j}\), es decir, por el residuo de su regresión auxiliar sobre los demás regresores. ``Por qué oscilan los coeficientes'' dijo que el ajuste no depende de qué generadores describan el subespacio; esta operación hace que un regresor, o un grupo de ellos, sea ortogonal a los demás. Qué cambia y qué no se deduce de lo demostrado hoy y en la lección 10. No cambia el ajuste: \(\boldsymbol{\mathop{\widehat y}}\), \(\mathrm{SRC}\), \(R^2\), \(\mathfrak s\) y las predicciones son los mismos. No cambia el coeficiente del regresor sustituido, ni su error estándar: \(\hat\beta_j\) se calcula con la parte propia de \(\boldsymbol x_j\), y la parte propia de \(\tilde{\boldsymbol x}_j\) respecto de los demás es ella misma. Sí cambian los coeficientes de los demás regresores: como \(\tilde{\boldsymbol x}_j\) es ortogonal a todos ellos, sus coeficientes pasan a ser los del modelo sin \(\boldsymbol x_j\) (familia ortogonal), con errores estándar menores. Y cambia la interpretación de todos. El coeficiente de \(\tilde{\boldsymbol x}_j\) es el efecto de la parte de \(\boldsymbol x_j\) que no acompaña a los demás regresores; el de cada uno de los demás ya no es el efecto ``con \(\boldsymbol x_j\) fijo'', sino el efecto de esa variable junto con el de la parte de \(\boldsymbol x_j\) que, en la muestra, la acompaña. La regresión auxiliar no crea información: asigna toda la variación compartida a los demás regresores, y esa asignación debe justificarla el problema económico, no la estadística. La actividad 6 (html) de la práctica C del laboratorio lo ilustra con la edad y las millas de los coches, sustituyendo la edad por su parte propia: allí se ve, con las tablas delante, qué coeficiente conserva su valor, cuál cambia y por qué los dos cambian de interpretación.
El caso en que esa justificación es más clara es el de la práctica D del laboratorio (actividad 3 (html)): el precio de ochenta y ocho viviendas sobre la tasación de una inmobiliaria y cuatro características de la vivienda. La inmobiliaria tasa a partir de las características, así que es la tasación la que debe sustituirse por su parte propia. Esa parte propia es la valoración de la inmobiliaria una vez descontado el efecto de las características que están en el modelo: lo que la inmobiliaria valora y no está entre los otros regresores (estado de conservación, situación, calidades). Con ella en el modelo, los coeficientes de las características miden su efecto sin mantener fija la tasación, y el coeficiente de la parte propia de la tasación mide cuánto responde el precio a esa valoración adicional de la inmobiliaria; en la muestra resulta claramente significativo (actividad 4 (html)).
Reconocerlo no es una opción más: cuando la muestra tiene limitaciones, hay que decirlo. Si la pregunta económica exige separar el efecto de nox del de lnox, estos datos no lo permiten, y lo correcto es informar los dos coeficientes con sus intervalos, que serán amplios, y no atribuir a la estimación una precisión que la muestra no da. Un intervalo ancho informa de lo que la muestra no permite precisar. Una vez dicho, es cuando cabe plantearse qué hacer con esas limitaciones, y es ahí donde se barajan las opciones anteriores, en función de los objetivos del estudio.
Lo que no hay que hacer lo dijo la lección 13: eliminar regresores porque sus \(t\) son bajos. Con colinealidad de grado, los \(t\) bajos son el síntoma, no un veredicto que indique que deben eliminarse conjuntamente; de hecho, el \(F\) puede rechazar esa eliminación. El procedimiento razonable tiene dos pasos: identificar con los \(t\) los coeficientes poco significativos y contrastar con el \(F\) que sus regresores pueden omitirse simultáneamente. Si el contraste no rechaza, puede ser conveniente eliminarlas, pero no es preceptivo: si la teoría exige mantenerlas, o el modelo sin ellas deja de tener sentido económico, es mejor dejarlas y reconocer que esta muestra no permite estimar bien sus efectos. La eliminación uno a uno, sacando en cada paso el regresor de mayor valor \(p\) y reestimando (es lo que hace la opción --auto de omit en Gretl), llega a un modelo en el que todos los \(t\) son grandes; con colinealidad de grado, el primero que sale lo hace por azar y el que queda hereda el efecto de los dos, así que conviene leer el contraste conjunto de todas las variables omitidas, que Gretl imprime al final, y no solo el modelo final. Existen, por último, métodos que renuncian a la insesgadez a cambio de varianza, como la regresión ridge, o que sustituyen los regresores por combinaciones ortogonales, como las componentes principales. Quedan fuera de este curso; baste saber que existen y que ninguno crea la información que la muestra no tiene.
Para profundizar: Wooldridge, J. M. (2020), cap. 3, sección 3.4 (qué hacer ante la colinealidad, y por qué eliminar regresores puede ser peor que dejarlos); Kennedy, P. (2008), A Guide to Econometrics, cap. 12 (un repaso claro de los remedios y de sus costes).
10. Recapitulación y guiño a las sesiones siguientes
| Pieza | Fórmula | Lectura geométrica |
|---|---|---|
| Parte propia del regresor \(\boldsymbol x_j\) | \(\tilde{\boldsymbol x}_j\): residuo de \(\boldsymbol x_j\) sobre los demás | lo que \(\boldsymbol x_j\) no comparte |
| Longitud de \(\tilde{\boldsymbol x}_j\) | \(\Vert\tilde{\boldsymbol x}_j\Vert_e=\Vert\boldsymbol x_j-\mu_{\boldsymbol x_j}\boldsymbol 1\Vert_e\sin\theta_j\) | cateto perpendicular al subespacio de los demás |
| Error estándar \(\mathrm{ee}(\hat\beta_j)\) | \(\mathfrak s/\Vert\tilde{\boldsymbol x}_j\Vert_e\) (demostración en el apéndice) | longitud del ruido estimado por unidad de longitud propia |
| \(\mathrm{VIF}_j\) | \(1/(1-R_j^2)=1/\sin^2\theta_j\) | inflación de la varianza; su raíz, del error estándar |
| Coeficientes \(\hat\beta_j\) | coordenadas de \(\boldsymbol{\mathop{\widehat y}}\) | inestables si los generadores casi se alinean |
Demostrado: la longitud de la parte propia. Enunciado (demostración en el apéndice, con la familia ortogonal): el error estándar. Ningún supuesto nuevo, ningún supuesto violado.
Laboratorio de colinealidad: la colinealidad creciente en Monte Carlo, la regresión auxiliar de nox y el VIF; el laboratorio del \(F\) ya anticipó la elipse de confianza de nox y lnox. Lección 16: la trampa de las variables ficticias es colinealidad exacta con \(\boldsymbol 1\).
Recapitulación y guiño a las sesiones siguientes
La sesión ha añadido una definición y un resultado. La definición es la parte propia de un regresor, el residuo de proyectarlo sobre los demás: una regresión de la lección 10 con un regresor en el papel del regresando. El resultado es su longitud, \(\Vert\boldsymbol x_j-\mu_{\boldsymbol x_j}\boldsymbol 1\Vert_e\sin\theta_j\), que sale de Pitágoras en esa regresión auxiliar. Todo lo demás es lectura: el error estándar de la lección 12, el ruido estimado dividido por esa longitud (demostrado en el apéndice, sección 5.4 (html) con la familia ortogonal de la lección 10), el VIF como inverso del seno al cuadrado, y las coordenadas que oscilan porque los generadores casi se alinean.
Conviene retener también lo que la sesión no ha hecho. No ha añadido ningún supuesto, y ninguno de los anteriores se ha violado: la colinealidad de grado es compatible con todo lo demostrado en las lecciones 11 y 12. Es un problema de la muestra, la falta de variación propia, y su remedio es información, no otro estimador.
Quedan dos hilos, y uno ya empezado. El laboratorio del contraste \(F\) aplicó lo de la lección 13 con datos reales, simuló la distribución del \(F\) bajo la hipótesis nula y dejó vista, en la elipse de confianza de nox y lnox, la oscilación de los coeficientes que hoy se ha explicado. En la práctica de colinealidad se verá, con un experimento de Monte Carlo, cómo crece la dispersión de los coeficientes al cerrar el ángulo entre dos regresores mientras el ajuste no se mueve; se calculará a mano la parte propia de nox con la regresión auxiliar; y se comprobará el VIF de Gretl contra la fórmula de hoy. El tercer hilo es de teoría y llega en la lección 16, al introducir las variables ficticias: si se incluyen una indicadora de hombre y otra de mujer junto con la constante, la suma de las dos es \(\boldsymbol 1\), y eso es la colinealidad exacta de la lección 10, que hoy hemos repasado: la llamada ``trampa de las variables ficticias''.
Para profundizar: Wooldridge, J. M. (2020), cap. 3, sección 3.4 (resumen) y cap. 7, sección 7.2 (la trampa de las variables ficticias, con la que enlaza la lección 16).
11. Preguntas de repaso (sesión 21) htmlonly
Le propongo 12 preguntas. Las marco con un nivel orientativo: [B] básica, [M] media, [D] discriminadora.
Comentario
Las preguntas que más le conviene trabajar son la 4 (fija el resultado central: la longitud de la parte propia sale de Pitágoras en la regresión auxiliar), la 7 (la distinción entre lo que la colinealidad estropea, las coordenadas, y lo que respeta, el ajuste) y la 9 (la colinealidad no viola ningún supuesto y los errores estándar grandes son correctos). Repase también la 6: separa el efecto parcial de la lección 10 de la colinealidad, dos cosas fáciles de confundir. La 12 le pide distinguir lo demostrado de lo enunciado.
Pregunta 1 [B] — Exacta frente a de grado
La diferencia entre colinealidad exacta y colinealidad de grado es:
- Ninguna: son dos nombres para el mismo problema.
- En la exacta un regresor es combinación lineal de los demás y las ecuaciones normales tienen infinitas soluciones; en la de grado forma un ángulo muy pequeño con el subespacio generado por los demás, y la solución es única pero imprecisa e inestable.
- La exacta ocurre con datos reales y la de grado solo con datos simulados.
- La de grado viola los supuestos del modelo y la exacta no.
Pregunta 2 [B] — La parte propia
La parte propia \(\tilde{\boldsymbol x}_j\) de un regresor es:
- El regresor en desviaciones respecto a su media.
- El residuo de la regresión de \(\boldsymbol x_j\) sobre los demás regresores, constante incluida: lo que los demás no reproducen.
- El ajuste de la regresión de \(\boldsymbol y\) sobre \(\boldsymbol x_j\).
- La proyección de \(\boldsymbol x_j\) sobre \(\mathcal L(\boldsymbol 1)\).
Pregunta 3 [B] — Qué mide el VIF
Un \(\mathrm{VIF}_j=25\) significa que:
- El coeficiente \(\hat\beta_j\) es \(25\) veces más grande de lo que debería.
- El \(R^2\) del modelo es \(0{,}25\).
- La varianza de \(\hat\beta_j\) es \(25\) veces la que tendría si el regresor no compartiera nada con los demás; su error estándar, \(5\) veces.
- Hay que eliminar el regresor \(j\) del modelo.
Pregunta 4 [M] — De dónde sale la longitud de la parte propia
La identidad \(\Vert\tilde{\boldsymbol x}_j\Vert_e^2=\Vert\boldsymbol x_j-\mu_{\boldsymbol x_j}\boldsymbol 1\Vert_e^2\,(1-R_j^2)\) se obtiene:
- Del supuesto de normalidad de la perturbación.
- De \(\mathrm{STC}=\mathrm{SEC}+\mathrm{SRC}\) en la regresión auxiliar de \(\boldsymbol x_j\) sobre los demás regresores: \(\tilde{\boldsymbol x}_j\) es su residuo y \(R_j^2\) su coeficiente de determinación.
- De la fórmula de la inversa de \(\boldsymbol{\mathsf X}^\top\boldsymbol{\mathsf X}\).
- No se obtiene: es un enunciado sin demostrar, como la fórmula matricial completa de la varianza.
Pregunta 5 [M] — Dos regresores
En un modelo con constante y dos regresores no constantes cuya correlación es \(0{,}99\), el error estándar de cada coeficiente, respecto al que tendría si los regresores no compartieran nada, se multiplica aproximadamente por:
- \(0{,}99\).
- \(50\).
- \(7\).
- \(1{,}01\).
Pregunta 6 [M] — Efecto parcial o colinealidad
Al añadir un regresor, el coeficiente de otro cambia de \(56\) a \(-24\) y su error estándar pasa de \(4\) a \(5\). ¿Qué indica?
- Colinealidad grave: hay que eliminar uno de los dos.
- Un cambio del efecto parcial (lección 10), no colinealidad: el error estándar apenas ha cambiado.
- Un error de cálculo de Gretl.
- Que el nuevo regresor es combinación lineal exacta del anterior.
Pregunta 7 [D] — Lo que oscila y lo que no
Con dos regresores cuyos vectores en desviaciones casi se alinean, de una muestra a otra cambian mucho:
- El ajuste \(\boldsymbol{\mathop{\widehat y}}\), el \(R^2\) y \(\mathfrak s\); los coeficientes, en cambio, son estables.
- Los coeficientes, en sentidos opuestos, mientras el ajuste, el \(R^2\), \(\mathfrak s\) y el \(F\) conjunto apenas cambian: la proyección es estable y las coordenadas no.
- Todo por igual.
- Nada: la colinealidad no afecta a la estimación.
Pregunta 8 [M] — El signo de la covarianza
Con nox y lnox en el mismo modelo, los coeficientes estimados son \(404\) y \(-13262\). La razón de que sean grandes y de signos opuestos es que:
- La contaminación tiene efectos contrarios según cómo se mida.
- Los dos regresores casi se alinean, así que el mismo ajuste admite descomposiciones muy distintas en las que un coeficiente compensa al otro; la suma de efectos es la de siempre.
- Uno de los dos regresores tiene varianza cero.
- El modelo está mal especificado y \(\mathrm{SRC}\) es mayor que \(\mathrm{STC}\).
Pregunta 9 [D] — Supuestos
Respecto a los supuestos del modelo, la colinealidad de grado:
- Viola la homocedasticidad, y por eso los errores estándar salen grandes.
- Viola la exogeneidad estricta, y por eso los coeficientes son sesgados.
- No viola ningún supuesto: MCO sigue insesgado y BLUE, y los errores estándar grandes son correctos; la muestra no permite estimar ese coeficiente con precisión.
- Viola la independencia lineal de los regresores, y Gretl no puede estimar el modelo.
Pregunta 10 [M] — Qué mirar
Con cuatro regresores no constantes, ninguno de los cuales está muy correlado con otro por parejas, ¿puede haber colinealidad de grado?
- No: si las correlaciones por parejas son moderadas, no hay colinealidad.
- Sí: un regresor puede formar un ángulo muy pequeño con el subespacio generado por los otros tres sin estar muy correlado con ninguno; por eso el diagnóstico es el VIF de cada regresor, no la matriz de correlaciones.
- Solo si \(n\) es pequeño.
- Solo si el \(R^2\) del modelo es mayor que \(0{,}9\).
Pregunta 11 [M] — Qué hacer
Dos regresores miden la misma magnitud en dos escalas, sus \(t\) son bajos y el \(F\) de excluirlos juntos es alto. La respuesta razonable es:
- Eliminar los dos, porque no son significativos.
- Quedarse con uno de los dos, o con una combinación: la información es la misma y la precisión mejora.
- Duplicar la muestra copiando las observaciones.
- Cambiar el nivel de significación al \(10\,\%\).
Pregunta 12 [D] — Qué se ha demostrado hoy y qué se ha enunciado
De los resultados de la sesión:
- Se ha demostrado \(\mathrm{ee}(\hat\beta_j)=\mathfrak s/\Vert\tilde{\boldsymbol x}_j\Vert_e\) y se ha enunciado sin demostrar la longitud de la parte propia.
- Se ha demostrado la longitud de la parte propia, \(\Vert\tilde{\boldsymbol x}_j\Vert_e=\Vert\boldsymbol x_j-\mu_{\boldsymbol x_j}\boldsymbol 1\Vert_e\sin\theta_j\), con Pitágoras en la regresión auxiliar; la fórmula del error estándar \(\mathfrak s/\Vert\tilde{\boldsymbol x}_j\Vert_e\) y la insesgadez de \(\mathfrak s^2\) con \(k\) regresores se han enunciado en la sesión y el apéndice (html) las demuestra.
- Se ha demostrado todo, incluida la insesgadez de \(\mathfrak s^2\) con \(k\) regresores.
- No se ha demostrado nada.
12. Respuestas htmlonly
- Pregunta 1 [B] — Exacta frente a de grado
Respuesta correcta: 2. Evalúa: la distinción con la que abre la sesión, y el enlace con la lección 10 (colinealidad exacta, ecuaciones normales con infinitas soluciones). La opción 4 es el error conceptual que la transparencia ``Qué es y qué no es'' desmonta.
- Pregunta 2 [B] — La parte propia
Respuesta correcta: 2. Evalúa: la definición central de la sesión. La opción 1 es el caso particular con un solo regresor no constante; observe por qué deja de valer con varios.
- Pregunta 3 [B] — Qué mide el VIF
Respuesta correcta: 3. Evalúa: la lectura del VIF como factor de la varianza y de su raíz como factor del error estándar. La opción 4 es la reacción automática que la sesión desaconseja.
- Pregunta 4 [M] — De dónde sale la longitud de la parte propia
Respuesta correcta: 2. Evalúa: el resultado demostrado hoy, la longitud de la parte propia (el error estándar se enuncia y el apéndice lo demuestra), y el reconocimiento de que es la lección 8 aplicada a una regresión cuyo regresando es un regresor. La opción 4 confunde este resultado con el enunciado de la insesgadez de \(\mathfrak s^2\).
- Pregunta 5 [M] — Dos regresores
Respuesta correcta: 3. Evalúa: el cálculo con \(k=3\): \(\mathrm{VIF}=1/(1-0{,}99^2)=50\) y el error estándar se multiplica por \(\sqrt{50}\approx7{,}1\). La opción 2 confunde varianza con error estándar.
- Pregunta 6 [M] — Efecto parcial o colinealidad
Respuesta correcta: 2. Evalúa: la distinción entre un cambio de significado del coeficiente (efecto parcial, lección 10 y su laboratorio, actividad 3 (html), donde el coeficiente de
bedrmscambiaba de signo al añadirsqft) y la colinealidad, cuya firma es el error estándar disparado. - Pregunta 7 [D] — Lo que oscila y lo que no
Respuesta correcta: 2. Evalúa: la idea que vertebra la sesión: la proyección depende del subespacio y las coordenadas de los generadores. Discrimina porque exige saber qué cantidades miran el subespacio (\(R^2\), \(\mathfrak s\), \(F\)) y cuáles las coordenadas (\(t\)).
- Pregunta 8 [M] — El signo de la covarianza
Respuesta correcta: 2. Evalúa: la lectura de la figura del paralelogramo aplicada al caso real, y la covarianza negativa entre coeficientes de regresores alineados. La opción 1 es la lectura ingenua de los signos.
- Pregunta 9 [D] — Supuestos
Respuesta correcta: 3. Evalúa: que la colinealidad de grado no es una violación de supuestos y que los errores estándar grandes son información correcta. La opción 4 describe la colinealidad exacta, no la de grado.
- Pregunta 10 [M] — Qué mirar
Respuesta correcta: 2. Evalúa: el argumento de la lección 10 (un regresor cerca del subespacio de otros sin estar cerca de ninguno) y su consecuencia práctica: el VIF, no la matriz de correlaciones.
- Pregunta 11 [M] — Qué hacer
Respuesta correcta: 2. Evalúa: la opción razonable cuando dos regresores llevan la misma información (quedarse con una forma funcional no pierde información), y el error de eliminar los dos que la lección 13 ya señaló. La opción 3 no crea información: las copias repiten las mismas perturbaciones, y el error estándar que calcularía el programa sería falso.
- Pregunta 12 [D] — Qué se ha demostrado hoy y qué se ha enunciado
Respuesta correcta: 2. Evalúa: el alcance de la sesión, con el mismo criterio que las lecciones 11, 12 y 13: la longitud de la parte propia se demuestra en la sesión con material del curso; la fórmula del error estándar y la insesgadez de \(\mathfrak s^2\) se enuncian y el apéndice las demuestra. La fórmula se comprueba además con números.
Notas al pie de página:
Con la norma estadística de la lección 2, que divide por \(n\), la longitud al cuadrado del regresor en desviaciones es su varianza muestral y no crece con \(n\). Las dos normas se relacionan por \(\Vert\boldsymbol x\Vert_e^2=n\Vert\boldsymbol x\Vert_s^2\), y la de la parte propia es \(\Vert\tilde{\boldsymbol x}_j\Vert_e^2=n\,\Vert\boldsymbol x_j-\mu_{\boldsymbol x_j}\boldsymbol 1\Vert_s^2\,(1-R_j^2)\): la varianza muestral del regresor, por lo que no comparte con los demás, por \(n\).