Sesión 22 (C) — Edad y millas: colinealidad con coeficientes significativos
Índice
- Descripción de la práctica
- Actividad 1 - Los datos y las dos regresiones simples
- Actividad 2 - Las dos juntas
- Actividad 3 - Las partes propias y el error estándar
- Actividad 4 - Contrastes: \(t\) grandes con un VIF de \(142\)
- Actividad 5 - La misma regresión en dos mitades
- Actividad 6 - Sustituir
agepor su parte propia - Preguntas de interpretación para la clase
- Para profundizar
- Código completo de la práctica
- Respuestas
Descripción de la práctica
El caso nox y lnox es la forma más visible de la colinealidad: dos \(t\) pequeños y un \(F\) grande. Esta práctica muestra otra, menos visible: dos regresores casi alineados cuyos coeficientes son significativos, uno de ellos con un signo que nadie esperaría. En esta práctica el VIF no avisa de un \(t\) pequeño, sino de un coeficiente que no puede leerse como se lee normalmente.
Los datos son data3-7 de Ramanathan: cincuenta y siete coches con su coste acumulado de reparaciones (cost, en dólares), su edad (age, en semanas) y las millas recorridas (miles, en miles de millas). Edad y millas crecen juntas: un coche que lleva más tiempo ha recorrido más. La pregunta es qué pasa cuando se pide al modelo que separe el efecto de cada uno.
Objetivos
- Comparar las dos regresiones simples con la regresión múltiple: los coeficientes cambian de tamaño y uno cambia de signo.
- Medir la colinealidad: correlación, partes propias y VIF, y comprobar de nuevo \(\mathrm{ee}(\hat\beta_j)=\mathfrak s/\Vert\tilde{\boldsymbol x}_j\Vert_e\).
- Ver que un VIF de \(142\) es compatible con dos \(t\) grandes, y qué es lo que ese VIF sí está diciendo.
- Comprobar la inestabilidad de las coordenadas estimando en dos mitades de la muestra.
- Sustituir
agepor su parte propia y comprobar qué cambia y qué no.
Comandos nuevos de esta práctica. Casi todo es conocido: open y labels (sesión 4), summary --simple y el comando corr (sesión 7), ols y sus accesores (sesiones 11 a 18), vif (actividad 3 (html) de la práctica B de hoy), restrict y $test (sesión 20), $vcv (actividad 3 (html) de la práctica B de la sesión 20 y actividad 5 (html) de la de hoy), matrix y $coeff como vector de coeficientes (práctica D de la sesión 14, actividad 2 (html)) y smpl (sesiones 14 a 18). Dos novedades y dos recordatorios:
loop foreach i 1 2- recorre una lista de números; dentro del bucle,
ivale \(1\) y después \(2\). En la práctica B de la sesión 7 (actividad 2 (html)) recorría una lista de series. (i =1) ? 40 : 10=- el operador condicional: vale \(40\) si se cumple la condición entre paréntesis y \(10\) si no.
restrict…end restrict- contrasta sobre el último modelo la restricción escrita dentro;
b[miles] = 0se refiere al coeficiente demiles. Con--quietno imprime las estimaciones restringidas, y$testrecoge después el estadístico del contraste. smpl 1 28- restringe la muestra a las observaciones 1 a 28: todo lo que se estime después usa solo esas filas.
smpl fulldevuelve la muestra completa. En los menús,Muestra -> Establecer rango.
Actividad 1 - Los datos y las dos regresiones simples
Abra data3-7, mire las variables y su correlación, y estime cost sobre age y cost sobre miles por separado.
open carga el fichero de muestra de Ramanathan (--quiet evita listar las variables) y labels muestra la descripción de cada una. summary --simple da media, mediana, desviación típica, mínimo y máximo de las tres variables, y el comando corr la correlación entre age y miles. El bloque Simples estima las dos regresiones simples con dos ols, cada una con su tabla completa, y tras cada una un printf resume en una línea el coeficiente, su error estándar, el \(t\), el \(R^2\) y \(\mathfrak s\).
o bien teclee en línea de comandos:
open data3-7.gdt --quiet
labels
summary cost age miles --simple
corr age miles
 cost: cumulative repair cost in actual dollars (11 - 3425)
 age: age of car in weeks of ownership (Range 5 - 538)
 miles: miles driven in thousands (Range 0.8 - 74.4)


                Media    Mediana      D. T.        Mín        Máx
cost             1427       1182       1151      11,00       3425
age             279,5      276,0      148,7      5,000      538,0
miles           41,58      43,40      19,96     0,8000      74,40


corr(age, miles) = 0,99646458
Bajo la hipótesis nula de no correlación:
 t(55) = 87,9614, con valor p a dos colas 0,0000
ols cost const age
printf "cost ~ age:    coef(age)   = %8.3f   ee = %7.3f   t = %6.2f   R2 = %.4f   s = %.1f\n", $coeff(age), $stderr(age), $coeff(age)/$stderr(age), $rsq, $sigma
ols cost const miles
printf "cost ~ miles:  coef(miles) = %8.3f   ee = %7.3f   t = %6.2f   R2 = %.4f   s = %.1f\n", $coeff(miles), $stderr(miles), $coeff(miles)/$stderr(miles), $rsq, $sigma
Modelo 1: MCO, usando las observaciones 1-57
Variable dependiente: cost

             coeficiente   Desv. típica   Estadístico t   valor p
  ----------------------------------------------------------------
  const      -625,935       104,150          -6,010       1,55e-07 ***
  age           7,34348       0,329580       22,28        3,31e-29 ***

Media de la vble. dep.  1426,632   D.T. de la vble. dep.   1151,186
Suma de cuad. residuos   7401653   D.T. de la regresión    366,8453
R-cuadrado              0,900265   R-cuadrado corregido    0,898451
F(1, 55)                496,4588   Valor p (de F)          3,31e-29
Log-verosimilitud      -416,4431   Criterio de Akaike      836,8863
Criterio de Schwarz     840,9724   Crit. de Hannan-Quinn   838,4743

cost ~ age:    coef(age)   =    7,343   ee =   0,330   t =  22,28   R2 = 0,9003   s = 366,8

Modelo 2: MCO, usando las observaciones 1-57
Variable dependiente: cost

             coeficiente   Desv. típica   Estadístico t   valor p
  ----------------------------------------------------------------
  const       -796,075      134,745          -5,908       2,26e-07 ***
  miles         53,4507       2,92614        18,27        5,11e-25 ***

Media de la vble. dep.  1426,632   D.T. de la vble. dep.   1151,186
Suma de cuad. residuos  10501755   D.T. de la regresión    436,9680
R-cuadrado              0,858491   R-cuadrado corregido    0,855919
F(1, 55)                333,6690   Valor p (de F)          5,11e-25
Log-verosimilitud      -426,4135   Criterio de Akaike      856,8271
Criterio de Schwarz     860,9132   Crit. de Hannan-Quinn   858,4151

cost ~ miles:  coef(miles) =   53,451   ee =   2,926   t =  18,27   R2 = 0,8585   s = 437,0
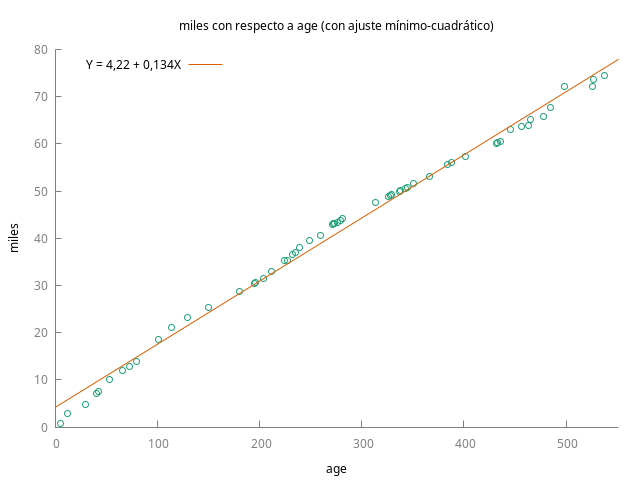
Figura 1: miles frente a age: los cincuenta y siete coches están casi sobre una recta. La correlación es \(0{,}9965\).
Lo que debe observar
Las dos regresiones simples dicen lo esperable: en el ajuste, a cada semana de edad le acompañan unos \(7\) dólares más de reparaciones; cada mil millas, con unos \(53\). Los dos coeficientes son positivos, con \(t\) de \(22\) y de \(18\). Pero la figura muestra que las dos variables son casi la misma: la correlación es \(0{,}9965\), un ángulo de \(4{,}8^\circ\), y en esta muestra ``más viejo'' y ``más rodado'' son casi indistinguibles.
Actividad 2 - Las dos juntas
Estime cost sobre age y miles, y pida los factores de inflación (Análisis -> Colinealidad).
La regresión con los dos regresores y, a continuación, vif sobre ese modelo (actividad 3 (html) de la práctica B).
o bien teclee en línea de comandos:
ols cost const age miles
vif
Modelo 3: MCO, usando las observaciones 1-57
Variable dependiente: cost

             coeficiente   Desv. típica   Estadístico t   valor p
  ----------------------------------------------------------------
  const         26,1888     114,201           0,2293      0,8195
  age           28,0163       2,77558        10,09        4,91e-14 ***
  miles       -154,635       20,6882         -7,475       6,99e-10 ***

Media de la vble. dep.  1426,632   D.T. de la vble. dep.   1151,186
Suma de cuad. residuos   3637878   D.T. de la regresión    259,5537
R-cuadrado              0,950980   R-cuadrado corregido    0,949165
F(2, 54)                523,8010   Valor p (de F)          4,36e-36
Log-verosimilitud      -396,1995   Criterio de Akaike      798,3990
Criterio de Schwarz     804,5282   Crit. de Hannan-Quinn   800,7810


Factores de inflación de varianza (VIF)
Mínimo valor posible = 1.0
Valores mayores que 10.0 pueden indicar un problema de colinealidad

         age  141,676
       miles  141,676

VIF(j) = 1/(1 - R(j)^2), donde R(j) es el coeficiente de correlación múltiple
entre la variable j y las demás variables independientes
Lo que debe observar
El coeficiente de age se ha multiplicado casi por cuatro, de \(7{,}3\) a \(28{,}0\), y el de miles ha cambiado de signo: de \(+53\) a \(-155\). Los dos son significativos, con \(t\) de \(10\) y de \(-7{,}5\). El ajuste es mejor que el de cualquiera de las simples: \(R^2=0{,}951\) y \(\mathfrak s=260\) frente a \(367\) y \(437\). Y el VIF es \(142\) para los dos regresores (con \(k=3\) es el mismo para ambos, \(1/(1-\rho^2)\)): el error estándar de cada coeficiente es \(\sqrt{142}=11{,}9\) veces el que tendría si el regresor estuviera solo.
Léase el signo con cuidado. \(-155\) no dice que rodar abarate las reparaciones. Dice que, a igual edad, en el ajuste, un coche con más millas de las que corresponden a su edad tiene menos gasto acumulado; o, con la misma cuenta, que a igual kilometraje, un coche más viejo gasta mucho más. Los dos coeficientes describen el efecto de mover un regresor mientras el otro se queda quieto, y en esta muestra eso casi nunca ocurre. Compruébelo: \(7{,}34\approx28{,}02-154{,}6\cdot0{,}134\), donde \(0{,}134\) es la pendiente de miles sobre age de la figura. Es la identidad que la práctica B de la sesión 14 (actividad 2 (html)) enunció para rooms y nox: la regresión simple mezcla los dos efectos en la proporción en que la muestra los mezcla.
Actividad 3 - Las partes propias y el error estándar
Mida la parte propia de cada regresor con la regresión auxiliar y compruebe la fórmula del error estándar con miles.
Dos regresiones auxiliares con --quiet, porque solo queremos sus accesores: la de age sobre miles y la de miles sobre age. En cada una, la raíz de $ess es la longitud de la parte propia, que el printf imprime junto a la longitud del regresor en desviaciones y al \(R^2\) auxiliar. Después se vuelve a estimar el modelo completo y se imprime \(\mathfrak s\) entre la longitud de la parte propia de miles junto al error estándar de miles que da Gretl; $sigma y $stderr se refieren al modelo que acaba de estimarse.
en línea de comandos:
ols age const miles --quiet
printf "parte propia de age   sobre miles: ||.|| = %8.3f    ||age en desviaciones||   = %8.3f    R2aux = %.4f\n", sqrt($ess), sqrt(sum((age-mean(age))^2)), $rsq
ols miles const age --quiet
scalar longPropiaMiles = sqrt($ess)
printf "parte propia de miles sobre age:   ||.|| = %8.3f    ||miles en desviaciones|| = %8.3f    R2aux = %.4f\n", longPropiaMiles, sqrt(sum((miles-mean(miles))^2)), $rsq
ols cost const age miles --quiet
printf "s = %.3f ;  s/||parte propia de miles|| = %.3f ;  ee(miles) de Gretl = %.3f\n", $sigma, $sigma/longPropiaMiles, $stderr(miles)
parte propia de age   sobre miles: ||.|| =   93,513    ||age en desviaciones||   = 1113,071    R2aux = 0,9929
parte propia de miles sobre age:   ||.|| =   12,546    ||miles en desviaciones|| =  149,332    R2aux = 0,9929
s = 259,554 ;  s/||parte propia de miles|| = 20,688 ;  ee(miles) de Gretl = 20,688
Lo que debe observar
La parte propia de miles mide \(12{,}5\) cuando el regresor en desviaciones mide \(149\): queda el \(8{,}4\%\) de su longitud, que es \(\sqrt{1-0{,}9929}=\sin4{,}8^\circ\). Y \(259{,}55/12{,}546=20{,}69\), el error estándar de la tabla. La parte propia de age mide \(93{,}5\) cuando el regresor en desviaciones mide \(1113\). Los dos regresores son largos, tienen mucha variación; lo que no tienen es variación por separado.
Actividad 4 - Contrastes: \(t\) grandes con un VIF de \(142\)
Compare los \(t\) individuales, el \(F\) conjunto y el \(F\) de omitir cada regresor, y lea la correlación entre los dos estimadores.
Sobre el modelo completo, dos bloques restrict contrastan, uno tras otro, que el coeficiente de age sea cero y que el de miles sea cero; cada \(F\) queda en $test y se guarda en un escalar. El bloque ContrastesResultados imprime los resultados: los dos \(t\) con el valor crítico, los intervalos al \(95\%\), el \(F\) global del pie de la tabla ($Fstat) con su valor crítico, los dos \(F\) de omisión con sus valores \(p\) (pvalue, sesión 18) y la correlación entre los dos estimadores, leída en $vcv: la fila 2 y la columna 3 corresponden a age y miles, segundo y tercer coeficiente de la lista (el primero es la constante).
en línea de comandos:
ols cost const age miles --quiet
scalar df = $df
restrict --quiet
    b[age] = 0
end restrict
scalar F_age = $test
restrict --quiet
    b[miles] = 0
end restrict
scalar F_miles = $test
scalar tc = critical(t, df, 0.025)
printf "Modelo completo: t(age) = %.2f   t(miles) = %.2f   t_c = %.3f\n", $coeff(age)/$stderr(age), $coeff(miles)/$stderr(miles), tc
printf "IC 95%% de age:   [%.2f ; %.2f]\n", $coeff(age) - tc*$stderr(age), $coeff(age) + tc*$stderr(age)
printf "IC 95%% de miles: [%.1f ; %.1f]\n", $coeff(miles) - tc*$stderr(miles), $coeff(miles) + tc*$stderr(miles)
printf "F de significacion conjunta (pie de tabla) = %.1f   F_c(2,%d) = %.3f\n", $Fstat, df, critical(F, 2, df, 0.05)
printf "Omitir age:   F(1,%d) = %.2f = t^2   valor p = %.2e\n", df, F_age, pvalue(F, 1, df, F_age)
printf "Omitir miles: F(1,%d) = %.2f = t^2   valor p = %.2e\n", df, F_miles, pvalue(F, 1, df, F_miles)
printf "correlacion entre los estimadores de age y miles: %.4f\n", $vcv[2,3]/sqrt($vcv[2,2]*$vcv[3,3])
Modelo completo: t(age) = 10,09   t(miles) = -7,47   t_c = 2,005
IC 95% de age:   [22,45 ; 33,58]
IC 95% de miles: [-196,1 ; -113,2]
F de significacion conjunta (pie de tabla) = 523,8   F_c(2,54) = 3,168
Omitir age:   F(1,54) = 101,89 = t^2   valor p = 4,91e-14
Omitir miles: F(1,54) = 55,87 = t^2   valor p = 6,99e-10
correlacion entre los estimadores de age y miles: -0,9965
Lo que debe observar
Con un VIF de \(142\), los dos coeficientes son significativos y el contraste rechaza omitir cualquiera de los dos: las partes propias son cortas, pero los coeficientes son tan grandes que sus \(t\) superan de sobra el umbral. El VIF no es un veredicto sobre la significación; es la escala del error estándar. Aquí dice que el intervalo de miles, de \(-196\) a \(-113\), sería doce veces más estrecho si miles no compartiera casi todo con age. Y la correlación entre los dos estimadores, \(-0{,}9965\), dice que si en otra muestra el coeficiente de age saliera menor, el de miles saldría menos negativo en proporción: la pareja está bien determinada; el reparto, no.
Actividad 5 - La misma regresión en dos mitades
Estime el modelo con los coches \(1\) a \(28\) y con los coches \(29\) a \(57\).
smpl 1 28 deja activas las 28 primeras observaciones y la regresión que sigue se estima solo con ellas. smpl 29 57 hace lo mismo con la segunda mitad, y smpl full restablece los 57 coches antes de seguir.
en línea de comandos (o Muestra -> Establecer rango):
printf "La misma regresion en dos mitades de la muestra:\n"
smpl 1 28
ols cost const age miles
printf "obs 1-28 : coef(age) = %8.3f (ee %6.3f)   coef(miles) = %9.3f (ee %7.3f)   s = %.1f\n", $coeff(age), $stderr(age), $coeff(miles), $stderr(miles), $sigma
smpl 29 57
ols cost const age miles
printf "obs 29-57: coef(age) = %8.3f (ee %6.3f)   coef(miles) = %9.3f (ee %7.3f)   s = %.1f\n", $coeff(age), $stderr(age), $coeff(miles), $stderr(miles), $sigma
smpl full
La misma regresion en dos mitades de la muestra:

Modelo 4: MCO, usando las observaciones 1-28
Variable dependiente: cost

             coeficiente   Desv. típica   Estadístico t   valor p
  ---------------------------------------------------------------
  const      -149,704        72,6969         -2,059       0,0500  *
  age           5,14157       4,62351         1,112       0,2767
  miles        -5,36813      30,4128         -0,1765      0,8613

Media de la vble. dep.  516,1429   D.T. de la vble. dep.   414,5243
Suma de cuad. residuos  507960,8   D.T. de la regresión    142,5427
R-cuadrado              0,890512   R-cuadrado corregido    0,881753
F(2, 25)                101,6678   Valor p (de F)          9,82e-13
Log-verosimilitud      -177,0137   Criterio de Akaike      360,0273
Criterio de Schwarz     364,0239   Crit. de Hannan-Quinn   361,2491

obs 1-28 : coef(age) =    5,142 (ee  4,624)   coef(miles) =    -5,368 (ee  30,413)   s = 142,5

Modelo 5: MCO, usando las observaciones 29-57 (n = 29)
Variable dependiente: cost

             coeficiente   Desv. típica   Estadístico t   valor p
  ---------------------------------------------------------------
  const       -975,847      774,808          -1,259       0,2191
  age           23,7238       8,23016         2,883       0,0078  ***
  miles       -107,742       69,5516         -1,549       0,1334

Media de la vble. dep.  2305,724   D.T. de la vble. dep.   924,8631
Suma de cuad. residuos   2285691   D.T. de la regresión    296,4982
R-cuadrado              0,904566   R-cuadrado corregido    0,897225
F(2, 26)                123,2194   Valor p (de F)          5,45e-14
Log-verosimilitud      -204,6350   Criterio de Akaike      415,2700
Criterio de Schwarz     419,3719   Crit. de Hannan-Quinn   416,5547

obs 29-57: coef(age) =   23,724 (ee  8,230)   coef(miles) =  -107,742 (ee  69,552)   s = 296,5
Lo que debe observar
En una mitad el coeficiente de miles es \(-5\) y en la otra \(-108\); el de age, \(5\) y \(24\). Con la mitad de los datos las partes propias son más cortas todavía, los errores estándar se disparan y las coordenadas cambian con el azar de cada mitad. El fichero está ordenado por edad, así que las dos mitades son además coches jóvenes y coches viejos, y \(\mathfrak s\) cambia de una a otra; eso añade una diferencia real a la oscilación. Pero la lección es la de la nube de la práctica A (actividad 2 (html)): con regresores alineados, los coeficientes individuales son lo primero que cambia de una muestra a otra.
Actividad 6 - Sustituir age por su parte propia
Guarde la parte propia de age (el residuo de su regresión auxiliar sobre miles) y úsela como regresor en lugar de age. Después prediga el coste de dos coches con los dos modelos.
La primera línea estima la regresión auxiliar de age sobre miles con --quiet; las dos siguientes guardan sus coeficientes en los escalares a0 y a1 (harán falta para la predicción), y la cuarta guarda sus residuos, $uhat, en una serie nueva, uhatAge (como en la actividad 4 (html) de la práctica D de la sesión 14). En los menús, en la ventana de la regresión auxiliar, Guardar -> Residuos. corr comprueba que el residuo no está correlado con miles. Después se estima cost sobre miles y uhatAge, y vif calcula los factores de inflación de ese modelo.
o bien teclee en línea de comandos:
ols age const miles --quiet
scalar a0 = $coeff(const)
scalar a1 = $coeff(miles)
series uhatAge = $uhat
corr uhatAge miles
ols cost const miles uhatAge
vif
corr(uhatAge, miles) = 0,00000000
Bajo la hipótesis nula de no correlación:
 t(55) = 2,41383e-13, con valor p a dos colas 1,0000


Modelo 6: MCO, usando las observaciones 1-57
Variable dependiente: cost

             coeficiente   Desv. típica   Estadístico t   valor p
  ----------------------------------------------------------------
  const       -796,075       80,0369         -9,946       8,27e-14 ***
  miles         53,4507       1,73809        30,75        6,66e-36 ***
  uhatAge       28,0163       2,77558        10,09        4,91e-14 ***

Media de la vble. dep.  1426,632   D.T. de la vble. dep.   1151,186
Suma de cuad. residuos   3637878   D.T. de la regresión    259,5537
R-cuadrado              0,950980   R-cuadrado corregido    0,949165
F(2, 54)                523,8010   Valor p (de F)          4,36e-36
Log-verosimilitud      -396,1995   Criterio de Akaike      798,3990
Criterio de Schwarz     804,5282   Crit. de Hannan-Quinn   800,7810


Factores de inflación de varianza (VIF)
Mínimo valor posible = 1.0
Valores mayores que 10.0 pueden indicar un problema de colinealidad

       miles    1,000
     uhatAge    1,000

VIF(j) = 1/(1 - R(j)^2), donde R(j) es el coeficiente de correlación múltiple
entre la variable j y las demás variables independientes
Lo que debe observar
uhatAge es la parte de la edad que no acompaña al kilometraje: cuántas semanas más (o menos) tiene un coche de las que corresponden a sus millas. Su correlación con miles es cero, por las ecuaciones normales de la regresión auxiliar, y el VIF de los dos regresores es \(1\).
Compare la tabla con la de la Actividad 2. \(\mathrm{SRC}\), \(R^2\) y \(\mathfrak s=259{,}55\) son los mismos: miles y uhatAge generan con la constante el mismo subespacio que age y miles, y la proyección no depende de cómo se describa el subespacio. El coeficiente de uhatAge es el de age en la Actividad 2, \(28{,}02\), con el mismo error estándar, \(2{,}78\): los dos se calculan con la misma parte propia de la edad. Lo que ha cambiado es el coeficiente de miles: ahora es \(53{,}45\), el de la regresión simple de la Actividad 1. Ya no mide el efecto de las millas a edad fija (\(-155\)), sino el de las millas sin descontar nada: la identidad de la Actividad 2, leída al revés, da \(53{,}45\approx-154{,}6+28{,}02\cdot7{,}43\), donde \(7{,}43\) son las semanas de edad que, en la muestra, acompañan a cada mil millas (la pendiente de age sobre miles). Lo descontado es la edad, no las millas.
Los dos coeficientes tienen ahora el signo esperado y \(t\) grandes, pero la regresión auxiliar no ha añadido información. Ha asignado toda la variación que comparten age y miles al regresor miles, y a uhatAge solo lo que la edad tiene de propio. Con la asignación contraria (sustituir miles por su residuo sobre age), el coeficiente de age sería el de la regresión simple, \(7{,}3\), y el del residuo de miles seguiría siendo \(-155\). Qué asignación es razonable lo decide el problema económico, no la estadística.
La predicción con los dos modelos
Para la predicción, los valores del coche se ponen en un vector fila x0 con un \(1\) delante, por la constante. La predicción es x0*$coeff, el producto de ese vector por el vector de coeficientes del último modelo, y su error estándar es la raíz de x0*$vcv*x0', la forma cuadrática con la matriz de covarianzas de los coeficientes (x0' es el vector traspuesto). En el modelo con uhatAge el coche no se describe por su edad, sino por su parte propia: la edad menos lo que las millas predicen de ella, 300 - (a0 + a1*mi). El bucle loop foreach i 1 2 repite el cálculo para dos coches de \(300\) semanas: mi vale \(40\) mil millas en la primera vuelta y \(10\) en la segunda (la expresión (i = 1) ? 40 : 10= elige el primer valor si la condición se cumple y el segundo si no).
en línea de comandos:
loop foreach i 1 2
    scalar mi = (i == 1) ? 40 : 10
    printf "Coche de 300 semanas y %d mil millas\n", mi
    ols cost const age miles --quiet
    matrix x0 = {1, 300, mi}
    printf "   modelo con age:     prediccion = %8.1f   ee = %6.1f\n", x0*$coeff, sqrt(x0*$vcv*x0')
    ols cost const miles uhatAge --quiet
    matrix x0 = {1, mi, 300 - (a0 + a1*mi)}
    printf "   modelo con uhatAge: prediccion = %8.1f   ee = %6.1f   (uhatAge del coche = %.1f)\n", x0*$coeff, sqrt(x0*$vcv*x0'), 300 - (a0 + a1*mi)
endloop
Coche de 300 semanas y 40 mil millas
   modelo con age:     prediccion =   2245,7   ee =   95,9
   modelo con uhatAge: prediccion =   2245,7   ee =   95,9   (uhatAge del coche = 32,3)
Coche de 300 semanas y 10 mil millas
   modelo con age:     prediccion =   6884,7   ee =  710,9
   modelo con uhatAge: prediccion =   6884,7   ee =  710,9   (uhatAge del coche = 255,1)
Lo que debe observar
Las predicciones son las mismas con los dos modelos, y con el mismo error estándar: el coche típico, de \(300\) semanas y \(40\) mil millas, cuesta \(2\,246\) dólares con un error estándar de \(96\); el de \(300\) semanas y \(10\) mil millas, \(6\,885\) con un error estándar de \(711\). Sustituir age por su parte propia no cambia nada de la predicción, porque el ajuste es el mismo. Lo que sí cambia de un coche a otro es la precisión: el segundo coche está dentro del rango de cada variable, pero su parte propia de edad es \(255\) semanas cuando las de la muestra no pasan de unas pocas decenas; está lejos de la recta de la Actividad 1, y predecir ahí es extrapolar.
Preguntas de interpretación para la clase
- En la Actividad 2, el coeficiente de
milespasa de \(+53\) a \(-155\) al añadirage. Explique con la parte propia por qué el coeficiente de la regresión múltiple no tiene por qué parecerse al de la simple. - Compruebe la identidad \(7{,}34\approx28{,}02-154{,}6\cdot0{,}134\) y diga qué representa cada uno de los tres números de la derecha.
- Con un VIF de \(142\), ¿por qué los dos coeficientes son significativos? ¿Qué tendría que valer el coeficiente de
milespara no serlo? - Un taller quiere predecir el coste de reparaciones de un coche de \(300\) semanas y \(40\) mil millas, valores típicos de la muestra. ¿Le preocupa la colinealidad para esa predicción? ¿Y para un coche de \(300\) semanas y \(10\) mil millas?
- Si tuviera que informar del efecto de la edad sobre el coste, ¿qué modelo usaría y qué diría del coeficiente de
miles? - En la Actividad 6, ¿por qué el coeficiente de
uhatAgecoincide con el deagede la Actividad 2, y el demilescon el de su regresión simple? ¿Ha resuelto la regresión auxiliar la colinealidad?
Para profundizar
- Lección 14 (lección 14), ``Síntomas y diagnóstico'' y ``Qué es y qué no es''.
- Lección 10 (lección 10), el coeficiente de regresión múltiple como coordenada, y la familia ortogonal como único caso en que coincide con el simple.
- Ramanathan, R. (2002). Introductory Econometrics with Applications, 5.ª ed., ejemplo 5.2 y sección 5.4 sobre multicolinealidad.
- Wooldridge, J. M. (2020). Introductory Econometrics, cap. 3, sección 3.4.
Código completo de la práctica
| Enlace al guión: | S22-Prct-C-ramanathan-coches.inp |
Respuestas
- Por qué cambia tanto el coeficiente. El coeficiente de
milesen la regresión simple es la coordenada de \(\boldsymbol{\mathop{\widehat y}}\) sobremilesen desviaciones, un vector de longitud \(149\). En la múltiple es la coordenada de \(\boldsymbol{\mathop{\widehat y}}\) en la base \(\{\boldsymbol 1,\text{age},\text{miles}\}\), y una coordenada depende de toda la base: con generadores casi alineados, la lección 14 mostró que el mismo ajuste admite descomposiciones muy distintas. Además, la lección 14 enunció que ese coeficiente se mide con la parte propia demiles, un vector de longitud \(12{,}5\) casi ortogonal amilesen desviaciones. Los dos coeficientes responden a preguntas distintas y no hay razón para que se parezcan, ni en tamaño ni en signo. Coinciden solo cuando los regresores son ortogonales (lección 10, familia ortogonal). - La identidad. \(28{,}02\) es el coeficiente de
ageen la múltiple; \(-154{,}6\) el demiles; \(0{,}134\) es cuántas mil millas más tiene, en esta muestra, un coche una semana más viejo. La regresión simple decostsobreagerecoge el efecto directo de la edad más el efecto de las millas que la edad arrastra: \(28{,}02+(-154{,}6)(0{,}134)=7{,}30\). La identidad es exacta salvo redondeo, y dice que el coeficiente de la simple no es ``el efecto de la edad'', sino el efecto de la edad junto con todo lo que en la muestra se mueve con ella. - Significativos con VIF \(142\). Porque el \(t\) es el coeficiente entre su error estándar, y el VIF solo infla el denominador: \(20{,}7\) en lugar de \(1{,}74\). Con un coeficiente de \(-155\) el cociente sigue siendo \(-7{,}5\). Para no ser significativo, el coeficiente de
milestendría que ser menor que \(2{,}005\cdot20{,}7\approx41\) en valor absoluto; sin la colinealidad, bastaría con que fuera menor que \(3{,}5\). El VIF dice cuánta precisión se ha perdido, no si queda suficiente. - Predicción. Para el coche típico, no: \(300\) semanas y \(40\) mil millas está sobre la recta de la figura, y allí el ajuste es el mismo cualquiera que sea el reparto entre los dos coeficientes; la predicción usa \(\boldsymbol{\mathop{\widehat y}}\), que la colinealidad no toca. Para el coche de \(300\) semanas y \(10\) mil millas, sí: está lejos de la recta, en una región donde no hay datos, y la predicción depende de la coordenada de
milespor separado, \(-155\cdot(10-40)=+4\,640\) dólares sobre el coche típico. Ese número descansa en la parte propia demiles, que mide \(12{,}5\): es una extrapolación con un error estándar enorme. - Qué informar. Depende de la pregunta, y hay que decir cuál se responde. Si se quiere el efecto de la edad sin separar lo que la edad arrastra, la regresión simple, \(7{,}3\) dólares por semana, con su intervalo estrecho, y advertir que incluye el efecto del kilometraje. Si se quiere el efecto de la edad a kilometraje fijo, la múltiple, \(28\) con intervalo de \(22\) a \(34\), y advertir que en la muestra casi no hay coches con la misma edad y distinto kilometraje, que el coeficiente de
mileses negativo y difícil de interpretar por separado, y que el VIF es \(142\). Lo que no se puede hacer es informar de \(-155\) como ``el efecto de rodar mil millas''. - Sustituir un regresor por su parte propia. El coeficiente de un regresor en la regresión múltiple se calcula con su parte propia respecto a los demás. La parte propia de
uhatAgerespecto amileses el propiouhatAge, que ya es ortogonal amiles; y es la misma que la deagerespecto amilesen la Actividad 2. Por eso el coeficiente y el error estándar coinciden (\(28{,}02\) y \(2{,}78\)).miles, en cambio, es ortogonal auhatAge, y con un regresor ortogonal su coeficiente es el de la regresión simple (lección 10, familia ortogonal): \(53{,}45\). La colinealidad no se ha resuelto, porque el subespacio, el ajuste y la parte propia de la edad son los mismos. Lo que ha cambiado es la pregunta que responde el coeficiente demiles: el efecto de las millas junto con la edad que las acompaña, en lugar del efecto de las millas a edad fija. Su error estándar es menor porque responde a una pregunta que la muestra sí permite responder con precisión.