Lección 12. Inferencia: error estándar, intervalo de confianza y contraste $t$
Author: Marcos Bujosa
La lección 11 dejó al estimador $\hat\beta_2$ bien centrado y con una varianza conocida, pero le faltaba lo esencial para contrastar hipótesis: la forma de su distribución. Hoy la obtenemos suponiendo normalidad de la perturbación.
Con ella construimos el error estándar, el intervalo de confianza y el contraste $t$, que no mide nada que el $R^2$ no midiera ya, y aprendemos a leer una tabla de resultados.
``Significativo'' no quiere decir ``grande'', ni ``importante'', ni ``verdadero''.
De dónde venimos: nos falta la forma
De la lección 11 nos traemos dos resultados sobre el modelo lineal simple ($k=2$: la constante $\mathit1$ y un único regresor no constante $X$): $$ \mathrm{E}(\hat\beta_2)=\beta_2, \qquad Var[\hat\beta_2\mid\boldsymbol X]=\frac{\sigma^2}{\sum_i(X_i-\overline{X})^2}=\frac{\sigma^2}{nS^2}. $$
Y nos traemos también una limitación que la lección 11 dejó enunciada: eso no basta para responder a
- si $\beta_2$ valiese cero, ¿serían datos como estos demasiado raros?
- ¿en qué rango de valores puedo confiar razonablemente que está $\beta_2$?
Saber dónde está centrada una distribución y cuánto se dispersa no permite responder a esas preguntas: necesitamos la forma de la distribución de probabilidad.
Hoy: un supuesto nuevo, tres herramientas (error estándar, intervalo, contraste) y, sobre todo, aprender a leerlas.
El supuesto nuevo: normalidad
Condicionada a $\boldsymbol X$, cada perturbación $U_i$ es normal de esperanza $0$ y varianza $\sigma^2$.
La descomposición de la lección 11 basta: $$ \hat\beta_2=\beta_2\,\mathit1+\sum_iW_iU_i. $$ Los $W_i$ son funciones de $\boldsymbol X$: con los regresores en su valor $\boldsymbol x$ son números, y una suma ponderada de normales independientes con pesos numéricos es normal (apuntes):
Lo nuevo es el símbolo ``$N$''; y es un supuesto genuino: la práctica C de la sesión 16 (actividad 1 (html)) mostró que insesgadez y varianza no la necesitan.
Geométricamente: la normalidad hace isótropa la perturbación: sus coordenadas en cualquier base ortonormal son independientes y con la misma distribución.
El error estándar, y el precio de estimar $\sigma$
Esa varianza contiene $\sigma^2$, que no conocemos: la estimamos con la cuasivarianza de los residuos (lección 11), $\mathfrak s^2=\mathrm{SRC}/(n-k)$.
Sustituyendo $\sigma$ por $\mathfrak s$ sobre los datos observados, el error estándar de $\hat\beta_2$: $$ \boxed{\;\mathrm{ee}(\hat\beta_2)=\frac{\mathfrak s}{\sqrt{\sum_i(x_i-\mu_{\boldsymbol x})^2}} =\frac{\mathfrak s}{\|\boldsymbol x-\boldsymbol{\mathop{\overline x}}\|_e}.\;} $$
Un cociente de longitudes: longitud del residuo por unidad de longitud del regresor en desviaciones.
El precio de estimar $\sigma$: la normal se convierte en una $t$ de Student con $n-k$ grados de libertad (enunciado; demostración en el apéndice): $$ \frac{\hat\beta_2-\beta_2}{\mathrm{ee}(\hat\beta_2)}\;\sim\;t_{n-k}. $$
Un contraste que ya puede hacer: la media
Su curso de Estadística dejó la media muestral con distribución conocida, $\overline X\sim N(\mu,\sigma^2/n)$ (allí escrita $N(\mu,\sigma/\sqrt n)$), y con ella el intervalo $\overline X\pm1{,}96\,\sigma/\sqrt n$. Le faltó el paso siguiente.
Pregunta: si $\mu$ valiese $\mu_0$, ¿serían datos como estos demasiado raros? Hipótesis nula: $H_0\!:\mu=\mu_0$.
Suponemos provisionalmente $H_0$. Entonces $$ \frac{\overline X-\mu_0}{\sigma/\sqrt n}\;\sim\;N(0,1): $$ la distancia de $\overline X$ a $\mu_0$, medida en desviaciones típicas de $\overline X$. Bajo $H_0$, el $95\,\%$ de las muestras dan un cociente entre $-1{,}96$ y $1{,}96$.
Decisión: si el cociente observado queda fuera, datos como estos serían raros bajo $H_0$ (ocurren el $5\,\%$ de las veces): se rechaza $H_0$. Si queda dentro, no se rechaza.
Con $\hat\beta_2$ en lugar de $\overline X$, $\mathrm{ee}(\hat\beta_2)$ en lugar de $\sigma/\sqrt n$ y $t_c$ en lugar de $1{,}96$: el contraste $t$ de la transparencia siguiente.
El contraste $t$
La misma lógica de la transparencia anterior, con $\hat\beta_2$. Hipótesis nula: $H_0\!:\beta_2=0$ (``el regresor no aporta nada''), frente a $H_1\!:\beta_2\neq0$.
Estadístico (bajo $H_0$, sustituyendo $\beta_2=0$ en la transparencia anterior): $$ t=\frac{\hat\beta_2}{\mathrm{ee}(\hat\beta_2)}\;\sim\;t_{n-k}. $$
Decisión al nivel $\alpha$ (habitualmente $0{,}05$): se rechaza $H_0$ si $\vert t\vert>t_c$, el valor crítico de la $t_{n-k}$ que deja $\alpha/2$ en cada cola; el conjunto $\vert t\vert>t_c$ es la región crítica.
Valor $p$: probabilidad de un $\vert t\vert$ al menos tan grande como el obtenido, si $H_0$ fuese cierta. Se rechaza si es menor que $\alpha$.
Nada obliga a contrastar contra cero: para $H_0\!:\beta_2=c$ (p. ej. una elasticidad unitaria), $\;t=(\hat\beta_2-c)/\mathrm{ee}(\hat\beta_2)$.
Lectura geométrica: la razón de catetos
En el modelo lineal simple ($k=2$), con $\boldsymbol{\mathop{\widehat y}}-\boldsymbol{\mathop{\overline y}}=\hat\beta_2(\boldsymbol x-\boldsymbol{\mathop{\overline x}})$ y $\mathfrak s^2=\mathrm{SRC}/(n-k)$, el estadístico queda: $$ \boxed{\;t^2=(n-k)\,\frac{\mathrm{SEC}}{\mathrm{SRC}}, \qquad\text{es decir}\qquad \vert t\vert=\sqrt{n-k}\;\frac{\|\boldsymbol{\mathop{\widehat y}}-\boldsymbol{\mathop{\overline y}}\|_e}{\|\boldsymbol{\mathop{\widehat e}}\|_e}.\;} $$
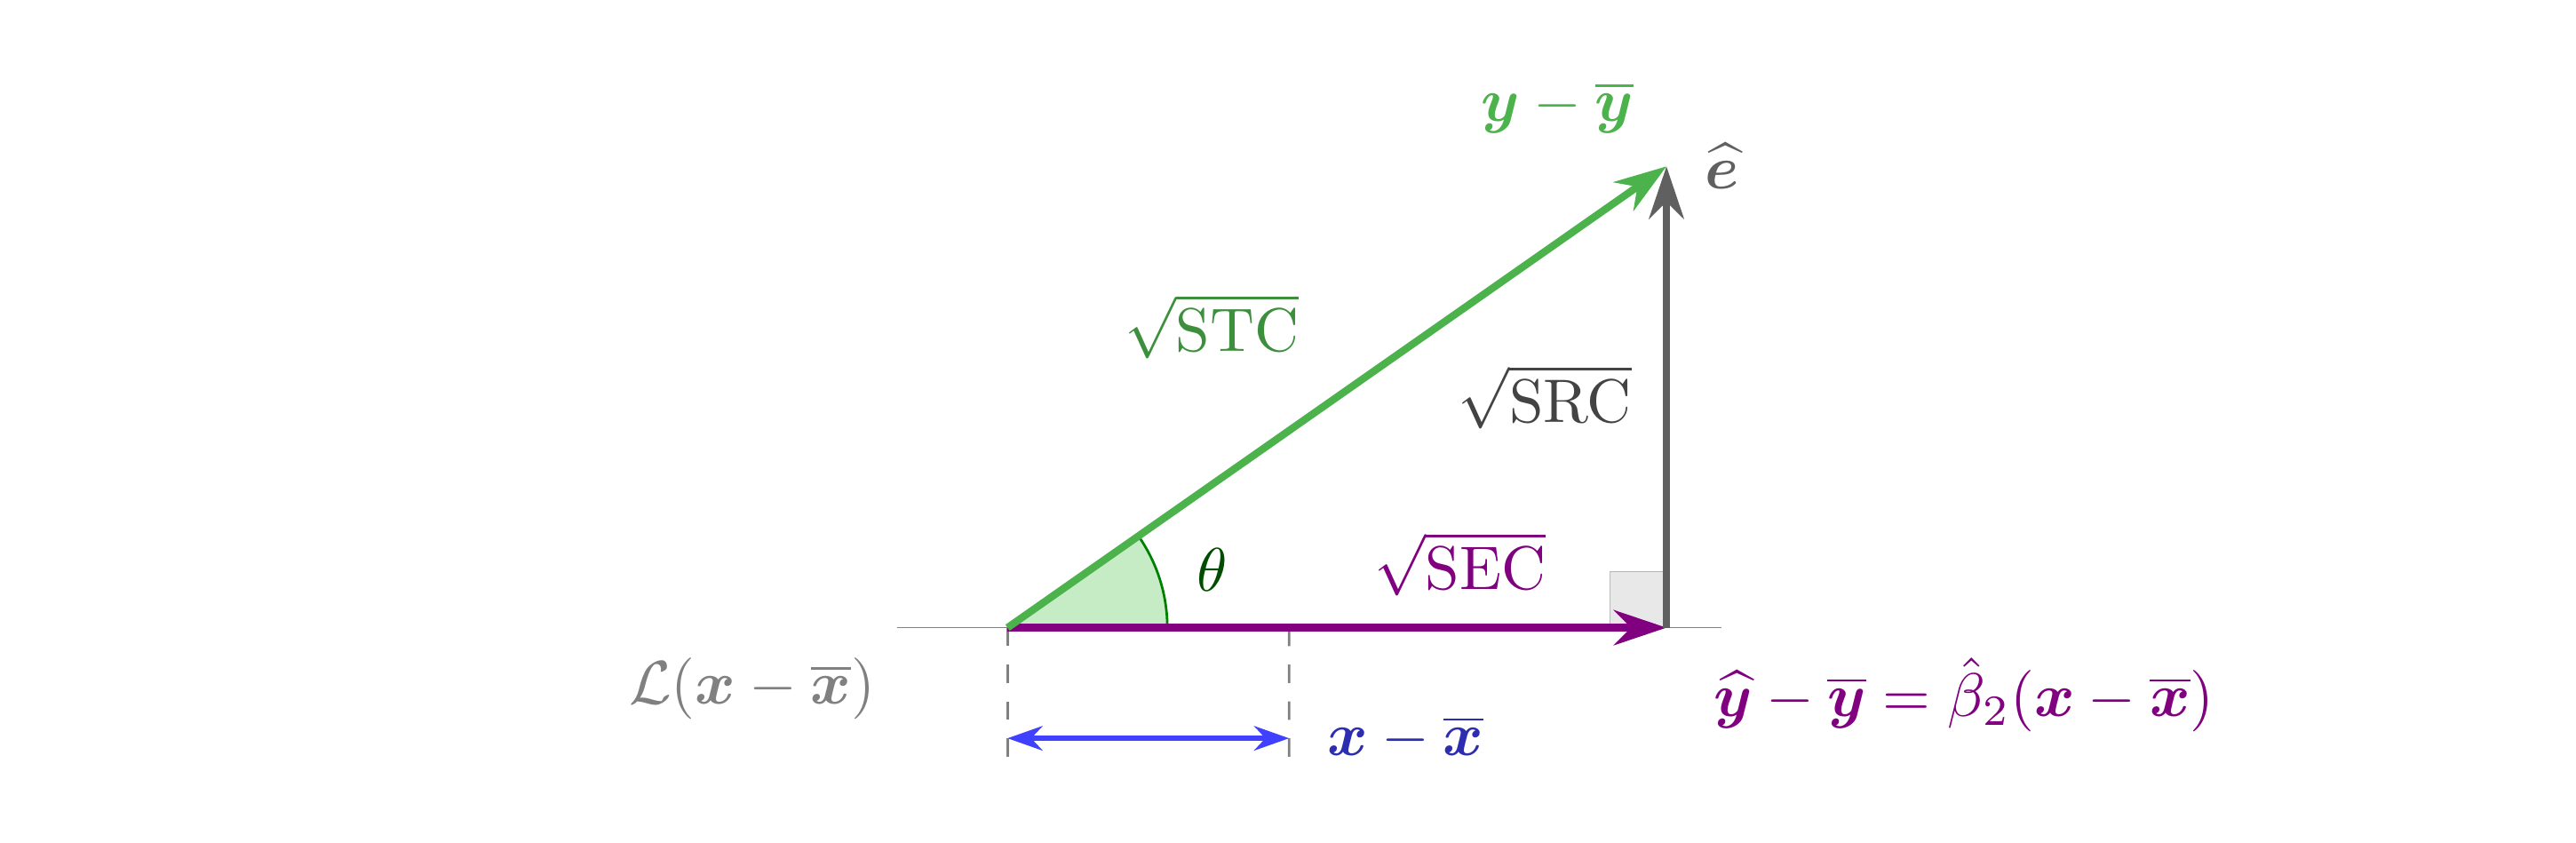
Y como $\mathrm{STC}=\mathrm{SEC}+\mathrm{SRC}$, también $t^2=(n-k)R^2/(1-R^2)$: el contraste $t$ no mide nada que el $R^2$ no midiera ya.
Por qué el valor crítico depende de $n-k$
La identidad anterior separa la significación en dos factores: $\;\vert t\vert=\sqrt{n-k}\times\sqrt{\mathrm{SEC}/\mathrm{SRC}}=\sqrt{n-k}\times\sqrt{R^2/(1-R^2)}$, es decir, cuántas observaciones $\times$ qué fuerza tiene la relación.
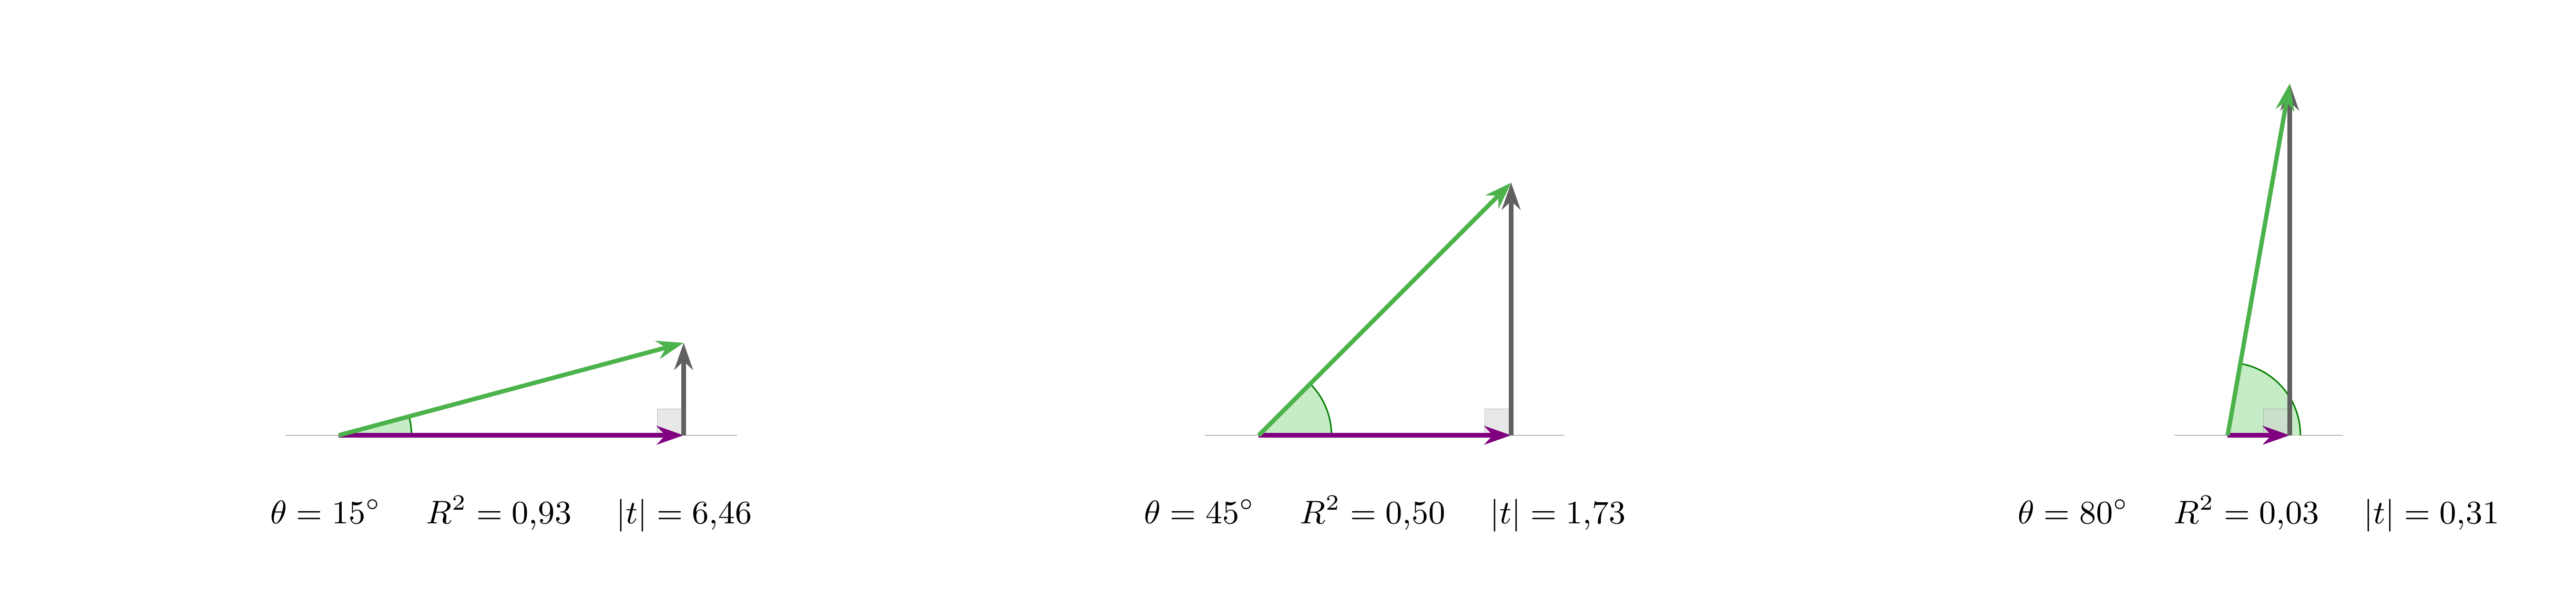
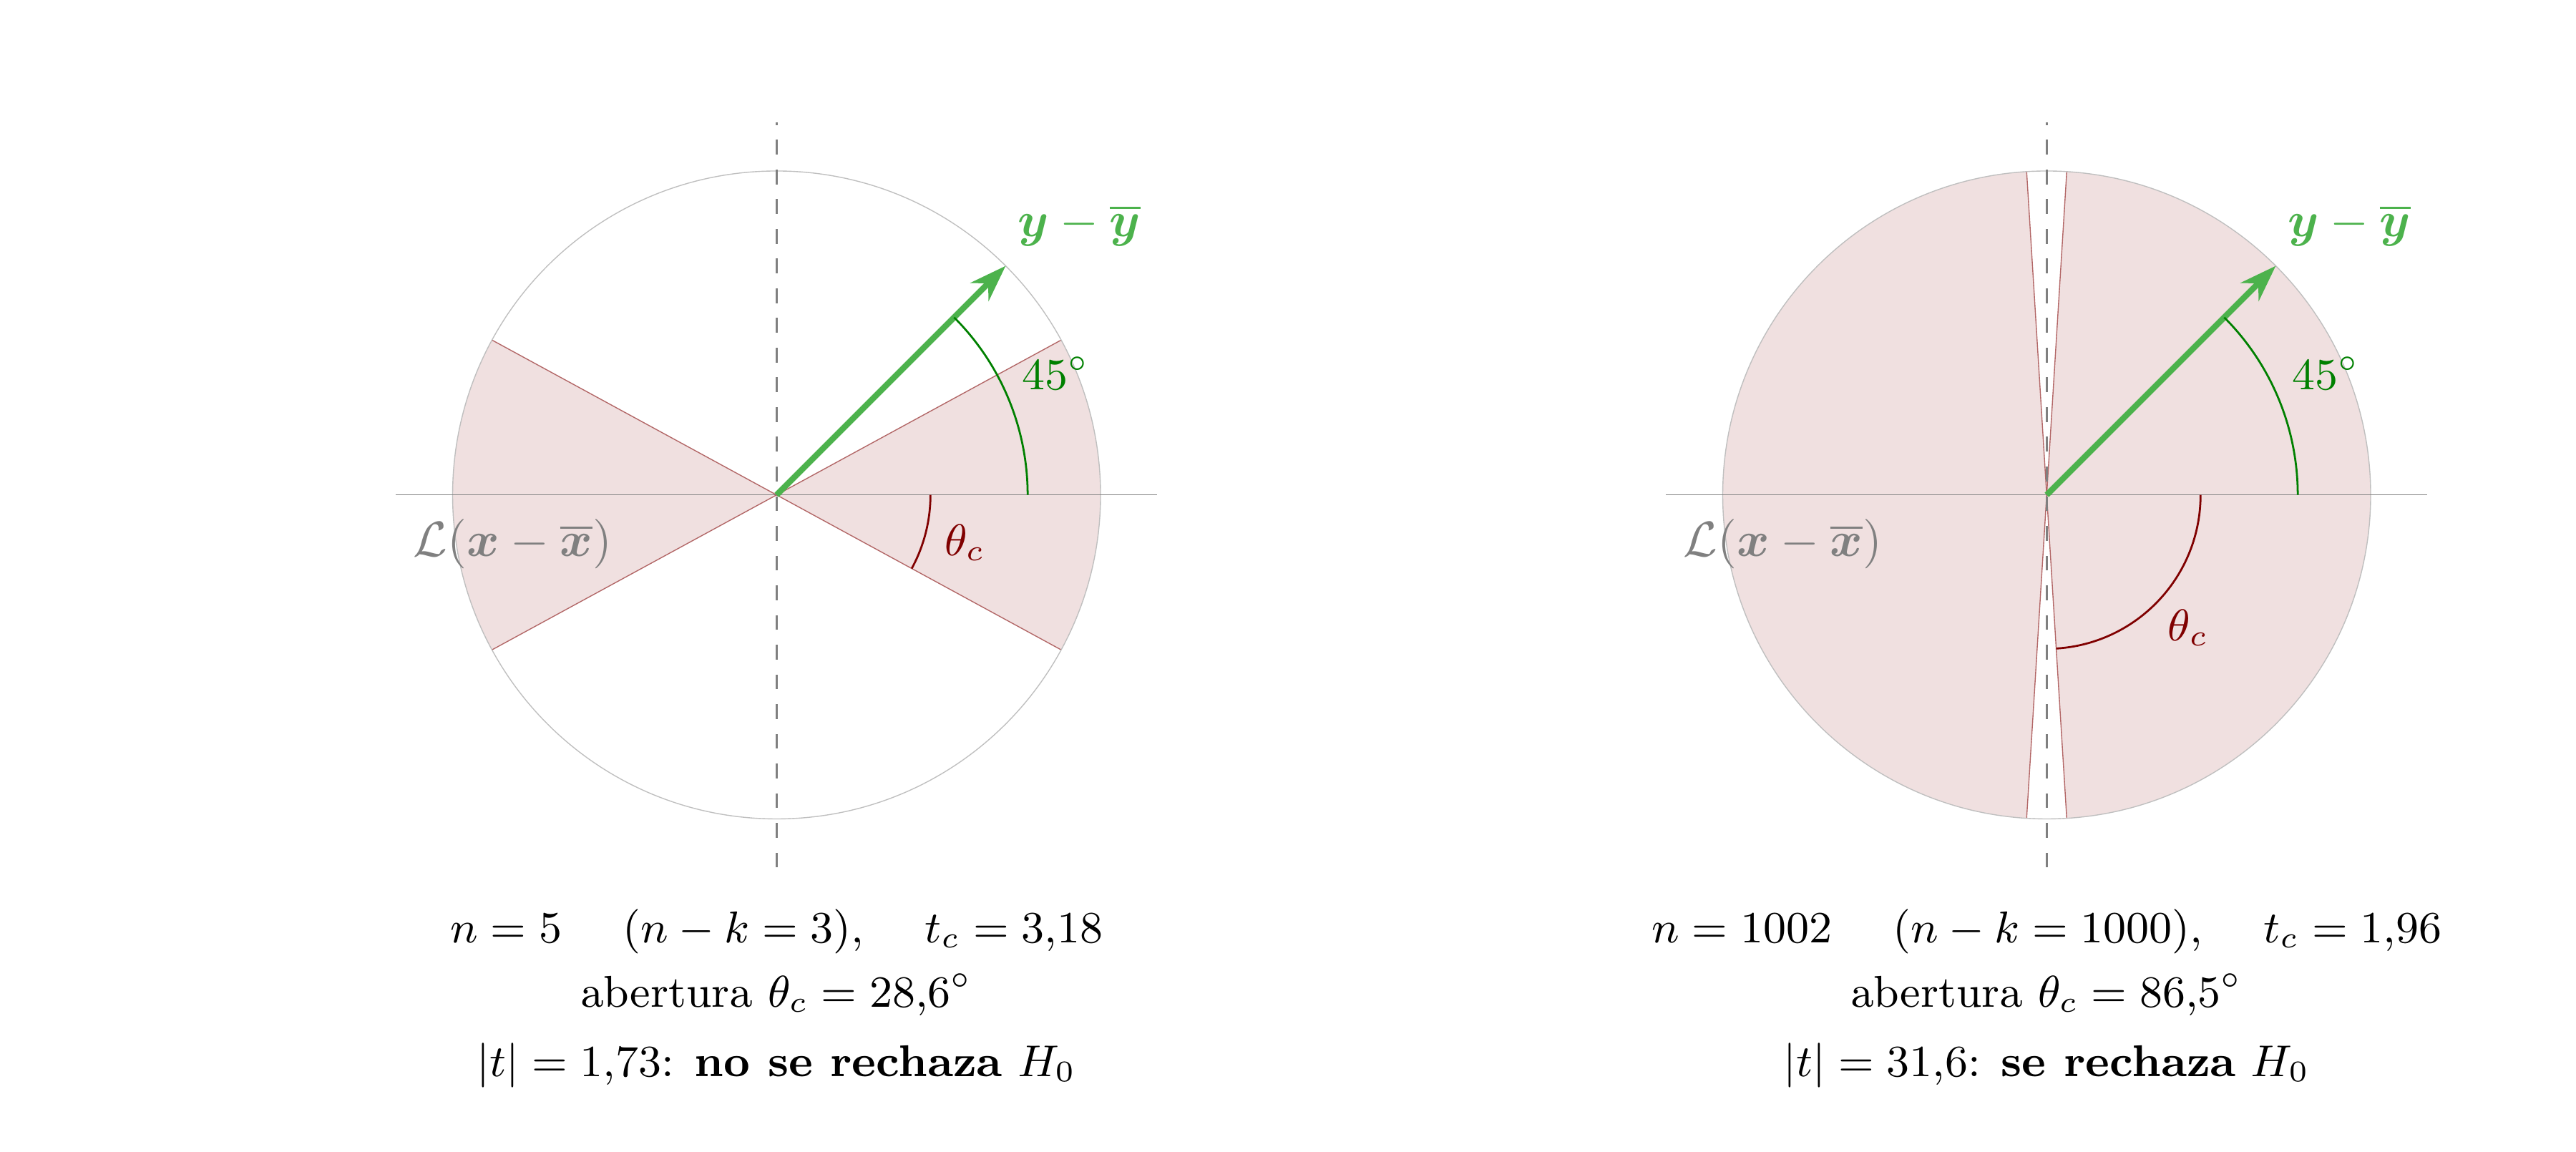
Un ángulo pequeño señala una posible relación; cómo de pequeño ha de ser para rechazar $H_0$ depende de $n$, porque con pocas observaciones el azar también produce ángulos pequeños: en $\mathbb{R}^2$ todo par de vectores en desviaciones está alineado ($R^2=1$ siempre, $n-k=0$) y ni el ángulo cero dice nada. En $\mathbb{R}^n$ con $n$ grande, un vector tomado al azar forma, con probabilidad alta, un ángulo próximo a $90^\circ$ con cualquier dirección fija. Por eso el mismo ángulo de $45^\circ$ es corriente bajo $H_0$ con $n=5$ y muy raro con $n=500$.
La región crítica es un cono alrededor de $\mathcal L(\boldsymbol x-\boldsymbol{\mathop{\overline x}})$ cuya abertura fija $t_c$: $28{,}6^\circ$ con $n-k=3$, $86{,}5^\circ$ con $n-k=1000$. El mismo vector a $45^\circ$ queda fuera con $n=5$ y dentro con $n=1002$.
El intervalo de confianza
Un rango de valores de $\beta_2$ que el contraste no rechaza, en vez de un veredicto: $$ \boxed{\;\Big[\;\hat\beta_2-t_c\cdot\mathrm{ee}(\hat\beta_2)\;,\;\;\hat\beta_2+t_c\cdot\mathrm{ee}(\hat\beta_2)\;\Big]\;} $$ con el mismo $t_c$ del contraste; semiamplitud $t_c\cdot\mathfrak s/\|\boldsymbol x-\boldsymbol{\mathop{\overline x}}\|_e$.
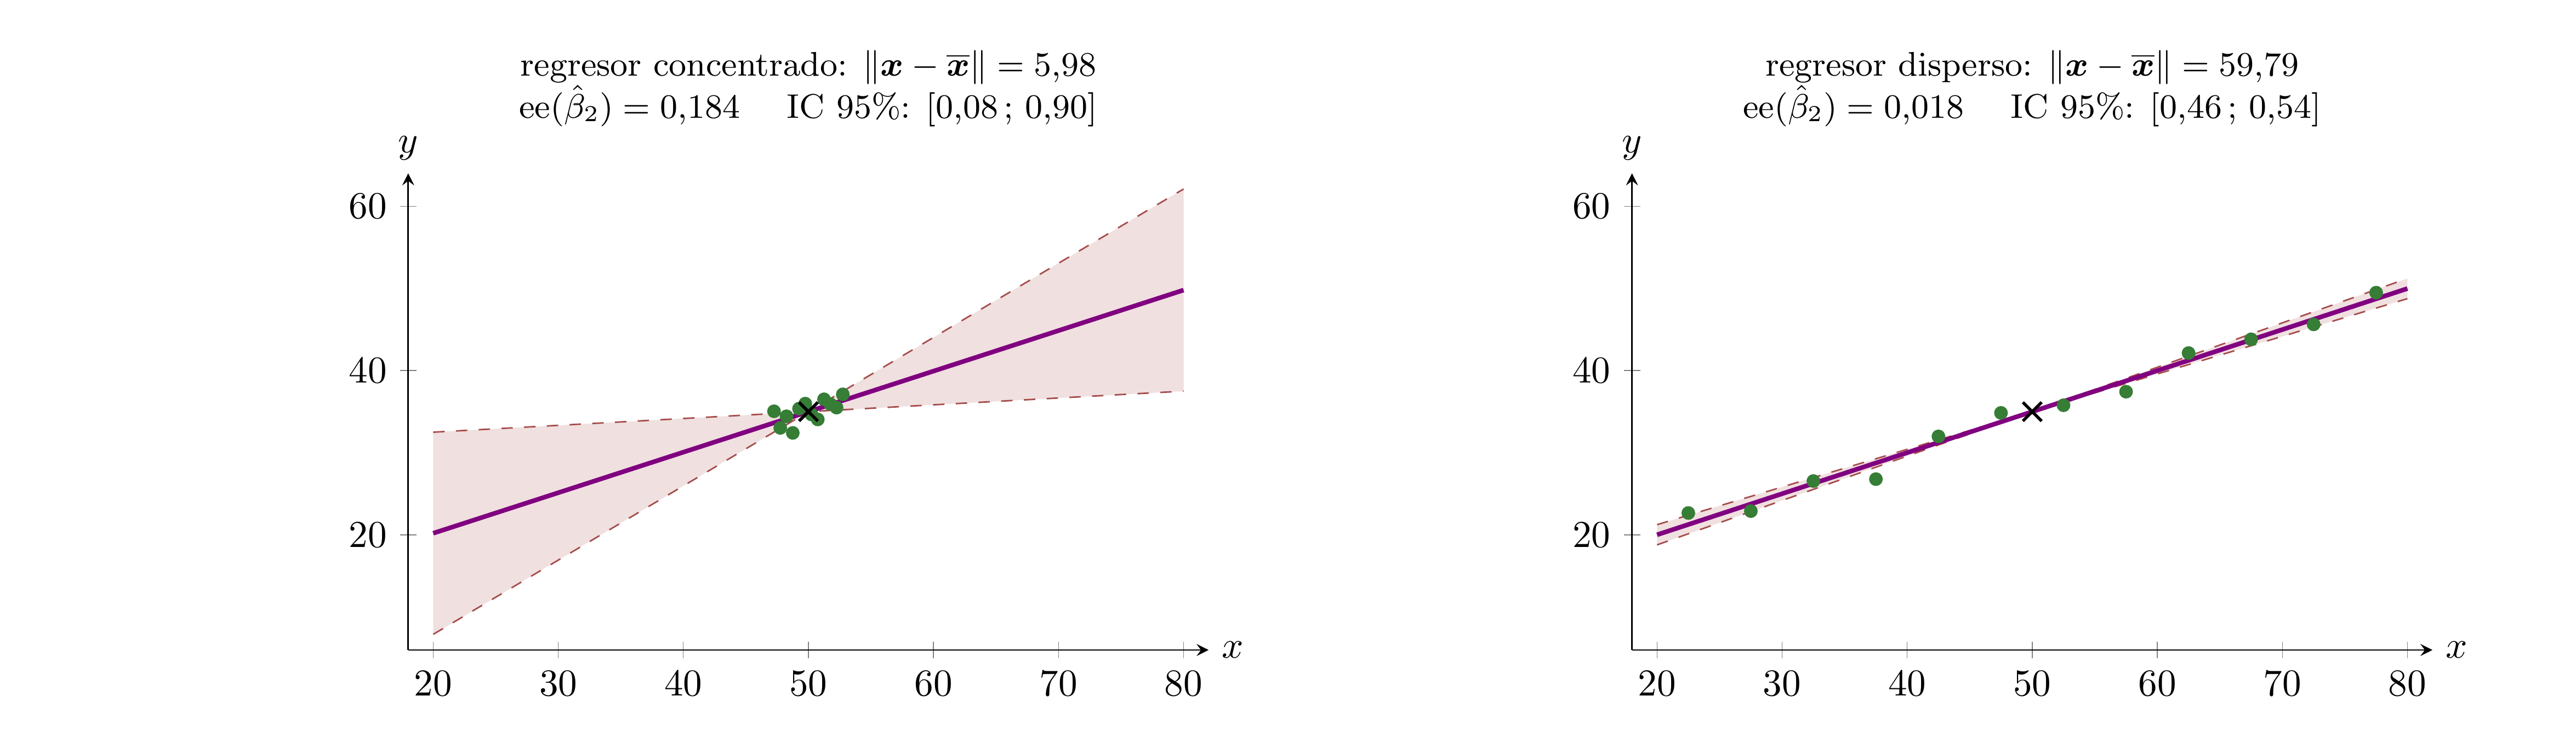
Dice: los extremos del intervalo son variables aleatorias, y el suceso ``el intervalo contiene a $\beta_2$'' tiene probabilidad $0{,}95$. No dice: que $\beta_2$ esté en este intervalo con probabilidad $0{,}95$; $\beta_2$ no es aleatorio, y estos dos extremos, ya calculados, tampoco.
Cómo se lee una tabla de resultados
Toda salida de estimación, de Gretl o de otro programa, tiene para cada regresor las mismas cuatro columnas; los rótulos son los de Gretl en español:
| Columna | Qué es | A qué pregunta responde |
|---|---|---|
| Coeficiente | $\hat\beta_j$ | ¿de qué tamaño es el efecto del regresor $x_j$ sobre el regresando $y$, en las unidades del problema? |
| Desv. típica | $\mathrm{ee}(\hat\beta_j)$ | ¿con cuánta precisión lo hemos medido? |
| Estadístico $t$ | el cociente de las dos anteriores | ¿a cuántos errores estándar del cero está? |
| Valor $p$ | $\mathrm{P}\big(\vert t_{n-k}\vert>\vert t\vert\big)$ | ¿cuán raro sería esto si el efecto fuese nulo? |
Las dos últimas se reconstruyen a partir de las dos primeras: $t$ = coeficiente $/$ error estándar, y el valor $p$ es una probabilidad calculada con $t$.
Aviso terminológico: en la salida en español de Gretl, ``desviación típica'' rotula tres cantidades distintas: la de la variable dependiente (dispersión de los datos), la de la regresión ($\mathfrak s$) y la de cada coeficiente (su error estándar). En inglés solo la primera es standard deviation; las otras dos son standard error.
Significación estadística $\neq$ relevancia económica
La identidad de la sección ``Lectura geométrica: la razón de catetos'' lo explica: $|t|$ mezcla fuerza de la relación con tamaño de la muestra. Tres casos inventados, calculados con la fórmula:
| $n$ | $R^2$ | $\theta$ | $\vert t\vert$ | Veredicto al $5\,\%$ |
|---|---|---|---|---|
| 3 | 0,90 | $18{,}4^\circ$ | 3,00 | no significativo ($t_c=12{,}71$) |
| 5 | 0,90 | $18{,}4^\circ$ | 5,20 | significativo ($t_c=3{,}18$) |
| 1002 | 0,01 | $84{,}3^\circ$ | 3,18 | significativo ($t_c=1{,}96$) |
Mismo ángulo, veredicto opuesto (filas 1 y 2). Y un ángulo de $84^\circ$ (casi ortogonal, $R^2$ del $1\,\%$) resulta significativo con mil observaciones (fila 3).
La significación dice si el efecto es distinguible de cero, no si es grande. Para juzgar si es grande hay que mirar el coeficiente en las unidades del problema, el intervalo de confianza y el $R^2$, no el $|t|$.
Y tres avisos más: ``no rechazar'' no es ``aceptar''; el valor $p$ no es la probabilidad de que $H_0$ sea cierta; y nada de todo esto establece causalidad.
Recapitulación y guiño a las sesiones siguientes
| Pieza | Fórmula | Lectura geométrica |
|---|---|---|
| Error estándar | $\mathfrak s/\Vert\boldsymbol x-\boldsymbol{\mathop{\overline x}}\Vert_e$ | longitud del residuo por unidad de longitud del regresor |
| Estadístico $t$ | $\hat\beta_2/\mathrm{ee}(\hat\beta_2)$ | $\sqrt{n-k}\times$ razón de catetos |
| Grados de libertad | $n-k$ | dimensión del subespacio del residuo: coordenadas de la perturbación en $\mathfrak s^2$ |
| Región crítica | $t$ fuera de $[-t_c,t_c]$, es decir, $\vert t\vert>t_c$ | cono alrededor de la dirección del regresor |
| Intervalo de confianza | $\hat\beta_2\pm t_c\cdot\mathrm{ee}(\hat\beta_2)$ | haz de pendientes no rechazadas |
Un solo supuesto nuevo (normalidad); todo lo demás venía de las lecciones 8 y 11.
Lección 13: la misma fórmula, $\frac{\mathrm{SEC}/(k-1)}{\mathrm{SRC}/(n-k)}$, con $k>2$ es el contraste $F$, que juzga varios regresores a la vez. Con $k=2$, $F=t^2$.
Más adelante: con $k$ regresores, $\mathrm{ee}(\hat\beta_j)=\mathfrak s/\|\tilde{\boldsymbol x}_j\|_e$, donde $\|\tilde{\boldsymbol x}_j\|_e$ es la longitud propia del regresor $j$: lo que le queda tras descontar lo que comparte con los demás. Colinealidad.