Lección 12. Inferencia: error estándar, intervalo de confianza y contraste \(t\)
Índice
- 1. De dónde venimos: nos falta la forma
- 2. El supuesto nuevo: normalidad
- 3. El error estándar, y el precio de estimar \(\sigma\)
- 4. El contraste \(t\)
- 5. Lectura geométrica: la razón de catetos
- 6. Por qué el valor crítico depende de \(n-k\)
- 7. El intervalo de confianza
- 8. Cómo se lee una tabla de resultados
- 9. Significación estadística \(\neq\) relevancia económica
- 10. Recapitulación y guiño a las sesiones siguientes
- 11. Preguntas de repaso (sesión 17) htmlonly
- 12. Respuestas htmlonly
La lección 11 dejó a \(\hat\beta_2\) bien centrado y con una varianza conocida, pero le faltaba lo esencial para contrastar hipótesis: la forma de su distribución. Hoy la obtenemos suponiendo normalidad de la perturbación.
Con ella construimos el error estándar, el intervalo de confianza y el contraste \(t\), que no mide nada que el \(R^2\) no midiera ya, y aprendemos a leer una tabla de resultados.
``Significativo'' no quiere decir ``grande'', ni ``importante'', ni ``verdadero''.
1. De dónde venimos: nos falta la forma
De la lección 11 nos traemos dos resultados sobre el modelo lineal simple (\(k=2\): la constante \(\mathit1\) y un único regresor no constante \(X\)): \[ \mathrm{E}(\hat\beta_2)=\beta_2, \qquad Var[\hat\beta_2\mid\boldsymbol X]=\frac{\sigma^2}{\sum_i(X_i-\overline{X})^2}=\frac{\sigma^2}{nS^2}. \]
Y nos traemos también una limitación reconocida en voz alta: eso no basta para responder a
- si \(\beta_2\) valiese cero, ¿serían datos como estos demasiado raros?
- ¿en qué rango de valores puedo confiar razonablemente que está \(\beta_2\)?
Saber dónde está centrada una distribución y cuánto se dispersa no permite responder a esas preguntas: necesitamos la forma de la distribución de probabilidad.
Hoy: un supuesto nuevo, tres herramientas (error estándar, intervalo, contraste) y, sobre todo, aprender a leerlas.
De dónde venimos: nos falta la forma
La lección 11 terminó reconociendo un límite. Allí demostramos que \(\hat\beta_2\) está bien centrado en \(\beta_2\) (insesgadez) y calculamos exactamente cuánto se dispersa alrededor de ese centro (\(Var[\hat\beta_2\mid\boldsymbol X]\)). Con esas dos cantidades sabemos mucho, pero desconocemos aquello que permite hacer inferencia: cuánta probabilidad acumula la distribución de \(\hat\beta_2\) a partir de un valor dado.
Un ejemplo elemental lo deja claro. Imagine dos variables aleatorias con la misma esperanza, \(0\), y la misma varianza, \(1\). La primera es normal estándar; la segunda toma solo los valores \(-1\) y \(+1\), con probabilidad \(1/2\) cada uno. Ambas tienen idénticos los dos primeros momentos, y sin embargo la probabilidad de superar el valor \(1{,}5\) es de aproximadamente \(0{,}067\) en la primera y exactamente \(0\) en la segunda. Esperanza y varianza no determinan la distribución; y las preguntas de la inferencia, como ``¿cuán raro sería observar una estimación tan alejada de cero como la que tengo delante, si en realidad \(\beta_2\) fuese cero?'', son preguntas sobre probabilidades de colas, no sobre momentos.
La lección 11 ya nos dio la pieza que hoy resultará decisiva. Allí escribimos \(\hat\beta_2=\beta_2\,\mathit1+\sum_iW_iU_i\), y esa descomposición no era un paso intermedio prescindible: dice que el error de estimación \(\hat\beta_2-\beta_2\,\mathit1\) es una suma ponderada de las perturbaciones. Si supiéramos qué forma tiene la distribución de las \(U_i\), sabríamos qué forma tiene la de \(\hat\beta_2\) condicionada a \(\boldsymbol X\). Eso es lo que vamos a hacer: suponer una forma para \(U\) y leer la consecuencia.
Sobre el reparto de la sesión: primero se construye el aparato (el supuesto, el error estándar y el contraste), después se traduce a geometría (la razón de catetos y los grados de libertad) y por último se interpreta (el intervalo, la tabla de resultados y la significación). Esa última parte es la que usará cada vez que lea un cuadro de resultados.
Para profundizar: Wooldridge, J. M. (2020), cap. 4, introducción y sección 4.1 (por qué la distribución muestral, y no solo sus momentos, es lo que hace falta para contrastar hipótesis).
2. El supuesto nuevo: normalidad
Condicionada a \(\boldsymbol X\), cada perturbación \(U_i\) es normal de esperanza \(0\) y varianza \(\sigma^2\).
La descomposición de la lección 11 basta: \[ \hat\beta_2=\beta_2\,\mathit1+\sum_iW_iU_i. \] Los \(W_i\) son funciones de \(\boldsymbol X\); por el Lema de la lección 11 salen fuera de todo momento condicionado, y la suma ponderada hereda la normalidad de las \(U_i\) (como una combinación lineal de normales independientes):
\[ \boxed{\;\hat\beta_2\;\Big|\;\boldsymbol X\;\sim\; N\Big(\beta_2,\;\frac{\sigma^2}{\sum_i(X_i-\overline X)^2}\Big).\;} \] Lo nuevo es el símbolo ``\(N\)''; y es un supuesto genuino: el laboratorio anterior (actividad 1 (html)) mostró que insesgadez y varianza no la necesitan.
Geométricamente: la normalidad hace el ruido isótropo: sus coordenadas en cualquier base ortonormal son independientes y con la misma distribución.
El supuesto nuevo: normalidad
El Modelo Clásico de Regresión Lineal de la lección 9 constaba de tres supuestos (linealidad, independencia lineal de los regresores y homocedasticidad), a los que la lección 11 añadió el muestreo aleatorio. Hoy incorporamos un supuesto más, la normalidad de la perturbación, y conviene decir qué añade y qué no. Formalmente, suponemos que, condicionada a la matriz aleatoria de regresores \(\boldsymbol X\), cada \(U_i\) tiene distribución normal: \[ U_i\;\Big|\;\boldsymbol X\;\sim\;N(0,\sigma^2), \qquad i=1,\ldots,n. \] Hasta ahora solo hemos condicionado momentos: una esperanza y una varianza. Una distribución es más que sus momentos, así que conviene decir qué significa aquí ``condicionada a \(\boldsymbol X\)''. La lección 9 nos dio la herramienta: condicionar en \(\boldsymbol X\) es proyectar sobre el espacio de las funciones de \(\boldsymbol X\). Falta elegir qué proyectar. La distribución de \(U_i\) queda descrita por las probabilidades \(\mathrm{P}(U_i\leq u)\), una para cada número \(u\). Para escribirlas como esperanzas usamos la indicadora de un suceso \(A\): la variable aleatoria \(\mathbb 1_A\) que vale \(1\) en los sucesos elementales de \(A\) y \(0\) en los demás, es decir, \(\mathbb 1_A(\omega)=1\) si \(\omega\in A\) y \(\mathbb 1_A(\omega)=0\) si \(\omega\notin A\). Su esperanza es la probabilidad del suceso, \(\mathrm{E}(\mathbb 1_A)=1\cdot\mathrm P(A)+0\cdot\mathrm P(A^c)=\mathrm P(A)\). Fíjese que la variable constante \(\mathit1\) de la lección 9 es la indicadora del suceso seguro, \(\mathit1=\mathbb 1_\Omega\). Así, \[ \mathrm{P}(U_i\leq u)=\mathrm{E}\big(\mathbb 1_{\{U_i\leq u\}}\big), \] es el escalar de la proyección de la indicadora sobre \(\mathit1\). Condicionar es sustituir la recta \(\mathcal L(\mathit1)\) por el espacio de las funciones de \(\boldsymbol X\): \[ P[U_i\leq u\mid\boldsymbol X]=E\big[\mathbb 1_{\{U_i\leq u\}}\mid\boldsymbol X\big]. \] El resultado es una función de \(\boldsymbol X\): la sombra de la indicadora sobre ese espacio. Como toda esperanza condicional, \(P[\cdot\mid\boldsymbol X]\) es una variable aleatoria, no un número; el número \(\mathrm P(A)\) se recupera por la ley de las esperanzas iteradas, \(\mathrm P(A)=\mathrm E\big(P[A\mid\boldsymbol X]\big)\). Dos comprobaciones justifican llamarla probabilidad. Si \(A\) y \(B\) son incompatibles, \(\mathbb 1_{A\cup B}=\mathbb 1_A+\mathbb 1_B\) (en cada \(\omega\) a lo sumo una de las dos vale \(1\)); como la proyección es lineal, \(P[A\cup B\mid\boldsymbol X]=P[A\mid\boldsymbol X]+P[B\mid\boldsymbol X]\): las sombras de dos sucesos incompatibles se suman, como sus probabilidades. Y la indicadora del suceso seguro, \(\mathit1\), ya es una función de \(\boldsymbol X\) (la constante), así que su sombra es ella misma: \(P[\Omega\mid\boldsymbol X]=E[\mathit1\mid\boldsymbol X]=\mathit1\), cuya esperanza es el número \(\mathrm P(\Omega)=1\).
El supuesto de normalidad dice dos cosas. La primera es que, para todo \(u\), la sombra \(P[U_i\leq u\mid\boldsymbol X]\) es una variable aleatoria constante: la distribución de \(U_i\) no depende de \(\boldsymbol X\). Eso no es exclusivo de la normal; lo diría igualmente suponer cualquier otra distribución fija, una uniforme por ejemplo. La segunda fija cuáles son esas constantes: \[ P[U_i\leq u\mid\boldsymbol X]=\Phi(u/\sigma)\,\mathit1, \] donde \(\Phi\) es la función de distribución de la normal estándar. El argumento es \(u\) medido en desviaciones típicas: como \(U_i/\sigma\) es normal estándar, \(\mathrm P(U_i\le u)=\mathrm P(U_i/\sigma\le u/\sigma)=\Phi(u/\sigma)\). Es decir: para cada \(u\), \(P[U_i\le u\mid\boldsymbol X]\) es una variable aleatoria constante, y por la ley de las esperanzas iteradas (lección 11) esa constante es la probabilidad sin condicionar, \(\mathrm P(U_i\le u)=\Phi(u/\sigma)\). Condicionar en los regresores no cambia la probabilidad de ningún suceso \(\{U_i\le u\}\): la distribución de \(U_i\) es la misma sea cual sea \(\boldsymbol X\), y el supuesto de hoy dice que dicha distribución es la \(N(0,\sigma^2)\). Que todas las sombras sean constantes es, de hecho, la definición de que \(U_i\) sea independiente de \(\boldsymbol X\) leída con proyecciones (apéndice, secciones 1.4 (html) y 1.5). Los dos supuestos que ya teníamos siguen el mismo patrón: \(E[U_i\mid\boldsymbol X]=\mathit0\) y \(E[U_i^2\mid\boldsymbol X]=\sigma^2\,\mathit1\) dicen que dos funciones concretas de \(U_i\) tienen sombra constante. Hoy lo pedimos para todas las indicadoras a la vez y fijamos qué constantes son mediante la función de distribución \(\Phi(u/\sigma)\).
Obsérvese que este supuesto no cambia ninguno de los momentos que ya teníamos: la esperanza condicional sigue siendo \(E[U_i\mid\boldsymbol X]=\mathit0\) y la varianza condicional sigue siendo \(Var[U_i\mid\boldsymbol X]=\sigma^2\,\mathit1\), exactamente como en la lección 11. Lo único que añade es de qué forma se reparte la probabilidad alrededor de ese valor esperado, con esa varianza.1
De aquí a la distribución de \(\hat\beta_2\) no hace falta ninguna cuenta nueva: basta releer lo que ya escribimos en la lección 11. Allí obtuvimos, por álgebra pura y sin tomar esperanzas, \[ \hat\beta_2=\beta_2\,\mathit1+\sum_iW_iU_i, \qquad\text{con}\qquad W_i=\frac{X_i-\overline X}{\sum_j(X_j-\overline X)^2}. \] Los pesos \(W_i\) son funciones de \(\boldsymbol X\). Como advertimos en la lección 11, condicionar en \(\boldsymbol X\) no los convierte en números: siguen siendo variables aleatorias (funciones de \(\omega\)) antes y después de condicionar. Lo que ocurre es que el Lema de aquella lección los saca fuera del operador \(E[\,\cdot\mid\boldsymbol X]\). Ya lo hicimos con la media y con la varianza: \[ E[\sum_iW_iU_i\mid\boldsymbol X]=\sum_iW_i\,E[U_i\mid\boldsymbol X]\quad\text{y}\quad Var[\sum_iW_iU_i\mid\boldsymbol X]=\sum_i\sum_jW_iW_j\,E[U_iU_j\mid\boldsymbol X]. \] Para la distribución hace falta lo mismo, pero para todas las indicadoras a la vez: que los \(W_i\) se comporten como números también dentro de \(E\big[\mathbb 1_{\{\sum_iW_iU_i\le u\}}\mid\boldsymbol X\big]\). Es así, por la misma razón que el Lema: los \(W_i\) son funciones de \(\boldsymbol X\), y las \(U_i\) son independientes de \(\boldsymbol X\) (todas sus sombras son constantes, como acabamos de ver) e independientes entre sí (muestreo aleatorio, lección 11). Aceptado eso, lo que queda es un resultado de su curso de probabilidad, que no demostraremos: una combinación lineal de normales independientes con coeficientes numéricos es normal (es la propiedad de la normal que el apéndice (html) enuncia en la sección 8, y de la que en la sección 9 sale esta distribución y, después, la \(t\)). Por tanto, condicionando en \(\boldsymbol X\), \(\sum_iW_iU_i\) es normal, y \(\hat\beta_2\) también, con el valor esperado y la varianza que ya calculamos en la lección 11: \[ \hat\beta_2\;\Big|\;\boldsymbol X\;\sim\; N\Big(\beta_2,\;\frac{\sigma^2}{\sum_i(X_i-\overline X)^2}\Big). \] Esta expresión es una afirmación sobre la distribución condicional en el sentido precisado más arriba: para cada \(u\), \[ P[\hat\beta_2\leq u\mid\boldsymbol X]=\Phi\!\left(\frac{u-\beta_2}{\sigma\big/\sqrt{\sum_i(X_i-\overline X)^2}}\right). \] Esta sombra es una función de \(\boldsymbol X\) y, a diferencia de lo que ocurría con las \(U_i\), no es constante. La forma de la distribución de \(\hat\beta_2\) depende de los regresores a través de su varianza condicional \(\sigma^2/\sum_i(X_i-\overline X)^2\), que es una variable aleatoria, función de \(\boldsymbol X\), como en la lección 11. En la transparencia siguiente evaluaremos esa varianza sobre los datos observados \(\boldsymbol x\) y obtendremos un número: es el paso de estimador a estimación de la lección 11. La aleatoriedad que cuenta aquí es la de la perturbación, con los regresores en el papel de aquello sobre lo que se proyecta.
La normalidad es un supuesto añadido, no una consecuencia de los anteriores, y el laboratorio anterior lo mostró (actividad 1 (html) y actividad 2 (html) de la práctica C de la sesión 16). Allí se repitió el experimento de Monte Carlo con perturbaciones uniformes y con perturbaciones \(\chi^2\) centradas, claramente no normales, y el resultado fue que la media de las estimaciones seguía cayendo sobre \(\beta_2\) y su varianza empírica seguía coincidiendo con la fórmula de la lección 11. No podía ser de otro modo: aquella demostración nunca usó la normalidad. Lo que sí cambiaba era la forma del histograma. Y cambiaba de una manera instructiva: con \(n=506\) el histograma parecía normal aunque \(U\) no lo fuese; con \(n=12\) y una \(\chi^2\) de un grado de libertad el contraste de normalidad rechazaba, y cuando una observación dominaba el regresor el histograma heredaba la asimetría de \(U\). Volveremos sobre esa dependencia del tamaño muestral al final de la sesión, porque es la razón por la que la inferencia que hoy construimos sigue siendo aproximadamente válida en muestras grandes incluso cuando la normalidad falla.
Queda la lectura geométrica, que es la que conecta este supuesto con el resto del curso, y conviene hacerla con cuidado, porque la geometría de \(\mathbb R^n\) es de los datos y no de las perturbaciones. Tomemos una base ortonormal de \(\mathcal L(\boldsymbol 1)^\perp\) construida con los regresores (por ejemplo, ortogonalizando, como en la práctica D de la sesión 14), y la fórmula que da las coordenadas de un vector en esa base. Evaluada sobre las perturbaciones centradas \((U_1-\overline U,\ldots,U_n-\overline U)\), como la lección 11 evaluó la fórmula de \(\hat\beta_2\), esa fórmula define \(n-1\) variables aleatorias: las coordenadas del ruido. Con lo que ya teníamos, homocedasticidad e incorrelación, se demuestra que son ortogonales entre sí y de la misma longitud \(\sigma\) (apéndice, Resultado 1 (html)). Lo que la normalidad añade es más: que son independientes y con la misma distribución \(N(0,\sigma^2)\), sea cual sea la base ortonormal elegida (apéndice, Resultado 3 (html)). A eso llamamos isotropía,2 ninguna dirección se distingue de otra, porque las coordenadas del ruido son intercambiables. Sin normalidad la primera propiedad se mantiene y la segunda no: con perturbaciones uniformes independientes las coordenadas siguen siendo ortogonales y de la misma longitud, pero no son independientes ni tienen la misma distribución (sus realizaciones llenan un cubo, que tiene direcciones privilegiadas, sus diagonales). La demostración de las dos propiedades está en el apéndice (secciones 7 (html) y 8); aquí basta con saber que la isotropía es lo que hace que, en la sección ``Por qué el valor crítico depende de \(n-k\)'', tenga sentido hablar de la distribución del ángulo.
Para profundizar: Wooldridge, J. M. (2020), cap. 4, sección 4.1 (supuesto MLR.6 de normalidad y distribuciones muestrales normales de los estimadores MCO).
3. El error estándar, y el precio de estimar \(\sigma\)
Esa varianza contiene \(\sigma^2\), que no conocemos: la estimamos con la cuasivarianza de los residuos (lección 11), \(\mathfrak s^2=\mathrm{SRC}/(n-k)\).
Sustituyendo \(\sigma\) por \(\mathfrak s\) sobre los datos observados, el error estándar de \(\hat\beta_2\): \[ \boxed{\;\mathrm{ee}(\hat\beta_2)=\frac{\mathfrak s}{\sqrt{\sum_i(x_i-\mu_{\boldsymbol x})^2}} =\frac{\mathfrak s}{\|\boldsymbol x-\boldsymbol{\mathop{\overline x}}\|_e}.\;} \]
Un cociente de longitudes: longitud del ruido estimado por unidad de longitud del regresor en desviaciones.
El precio de estimar \(\sigma\): la normal se convierte en una \(t\) de Student con \(n-k\) grados de libertad (enunciado; demostración en el apéndice): \[ \frac{\hat\beta_2-\beta_2}{\mathrm{ee}(\hat\beta_2)}\;\sim\;t_{n-k}. \]
El error estándar, y el precio de estimar \(\sigma\)
La varianza de \(\hat\beta_2\) que aparece en la distribución de ``El supuesto nuevo: normalidad'', \(\sigma^2/\sum_i(X_i-\overline X)^2\), tiene un problema práctico evidente: contiene \(\sigma^2\), la varianza de la perturbación poblacional, que es desconocida, como toda cantidad poblacional. La lección 11 ya nos dejó resuelto ese punto: \(\sigma^2\) se estima mediante la cuasivarianza de los residuos, \(\mathfrak s^2=\mathrm{SRC}/(n-k)\), usando el tercer miembro de la familia de productos escalares del curso, el de divisor \(n-k\). Recordemos que ese divisor no era arbitrario: los residuos viven en el subespacio ortogonal a las columnas de \(\boldsymbol{\mathsf X}\), de dimensión \(n-k\), y dividir por esa dimensión es lo que hace insesgado al estimador.
Sustituyendo \(\sigma\) por \(\mathfrak s\) en la raíz cuadrada de la varianza, y aplicando la expresión sobre los datos observados en lugar de sobre la muestra aleatoria, obtenemos el error estándar de \(\hat\beta_2\): \[ \mathrm{ee}(\hat\beta_2)=\frac{\mathfrak s}{\sqrt{\sum_i(x_i-\mu_{\boldsymbol x})^2}} =\frac{\mathfrak s}{\|\boldsymbol x-\boldsymbol{\mathop{\overline x}}\|_e}. \] La notación merece un comentario, porque el término ``error estándar'' es una de las fuentes de confusión más frecuentes al leer resultados. Un error estándar mide la dispersión de un estimador: cuánto variaría el número que hemos calculado si volviéramos a tomar otra muestra. No mide la dispersión de unos datos. Y el objeto que acabamos de escribir es un número: se calcula con los datos que tenemos. Es la realización de una variable aleatoria, la que resulta de evaluar esa misma fórmula sobre la muestra aleatoria. Es el mismo abuso de lenguaje, cómodo y universal, que ya hicimos en la lección 11 al llamar ``sesgado'' a \(\mathrm{SRC}/n\) e ``insesgado'' a \(\mathfrak s^2\): fórmulas escritas con los residuos observados, para hablar de propiedades que son del estimador subyacente.3
Escrito así, el error estándar es un cociente de dos longitudes, y esa es su lectura más útil. En el numerador, \(\mathfrak s=\sqrt{\langle\boldsymbol{\mathop{\widehat e}},\boldsymbol{\mathop{\widehat e}}\rangle_{n-k}}\) es la longitud del vector de residuos, medida con el producto escalar de divisor \(n-k\) de la lección 11; es lo que tenemos en lugar de \(\sigma\), la desviación típica de la perturbación. Llamaremos ruido a la perturbación, como ya hicimos en la lección 11 al leer la fórmula de la varianza, y longitud del ruido estimado a \(\mathfrak s\), que es la longitud del vector de residuos. En el denominador, \(\|\boldsymbol x-\boldsymbol{\mathop{\overline x}}\|_e\) mide cuánto se separa el regresor de su propia media: es, literalmente, la longitud euclídea del vector en desviaciones de la lección 4. Por tanto: el error estándar es la longitud del ruido estimado por unidad de longitud del regresor en desviaciones. Un regresor con mucha variación (un vector en desviaciones largo) permite estimar su coeficiente con precisión; un regresor cuyos valores apenas cambian dentro de la muestra (un vector en desviaciones corto), no, aunque \(\mathfrak s\) sea relativamente pequeño. Es la lectura geométrica de algo que en la lección 11 aparecía como ``más dispersión en \(X\), más precisión'', y la veremos dibujada en la transparencia del intervalo de confianza.
Queda el segundo asunto de esta transparencia, la distribución del cociente. Si conociéramos \(\sigma\), de la distribución normal de ``El supuesto nuevo: normalidad'' se seguiría inmediatamente que \[ \frac{\hat\beta_2-\beta_2}{\sqrt{\sigma^2/\sum_i(X_i-\overline X)^2}}\;\sim\;N(0,1), \] porque restar la esperanza y dividir por la desviación típica convierte cualquier normal en la normal estándar. Pero no conocemos \(\sigma\): en su lugar usamos \(\mathfrak s\). Y \(\mathfrak s\), como \(\hat\beta_2\), es la realización de un estimador: la variable aleatoria que resulta de evaluar \(\sqrt{\mathrm{SRC}/(n-k)}\) sobre la lista de residuos \((\hat E_1,\ldots,\hat E_n)\) de la lección 11, y que denotamos con el mismo símbolo. Al dividir por una cantidad que también fluctúa de muestra en muestra, el cociente resultante se dispersa más que una normal estándar: puede salir grande porque el numerador sea grande, pero también porque el denominador haya salido pequeño por azar. El resultado exacto es que ese cociente sigue una distribución conocida, la \(t\) de Student con \(n-k\) grados de libertad: \[ \frac{\hat\beta_2-\beta_2}{\mathrm{ee}(\hat\beta_2)}\;\sim\;t_{n-k}. \] La demostración está en el apéndice (secciones 8 (html) y 9); aquí basta con la idea: numerador y denominador son funciones de coordenadas del ruido distintas, la de la dirección del regresor y las \(n-k\) del residuo, y con normalidad esas coordenadas son independientes; eso, y nada más, es lo que convierte el cociente en una \(t_{n-k}\). La distribución \(t_{n-k}\) es simétrica y acampanada como la normal, pero con colas más gruesas, y tanto más gruesas cuanto menor sea \(n-k\); a medida que \(n-k\) crece, se acerca a la normal estándar hasta hacerse indistinguible de ella en la práctica (con \(n-k\) del orden de unas decenas, la diferencia ya es pequeña). El número de grados de libertad es \(n-k\), el mismo que aparecía en el divisor de \(\mathfrak s^2\). En la sección ``Por qué el valor crítico depende de \(n-k\)'' veremos su significado geométrico: es la dimensión del subespacio donde vive el residuo.
Nota de coherencia: en este curso, \(k\) cuenta todos los regresores, incluida la constante. Por eso los grados de libertad se escriben siempre \(n-k\) y nunca \(n-k-1\). En el modelo lineal simple de hoy, \(k=2\) y los grados de libertad son \(n-2\).
Para profundizar: Wooldridge, J. M. (2020), cap. 4, sección 4.2 (el estadístico \(t\) y su distribución); y cap. 3, sección 3.4 (errores estándar de los coeficientes).
4. El contraste \(t\)
Hipótesis nula: \(H_0\!:\beta_2=0\) (``el regresor no aporta nada''), frente a \(H_1\!:\beta_2\neq0\).
Estadístico (bajo \(H_0\), sustituyendo \(\beta_2=0\) en la transparencia anterior): \[ t=\frac{\hat\beta_2}{\mathrm{ee}(\hat\beta_2)}\;\sim\;t_{n-k}. \]
Decisión al nivel \(\alpha\) (habitualmente \(0{,}05\)): se rechaza \(H_0\) si \(\vert t\vert>t_c\), el valor crítico de la \(t_{n-k}\) que deja \(\alpha/2\) en cada cola.
Valor \(p\): probabilidad de un \(\vert t\vert\) al menos tan grande como el obtenido, si \(H_0\) fuese cierta. Se rechaza si es menor que \(\alpha\).
Nada obliga a contrastar contra cero: para \(H_0\!:\beta_2=c\) (p. ej. una elasticidad unitaria), \(\;t=(\hat\beta_2-c)/\mathrm{ee}(\hat\beta_2)\).
El contraste \(t\)
Con la distribución de ``El error estándar, y el precio de estimar \(\sigma\)'' en la mano, el contraste se construye sin ningún ingrediente nuevo. La hipótesis que se contrasta con más frecuencia es \(H_0\!:\beta_2=0\), que en términos del modelo poblacional dice que el regresor no interviene: si \(\beta_2=0\), entonces \(Y=\beta_1\,\mathit1+U\) (el regresor \(X\) no aparece). La alternativa habitual es \(H_1\!:\beta_2\neq0\), que no especifica ningún valor concreto y admite desviaciones en los dos sentidos (de ahí que el contraste se llame de dos colas).
El razonamiento es el de todo contraste de hipótesis, y conviene enunciarlo con cuidado porque es donde se cometen los errores de interpretación. Suponemos provisionalmente que \(H_0\) es cierta. Bajo ese supuesto, sustituyendo \(\beta_2=0\) en el resultado de ``El error estándar, y el precio de estimar \(\sigma\)'', sabemos exactamente cómo se distribuye el cociente \[ t=\frac{\hat\beta_2}{\mathrm{ee}(\hat\beta_2)}\;\sim\;t_{n-k}. \] Este cociente es la distancia entre la estimación y el valor \(0\), expresada en una unidad de medida nueva: el error estándar. Dividir una longitud por otra dice cuántas veces cabe la segunda en la primera (seis metros entre metro y medio son cuatro), de modo que \(t=3\) significa que \(\hat\beta_2\) dista de cero tres errores estándar. Con esa unidad, la pregunta ``¿está lejos de cero?'' ya no depende de las unidades de \(X\) e \(Y\): se compara con la imprecisión propia del estimador. Por eso \(t\) no cambia al cambiar las unidades, como veremos al leer la tabla de resultados. Si el valor que obtenemos con nuestros datos es de los que la \(t_{n-k}\) produce con facilidad, no hay nada que nos induzca a rechazar \(H_0\). Si es un valor que la \(t_{n-k}\) produciría muy raramente, tenemos un conflicto: o bien hemos tenido muy mala suerte, o bien el supuesto provisional era falso. El contraste opta por lo segundo, y al hacerlo acepta un riesgo cuantificado de equivocarse.
Ese riesgo es el nivel de significación \(\alpha\), la probabilidad de rechazar \(H_0\) siendo cierta, que se fija de antemano (por convención, \(\alpha=0{,}05\); también se usan \(0{,}10\) y \(0{,}01\)).4 Fijado \(\alpha\), el valor crítico \(t_c\) es el número que deja una probabilidad \(\alpha/2\) en cada cola de la \(t_{n-k}\), y la regla es: rechazar \(H_0\) si \(|t|>t_c\). El conjunto de valores que llevan a rechazar se llama región crítica. Nótese que \(t_c\) depende de dos cosas: del nivel \(\alpha\) que hayamos elegido y de los grados de libertad \(n-k\). Esta segunda dependencia tiene una lectura geométrica, y le dedicaremos una transparencia entera.
Una forma equivalente y, en la práctica, más informativa de presentar la misma decisión es el valor \(p\): la probabilidad de que la \(t_{n-k}\) produzca un valor tan alejado de cero, o más, que el \(t\) que hemos obtenido, siempre bajo el supuesto de que \(H_0\) es cierta. Con él, la regla de decisión se vuelve inmediata: se rechaza \(H_0\) si el valor \(p\) es menor que \(\alpha\). Su ventaja es que no obliga a comprometerse con un \(\alpha\) antes de mirar los datos y permite al lector aplicar el suyo: un valor \(p\) de \(0{,}048\) y otro de \(0{,}000001\) llevan ambos a ``rechazar al \(5\,\%\)'', pero no dicen lo mismo. Su inconveniente es que se malinterpreta con enorme facilidad, y a eso dedicaremos parte de la sección ``Significación estadística \(\neq\) relevancia económica''.
Conviene, por último, deshacer una asociación demasiado automática entre ``contraste \(t\)'' y ``contrastar contra cero''. El cero tiene un lugar privilegiado porque corresponde a la pregunta ``¿interviene este regresor?'', pero la construcción vale para cualquier valor de referencia: para contrastar \(H_0\!:\beta_2=c\) basta usar \[ t=\frac{\hat\beta_2-c}{\mathrm{ee}(\hat\beta_2)}, \] que bajo esa \(H_0\) sigue igualmente una \(t_{n-k}\). Y hay preguntas económicas que exigen precisamente eso. Si el modelo está escrito en logaritmos y \(\beta_2\) es una elasticidad (algo que veremos con detalle más adelante en el curso), la pregunta interesante rara vez es ``¿es la elasticidad distinta de cero?'' (casi siempre lo es), sino ``si fuese unitaria, ¿serían estos datos demasiado raros?'', es decir, \(H_0\!:\beta_2=1\). Del mismo modo, si la teoría predice un valor concreto, contrastar contra ese valor es lo que pone a prueba la teoría; contrastar contra cero, no.
Para profundizar: Wooldridge, J. M. (2020), cap. 4, secciones 4.2a-4.2e (contrastes de una y dos colas, valores críticos, valores \(p\), y contrastes de hipótesis con valores de referencia distintos de cero).
5. Lectura geométrica: la razón de catetos
Con \(\boldsymbol{\mathop{\widehat y}}-\boldsymbol{\mathop{\overline y}}=\hat\beta_2(\boldsymbol x-\boldsymbol{\mathop{\overline x}})\) y \(\mathfrak s^2=\mathrm{SRC}/(n-k)\), el estadístico queda: \[ \boxed{\;t^2=(n-k)\,\frac{\mathrm{SEC}}{\mathrm{SRC}}, \qquad\text{es decir}\qquad \vert t\vert=\sqrt{n-k}\;\frac{\|\boldsymbol{\mathop{\widehat y}}-\boldsymbol{\mathop{\overline y}}\|_e}{\|\boldsymbol{\mathop{\widehat e}}\|_e}.\;} \]
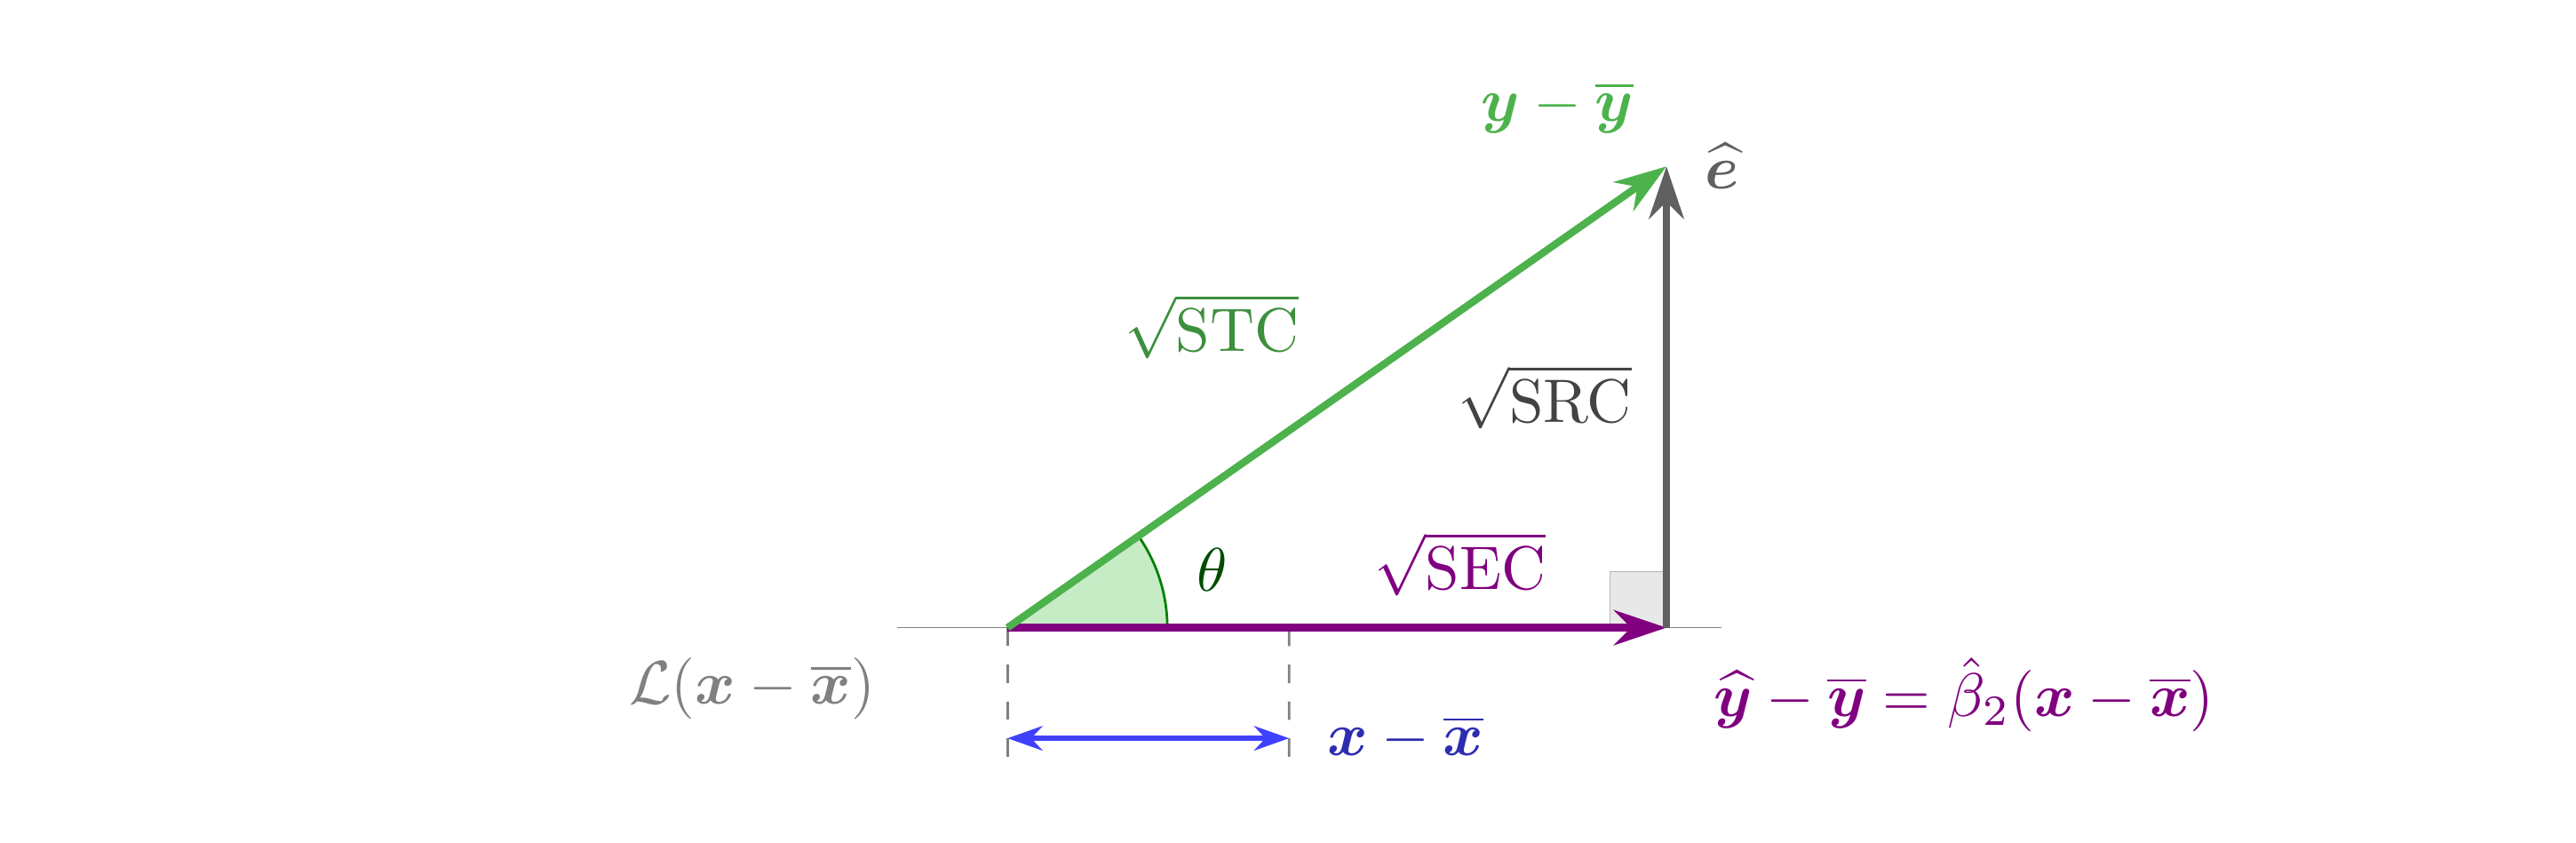
Figura 1: El triángulo rectángulo de la lección 8, con los dos catetos medidos. En verde, el vector de datos en desviaciones (la hipotenusa, de longitud \(\sqrt{\mathrm{STC}}\)); en violeta, el ajuste en desviaciones (el cateto explicado, de longitud \(\sqrt{\mathrm{SEC}}\)), rotulado a la derecha de su punta, que es un múltiplo del regresor en desviaciones (en azul, medido bajo el eje); en gris, el residuo (el cateto residual, de longitud \(\sqrt{\mathrm{SRC}}\)). El ángulo \(\theta=\measuredangle\big((\boldsymbol y-\boldsymbol{\mathop{\overline y}}),(\boldsymbol{\mathop{\widehat y}}-\boldsymbol{\mathop{\overline y}})\big)\) es el que corresponde a \(R^2=\cos^2\theta\). El estadístico \(t\) compara los dos catetos.
Y como \(\mathrm{STC}=\mathrm{SEC}+\mathrm{SRC}\), también \(t^2=(n-k)R^2/(1-R^2)\): el contraste \(t\) no mide nada que el \(R^2\) no midiera ya.
Lectura geométrica: la razón de catetos
Hasta aquí, la construcción del contraste ha sido puramente probabilística. Esta transparencia y la siguiente la traducen al lenguaje geométrico del curso: el estadístico \(t\) es un objeto que ya conocíamos desde la lección 8, mirado con otra escala.
Empecemos por la pieza que hace posible la traducción. En el modelo lineal simple, el ajuste es \(\boldsymbol{\mathop{\widehat y}}=\hat\beta_1\boldsymbol1+\hat\beta_2\boldsymbol x\), y sabemos desde la lección 7 que el ajuste y los datos tienen la misma media, \(\mu_{\boldsymbol{\mathop{\widehat y}}}=\mu_{\boldsymbol y}\). Recordando además la notación de la lección 4 (la barra sobre un vector denota el vector constante formado por su media, \(\boldsymbol{\mathop{\overline v}}=\mu_{\boldsymbol v}\boldsymbol1\)), y usando \(\mu_{\boldsymbol{\mathop{\widehat y}}}=\hat\beta_1+\hat\beta_2\mu_{\boldsymbol x}\), se obtiene \[ \boldsymbol{\mathop{\widehat y}}-\boldsymbol{\mathop{\overline y}} =\big(\hat\beta_1\boldsymbol1+\hat\beta_2\boldsymbol x\big)-\big(\hat\beta_1+\hat\beta_2\mu_{\boldsymbol x}\big)\boldsymbol 1 =\hat\beta_2\big(\boldsymbol x-\mu_{\boldsymbol x}\boldsymbol1\big) =\hat\beta_2\big(\boldsymbol x-\boldsymbol{\mathop{\overline x}}\big). \] Es decir: el ajuste en desviaciones es el regresor en desviaciones multiplicado por \(\hat\beta_2\). En el triángulo rectángulo de la lección 8, el ajuste en desviaciones y el residuo son los dos catetos, y el vector de datos en desviaciones es la hipotenusa. Hoy llamaremos cateto explicado al primero, porque su longitud al cuadrado es la \(\mathrm{SEC}\), y cateto residual al segundo, cuya longitud al cuadrado es la \(\mathrm{SRC}\) (el nombre arrastra la reserva que hicimos en la lección 8 sobre la palabra ``explicada''). La igualdad anterior dice que el cateto explicado está alineado con el regresor en desviaciones. Eso solo ocurre con un único regresor no constante: con dos o más, el ajuste en desviaciones vive en un subespacio de dimensión \(k-1\) y ya no está alineado con ningún regresor en particular (lección 10). Por eso hoy trabajamos con \(k=2\).
Tomando normas euclídeas al cuadrado en esa igualdad obtenemos \(\mathrm{SEC}=\hat\beta_2^{\,2}\,\|\boldsymbol x-\boldsymbol{\mathop{\overline x}}\|_e^2\). A partir de aquí la cuenta es mecánica. Partimos del estadístico, escribimos el error estándar como el cociente de longitudes de ``El error estándar, y el precio de estimar \(\sigma\)'' y elevamos al cuadrado: \[ t=\frac{\hat\beta_2}{\mathrm{ee}(\hat\beta_2)} =\frac{\hat\beta_2\,\|\boldsymbol x-\boldsymbol{\mathop{\overline x}}\|_e}{\mathfrak s}, \qquad t^2=\frac{\hat\beta_2^{\,2}\,\|\boldsymbol x-\boldsymbol{\mathop{\overline x}}\|_e^2}{\mathfrak s^2} =\frac{\mathrm{SEC}}{\mathrm{SRC}/(n-k)} =(n-k)\,\frac{\mathrm{SEC}}{\mathrm{SRC}}, \] que es la identidad anunciada. \(\blacksquare\)
A la izquierda, un estadístico de contraste, construido con supuestos probabilísticos, normalidad y la distribución del estimador. A la derecha, dos sumas de cuadrados que calculamos en la lección 8 sin la menor referencia a la probabilidad, y un número entero, \(n-k\), que también es geometría: la dimensión del subespacio donde vive el residuo (lección 11). Nada de lo que hay a la derecha es probabilístico. La lectura es directa: el estadístico \(t\) compara la longitud del cateto explicado con la del cateto residual. Un cateto explicado largo frente a un residuo corto, es decir, un ángulo \(\theta\) pequeño, da un \(|t|\) grande; un cateto explicado corto frente a un residuo largo, un ángulo próximo a \(90^\circ\), da un \(|t|\) pequeño.
Nótese que la identidad está escrita para \(|t|\), no para \(t\): el cociente de longitudes es siempre positivo, mientras que \(t\) hereda el signo de \(\hat\beta_2\). Si \(\hat\beta_2\) es negativo, el cateto explicado apunta en el sentido opuesto sobre la misma recta \(\mathcal{L}(\boldsymbol x-\boldsymbol{\mathop{\overline x}})\) (el conjunto de todos los múltiplos del regresor en desviaciones; geométricamente, una recta de \(\mathbb{R}^n\)), y nada más cambia: las longitudes, el ángulo y el valor de \(|t|\) son los mismos. Por eso la figura está dibujada con \(\hat\beta_2>0\) sin pérdida de generalidad.
La segunda forma de la identidad se obtiene recordando dos cosas de la lección 8: que \(R^2=\mathrm{SEC}/\mathrm{STC}\) y que \(\mathrm{STC}=\mathrm{SEC}+\mathrm{SRC}\) (el teorema de Pitágoras aplicado al triángulo de la figura, en su versión con norma euclídea, sin el factor \(1/n\) del producto escalar estadístico). De la segunda, \(\mathrm{SRC}=\mathrm{STC}-\mathrm{SEC}\), y dividiendo numerador y denominador por \(\mathrm{STC}\): \[ \frac{\mathrm{SEC}}{\mathrm{SRC}}=\frac{\mathrm{SEC}/\mathrm{STC}}{1-\mathrm{SEC}/\mathrm{STC}}=\frac{R^2}{1-R^2}, \qquad\text{luego}\qquad t^2=(n-k)\,\frac{R^2}{1-R^2}. \] Y como \(R^2=\cos^2\theta\), donde \(\theta=\measuredangle\big((\boldsymbol y-\boldsymbol{\mathop{\overline y}}),(\boldsymbol{\mathop{\widehat y}}-\boldsymbol{\mathop{\overline y}})\big)\), resulta que \(|t|\) es una función únicamente del ángulo \(\theta\) y del número \(n-k\). No hay ninguna otra información en el estadístico \(t\): dado el ángulo y dados los grados de libertad, \(|t|\) está determinado.
Esto tiene una consecuencia práctica que conviene retener, y que reaparecerá en la sección ``Significación estadística \(\neq\) relevancia económica'': un \(R^2\) alto y un \(|t|\) alto no son dos resultados independientes que se refuercen mutuamente. Son la misma medida, expresada dos veces. Lo que \(|t|\) añade al \(R^2\) no es información sobre la relación, sino el factor \(\sqrt{n-k}\): cuántas observaciones respaldan ese ángulo.
Podemos comprobar la identidad con el ejemplo numérico de la lección 8, donde \(\mathrm{STC}=100\), \(\mathrm{SEC}=90\), \(\mathrm{SRC}=10\) y \(n=5\) (con \(k=2\), luego \(n-k=3\)): \[ t^2=3\cdot\frac{90}{10}=27,\qquad |t|=5{,}20. \] Y, por la otra vía, \(R^2=0{,}9\) da \(t^2=3\cdot\frac{0{,}9}{0{,}1}=27\), el mismo número.
Para profundizar: Wooldridge, J. M. (2020), cap. 4, sección 4.5 (donde aparece, para el contraste \(F\), la misma relación entre estadísticos de contraste y sumas de cuadrados que aquí hemos obtenido para \(t\)).
6. Por qué el valor crítico depende de \(n-k\)
La identidad anterior separa la significación en dos factores: \(\;\vert t\vert=\sqrt{n-k}\times\sqrt{\mathrm{SEC}/\mathrm{SRC}}=\sqrt{n-k}\times\sqrt{R^2/(1-R^2)}\), es decir, cuántas observaciones \(\times\) qué fuerza tiene la relación.
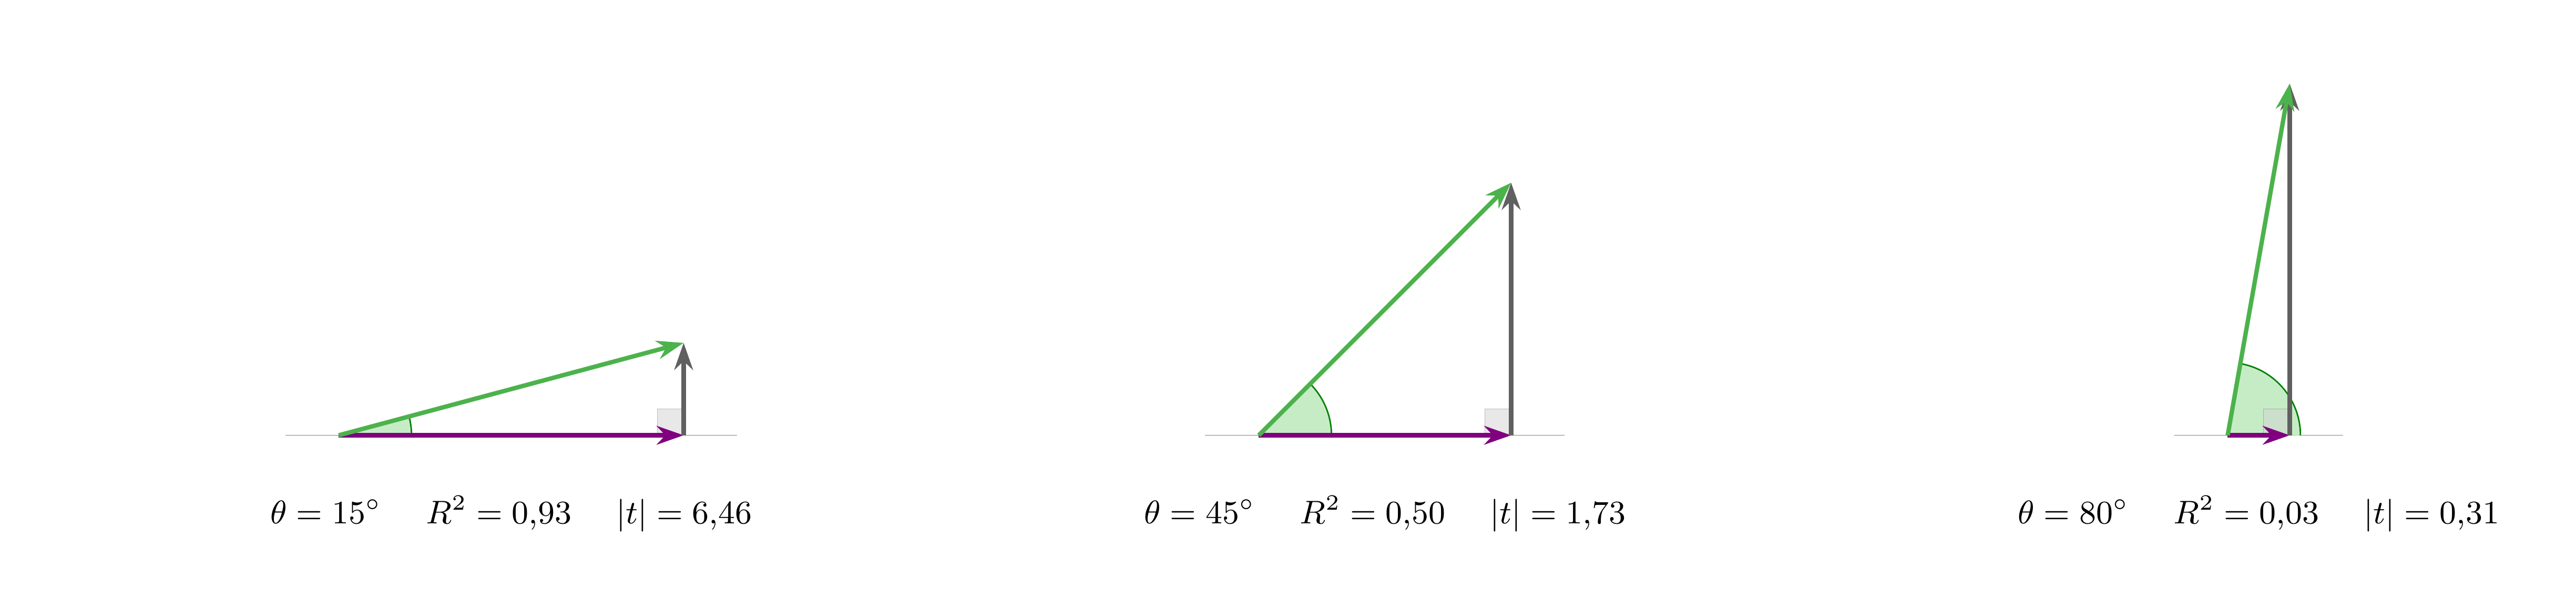
Figura 2: El mismo triángulo con tres aberturas del ángulo \(\theta\), con su \(R^2=\cos^2\theta\) y el \(\vert t\vert\) que resulta con \(n=5\) (\(n-k=3\)), cuyo valor crítico al \(5\,\%\) es \(3{,}18\). La hipotenusa mide lo mismo en los tres paneles: lo único que cambia es el ángulo. Solo el primero resulta significativo. Bajo \(H_0\) los tres paneles son posibles: la hipótesis nula no fija el ángulo, sino su distribución (apuntes de esta transparencia).
Con pocas observaciones un ángulo pequeño no prueba nada: en \(\mathbb{R}^2\) todo par de vectores en desviaciones está alineado (\(R^2=1\) siempre, \(n-k=0\)). En \(\mathbb{R}^n\) con \(n\) grande, un vector tomado al azar forma, con probabilidad alta, un ángulo próximo a \(90^\circ\) con cualquier dirección fija. Por eso el mismo ángulo de \(45^\circ\) es corriente bajo \(H_0\) con \(n=5\) y rarísimo con \(n=500\).
Por qué el valor crítico depende de \(n-k\)
La identidad de ``Lectura geométrica: la razón de catetos'' descompone la significación estadística en dos factores (en el apéndice, sección 5.4 (html), la misma identidad se obtiene en una base ortonormal adaptada, y vale para cualquier \(k\) con la parte propia del regresor en el lugar del regresor). Uno es geométrico y describe la relación: la razón entre los dos catetos, equivalentemente el ángulo \(\theta\), equivalentemente el \(R^2\). El otro es aritmético y describe el tamaño de la muestra: el factor \(\sqrt{n-k}\), que solo cuenta observaciones. Un mismo ángulo, con más observaciones, produce un \(|t|\) mayor; un mismo número de observaciones, con un ángulo más cerrado, también. La significación es el producto de ambas cosas, y por eso no puede leerse como si midiera solo una de las dos.
¿Por qué hay que corregir por los grados de libertad? ¿Por qué un ángulo pequeño no basta, por sí solo, para rechazar? La respuesta ya está demostrada en este curso: es el resultado de la lección 5 según el cual en \(\mathbb{R}^2\) la correlación es siempre \(\pm1\). Recordemos el argumento: el subespacio \(\mathcal{L}(\boldsymbol1)^\perp\), donde viven todos los vectores en desviaciones, tiene dimensión \(n-1\), de modo que en \(\mathbb{R}^2\) es una simple recta; y dos vectores cualesquiera sobre una recta están forzosamente alineados.
Traduzcamos eso al lenguaje de hoy. Con \(n=2\) observaciones y \(k=2\) coeficientes, la recta de regresión pasa exactamente por los dos puntos: el residuo es nulo, \(\mathrm{SRC}=0\), el ángulo \(\theta\) es \(0^\circ\) y \(R^2=1\). Un ajuste perfecto. ¿Prueba eso una relación entre las variables? No: prueba que dos puntos determinan una recta. Y el aparato construido lo refleja: los grados de libertad son \(n-k=2-2=0\), la cuasivarianza \(\mathfrak s^2=\mathrm{SRC}/(n-k)\) es un cociente de la forma \(0/0\), el error estándar no está definido y el estadístico \(t\) no existe. No es que el contraste dé un resultado ambiguo: es que no hay contraste posible. Con \(n=3\) ya hay un grado de libertad, y el contraste existe, pero su valor crítico al \(5\,\%\) es \(12{,}71\): \(H_0\) es difícil de rechazar, porque con tres puntos un ángulo pequeño sigue siendo fácil de obtener por azar.
Con esto en mente, la figura de la transparencia se lee así. Los tres paneles tienen la misma hipotenusa y solo cambia el ángulo: con \(\theta=15^\circ\) el \(R^2\) es de \(0{,}93\) y \(\vert t\vert=6{,}46\), por encima de \(3{,}18\) (el valor crítico de la \(t_3\) al \(5\,\%\)); con \(\theta=45^\circ\), un \(R^2\) de \(0{,}50\) ya no basta (\(\vert t\vert=1{,}73\)); y con \(\theta=80^\circ\) el cateto explicado es casi nulo.
La hipótesis \(H_0\!:\beta_2=0\) tan solo habla del parámetro poblacional, no de la muestra: bajo \(H_0\) pueden darse muestras como las de cualquiera de los tres paneles (aunque con distinta probabilidad). Lo que \(H_0\) fija es el centro de la distribución de \(\hat\beta_2\): \(E[\hat\beta_2\mid\boldsymbol X]=\mathit0\) (lección 11), es decir, el cateto explicado, \(\hat\beta_2(\boldsymbol x-\boldsymbol{\mathop{\overline x}})\) evaluado sobre la muestra, tiene esperanza nula con su signo (su longitud no: lección 13), y la distribución del ángulo es simétrica alrededor de \(90^\circ\) (lo cual no impide que pueda ocurrir un caso como el de la figura de la izquierda). Lo que el contraste mide es cuánto se aleja la muestra de datos de ese centro.
Hay una propiedad de los espacios de dimensión alta que enunciamos sin demostrar: en \(\mathbb{R}^n\) con \(n\) grande, dos direcciones tomadas al azar son casi ortogonales. Dicho de otra forma: si el vector de datos en desviaciones apunta ``a un sitio cualquiera'', lo esperable es que forme con la dirección del regresor un ángulo próximo a \(90^\circ\), y tanto más próximo cuanto mayor sea \(n\). La lección 13 la hará precisa con el \(R^2\) que regala el azar, y el apéndice (sección 8) (html) la demuestra: bajo \(H_0\), \(\cos^2\theta\) tiene esperanza \(1/(n-1)\). Por eso un ángulo de, digamos, \(45^\circ\) es poco informativo con cinco observaciones, porque bajo \(H_0\) sale a menudo, y muy informativo con quinientas, porque bajo \(H_0\) casi nunca ocurre.
Ahora podemos decir qué aporta la normalidad. Bajo \(H_0\) el modelo es \(Y_i=\beta_1\,\mathit1+U_i\) para cada \(i\), con \(U_1,\ldots,U_n\) las perturbaciones de la muestra. Apliquemos a cada \(Y_i\) la fórmula aritmética del vector en desviaciones (lección 11: una fórmula de datos evaluada en variables aleatorias), es decir, restemos a cada una la media muestral \(\overline Y=\frac1n\sum_iY_i\), que es una variable aleatoria. Como cada \(Y_i\) es \(\beta_1\) más \(U_i\), su media muestral es \(\overline Y=\beta_1\,\mathit1+\overline U\), con \(\overline U=\frac1n\sum_iU_i\) la media muestral de las perturbaciones, y al restar, \(\beta_1\) se cancela: \[ Y_i-\overline{Y}=(\beta_1\,\mathit1+U_i)-(\beta_1\,\mathit1+\overline U)=U_i-\overline{U},\qquad i=1,\ldots,n. \] La hipotenusa del triángulo que vemos, \(\boldsymbol y-\boldsymbol{\mathop{\overline y}}\), es la realización de la lista \((U_1-\overline U,\ldots,U_n-\overline U)\): solo ruido, sin \(\beta_1\).
El ángulo \(\theta\) entre esa hipotenusa y la dirección del regresor en desviaciones se calcula con una fórmula de datos, el arcocoseno de un cociente entre un producto escalar y dos normas (lección 5), y evaluada sobre la muestra esa fórmula es una variable aleatoria (lección 11). Con la base ortonormal de ``El supuesto nuevo: normalidad'', elegida con su primer vector en la dirección del regresor en desviaciones, \(\cos\theta\) es la primera coordenada del ruido dividida por la raíz de la suma de los cuadrados de las \(n-1\) coordenadas. Como bajo normalidad las \(n-1\) coordenadas son independientes y con la misma distribución (isotropía), la distribución de ese cociente no depende de cuál sea la dirección del regresor: solo de cuántas coordenadas compiten con la primera, que son \(n-2\), es decir, \(n-k\) con \(k=2\): la dimensión del subespacio donde vive el residuo. La demostración está en el apéndice (sección 9) (html), donde además se ve que esa distribución, escrita en la escala del estadístico, es la \(t_{n-k}\) de la transparencia del error estándar; aquí basta con la conclusión. La identidad de ``Lectura geométrica: la razón de catetos'' dice que \(|t|\) es \(\sqrt{n-k}\) por la razón de catetos, y la razón de catetos decrece cuando el ángulo crece: fijado \(n-k\), conocer la distribución del ángulo bajo \(H_0\) es conocer la del estadístico, y al revés. Por eso los grados de libertad de la \(t_{n-k}\) son \(n-k\): el número de coordenadas del ruido, ortogonales al regresor, hacia las que el ángulo se puede abrir. Sin normalidad las coordenadas del ruido siguen siendo ortogonales y de la misma longitud, pero no independientes: la distribución del ángulo ya no es esa, y la \(t_{n-k}\) deja de ser la distribución exacta del estadístico. Qué queda entonces, y por qué con muchas observaciones sigue sirviendo, se explica al final de la sesión.
La distribución del ángulo permite leer la región crítica de otra manera. Rechazar \(H_0\) cuando \(|t|>t_c\) equivale, por la identidad, a rechazarla cuando el ángulo es menor que un cierto ángulo crítico \(\theta_c\). La región crítica está asociada con un cono alrededor de la recta generada por el regresor en desviaciones, y el valor crítico \(t_c\) determina la abertura de ese cono. Lo que hace el contraste es preguntar si el vector de datos en desviaciones ha caído dentro de dicho cono.
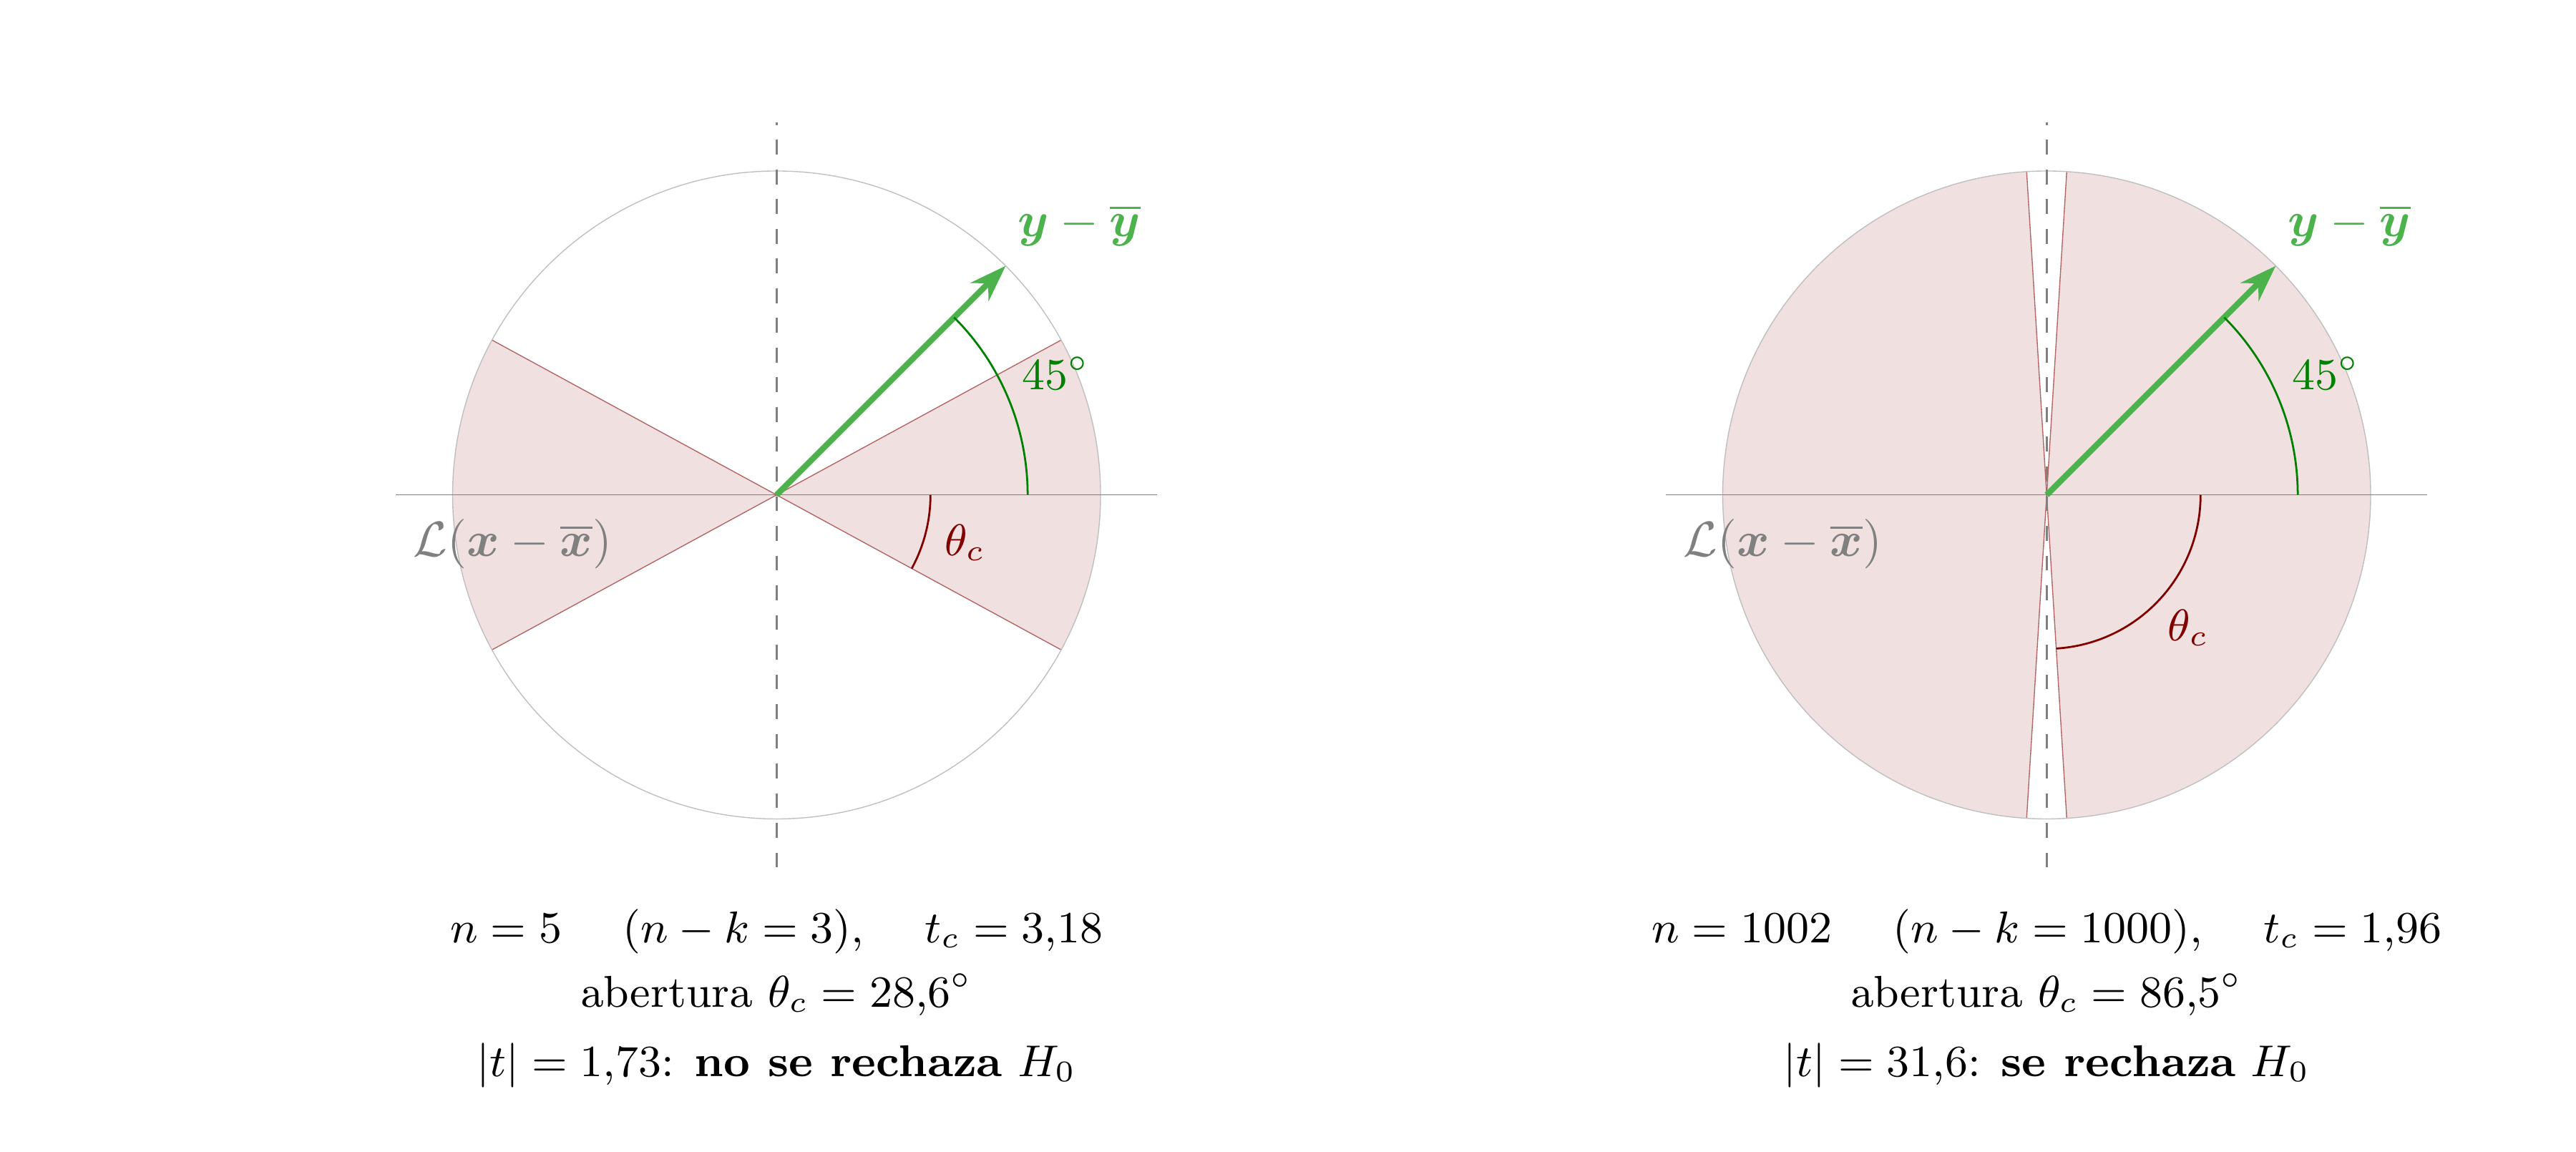
Figura 3: La región crítica al \(5\,\%\) (sombreada) como un cono alrededor de la recta generada por el regresor en desviaciones, vista en el plano que forman el regresor en desviaciones y el vector de datos en desviaciones. El nivel es el mismo en los dos paneles. A la izquierda, con \(n=5\): la abertura es de \(28{,}6^\circ\). A la derecha, con \(n=1002\): la abertura es de \(86{,}5^\circ\), casi todo el espacio. El vector de datos en desviaciones forma en los dos paneles el mismo ángulo de \(45^\circ\) con el regresor, y el veredicto es opuesto.
La figura pone números a la idea. La abertura del cono se obtiene de la identidad: el ángulo crítico es aquel cuya razón de catetos vale \(t_c/\sqrt{n-k}\), con \(t_c\) el valor crítico de la \(t_{n-k}\) al \(5\,\%\). Con \(n=5\) (\(n-k=3\), \(t_c=3{,}18\)) sale \(\theta_c=28{,}6^\circ\): el cono es estrecho, y hace falta que los datos se alineen mucho con el regresor para rechazar. Con \(n=1002\) (\(n-k=1000\), \(t_c=1{,}96\)) sale \(\theta_c=86{,}5^\circ\): el cono ocupa casi todo el espacio, y basta un ángulo apenas distinto de la ortogonalidad para rechazar. Los dos paneles muestran el mismo vector de datos, a \(45^\circ\) del regresor: fuera del cono en el primer caso (no se rechaza, \(|t|=1{,}73\)), dentro en el segundo (se rechaza, \(|t|=31{,}6\)).
Hay que ser cuidadoso al interpretar ese contraste, porque admite dos lecturas y solo una es correcta. La lectura incorrecta sería: ``con muchas observaciones el contraste es más laxo, rechaza con menos exigencia''. No: el contraste mantiene, en los dos paneles, la misma probabilidad de error de tipo I, el \(5\,\%\): eso es lo que significa haber calculado la abertura con \(t_c\). Lo que cambia es que, con mil dos observaciones (figura de la derecha), el azar produce casi siempre ángulos muy próximos a \(90^\circ\): casi toda la probabilidad (\(95\,\%\)) se concentra en la rendija vertical; de manera que ese amplio cono (con apertura \(2\theta_c\)) corresponde únicamente al \(5\,\%\) de los casos. La lectura correcta es: con muchas observaciones, una desviación pequeñísima de la ortogonalidad ya es estadísticamente detectable.
Que esa desviación sea económicamente relevante es otra cuestión, y a ella dedicaremos una transparencia entera.
Para profundizar: Wooldridge, J. M. (2020), cap. 4, sección 4.2a (dependencia del valor crítico respecto de los grados de libertad). Fisher, R. A. (1915), ``Frequency distribution of the values of the correlation coefficient in samples from an indefinitely large population'', Biometrika 10, 507-521: el artículo donde la distribución del coeficiente de correlación se obtiene, originalmente, por un argumento geométrico sobre ángulos como el que aquí solo hemos enunciado.
7. El intervalo de confianza
Un rango de valores de \(\beta_2\) que el contraste no rechaza, en vez de un veredicto: \[ \boxed{\;\Big[\;\hat\beta_2-t_c\cdot\mathrm{ee}(\hat\beta_2)\;,\;\;\hat\beta_2+t_c\cdot\mathrm{ee}(\hat\beta_2)\;\Big]\;} \] con el mismo \(t_c\) del contraste; semiamplitud \(t_c\cdot\mathfrak s/\|\boldsymbol x-\boldsymbol{\mathop{\overline x}}\|_e\).
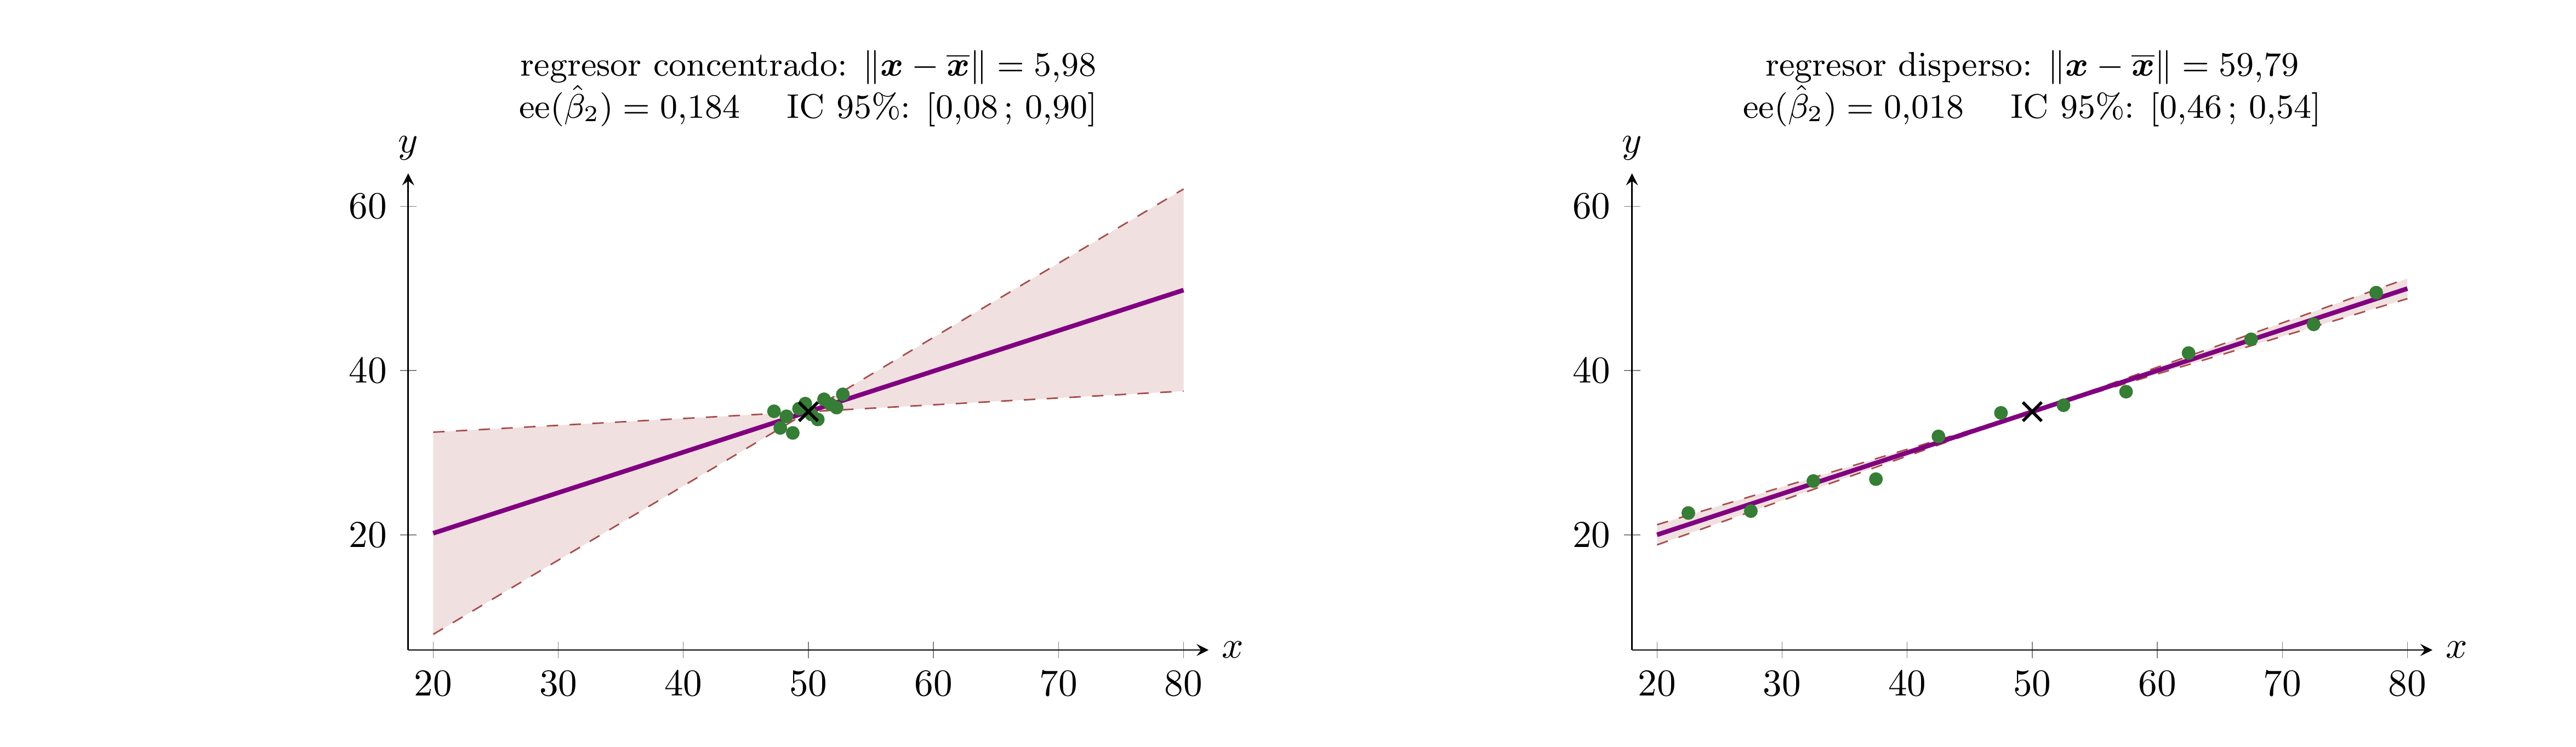
Figura 4: Dos ajustes con la misma muestra de perturbaciones, el mismo \(n=12\) y el mismo residuo, y por tanto el mismo \(\mathfrak s=1{,}10\). Lo único distinto es cuánto se separan los valores del regresor. La zona sombreada es el haz de rectas cuyas pendientes caen en el intervalo de confianza al \(95\,\%\), dibujadas pivotando sobre el centroide, por donde la recta de regresión pasa siempre. Diez veces más largo el regresor en desviaciones, diez veces más estrecho el haz.
Dice: los extremos del intervalo son variables aleatorias, y el suceso ``el intervalo contiene a \(\beta_2\)'' tiene probabilidad \(0{,}95\). No dice: que \(\beta_2\) esté en este intervalo con probabilidad \(0{,}95\); \(\beta_2\) no es aleatorio, y estos dos extremos, ya calculados, tampoco.
El intervalo de confianza
El contraste de hipótesis responde sí o no. El intervalo de confianza responde a otra pregunta, ``¿bajo qué valores de \(\beta_2\) no serían demasiado raros datos como estos?'', con el ``demasiado'' fijado por \(\alpha\) y con la misma maquinaria. Su construcción sale de despejar en la distribución de la sección ``El error estándar, y el precio de estimar \(\sigma\)'': si \((\hat\beta_2-\beta_2)/\mathrm{ee}(\hat\beta_2)\) sigue una \(t_{n-k}\), entonces ese cociente cae entre \(-t_c\) y \(+t_c\) con probabilidad \(1-\alpha\), y despejando \(\beta_2\) de esa doble desigualdad se obtiene \[ \Big[\;\hat\beta_2-t_c\cdot\mathrm{ee}(\hat\beta_2)\;,\;\;\hat\beta_2+t_c\cdot\mathrm{ee}(\hat\beta_2)\;\Big]. \] Es, por tanto, el contraste mismo, formulado como conjunto de valores. Y esa equivalencia es exacta y conviene tenerla clara: un valor \(c\) queda fuera del intervalo de confianza al \(95\,\%\) si y solo si el contraste de \(H_0\!:\beta_2=c\) se rechaza al \(5\,\%\). El intervalo es, literalmente, el conjunto de las hipótesis que no se rechazarían. Por eso contiene toda la información del contraste y algo más: no solo dice si el cero se rechaza, sino qué otros valores también, y con qué margen. El apéndice (sección 9, ``Del contraste al intervalo'') (html) escribe el suceso ``el intervalo contiene a \(\beta_2\)'' con las coordenadas del ruido y lee su probabilidad \(1-\alpha\) como la fracción de columnas de la matriz de copias en las que ocurre: es lo que la práctica C de la sesión 18 mide repitiendo muestras.
La semiamplitud del intervalo, \(t_c\cdot\mathfrak s/\|\boldsymbol x-\boldsymbol{\mathop{\overline x}}\|_e\), es el error estándar multiplicado por \(t_c\), y hereda su lectura como cociente de longitudes: longitud del ruido estimado por unidad de longitud del regresor en desviaciones. La figura la hace visible, pero conviene leerla despacio. Toda recta con pendiente dentro del intervalo se ha dibujado pasando por el centroide \((\mu_{\boldsymbol x},\mu_{\boldsymbol y})\), como la recta de regresión (lección 7), y la zona sombreada es el haz de todas ellas, limitado por las dos rectas de pendiente extrema, \(\hat\beta_2\pm t_c\cdot\mathrm{ee}(\hat\beta_2)\). La semiamplitud no es, por tanto, una anchura de esa zona, sino una diferencia de pendientes: a una distancia horizontal \(d\) del centroide, el haz se abre verticalmente \(d\cdot t_c\cdot\mathrm{ee}(\hat\beta_2)\) por encima y por debajo de la recta de regresión, y la semiamplitud es esa abertura por unidad de distancia al centroide. Un intervalo diez veces más estrecho es un haz diez veces más cerrado.
Los dos paneles de la figura comparten todo excepto la dispersión del regresor: los mismos parámetros (\(\beta_1=10\), \(\beta_2=0{,}5\)), las mismas doce perturbaciones y el mismo vector de residuos, porque el regresor en desviaciones apunta en la misma dirección en los dos casos y solo cambia su longitud.5 En consecuencia \(\mathfrak s=1{,}10\) en ambos, y toda la diferencia procede del denominador: \(\|\boldsymbol x-\boldsymbol{\mathop{\overline x}}\|_e\) vale \(5{,}98\) en el panel izquierdo y \(59{,}79\) en el derecho. Diez veces más largo el regresor en desviaciones, diez veces más pequeño el error estándar (\(0{,}184\) frente a \(0{,}018\)) y diez veces más estrecho el intervalo: \([0{,}08;\,0{,}90]\) frente a \([0{,}46;\,0{,}54]\).
Y no es solo el intervalo lo que se estrecha: el error de estimación efectivamente cometido también se divide por diez. La pendiente verdadera es \(\beta_2=0{,}5\); con el regresor concentrado se estima \(0{,}4931\) (error de \(-0{,}0069\)) y con el regresor disperso, \(0{,}4993\) (error de \(-0{,}00069\)). Exactamente un factor de diez, el mismo que separa las longitudes. La lectura sustantiva es la que importa: para estimar bien el efecto de una variable hace falta que esa variable varíe. Si en su muestra todo el mundo tiene aproximadamente la misma educación, no podrá medir con precisión el efecto de la educación sobre el salario, por muy limpios que sean sus datos y por muchas observaciones que tenga. Esta idea reaparecerá, con varios regresores, al estudiar la colinealidad.
Vale la pena señalar que el panel izquierdo es un buen ejemplo de una situación incómoda pero frecuente: el contraste rechaza \(H_0\!:\beta_2=0\) (el cero no está en el intervalo, \(|t|=2{,}68\) frente a un crítico de \(2{,}23\)), y sin embargo el intervalo es tan ancho, de \(0{,}08\) a \(0{,}90\), que apenas informa sobre la magnitud del efecto. Si un resultado así se comunica diciendo solo ``el efecto es significativo'', se está ocultando lo esencial: que el rango de valores que el contraste no descarta es tan amplio que no sabemos, ni aproximadamente, cuánto vale \(\beta_2\). Por eso conviene dar el intervalo y no solo el veredicto, sobre todo al leer o escribir un informe.
Queda la cuestión de la interpretación, donde es fácil equivocarse. La afirmación correcta es sobre el procedimiento, no sobre este intervalo concreto. Evaluada sobre la muestra aleatoria, la receta da un intervalo cuyos extremos, \(\hat\beta_2\pm t_c\,\mathrm{ee}(\hat\beta_2)\), son variables aleatorias, y lo que garantiza la distribución \(t_{n-k}\) es que el suceso ``ese intervalo contiene a \(\beta_2\)'' tiene probabilidad \(0{,}95\). La lectura en términos de repeticiones, ``si repitiéramos el muestreo muchas veces, alrededor del \(95\,\%\) de los intervalos contendrían a \(\beta_2\)'', es una consecuencia de esa probabilidad, no su definición. La afirmación incorrecta, y muy tentadora, es ``hay un \(95\,\%\) de probabilidad de que \(\beta_2\) esté entre \(0{,}46\) y \(0{,}54\)''. No tiene sentido en este marco: \(\beta_2\) es un número fijo y desconocido, no una variable aleatoria, así que no hay ninguna distribución de probabilidad sobre sus valores posibles. Lo aleatorio es el intervalo, cuyos extremos son variables aleatorias, funciones de la muestra; no el parámetro. Este intervalo concreto, el que tenemos delante, o contiene a \(\beta_2\) o no lo contiene; el \(0{,}95\) es la probabilidad de que el método acierte, no la de que acierte esta vez.6 La cobertura de los intervalos, la fracción de ellos que acierta, es lo que comprobaremos con datos simulados en el laboratorio que sigue a esta lección.
Para profundizar: Wooldridge, J. M. (2020), cap. 4, sección 4.3 (intervalos de confianza y su relación con los contrastes de dos colas).
8. Cómo se lee una tabla de resultados
Toda salida de estimación tiene, para cada regresor, las mismas cuatro columnas:
| Columna | Qué es | A qué pregunta responde |
|---|---|---|
| Coeficiente | \(\hat\beta_j\) | ¿de qué tamaño es el efecto, en las unidades del problema? |
| Desv. típica | \(\mathrm{ee}(\hat\beta_j)\) | ¿con cuánta precisión lo hemos medido? |
| Estadístico \(t\) | el cociente de las dos anteriores | ¿a cuántos errores estándar del cero está? |
| Valor \(p\) | \(\mathrm{P}\big(\vert t_{n-k}\vert>\vert t\vert\big)\) | ¿cuán raro sería esto si el efecto fuese nulo? |
Las dos últimas son derivadas: no añaden información, reordenan la de las dos primeras. La tabla se comprueba: \(t\) = coeficiente \(/\) error estándar.
Aviso terminológico: en la salida en español de Gretl, ``desviación típica'' rotula tres cantidades distintas: la de la variable dependiente (dispersión de los datos), la de la regresión (\(\mathfrak s\)) y la de cada coeficiente (su error estándar). En inglés solo la primera es standard deviation; las otras dos son standard error.
Cómo se lee una tabla de resultados
Todo lo construido hasta aquí se presenta, en la práctica, en forma de tabla: cuatro columnas por regresor, más unas pocas líneas de resumen del modelo. Tomemos como ejemplo el panel derecho de la figura de ``El intervalo de confianza'', el del regresor disperso, cuya estimación completa es esta:
| Regresor | Coeficiente | Desv. típica | Estadístico \(t\) | Valor \(p\) |
|---|---|---|---|---|
| constante | 10,0343 | 0,9732 | 10,31 | \(1{,}2\cdot10^{-6}\) |
| \(\boldsymbol x\) | 0,4993 | 0,0184 | 27,14 | \(1{,}1\cdot10^{-10}\) |
con \(n=12\), \(k=2\), \(\mathrm{STC}=903{,}40\), \(\mathrm{SEC}=891{,}30\), \(\mathrm{SRC}=12{,}10\), \(\mathfrak s=1{,}1001\) y \(R^2=0{,}9866\).
La primera columna es el tamaño del efecto estimado, en las unidades del problema. Aquí, \(\hat\beta_2=0{,}4993\) significa que a un aumento de una unidad de \(x\) le corresponde, en el ajuste, un aumento de \(0{,}4993\) unidades de \(y\). Es, junto con el error estándar, una de las dos columnas cuyo valor cambia si cambian las unidades de medida: si midiéramos \(x\) en centenares (es decir, \(x/100\)), el coeficiente se multiplicaría por cien (si un metro cuadrado más sube el precio \(2\,000\) euros, cien metros cuadrados más lo suben \(200\,000\)).
La segunda columna es el error estándar, y responde a una pregunta distinta: no cuánto vale el efecto, sino con cuánta precisión lo hemos medido. Un coeficiente sin su error estándar es un número sin unidades de incertidumbre, y no se puede evaluar.
La tercera y la cuarta columnas son derivadas: se calculan a partir de las dos primeras y no añaden ninguna información que no estuviera ya en ellas. El estadístico \(t\) es el cociente de la primera entre la segunda, y el valor \(p\) es una transformación monótona de \(|t|\) una vez fijados los grados de libertad. A diferencia del coeficiente y de su error estándar, el estadístico \(t\) y el valor \(p\) no cambian si cambian las unidades de medida: el coeficiente y su error estándar se multiplican por el mismo factor y el cociente se conserva. Eso los hace cómodos para comparar y, al mismo tiempo, inservibles para valorar la magnitud del efecto.
El pie de la tabla también informa. El \(R^2=0{,}9866\) dice, como sabemos desde la lección 8, que el ajuste reproduce el \(98{,}66\,\%\) de la variación total de \(\boldsymbol y\); en el triángulo, el ángulo \(\theta\) es de unos \(6{,}6^\circ\).
El otro número del pie es \(\mathfrak s=1{,}1001\), la estimación de la desviación típica de la perturbación, en las mismas unidades que \(\boldsymbol y\). Un número con unidades no es grande ni pequeño por sí solo: hay que compararlo con algo medido en las mismas unidades, y hay dos comparaciones naturales. La primera es con la variación de \(\boldsymbol y\), cuya desviación típica es \(\sqrt{\mathrm{STC}/n}=8{,}68\). El ruido típico es un octavo de eso, pequeño; es la misma información que da \(1-R^2=0{,}013\), la fracción de la variación que queda sin explicar. La segunda es con el efecto estimado: una unidad de \(x\) mueve el ajuste \(0{,}4993\) unidades de \(y\), así que un ruido típico de \(1{,}10\) equivale a lo que el ajuste atribuye a unas dos unidades de \(x\). Esta segunda comparación, en unidades del problema, es la que el \(R^2\) no puede hacer, porque es adimensional.
Por último, la tabla permite comprobar la identidad de la sección ``Lectura geométrica: la razón de catetos'': \(\sqrt{(n-k)\,\mathrm{SEC}/\mathrm{SRC}}=\sqrt{10\cdot891{,}30/12{,}10}=27{,}14\), que es el \(|t|\) de la tabla.
Queda el aviso terminológico, que en español es más necesario que en inglés. En la salida original de Gretl aparecen, en sitios distintos, ``S.D. dependent var'' (la desviación típica de la variable dependiente: una dispersión de datos), ``S.E. of regression'' (nuestra \(\mathfrak s\): una estimación de la desviación típica de la perturbación) y la columna ``Std. Error'' de cada coeficiente (el error estándar propiamente dicho: la dispersión de un estimador). Son tres cantidades conceptualmente distintas, y la versión española de Gretl rotula las tres como desviación típica: ``D.T. de la vble. dep.'', ``D.T. de la regresión'' y, como cabecera de la columna de los errores estándar, ``Desv. típica''. La distinción entre desviación típica y error estándar, que en inglés está en el propio nombre, se pierde. Al leer una salida en español conviene identificar cada una por su posición, no por su etiqueta.7
Una última observación sobre los artículos y los informes ajenos. Muchos no publican las cuatro columnas: es habitual dar el coeficiente y, debajo, entre paréntesis, el error estándar o, en algunas tradiciones, el estadístico \(t\), con asteriscos que codifican niveles de significación. Antes de interpretar nada hay que averiguar qué contiene el paréntesis, porque la diferencia es enorme: un \(0{,}02\) bajo un coeficiente de \(0{,}5\) significa una estimación muy precisa si es un error estándar, y una estimación pésima si es un estadístico \(t\). La nota al pie de la tabla lo suele decir.8
Para profundizar: Wooldridge, J. M. (2020), cap. 4, sección 4.6 (cómo se informan los resultados de una regresión, y cómo leer las convenciones habituales de presentación).
9. Significación estadística \(\neq\) relevancia económica
La identidad de la sección ``Lectura geométrica: la razón de catetos'' lo explica: \(|t|\) mezcla fuerza de la relación con tamaño de la muestra. Tres casos inventados, calculados con la fórmula:
| \(n\) | \(R^2\) | \(\theta\) | \(\vert t\vert\) | Veredicto al \(5\,\%\) |
|---|---|---|---|---|
| 3 | 0,90 | \(18{,}4^\circ\) | 3,00 | no significativo (\(t_c=12{,}71\)) |
| 5 | 0,90 | \(18{,}4^\circ\) | 5,20 | significativo (\(t_c=3{,}18\)) |
| 1002 | 0,01 | \(84{,}3^\circ\) | 3,18 | significativo (\(t_c=1{,}96\)) |
Mismo ángulo, veredicto opuesto (filas 1 y 2). Y un ángulo de \(84^\circ\) (casi ortogonal, \(R^2\) del \(1\,\%\)) resulta significativo con mil observaciones (fila 3).
La significación dice si el efecto es distinguible de cero, no si es grande. Para juzgar si es grande hay que mirar el coeficiente en las unidades del problema, el intervalo de confianza y el \(R^2\), no el \(|t|\).
Y tres avisos más: ``no rechazar'' no es ``aceptar''; el valor \(p\) no es la probabilidad de que \(H_0\) sea cierta; y nada de todo esto establece causalidad.
Significación estadística \(\neq\) relevancia económica
El contenido de esta transparencia se resume en una frase: ``significativo'' no quiere decir ``grande''. Se lee en la identidad que obtuvimos en la sección ``Lectura geométrica: la razón de catetos''.
Recordémosla: \(|t|=\sqrt{n-k}\cdot\sqrt{\mathrm{SEC}/\mathrm{SRC}}\). El estadístico de contraste es el producto de dos factores que miden cosas completamente distintas. El segundo mide la fuerza de la relación en la muestra: el ángulo, el \(R^2\), la razón de catetos. El primero solo cuenta observaciones. Un \(|t|\) grande puede deberse a cualquiera de los dos, y el estadístico no distingue entre ellos: con suficientes observaciones, una relación arbitrariamente débil produce un \(|t|\) arbitrariamente grande. Decir ``el coeficiente es significativo'' es, por tanto, decir algo sobre el producto de los dos factores, no sobre el efecto.
La tabla de la transparencia lleva esa mezcla de los dos factores al extremo con tres casos inventados, calculados con la fórmula a partir de \(n\) y \(R^2\), no procedentes de datos. En los tres casos se contrasta la misma hipótesis, \(H_0\!:\beta_2=0\), la de que el regresor no interviene. Las dos primeras filas tienen el mismo \(R^2\) de \(0{,}90\) (el mismo ángulo de \(18{,}4^\circ\), la misma fuerza de relación en la muestra) y veredictos opuestos: con \(n=3\) el estadístico vale \(3{,}00\) frente a un valor crítico de \(12{,}71\), y no se rechaza \(H_0\); con \(n=5\) vale \(5{,}20\) frente a \(3{,}18\), y se rechaza. La tercera fila hace el recorrido inverso: un \(R^2\) del \(1\,\%\) (un ángulo de \(84{,}3^\circ\), prácticamente ortogonal, una relación casi inexistente) lleva a rechazar \(H_0\) al \(5\,\%\) en cuanto hay mil observaciones. Conviene traducir lo que dice ese \(R^2\): el ajuste reproduce el \(1\,\%\) de la variación total del regresando, y el \(99\,\%\) restante queda en el residuo. El efecto es distinguible de cero, pero para entender por qué varía el regresando ese regresor no cuenta casi nada: significativo e irrelevante a la vez. Esta situación es frecuente con las bases de datos grandes de hoy, donde casi cualquier coeficiente resulta significativo y la significación deja, en consecuencia, de aportar información.
¿Qué mirar entonces? Tres cosas, por orden. Primera: el coeficiente, en las unidades del problema. La pregunta es si su magnitud es económicamente apreciable. Un efecto de dos céntimos sobre el salario mensual puede ser muy significativo y carecer de interés. Un efecto de doscientos euros puede no ser significativo y merecer toda la atención; en ese caso lo razonable es buscar una muestra mayor y ver si el efecto se sostiene con más datos. Esta lectura del coeficiente recorre el resto del curso: con logaritmos y variables dicotómicas, buena parte del trabajo consiste en saber qué significa \(\hat\beta_j\) en cada caso (un cambio absoluto, un cambio porcentual, una elasticidad, un desplazamiento). Segunda: el intervalo de confianza. Dice de una vez si el efecto es distinguible de cero y con qué margen. El panel izquierdo de la figura de la sección ``El intervalo de confianza'' era un ejemplo: significativo, pero con un intervalo tan ancho que informa de casi nada. Tercera: el \(R^2\). Informa de la fuerza de la relación sin mezclarla con el tamaño de la muestra. Hay que leerlo con la cautela de la lección 8: no mide la calidad del modelo, y un \(R^2\) alto puede ser espurio.
Los tres avisos de la transparencia son los errores de lectura más frecuentes.
``No rechazar'' no es ``aceptar''. Cuando el contraste no rechaza \(H_0\!:\beta_2=0\), lo correcto es decir que datos como estos no serían raros si \(\beta_2\) fuese cero; no que \(\beta_2\) sea cero. La diferencia es la que hay entre ``no he encontrado pruebas'' y ``he probado que no hay nada''. Un contraste no rechaza por dos motivos muy distintos: porque el efecto es realmente nulo, o porque la muestra no permite detectarlo (regresor poco disperso, muestra pequeña, mucho ruido). El intervalo de confianza permite distinguir los dos casos: un intervalo estrecho alrededor del cero es informativo (``si hay efecto, es pequeño''); un intervalo ancho que contiene al cero no dice casi nada. Por eso, ante un resultado no significativo, la pregunta útil no es ``¿acepto \(H_0\)?'' sino ``¿qué anchura tiene mi intervalo?''.
El valor \(p\) no es la probabilidad de que \(H_0\) sea cierta. Es la probabilidad de observar unos datos al menos tan extremos como los observados suponiendo que \(H_0\) es cierta. Las dos cosas se parecen en la redacción y no tienen nada que ver: la primera exigiría una distribución de probabilidad sobre las hipótesis, que en este marco no existe: \(\beta_2\) es un número fijo, como ya discutimos con el intervalo. Un valor \(p\) de \(0{,}03\) no significa ``hay un \(3\,\%\) de probabilidad de que el regresor no importe''. Significa: ``si el regresor no importara, datos como estos aparecerían el \(3\,\%\) de las veces''.
Nada de esto establece causalidad. El contraste \(t\) se pronuncia sobre un coeficiente de un ajuste; de si ese coeficiente mide un efecto causal no dice, ni puede decir, absolutamente nada. Es la misma advertencia de la lección 9, la descomposición ortogonal no implica causalidad, y de la lección 8, donde las correlaciones espurias cumplen la identidad de Pitágoras igual que las relaciones sensatas. Un coeficiente significativo en una relación espuria es igual de significativo. La significación mide cuán raros serían los datos bajo una hipótesis sobre un parámetro; la causalidad es una cuestión ajena, que exige teoría y, sobre todo, un diseño que permita sostenerla.
Conviene añadir un cuarto aviso, que apunta ya a las dos lecciones siguientes. Los contrastes \(t\) que hemos construido son individuales: cada uno se pronuncia sobre un coeficiente, por separado. Y en regresión múltiple puede ocurrir que ningún coeficiente sea individualmente significativo y que, sin embargo, los regresores en conjunto sí mejoren el ajuste: eso es lo que detecta el contraste \(F\) de la próxima lección. Suele ser síntoma de que dos o más regresores apuntan en direcciones muy próximas y el ajuste no puede repartir el efecto entre ellos con precisión. Es la colinealidad, a la que dedicaremos otra lección.
Y, para cerrar, una observación sobre el supuesto de normalidad con el que abrimos la sesión. En el laboratorio anterior (actividad 2 (html)) vimos que, con \(n=506\), el histograma de las estimaciones parecía normal aunque la perturbación no lo fuera, mientras que con \(n=12\) dejaba de ser normal. El teorema central del límite garantiza que, al crecer la muestra, la distribución de \(\hat\beta_2\) se aproxima a la normal aunque \(U\) no sea normal. La consecuencia práctica: en muestras grandes, los contrastes \(t\) y los intervalos de confianza de esta lección siguen siendo aproximadamente válidos sin el supuesto de normalidad. En muestras pequeñas, en cambio, ese supuesto es el que sostiene el resultado exacto, y si falla, el valor \(p\) que imprime el programa puede estar bastante equivocado.
Para profundizar: Wooldridge, J. M. (2020), cap. 4, sección 4.2f (significación económica frente a significación estadística); y cap. 5, sección 5.2 (normalidad asintótica de MCO y validez aproximada de los contrastes en muestras grandes).
10. Recapitulación y guiño a las sesiones siguientes
| Pieza | Fórmula | Lectura geométrica |
|---|---|---|
| Error estándar | \(\mathfrak s/\Vert\boldsymbol x-\boldsymbol{\mathop{\overline x}}\Vert_e\) | longitud del ruido estimado por unidad de longitud del regresor |
| Estadístico \(t\) | \(\hat\beta_2/\mathrm{ee}(\hat\beta_2)\) | \(\sqrt{n-k}\times\) razón de catetos |
| Grados de libertad | \(n-k\) | dimensión del subespacio del residuo: coordenadas del ruido en \(\mathfrak s^2\) |
| Región crítica | \(\vert t\vert>t_c\) | cono alrededor de la dirección del regresor |
| Intervalo de confianza | \(\hat\beta_2\pm t_c\cdot\mathrm{ee}(\hat\beta_2)\) | haz de pendientes no rechazadas |
Un solo supuesto nuevo (normalidad); todo lo demás venía de las lecciones 8 y 11.
Lección 13: la misma fórmula, \(\frac{\mathrm{SEC}/(k-1)}{\mathrm{SRC}/(n-k)}\), con \(k>2\) es el contraste \(F\), que juzga varios regresores a la vez. Con \(k=2\), \(F=t^2\).
Más adelante: con \(k\) regresores, \(\mathrm{ee}(\hat\beta_j)=\mathfrak s/\|\tilde{\boldsymbol x}_j\|_e\), donde \(\|\tilde{\boldsymbol x}_j\|_e\) es la longitud propia del regresor \(j\): lo que le queda tras descontar lo que comparte con los demás. Colinealidad.
Recapitulación y guiño a las sesiones siguientes
El único supuesto añadido en esta sesión ha sido la normalidad de la perturbación, y su único cometido ha sido dar forma a una distribución cuyos dos primeros momentos ya conocíamos y, con ello, hacer independientes las coordenadas del ruido; esa independencia es lo único que distingue la \(t_{n-k}\) exacta de una aproximación (apéndice, secciones 8 (html) y 9). Todo lo demás (el triángulo, las sumas de cuadrados, el \(R^2\), la varianza de \(\hat\beta_2\), la cuasivarianza de los residuos con su divisor \(n-k\)) estaba ya sobre la mesa desde las lecciones 8 y 11.
La tabla resume las cinco piezas y su lectura geométrica. Conviene subrayar el patrón que las recorre: las cinco se leen en el triángulo de la lección 8, el que forman el vector de datos en desviaciones, el ajuste en desviaciones y el residuo. El error estándar compara el ruido con la longitud del regresor en desviaciones; el estadístico \(t\) compara los dos catetos; el intervalo de confianza traduce esa comparación a un haz de pendientes; los grados de libertad cuentan las direcciones, ortogonales al regresor, hacia las que puede abrirse el ángulo; y la región crítica es un cono alrededor del regresor cuya abertura fija el valor crítico. Toda la inferencia de esta lección se lee en ese triángulo.
Dos hilos quedan abiertos, y los dos salen de la misma identidad.
El primero apunta a la lección siguiente. Hoy hemos visto que \(t^2=(n-k)\,\mathrm{SEC}/\mathrm{SRC}\). Pero lo podemos escribir de otro modo, \[ t^2=\frac{\mathrm{SEC}/1}{\mathrm{SRC}/(n-k)}: \] la suma explicada dividida por \(1\), entre la suma residual dividida por sus grados de libertad, \(n-k\). Ese \(1\) es el número de regresores no constantes, es decir, \(k-1\) con \(k=2\). Escrito con \(k-1\) en su sitio, \(\dfrac{\mathrm{SEC}/(k-1)}{\mathrm{SRC}/(n-k)}\) es el estadístico \(F\): su fórmula es esta misma para cualquier \(k\), y contrasta de manera simultánea que todos los coeficientes salvo la constante son cero. Con \(k=2\), el \(F\) es \(t^2\): el mismo objeto con otro nombre. La figura del triángulo servirá, sin cambios, para la próxima lección.
El segundo apunta algo más lejos. Todo lo de hoy se ha demostrado para \(k=2\), con un único regresor no constante, porque solo en ese caso el cateto explicado es un múltiplo del regresor. Con más regresores, la fórmula del error estándar sigue siendo un cociente de longitudes, pero el denominador cambia de una manera muy instructiva: en lugar de la longitud del regresor en desviaciones, aparece la longitud de \(\tilde{\boldsymbol x}_j\), la parte del regresor \(j\) que no se puede reconstruir a partir de los demás regresores; la llamaremos la longitud propia del regresor. Lo enunciamos aquí; la lección 14 definirá esa parte propia y medirá su longitud, y la demostración está en el apéndice (html), secciones 5.4, 6.5 y 7.1: \[ \mathrm{ee}(\hat\beta_j)=\frac{\mathfrak s}{\|\tilde{\boldsymbol x}_j\|_e}. \] La lectura es inmediata y anticipa un problema que trataremos con detalle: si el regresor \(j\) forma un ángulo muy pequeño con el subespacio generado por los demás, es decir, si apunta casi en la misma dirección que ellos, entonces \(\tilde{\boldsymbol x}_j\) es muy corto, el error estándar se dispara y el coeficiente se estima con muy poca precisión. No porque falte información en los datos, sino porque esa información no permite separar el efecto de ese regresor del de sus compañeros. Es la colinealidad, y es la traducción exacta, en el lenguaje de los ángulos de este curso, de lo que en la transparencia del intervalo de confianza vimos con un solo regresor: para medir bien el efecto de una variable hace falta que esa variable varíe por su cuenta.
Para profundizar: Wooldridge, J. M. (2020), cap. 4, sección 4.5 (el contraste \(F\), con el que arranca la lección siguiente); y cap. 3, sección 3.4 (varianza de los estimadores MCO en regresión múltiple y el papel de la colinealidad).
11. Preguntas de repaso (sesión 17) htmlonly
Le propongo 12 preguntas. Las marco con un nivel orientativo: [B] básica, [M] media, [D] discriminadora.
Comentario
Las preguntas que más le conviene trabajar son la 5 (fija la identidad que vertebra la sesión: el estadístico \(t\) es la razón entre los dos catetos de la lección 8 corregida por la dimensión) y la 7 (conecta el caso \(n=2\) de la lección 5 con los grados de libertad, y explica por qué el valor crítico depende de \(n-k\)). La 11 es la de más uso fuera del curso, y la más sencilla de razonar una vez vista la identidad. Trabaje la 8 y la 9 juntas: la equivalencia entre intervalo y contraste es la que permite dejar de memorizar dos recetas. La 12 le pide distinguir lo que hoy se ha demostrado de lo que solo se ha enunciado.
Pregunta 1 [B] — Qué añade el supuesto de normalidad
Al suponer que la perturbación es normal, ¿qué se gana respecto a lo que ya se tenía en la lección 11?
- Se gana la insesgadez de \(\hat\beta_2\), que antes no estaba garantizada.
- Se gana una varianza más pequeña para \(\hat\beta_2\).
- Se gana la forma de la distribución de \(\hat\beta_2\); su valor esperado y su varianza eran ya conocidos y no cambian.
- Se gana la homocedasticidad, que hasta ahora era solo una conjetura.
Pregunta 2 [B] — Qué mide un error estándar
El error estándar \(\mathrm{ee}(\hat\beta_2)\) mide:
- La dispersión de los datos del regresando alrededor de su media.
- La dispersión del estimador \(\hat\beta_2\) de una muestra a otra, es decir, con cuánta precisión se ha medido el coeficiente.
- El tamaño típico de los residuos del ajuste.
- La distancia entre \(\hat\beta_2\) y el verdadero \(\beta_2\) en esta muestra concreta.
Pregunta 3 [M] — Lectura geométrica del error estándar
Escrito como \(\mathrm{ee}(\hat\beta_2)=\mathfrak s/\|\boldsymbol x-\boldsymbol{\mathop{\overline x}}\|_e\), el error estándar se lee como:
- La longitud del ruido estimado por unidad de longitud del regresor en desviaciones: a igual ruido, un regresor más disperso da más precisión.
- El coseno del ángulo entre el regresor y el regresando.
- La longitud del residuo dividida por el número de observaciones.
- Una cantidad que no depende de la dispersión del regresor, solo del ruido.
Pregunta 4 [M] — Por qué aparece la \(t\) de Student
Si \(\hat\beta_2\) es normal, ¿por qué el estadístico de contraste no sigue una normal estándar, sino una \(t_{n-k}\)?
- Porque \(\hat\beta_2\) deja de ser normal al restarle \(\beta_2\).
- Porque la \(t\) es solo una aproximación cómoda a la normal, que se usa por tradición.
- Porque en el denominador no está \(\sigma\) (desconocida) sino su estimación \(\mathfrak s\), que también fluctúa de muestra en muestra, y eso añade dispersión al cociente.
- Porque el supuesto de normalidad solo vale para muestras grandes.
Pregunta 5 [M] — La identidad central de la sesión
La igualdad \(t^2=(n-k)\,\mathrm{SEC}/\mathrm{SRC}\), válida en la regresión simple, dice que:
- El estadístico \(t\) y el \(R^2\) miden cosas independientes, y conviene mirar los dos porque se refuerzan.
- El estadístico \(t\) compara la longitud del cateto explicado con la del cateto residual, corregida por el factor \(\sqrt{n-k}\): no mide nada que el \(R^2\) no midiera ya.
- El estadístico \(t\) solo depende del número de observaciones.
- La identidad es válida únicamente si \(\hat\beta_2>0\).
Pregunta 6 [D] — Una estimación nula, en términos geométricos
En la regresión simple, ¿qué configuración geométrica de los vectores corresponde exactamente a una estimación nula, \(\hat\beta_2=0\)?
- El vector de datos en desviaciones es ortogonal a la recta generada por el regresor en desviaciones: cateto explicado nulo, ángulo de \(90^\circ\), \(\mathrm{SEC}=0\).
- El vector de datos en desviaciones está alineado con el regresor en desviaciones: ángulo de \(0^\circ\).
- El vector de residuos es nulo.
- El regresor en desviaciones es el vector nulo.
Pregunta 7 [D] — Por qué el valor crítico depende de \(n-k\)
Con \(n=2\) observaciones y \(k=2\) coeficientes, la recta pasa exactamente por los dos puntos y \(R^2=1\). ¿Qué dice el aparato de esta lección sobre ese caso, y qué se aprende de él?
- Que el contraste rechaza \(H_0\) con toda seguridad, porque el ajuste es perfecto.
- Que \(n-k=0\): no hay grados de libertad, \(\mathfrak s^2\) es un cociente \(0/0\) y no existe contraste posible. Un ángulo pequeño con muy pocas observaciones no prueba nada, y de ahí que el valor crítico dependa de \(n-k\).
- Que el contraste no rechaza nunca, porque \(\mathrm{SRC}=0\).
- Que el caso es irrelevante, porque la teoría de esta lección exige \(n\) grande.
Pregunta 8 [M] — Interpretación del intervalo de confianza
Se obtiene el intervalo al \(95\,\%\) \([0{,}46;\,0{,}54]\) para \(\beta_2\). La lectura correcta es:
- Hay una probabilidad de \(0{,}95\) de que \(\beta_2\) esté entre \(0{,}46\) y \(0{,}54\).
- El \(95\,\%\) de los valores posibles de \(\beta_2\) están en ese rango.
- Los extremos del intervalo, calculados sobre la muestra aleatoria, son variables aleatorias, y el suceso ``el intervalo contiene a \(\beta_2\)'' tiene probabilidad \(0{,}95\); sobre este intervalo concreto, ya calculado, solo cabe decir que acierta o no acierta.
- El \(95\,\%\) de las observaciones de la muestra son compatibles con ese rango de pendientes.
Pregunta 9 [M] — Intervalo y contraste son el mismo objeto
El intervalo de confianza al \(95\,\%\) para \(\beta_2\) es \([0{,}46;\,0{,}54]\). ¿Qué puede afirmarse sin hacer ningún cálculo más?
- Nada: el contraste y el intervalo son herramientas distintas y requieren cálculos distintos.
- Que \(H_0\!:\beta_2=0\) se rechaza al \(5\,\%\), y que \(H_0\!:\beta_2=0{,}5\) no se rechaza: el intervalo es el conjunto de hipótesis que no se rechazan.
- Que \(H_0\!:\beta_2=0\) no se rechaza, porque el cero está por debajo del intervalo.
- Que el valor \(p\) del contraste contra cero es \(0{,}05\).
Pregunta 10 [B] — Las columnas derivadas de una tabla de resultados
Si se multiplican por \(100\) las unidades en que se mide el regresor, ¿qué columnas de la tabla de resultados cambian?
- Ninguna: la tabla es invariante ante cambios de unidades.
- Todas, y en el mismo factor.
- Cambian el coeficiente y su error estándar (ambos en el mismo factor), y no cambian el estadístico \(t\) ni el valor \(p\), porque son un cociente de las dos primeras.
- Cambian solo el estadístico \(t\) y el valor \(p\).
Pregunta 11 [D] — Significación y relevancia
Con \(n=1002\) observaciones se obtiene un \(R^2\) de \(0{,}01\) y un coeficiente significativo al \(5\,\%\) (\(\vert t\vert=3{,}18\)). ¿Cómo se explica, y qué debe concluirse?
- Hay un error de cálculo: con un \(R^2\) tan bajo el coeficiente no puede ser significativo.
- Que el modelo es bueno, porque la significación es lo que importa y el \(R^2\) es secundario.
- Que \(\vert t\vert\) mezcla la fuerza de la relación (el ángulo, aquí de \(84^\circ\): casi ortogonalidad) con el tamaño de la muestra (\(\sqrt{n-k}\)): el efecto es distinguible de cero, lo que no dice nada sobre si es grande. Hay que mirar el coeficiente en las unidades del problema y el intervalo.
- Que con muestras grandes el contraste \(t\) deja de ser válido.
Pregunta 12 [D] — Qué se ha demostrado hoy y qué se ha enunciado
De los siguientes resultados de la sesión, ¿cuál se ha demostrado y cuál se ha enunciado sin demostrar?
- Se ha demostrado que el estadístico sigue una \(t_{n-k}\), y se ha enunciado sin demostrar la identidad \(t^2=(n-k)\mathrm{SEC}/\mathrm{SRC}\).
- Se ha demostrado la identidad \(t^2=(n-k)\mathrm{SEC}/\mathrm{SRC}\) (con la geometría de las lecciones 8 y 11); la distribución \(t_{n-k}\) del estadístico, y que sea la del ángulo bajo \(H_0\), se han enunciado en la sesión y demostrado en el apéndice (html) a partir de una propiedad de la normal que sí queda sin demostrar.
- Se ha demostrado todo, incluida la distribución del ángulo.
- No se ha demostrado nada: la sesión entera se apoya en resultados externos.
12. Respuestas htmlonly
- Pregunta 1 [B] — Qué añade el supuesto de normalidad
Respuesta correcta: 3. Evalúa: que se entienda el papel exacto de un supuesto distribucional: fija la forma, no los momentos. Descarta la confusión frecuente de creer que la normalidad es necesaria para la insesgadez, que el laboratorio anterior ya desmintió empíricamente.
- Pregunta 2 [B] — Qué mide un error estándar
Respuesta correcta: 2. Evalúa: la distinción entre desviación típica (dispersión de datos) y error estándar (dispersión de un estimador), que la traducción española de las salidas de los programas tiende a borrar. La opción 4 es especialmente tentadora y es falsa: esa distancia es desconocida.
- Pregunta 3 [M] — Lectura geométrica del error estándar
Respuesta correcta: 1. Evalúa: la lectura del error estándar como cociente de longitudes, y su consecuencia práctica, que para medir el efecto de una variable hace falta que esa variable varíe, y que es la misma idea que reaparecerá en la colinealidad.
- Pregunta 4 [M] — Por qué aparece la \(t\) de Student
Respuesta correcta: 3. Evalúa: comprensión de que la \(t\) es el resultado exacto de dividir por una cantidad estimada. Discrimina porque la opción 2 recoge una creencia muy extendida y exactamente invertida: es la normal la que aproxima a la \(t\) cuando \(n-k\) crece, no al contrario.
- Pregunta 5 [M] — La identidad central de la sesión
Respuesta correcta: 2. Evalúa: la idea que vertebra la sesión. La opción 1 es la lectura ingenua que conviene destruir: un \(R^2\) alto y un \(t\) alto no son dos pruebas que se sumen, son la misma medida dicha dos veces. La opción 4 confunde la identidad (escrita para \(\vert t\vert\)) con su validez.
- Pregunta 6 [D] — Una estimación nula, en términos geométricos
Respuesta correcta: 1. Evalúa: la traducción de una estimación a una configuración geométrica (conviene recordar en clase que \(H_0\!:\beta_2=0\) habla del parámetro y no fija esta configuración). Discrimina porque exige recordar que \(\boldsymbol{\mathop{\widehat y}}-\boldsymbol{\mathop{\overline y}}=\hat\beta_2(\boldsymbol x-\boldsymbol{\mathop{\overline x}})\): si la estimación se anula, el cateto explicado desaparece y solo queda el residuo.
- Pregunta 7 [D] — Por qué el valor crítico depende de \(n-k\)
Respuesta correcta: 2. Evalúa: la conexión entre un resultado de la lección 5 (en \(\mathbb{R}^2\) la correlación es siempre \(\pm1\)) y los grados de libertad de la inferencia. Es la pregunta que mejor distingue a quien ha entendido por qué hay que corregir el ángulo por la dimensión.
- Pregunta 8 [M] — Interpretación del intervalo de confianza
Respuesta correcta: 3. Evalúa: que la garantía del intervalo es sobre el procedimiento y no sobre el parámetro, porque el parámetro no es aleatorio. La opción 1 es el error más común y el más difícil de erradicar.
- Pregunta 9 [M] — Intervalo y contraste son el mismo objeto
Respuesta correcta: 2. Evalúa: la equivalencia exacta entre el intervalo al \(1-\alpha\) y el contraste al \(\alpha\), que ahorra memorizar dos recetas. La opción 3 comprueba que se lee bien la posición del cero respecto del intervalo.
- Pregunta 10 [B] — Las columnas derivadas de una tabla de resultados
Respuesta correcta: 3. Evalúa: que se entienda qué columnas de la tabla son informativas y cuáles derivadas. Tiene una consecuencia práctica inmediata: el estadístico \(t\) y el valor \(p\), al ser invariantes ante cambios de unidades, son inservibles para valorar la magnitud de un efecto.
- Pregunta 11 [D] — Significación y relevancia
Respuesta correcta: 3. Evalúa: la descomposición de la significación en fuerza de la relación y tamaño de la muestra, y su consecuencia al leer estudios con muestras grandes, donde casi cualquier coeficiente resulta significativo.
- Pregunta 12 [D] — Qué se ha demostrado hoy y qué se ha enunciado
Notas al pie de página:
Una precisión notacional. Dentro del símbolo \(N(0,\sigma^2)\), los argumentos \(0\) y \(\sigma^2\) son parámetros de una distribución, dos números, no variables aleatorias. Por eso aquí escribimos \(0\) a secas, y no \(\mathit 0\): la regla del curso que obliga a escribir \(\beta_1\,\mathit1\) en lugar de \(\beta_1\) se aplica cuando un escalar se combina (se suma, se multiplica) con variables aleatorias, para mantener el paralelismo dimensional; no se aplica a los argumentos de una distribución. Compárese: \(E[U_i\mid\boldsymbol X]=\mathit0\) es una igualdad entre variables aleatorias (la esperanza condicional lo es), mientras que ``la esperanza de esa normal es \(0\)'' es una afirmación sobre el valor numérico de un parámetro.
El término de los manuales, ``perturbaciones esféricas'', no es sinónimo: significa solo que las perturbaciones tienen la misma varianza y covarianzas nulas (nuestra familia ortogonal de la misma longitud) y no dice nada sobre la forma de la distribución. Unas perturbaciones uniformes independientes son esféricas en ese sentido y no son isótropas: sus realizaciones llenan un cubo, y un cubo tiene direcciones privilegiadas, sus diagonales. La isotropía es más fuerte: la distribución entera es invariante por giros, no solo sus segundos momentos. Con componentes independientes equivale exactamente a la normalidad (teorema de Maxwell). Por eso ``isotropía'' es el nombre geométrico del supuesto de hoy.
La confusión se agrava con la traducción. En inglés, la salida de un programa como Gretl distingue ``S.D. dependent var'' (standard deviation: dispersión de los datos del regresando) de ``S.E. of regression'' (standard error) y de la columna ``Std. Error'' de cada coeficiente. En la versión española de Gretl las tres se rotulan como desviación típica (``D.T. de la vble. dep.'', ``D.T. de la regresión'' y la cabecera ``Desv. típica'' de la columna de los coeficientes), de modo que tres cantidades conceptualmente distintas comparten etiqueta. Volveremos sobre ello en la transparencia dedicada a leer una tabla de resultados.
Pero esos valores son los más empleados únicamente por costumbre, no por un argumento objetivo. Tiene más sentido fijarlo según cuánto nos preocupe cada uno de los dos errores posibles: rechazar \(H_0\) siendo cierta, cuya probabilidad es \(\alpha\), y no rechazarla siendo falsa, que es tanto más probable cuanto menor sea \(\alpha\).
En los dos paneles el regresor toma valores igualmente espaciados alrededor de \(50\); lo único que cambia es el paso (\(0{,}5\) frente a \(5\)). Al ser el mismo patrón multiplicado por una constante, el vector en desviaciones tiene la misma dirección y una longitud diez veces mayor, y la proyección de la realización del ruido sobre esa dirección, y por tanto el residuo, es idéntica. De ahí que \(\mathrm{SRC}\) y \(\mathfrak s\) coincidan exactamente en ambos paneles, y que toda la diferencia recaiga sobre el denominador del error estándar.
Hay enfoques de la estadística, los llamados bayesianos, en los que sí tiene sentido asignar una distribución de probabilidad a un parámetro desconocido, y en los que existe un objeto (el intervalo de credibilidad) del que sí puede decirse ``contiene a \(\beta_2\) con probabilidad \(0{,}95\)''. Son objetos distintos, construidos con supuestos distintos, y a veces numéricamente parecidos. El de este curso es el intervalo de confianza clásico, y su garantía es la que se ha descrito: sobre el procedimiento.
Hay una relación entre las dos primeras. La ``desviación típica de la variable dependiente'' que imprimen los programas es \(\sqrt{\mathrm{STC}/(n-1)}\), es decir, exactamente la misma fórmula que \(\mathfrak s=\sqrt{\mathrm{SRC}/(n-k)}\) evaluada en el modelo con un único regresor, la constante (\(k=1\)): en ese modelo el ajuste es el vector de medias y el residuo es el vector en desviaciones, luego \(\mathrm{SRC}=\mathrm{STC}\) y \(n-k=n-1\). La ``dispersión de los datos'' es, por tanto, el caso degenerado de la ``dispersión residual'' cuando el modelo no aporta nada más que la media. El apéndice (sección 7.2) (html) hace la misma observación desde el otro lado: el divisor \(n-1\) de la varianza muestral es el caso \(k=1\) de la insesgadez de \(\mathfrak s^2\).
Si no lo dice, los propios asteriscos permiten deducirlo, porque marcan los coeficientes con \(|t|\) por encima del valor crítico, que ronda el \(2\). Si el paréntesis contuviera el estadístico \(t\), un coeficiente con asteriscos llevaría en él un número mayor que \(2\); si lleva uno pequeño, como el \(0{,}02\) del ejemplo, el paréntesis es el error estándar, y el \(t\) se obtiene dividiendo, \(0{,}5/0{,}02=25\), que es coherente con los asteriscos. Basta comprobar cuál de las dos lecturas cuadra con las estrellas de la tabla.