Lección 13. El contraste \(F\): significación conjunta
Índice
- 1. De dónde venimos: los contrastes \(t\) son individuales
- 2. La hipótesis conjunta
- 3. El estadístico \(F\)
- 4. Lectura geométrica: la misma figura
- 5. El \(F\) en una tabla de resultados
- 6. Restricciones lineales: modelos anidados
- 7. Tres restricciones sobre
hprice2 - 8. Conjunto \(\neq\) individual: el caso de la apertura
- 9. Qué dice y qué no dice el \(F\)
- 10. Recapitulación y guiño a las sesiones siguientes
- 11. Preguntas de repaso (sesión 19) htmlonly
- 12. Respuestas htmlonly
Hoy haremos preguntas sobre varios coeficientes a la vez: ¿aportan algo en conjunto estos regresores?, ¿tienen el mismo efecto estas dos variables?, ¿suman uno estos dos coeficientes? Las responde el estadístico \(F\): la razón entre las longitudes al cuadrado de los dos catetos del triángulo de la lección 8, cada una dividida por sus grados de libertad. La segunda mitad enseña a leer el \(F\) de una tabla de resultados: qué afirma y qué no.
``Varios coeficientes, una hipótesis: hace falta un estadístico que mire en varias direcciones a la vez.''
1. De dónde venimos: los contrastes \(t\) son individuales
La lección 12 juzga un coeficiente cada vez, \(t=\hat\beta_j/\mathrm{ee}(\hat\beta_j)\), y demostró (con \(k=2\)) que \(t^2=(n-k)\,\mathrm{SEC}/\mathrm{SRC}\). En la práctica A de la sesión 18, al pie de la tabla de price sobre rooms (actividad 1), apareció un \(F(1,504)=472{,}95\) que la actividad 3 comprobó igual a \(t^2\).
Un caso real (hprice2; price sobre rooms, nox y su logaritmo lnox):
| Regresor | Coeficiente | Error estándar | Estadístico \(t\) | Valor \(p\) |
|---|---|---|---|---|
rooms |
8161,84 | 418,34 | 19,51 | \(1{,}65\cdot10^{-63}\) |
nox |
404,19 | 2198,85 | 0,18 | 0,854 |
lnox |
-13262,2 | 12655,7 | -1,05 | 0,295 |
¿Sobran nox y lnox? Cada \(t\) por separado no lo descarta. Pero la pregunta es sobre los dos a la vez, y eso ningún \(t\) lo contesta. Hoy: el \(F\) por derecho propio, y con él la respuesta a esta última pregunta al final.
De dónde venimos: los contrastes \(t\) son individuales
Todo el aparato de la lección 12 (error estándar, intervalo de confianza, contraste \(t\)) se pronuncia sobre un coeficiente cada vez. Es lo natural cuando la pregunta es ``¿interviene este regresor?'', y es lo que hace la tabla de resultados fila a fila. Pero muchas preguntas económicas no son sobre un coeficiente, sino sobre varios a la vez: ¿aportan algo en conjunto estos tres regresores?, ¿tienen el mismo efecto estas dos variables?, si la suma de dos coeficientes valiese uno, ¿serían estos datos demasiado raros? Ninguna de ellas se responde con una fila de la tabla. Hoy construimos la herramienta que las responde a todas.
Dos piezas de las sesiones anteriores bastan para construirla. La primera es la identidad de la lección 12, \(t^2=(n-k)\,\mathrm{SEC}/\mathrm{SRC}\): el cuadrado del estadístico \(t\) es la razón entre las longitudes al cuadrado de los dos catetos del triángulo de la lección 8, multiplicada por los grados de libertad del residuo, \(n-k\). La segunda es una observación de la práctica A de la sesión 18: al pie de toda tabla de regresión Gretl imprime un número rotulado \(F\), y en la regresión simple de price sobre rooms (actividad 1 (html)) ese número, \(472{,}95\), coincidía con \(t^2\).1 Allí dijimos que ese \(F\) es el cociente entre \(\mathrm{SEC}\) y \(\mathrm{SRC}\), cada una dividida por sus grados de libertad, y que la lección 13 lo usaría para contrastar una hipótesis conjunta. Esa conversión es la lección de hoy.
La tabla de la transparencia es el caso que motiva la sesión. Es una regresión con datos reales (las viviendas de hprice2 de los laboratorios) del precio mediano sobre tres regresores: el número de habitaciones y dos medidas de la contaminación del aire, la concentración de óxidos de nitrógeno nox y su logaritmo lnox. Los coeficientes de nox y lnox tienen ambos un valor \(p\) muy alto: \(0{,}854\) y \(0{,}295\). Si uno lee la tabla como enseñó la lección 12, fila a fila, podría asumir que ninguno de los dos interviene y que ambos sobran. Sin embargo, como veremos en la sección ``Conjunto \(\neq\) individual'', si se quitan los dos a la vez el ajuste empeora más de lo que cabe esperar por azar: la contaminación sí aporta al ajuste. El error está en contestar a una pregunta conjunta sobre dos coeficientes con dos respuestas a preguntas sobre coeficientes individuales.
Sobre el reparto de la sesión: tras la apertura, las tres transparencias siguientes construyen el contraste \(F\) de significación conjunta y lo leen en el triángulo rectángulo de la lección 8, el que forman el vector de datos en desviaciones, el ajuste en desviaciones y el residuo; la quinta lo lee en una tabla de Gretl; la sexta y la séptima lo generalizan a cualquier hipótesis lineal sobre los coeficientes; las dos siguientes lo interpretan, y la décima recapitula.
Para profundizar: Wooldridge, J. M. (2020), cap. 4, introducción a la sección 4.5 (por qué los contrastes \(t\) individuales no responden a hipótesis sobre varios coeficientes).
2. La hipótesis conjunta
Significación conjunta: \(H_0\!:\beta_2=\beta_3=\cdots=\beta_k=0\) (``ningún regresor no constante aporta nada'') frente a \(H_1\!:\) al menos uno es distinto de cero.
Geométricamente: bajo \(H_0\) el modelo poblacional se reduce al regresor constante, \(Y=\beta_1\,\mathit1+U\), y el ajuste que respeta \(H_0\) es el vector de medias \(\boldsymbol{\mathop{\overline y}}\). Aunque \(H_0\) sea cierta, el ajuste con más regresores \(\boldsymbol{\mathop{\widehat y}}\) no coincide con \(\boldsymbol{\mathop{\overline y}}\): esos regresores recogen parte de la perturbación, y el cateto explicado tiene longitud positiva. La pregunta es si esa longitud es mayor de lo que cabe esperar por azar.
¿Por qué no \(k-1\) contrastes \(t\)? Cada \(t\) juzga a su regresor con los demás dentro del modelo; ``todos no significativos uno a uno'' no es ``todos nulos a la vez'' (la tabla de la apertura).
Cada \(t\) mide una sola dirección. La significación conjunta pide un estadístico que mida el cateto explicado entero, en su subespacio de dimensión \(k-1\).
La hipótesis conjunta
Un contraste muy frecuente es el de significación conjunta, cuya hipótesis nula es: que todos los coeficientes de los regresores no constantes sean cero a la vez, \(\beta_2=\cdots=\beta_k=0\). En términos del modelo poblacional de la lección 10, \(Y=\beta_1\,\mathit1+\beta_2X_2+\cdots+\beta_kX_k+U\), dice que ninguno de los regresores interviene: \(Y=\beta_1\,\mathit1+U\). En ese caso la esperanza condicional de \(Y\) dados los regresores, \(E[Y\mid X_2,\ldots,X_k]\), es la constante \(\beta_1\,\mathit1\), la misma que se obtiene al condicionar solo a la constante, \(E[Y\mid\mathit1]\): conocer los regresores no mejora la predicción de \(Y\) que se hace sin ellos. La estimación de esa constante es la media de los datos, \(\overline y\). La hipótesis alternativa es la negación lógica: al menos uno de esos coeficientes es distinto de cero. En ese caso \(E[Y\mid X_2,\ldots,X_k]\) no es constante y se aproxima a \(Y\) más que \(E[Y\mid\mathit1]\). \(H_1\) es poco exigente: no dice cuál ni cuántos regresores contribuyen a esa mejora, solo que los coeficientes no son todos nulos.
El párrafo anterior enuncia la hipótesis en la población. Con los datos, la traducción geométrica es la del ajuste en \(\mathbb R^n\) y usa el vocabulario de la lección 10. El ajuste \(\boldsymbol{\mathop{\widehat y}}\) es la proyección de \(\boldsymbol y\) sobre \(\mathcal L(\boldsymbol 1,\boldsymbol x_2,\ldots,\boldsymbol x_k)\), y el triángulo rectángulo de la lección 8 (hipotenusa \(\boldsymbol y-\boldsymbol{\mathop{\overline y}}\), catetos \(\boldsymbol{\mathop{\widehat y}}-\boldsymbol{\mathop{\overline y}}\) y \(\boldsymbol{\mathop{\widehat e}}\)) sigue existiendo sea cual sea \(k\), como anunció la lección 8 y comprobó la lección 10.
Si \(H_0\) fuese cierta, el modelo poblacional no contendría ningún regresor distinto de la constante y el ajuste correspondiente a \(H_0\) sería el vector de medias; consecuentemente, el cateto explicado \(\boldsymbol{\mathop{\widehat y}}-\boldsymbol{\mathop{\overline y}}\) ``debería'' ser nulo.2
En la práctica ese cateto no será cero ni siquiera con \(H_0\) cierta: para que lo fuera debería ocurrir que el vector de datos en desviaciones \(\boldsymbol y-\boldsymbol{\mathop{\overline y}}\) fuera ortogonal a todos los regresores en desviaciones, y, con la perturbación normal de la lección 12, eso tiene probabilidad cero. Por tanto, la pregunta que el contraste tiene que responder es si el cateto explicado es más largo de lo que cabe esperar que sea por azar cuando \(H_0\) es cierta. Es la misma pregunta de la lección 12, con una diferencia: allí el cateto explicado vivía en una recta (la del regresor en desviaciones) y aquí vive en un subespacio de dimensión \(k-1\) (el de los \(k-1\) regresores en desviaciones, lección 10).
Para responder no basta con mirar los \(k-1\) contrastes \(t\) de la tabla. La razón está en el contenido de la hipótesis: cada \(t\) contrasta \(H_0\!:\beta_j=0\) manteniendo a los demás regresores en el modelo. Es decir, el \(t\) de nox pregunta si nox aporta algo además de la constante, rooms y lnox, y el de lnox pregunta si aporta algo además de la constante, rooms y nox. Ambos pueden responder ``no se rechaza \(H_0\!:\beta_j=0\)'' y, sin embargo, el contraste conjunto puede rechazar que los dos coeficientes sean cero a la vez (datos como estos serían muy raros si lo fuesen). ``Todos individualmente nulos'' y ``todos simultáneamente nulos'' son afirmaciones distintas, y la segunda constituye la \(H_0\) para el contraste de significación conjunta.3
Para profundizar: Wooldridge, J. M. (2020), cap. 4, sección 4.5 (``Testing multiple linear restrictions'': el planteamiento de la hipótesis conjunta y por qué los \(t\) individuales no la contrastan).
3. El estadístico \(F\)
Los dos catetos de la lección 8, cada uno dividido por sus grados de libertad (\(k-1\) el explicado, \(n-k\) el residuo): \[ \boxed{\;F=\frac{\mathrm{SEC}/(k-1)}{\mathrm{SRC}/(n-k)}\;} \qquad\text{(el denominador es $\mathfrak s^2$).} \] \(k-1\) es el número \(q\) de restricciones que impone \(H_0\) (\(\beta_2=0,\ldots,\beta_k=0\)). El estadístico general divide por dicho número; este es el caso \(q=k-1\).
Las coordenadas de la perturbación en una base ortonormal son variables aleatorias ortogonales y de la misma longitud \(\sigma\) (homocedasticidad e incorrelación). Bajo \(H_0\), \(\mathrm{SEC}\) suma \(k-1\) de sus cuadrados y \(\mathrm{SRC}\) las otras \(n-k\). Divididas por su número de sumandos, el numerador y el denominador de \(F\) estiman los dos \(\sigma^2\), y \(F\approx1\). Si \(H_0\) es falsa, el efecto de los regresores se suma al cateto explicado y no al residuo: solo crece el numerador. Un \(F\) mucho mayor que \(1\) es evidencia contra \(H_0\).
Enunciado (demostración en el apéndice): bajo \(H_0\), \(\;F\sim F_{k-1,\,n-k}\). Se rechaza al nivel \(\alpha\) si \(F>F_c\), con \(F_c\) el valor que deja \(\alpha\) en la cola derecha (una sola cola: \(F\) compara longitudes, no tiene signo). Valor \(p\): \(\mathrm{P}(F_{k-1,\,n-k}>F)\).
El estadístico \(F\)
La lección 12 dejó el estadístico \(t\) escrito como \(t^2=\frac{\mathrm{SEC}/1}{\mathrm{SRC}/(n-k)}\), y en su recapitulación hizo notar que ese \(1\) es \(k-1\) con \(k=2\). Con \(k-1\) en su sitio, la misma fórmula es el estadístico \(F\): \[ F=\frac{\mathrm{SEC}/(k-1)}{\mathrm{SRC}/(n-k)}. \] El curso ya conoce los dos divisores. El denominador, \(\mathrm{SRC}/(n-k)\), es la cuasivarianza de los residuos \(\mathfrak s^2\) de la lección 11: la suma de cuadrados del residuo dividida por los grados de libertad del residuo, la dimensión \(n-k\) del subespacio \(\mathcal L(\boldsymbol 1,\boldsymbol x_2,\ldots,\boldsymbol x_k)^\perp\) donde el residuo vive. El numerador hace lo mismo con el otro cateto: \(\mathrm{SEC}=\Vert\boldsymbol{\mathop{\widehat y}}-\boldsymbol{\mathop{\overline y}}\Vert_e^2\) es la suma de cuadrados del cateto explicado, y \(k-1\) son sus grados de libertad, los grados de libertad del ajuste. El ajuste \(\boldsymbol{\mathop{\widehat y}}\) vive en \(\mathcal L(\boldsymbol 1,\boldsymbol x_2,\ldots,\boldsymbol x_k)\), de dimensión \(k\) si las columnas de \(\boldsymbol{\mathsf X}\) son linealmente independientes; el ajuste en desviaciones es, además, ortogonal a \(\boldsymbol 1\), y esa condición deja el subespacio de los regresores en desviaciones, de dimensión \(k-1\) (lección 10). Así que \(F\) compara los dos catetos por grado de libertad.
El divisor \(k-1\) es el número de restricciones que impone \(H_0\) sobre los coeficientes: \(\beta_2=0,\ldots,\beta_k=0\). Esa lectura es la que vale para cualquier hipótesis lineal. Cada restricción quita una dimensión al subespacio donde vive el ajuste, y las \(k-1\) juntas lo reducen de \(\mathcal L(\boldsymbol 1,\boldsymbol x_2,\ldots,\boldsymbol x_k)\) a \(\mathcal L(\boldsymbol 1)\). No hay un estadístico \(F\) para la significación conjunta y otro para las demás hipótesis: hay uno solo, que divide el numerador por el número de restricciones, \(q\), y el de esta sección es el caso \(q=k-1\). La sección ``Restricciones lineales: modelos anidados'' lo escribe para cualquier \(q\).
El motivo de dividir es este. Si en cada subespacio se toma una base de vectores ortogonales de longitud \(1\), la longitud al cuadrado de un vector es la suma de sus coordenadas al cuadrado (Pitágoras generalizado, lección 10): el cateto explicado suma \(k-1\) coordenadas al cuadrado y el residuo, \(n-k\). Un cateto puede ser largo por dos motivos: porque sus coordenadas son grandes o porque son muchas. Comparar las dos sumas tal cual mezclaría los dos motivos: con \(n=500\) y \(k=3\), el residuo suma \(497\) cuadrados y el cateto explicado solo \(2\), así que el residuo sería más largo aunque todas las coordenadas fuesen del mismo tamaño. Dividir cada suma por su número de coordenadas elimina el segundo motivo y deja solo el primero, el tamaño de las coordenadas: \(\mathrm{SEC}/(k-1)\) es la media de las coordenadas al cuadrado del cateto explicado y \(\mathrm{SRC}/(n-k)\), la del residuo, y dos medias sí se pueden comparar aunque una tenga \(2\) sumandos y la otra \(497\). \(F\) es el cociente de esas dos medias, y el párrafo siguiente dice por qué deben parecerse bajo \(H_0\).4 Recuerde el aviso de la lección 8 sobre las siglas: en su curso de Estadística, SCR era la suma de regresión, nuestra \(\mathrm{SEC}\), y SCE la suma del error, nuestra \(\mathrm{SRC}\).
¿Por qué sirve ese cociente para contrastar \(H_0\)? Supongamos \(H_0\) cierta. El argumento tiene dos pasos: el primero con los datos, en \(\mathbb R^n\); el segundo con la muestra aleatoria.
Con los datos. Bajo \(H_0\) el modelo poblacional es \(Y=\beta_1\,\mathit1+U\) y, como vimos en la lección 12, \(Y_i-\overline Y=U_i-\overline U\) para cada \(i\): la hipotenusa del triángulo, \(\boldsymbol y-\boldsymbol{\mathop{\overline y}}\), es la realización de las perturbaciones centradas. Tomemos una base ortonormal de \(\mathcal L(\boldsymbol 1)^\perp\) como la de la lección 12 (vectores de longitud \(1\) y ortogonales dos a dos), ahora con sus \(k-1\) primeros vectores en el subespacio de los regresores en desviaciones (el que el apéndice (html) llama \(\mathcal E\)) y los \(n-k\) restantes en el del residuo (\(\mathcal R\)). La hipotenusa tiene \(n-1\) coordenadas en esa base, que son números. El cateto explicado es la parte de la hipotenusa en el primer subespacio y el residuo, su parte en el segundo; así que \(\mathrm{SEC}\) es la suma de los cuadrados de las \(k-1\) primeras coordenadas y \(\mathrm{SRC}\), la de las otras \(n-k\) (Pitágoras generalizado, lección 10).
Con la muestra aleatoria. Las fórmulas que calculan esas \(n-1\) coordenadas, evaluadas sobre la muestra aleatoria, son las coordenadas de la perturbación de la lección 12: variables aleatorias ortogonales entre sí y de la misma longitud \(\sigma\), de modo que cada cuadrado tiene esperanza \(\sigma^2\) (en adelante, coordenadas de la perturbación nombra siempre esas variables aleatorias). \(\mathrm{SEC}\) y \(\mathrm{SRC}\), evaluadas sobre la muestra aleatoria, son sumas de \(k-1\) y de \(n-k\) de esos cuadrados. Por tanto, bajo \(H_0\), la longitud al cuadrado del cateto explicado vale en promedio \((k-1)\sigma^2\) y la del residuo, \((n-k)\sigma^2\).5
Para estas dos esperanzas bastan la homocedasticidad y la incorrelación de la lección 11; la demostración está en el apéndice (sección 7, Resultados 1 y 2) (html).6 Dividiendo cada una por sus grados de libertad, numerador y denominador de \(F\) estiman ambos \(\sigma^2\), y su cociente debe rondar \(1\).
Si \(H_0\) es falsa, el apéndice (sección 7.2) (html) muestra también qué cambia: las coordenadas en \(\mathcal E\) llevan sumadas las coordenadas del efecto de los regresores no constantes, el vector de componentes \(\beta_2(X_{i2}-\overline X_2)+\cdots+\beta_k(X_{ik}-\overline X_k)\), que el apéndice llama la parte sistemática (sección 6.4 (html)); su suma de cuadrados crece, y el numerador estima \(\sigma^2\) más algo positivo. El denominador no cambia, porque ese efecto está en el subespacio de los regresores y no tiene coordenadas en \(\mathcal R\). Un \(F\) mucho mayor que \(1\) es evidencia contra \(H_0\); un \(F\) cercano a \(1\) (o menor) es lo que cabe esperar bajo \(H_0\). La normalidad, como en la lección 12, hará falta para la distribución del cociente.
Para convertir esta idea en un contraste con nivel de significación hace falta saber cuánto mayor que \(1\) es ``mucho'', y eso exige la distribución de \(F\) bajo \(H_0\). Igual que en la lección 12 con la \(t\) de Student, la sesión la enuncia y el apéndice la demuestra: bajo \(H_0\) y los supuestos de la lección 12, el estadístico sigue una distribución \(F\) de Fisher–Snedecor con \(k-1\) y \(n-k\) grados de libertad, \(F_{k-1,\,n-k}\). Es una distribución que solo toma valores positivos, asimétrica, con esperanza próxima a \(1\) cuando \(n-k\) es grande y una cola derecha larga. Su forma depende de los dos números de grados de libertad, las dos dimensiones de los subespacios donde viven los catetos del triángulo. Son los grados de libertad del ajuste, \(k-1\), uno por regresor no constante, y los grados de libertad del residuo, \(n-k\).7
La regla de decisión tiene una novedad respecto a la lección 12: la región crítica está en una sola cola. Se rechaza \(H_0\) al nivel \(\alpha\) si \(F>F_c\), donde \(F_c\) es el valor de la \(F_{k-1,\,n-k}\) que deja probabilidad \(\alpha\) a su derecha. No hay cola izquierda porque \(F\) compara longitudes al cuadrado y no tiene signo: un \(F\) pequeño dice que el cateto explicado es corto, que es lo que \(H_0\) predice. El valor \(p\) es la probabilidad de un valor al menos tan grande como el observado si \(H_0\) fuese cierta, \(\mathrm{P}(F_{k-1,\,n-k}>F)\), y Gretl lo imprime al lado del \(F\) al pie de cada tabla.
Para profundizar: Wooldridge, J. M. (2020), cap. 4, sección 4.5 (el estadístico \(F\) y su distribución bajo la hipótesis nula); apéndice B (distribuciones \(\chi^2\), \(t\) y \(F\) y la relación \(t^2_{\nu}=F_{1,\nu}\)).
4. Lectura geométrica: la misma figura
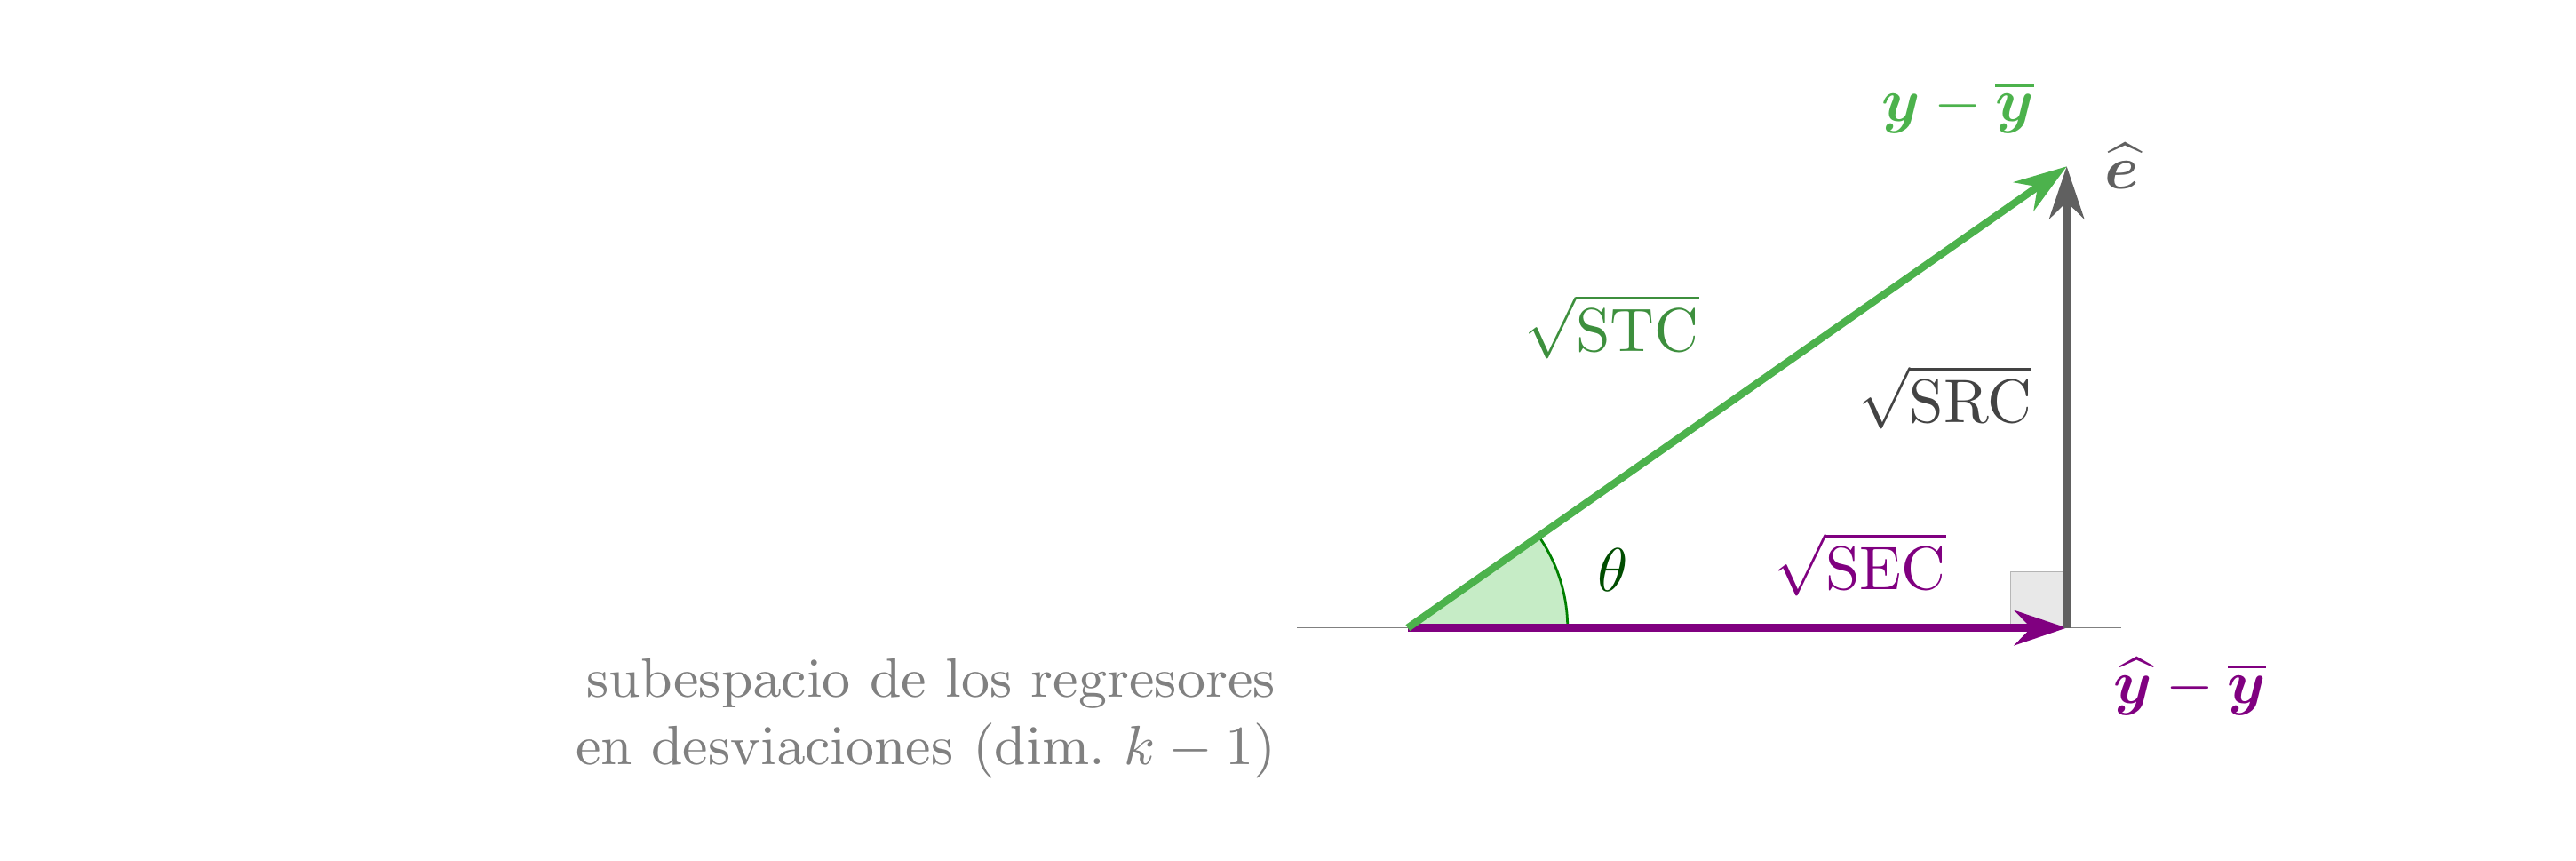
Figura 1: El triángulo de las lecciones 8 y 12, con un solo cambio: ya no hay un regresor medido bajo el eje. En verde, el vector de datos en desviaciones (hipotenusa, longitud \(\sqrt{\mathrm{STC}}\)); en violeta, el ajuste en desviaciones (cateto explicado, longitud \(\sqrt{\mathrm{SEC}}\)), que con varios regresores ya no es múltiplo de ninguno de ellos: el eje horizontal es ahora un subespacio de dimensión \(k-1\); en gris, el residuo (cateto residual, longitud \(\sqrt{\mathrm{SRC}}\)), en un subespacio de dimensión \(n-k\). El ángulo \(\theta\) es el de \(R^2=\cos^2\theta\). El estadístico \(F\) compara las longitudes al cuadrado de los dos catetos, cada una dividida por sus grados de libertad.
\[ F=\frac{n-k}{k-1}\cdot\frac{\mathrm{SEC}}{\mathrm{SRC}}=\frac{n-k}{k-1}\cdot\frac{R^2}{1-R^2}: \quad\text{función de $\theta$ y los grados de libertad} \]
Con \(k=2\): \(F=(n-2)\,\mathrm{SEC}/\mathrm{SRC}=t^2\), y también \(F_c=t_c^2\). El ejemplo de la lección 8 (\(n=5\)): \(F=\dfrac{90/1}{10/3}=27=t^2\); \(F_c(1,3)=10{,}13=3{,}182^2\). Bajo \(H_0\), \(R^2\) vale en promedio \((k-1)/(n-1)\) por azar: con ese \(R^2\), \(F=1\) y \(\bar R^2=0\).
Lectura geométrica: la misma figura
La figura es similar a la de la lección 12. Con \(k\) regresores el esquema del triángulo rectángulo de la bondad de ajuste (lección 8) se mantiene intacto: \(\mathrm{STC}=\mathrm{SEC}+\mathrm{SRC}\) y también se mantiene que \(R^2=\cos^2\theta\). El motivo es que el residuo MCO siempre es ortogonal al subespacio de los regresores; así que, en particular, \(\boldsymbol{\mathop{\widehat e}}\perp\boldsymbol{\mathop{\widehat y}}-\boldsymbol{\mathop{\overline y}}\) puesto que los vectores \(\boldsymbol{\mathop{\widehat y}}\) y \(\boldsymbol{\mathop{\overline y}}\) son combinación lineal de los regresores. Lo único que cambia en esta figura respecto a la lección 12 es el eje horizontal: el cateto explicado ya no es un múltiplo del regresor no constante en desviaciones, porque ahora hay \(k-1\) regresores y \(\boldsymbol{\mathop{\widehat y}}-\boldsymbol{\mathop{\overline y}}\) es una combinación de todos ellos que, en general, no está alineada con ninguno (lección 10). La recta horizontal representa aquí un subespacio de dimensión \(k-1\) (y en la lección 12 correspondía únicamente a los múltiplos del regresor no constante en desviaciones \((\boldsymbol{x}-\boldsymbol{\mathop{\overline x}})\)).
Escribamos \(F\) en términos del triángulo. Sacando los divisores fuera, \[ F=\frac{\mathrm{SEC}/(k-1)}{\mathrm{SRC}/(n-k)}=\frac{n-k}{k-1}\cdot\frac{\mathrm{SEC}}{\mathrm{SRC}}, \] y como \(\mathrm{SEC}/\mathrm{SRC}=R^2/(1-R^2)\),8 \[ F=\frac{n-k}{k-1}\cdot\frac{R^2}{1-R^2}. \] Es la misma estructura que la identidad de la lección 12 con un factor distinto: allí \(t^2=(n-k)\,R^2/(1-R^2)\); aquí el \(n-k\) se divide además por \(k-1\). (En el apéndice, sección 5.5 (html), la misma identidad sale de escribir el \(F\) con las coordenadas del vector de datos en desviaciones en una base ortonormal.) En los dos casos el estadístico es una función únicamente del ángulo \(\theta\) (vía \(R^2=\cos^2\theta\)) y de los grados de libertad del ajuste y del residuo. Y en los dos casos vale la misma lectura: el contraste no mide nada que el \(R^2\) no midiera ya; lo que añade es el cociente de los grados de libertad: los \(n-k\) del residuo por cada uno de los \(k-1\) del ajuste. Un \(R^2\) dado es tanto más sorprendente cuantas más observaciones haya (\(n-k\) grande) y cuantos menos regresores se hayan usado para conseguirlo (\(k-1\) pequeño).
La explicación está en el \(R^2\) que el azar produce por sí solo. Bajo \(H_0\) y con el supuesto de normalidad de la lección 12, las \(n-1\) coordenadas de la perturbación de la sección ``El estadístico \(F\)'' son independientes y todas tienen la distribución \(N(0,\sigma^2)\) (apéndice, Resultado 3 (html)); lo que sigue usa que son independientes y que todas tienen la misma distribución.9
Tomemos en \(\mathcal L(\boldsymbol 1)^\perp\) la base ortonormal de esa misma sección, cuyos \(k-1\) primeros vectores generan el subespacio de los regresores en desviaciones. Para cada realización, \(\mathrm{STC}\) es la suma de los cuadrados de las \(n-1\) coordenadas del vector de datos en desviaciones; evaluadas sobre la muestra aleatoria, esas \(n-1\) coordenadas son independientes y tienen la misma distribución (isotropía). Cada uno de sus cuadrados es una fracción de \(\mathrm{STC}\), y las \(n-1\) fracciones suman \(1\). Como ninguna coordenada se distingue de las demás, las \(n-1\) fracciones valen en promedio lo mismo: \(1/(n-1)\) cada una. El cateto explicado, \(\mathrm{SEC}\), es la suma de los \(k-1\) primeros cuadrados. Así que, cuando es cierta la \(H_0\) de significación conjunta, \(\beta_2=\cdots=\beta_k=0\), \(R^2=\mathrm{SEC}/\mathrm{STC}\) vale en promedio \((k-1)/(n-1)\): ese es el \(R^2\) que se obtiene sin que los regresores tengan nada que ver con el regresando. Crece con el número de regresores, porque cada regresor añadido aporta una coordenada más al cateto explicado; y decrece con \(n\), porque el mismo número de coordenadas es una fracción menor del total. Un \(R^2\) de \(0{,}30\) dice cosas distintas con \(n=11\) y \(k=4\), donde el azar da \(0{,}30\) en promedio, que con \(n=101\) y \(k=2\), donde el azar da \(0{,}01\).
El estadístico \(F\) compara el \(R^2\) observado con esa referencia. Llamemos \(r_0=(k-1)/(n-1)\) al valor que \(R^2\) toma en promedio bajo \(H_0\). Como \(r_0/(1-r_0)=(k-1)/(n-k)\), la fórmula de \(F\) se puede escribir
\[
F=\frac{R^2/(1-R^2)}{r_0/(1-r_0)}:
\]
el cociente \(\mathrm{SEC}/\mathrm{SRC}\) observado, dividido por el cociente que corresponde a la referencia. Por tanto \(F=1\) cuando \(R^2=r_0\), \(F>1\) cuando \(R^2>r_0\) y \(F<1\) cuando \(R^2
El coeficiente de determinación ajustado, \(\bar R^2\), de la actividad 5 (html) de la práctica B de la sesión 14 usa la misma referencia. Allí se definió dividiendo cada suma de cuadrados de \(R^2=1-\mathrm{SRC}/\mathrm{STC}\) por sus grados de libertad: \(\bar R^2=1-\frac{\mathrm{SRC}/(n-k)}{\mathrm{STC}/(n-1)}=1-(1-R^2)\frac{n-1}{n-k}\). Como \((n-k)/(n-1)=1-r_0\),
\[
\bar R^2=1-\frac{1-R^2}{1-r_0}=\frac{R^2-r_0}{1-r_0}.
\]
El numerador es la distancia de \(R^2\) a la referencia, y el denominador, la distancia de la referencia a \(1\). \(\bar R^2\) vale \(0\) cuando \(R^2=r_0\), vale \(1\) cuando \(R^2=1\) y es negativo cuando \(R^2
Con los dos ejemplos anteriores: si \(n=11\) y \(k=4\), la referencia es \(r_0=0{,}30\), y un \(R^2=0{,}30\) da \(F=1\) y \(\bar R^2=0\); si \(n=101\) y \(k=2\), la referencia es \(r_0=0{,}01\), y el mismo \(R^2=0{,}30\) da \(F=99\cdot0{,}30/0{,}70=42{,}4\) y \(\bar R^2=0{,}29/0{,}99=0{,}293\).
Los dos números se usan para cosas distintas. \(\bar R^2\) es descriptivo y no tiene un nivel de significación: \(\bar R^2>0\) solo dice que \(F>1\), y con \(H_0\) cierta un \(F\) algo mayor que \(1\) no es raro. El contraste \(F\) añade la distribución \(F_{k-1,\,n-k}\), que dice a partir de qué valor crítico \(F_c\), mayor que \(1\), datos como estos serían demasiado raros si \(H_0\) fuese cierta.
En la práctica B de la sesión 14, \(\bar R^2\) se usó para comparar dos modelos con el mismo regresando, uno con los regresores del otro y alguno más. El motivo de que sirva para eso está en su definición, \(\bar R^2=1-\frac{\mathrm{SRC}/(n-k)}{\mathrm{STC}/(n-1)}\). El denominador \(\mathrm{STC}/(n-1)\) solo depende del regresando y es el mismo número en los dos modelos; así que tiene mayor \(\bar R^2\) el modelo con menor \(\mathfrak s^2=\mathrm{SRC}/(n-k)\). Con \(R^2\) la comparación no es posible, porque al añadir regresores \(\mathrm{SRC}\) no sube nunca y el modelo mayor tiene siempre un \(R^2\) mayor o igual. Con \(\mathfrak s^2\) sí lo es: si los coeficientes de los regresores añadidos son cero, \(\mathfrak s^2\) es un estimador insesgado de \(\sigma^2\) en los dos modelos (lección 11), y ninguno de los dos tiene en promedio un \(\mathfrak s^2\) menor que el otro. Al añadir regresores, \(\mathrm{SRC}\) baja pero el divisor \(n-k\) también, y \(\mathfrak s^2\) puede bajar o subir. La sección ``Tres restricciones sobre
Con \(k=2\) la referencia es \(1/(n-1)\), y eso explica la propiedad que la lección 12 enunció sin demostrar: que en dimensión alta dos direcciones tomadas al azar son casi ortogonales. Con un solo regresor el subespacio de los regresores en desviaciones es una recta, y \(R^2=\cos^2\theta\) es el cuadrado del coseno del ángulo entre el vector de datos en desviaciones y esa recta. Ese cuadrado vale en promedio \(1/(n-1)\) porque la recta es una sola de las \(n-1\) direcciones ortonormales, y las \(n-1\) coordenadas de la perturbación sobre ellas son independientes y tienen la misma distribución: la longitud al cuadrado de la perturbación centrada se reparte en promedio a partes iguales entre las \(n-1\) direcciones, y a la recta del regresor le corresponde \(1/(n-1)\) de ella. Cuantas más observaciones, más direcciones se reparten esa longitud y menor es la fracción que cae en la del regresor.
Que el ángulo entre el vector de datos en desviaciones y la recta del regresor sea pequeño exige que casi toda la longitud de ese vector esté sobre esa recta y casi nada en las otras \(n-2\) direcciones. Bajo \(H_0\), \(Y_i=\beta_1\,\mathit1+U_i\), así que \(Y_i-\overline Y=U_i-\overline U\): el vector de datos en desviaciones es la realización de las perturbaciones centradas (sección ``El estadístico \(F\)''), y la distribución de la perturbación no distingue una dirección de otra: concentrarse en la recta del regresor es tan improbable como concentrarse en cualquier otra de las \(n-1\) direcciones. Los números: con \(n=5\) el promedio de \(\cos^2\theta\) es \(1/4\), el de un ángulo de \(60^\circ\); con \(n=1002\) es \(1/1001\), el de un ángulo de \(88{,}2^\circ\). Es la figura del cono de la lección 12: con mil observaciones, casi todas las realizaciones de la perturbación centrada forman con la recta del regresor un ángulo próximo a \(90^\circ\): la franja estrecha alrededor de la vertical. La conclusión: con muchos datos, \(H_0\) se rechaza en cuanto el ángulo se desvía ligeramente de los \(90^\circ\), porque con \(H_0\) cierta el azar casi nunca produce ni siquiera esa pequeña desviación. Un \(R^2\) minúsculo basta entonces para rechazar.
El caso \(k=2\) es el de la lección 12. Con un único regresor no constante, \(k-1=1\) y la fórmula se reduce a \(F=(n-2)\,\mathrm{SEC}/\mathrm{SRC}\), que es \(t^2\). También coincide el valor crítico, porque la \(F_{1,\,n-k}\) es la distribución del cuadrado de una \(t_{n-k}\) (apéndice, sección 10 (html): con \(q=1\) el numerador del \(F\) es el cuadrado del numerador de la \(t\), y el denominador es el mismo), de modo que \(F_c=t_c^2\) y las dos reglas de decisión rechazan en los mismos casos. Es lo que la práctica A de la sesión 18 verificó sobre
También la región crítica se lee igual que en la lección 12: rechazar cuando \(F>F_c\) equivale a rechazar cuando el ángulo \(\theta\) es menor que un ángulo crítico \(\theta_c\) (un cono alrededor del subespacio de los regresores en desviaciones), y la abertura de ese cono depende de los grados de libertad del ajuste y del residuo. Con los números de ``El \(F\) en una tabla de resultados'' (\(n=506\), \(k=4\)), la abertura al \(5\,\%\) es de \(82{,}9^\circ\): casi todo el espacio, por la misma razón que en la lección 12: en dimensión alta el azar solo produce ángulos próximos a \(90^\circ\).
Para profundizar: Wooldridge, J. M. (2020), cap. 4, sección 4.5, apartado ``The \(R\)-squared form of the \(F\) statistic''.
hprice2'' demuestra cuándo ocurre cada cosa: añadir regresores sube \(\bar R^2\) si y solo si el \(F\) que contrasta que sus coeficientes son cero es mayor que \(1\). El resultado de este apartado, \(\bar R^2>0\) si y solo si \(F>1\), es el caso en que el modelo menor solo tiene la constante.
hprice2 con restrict (actividad 3 (html)), y lo que el ejemplo de juguete de la lección 8 permite comprobar con números redondos: \(\mathrm{SEC}=90\), \(\mathrm{SRC}=10\), \(n=5\), luego \(F=(90/1)/(10/3)=27\), el mismo \(t^2=27\) de la lección 12; y el valor crítico al \(5\,\%\) de la \(F_{1,3}\) es \(10{,}13\), el cuadrado del \(3{,}182\) de la \(t_3\). Se rechaza por las dos vías, y con el mismo valor \(p\).
5. El \(F\) en una tabla de resultados
hprice2: price sobre rooms, nox y stratio (actividad 3 de S14-B).
| Regresor | Coeficiente | Error estándar | Estadístico \(t\) |
|---|---|---|---|
| constante | 9458,01 | 4371,41 | 2,16 |
rooms |
7000,63 | 409,15 | 17,11 |
nox |
-1693,33 | 236,25 | -7,17 |
stratio |
-1166,96 | 128,76 | -9,06 |
\(n=506\), \(k=4\), \(\mathrm{SRC}=1{,}711\cdot10^{10}\), \(\mathrm{SEC}=2{,}572\cdot10^{10}\). Al pie de la tabla, Gretl imprime tres estadísticos: \(R^2\), la ``D.T. de la regresión'' (\(\mathfrak s=\sqrt{\mathrm{SRC}/(n-k)}\)) y \(F(k-1,\,n-k)\) con su valor \(p\): \[ \boxed{R^2=0{,}6005}\qquad\boxed{\mathfrak s=5837{,}8}\qquad\boxed{F(3,502)=251{,}5,\quad p=1{,}3\cdot10^{-99}} \]
Lectura: \(F=251{,}5\) dice que la longitud al cuadrado por grado de libertad del cateto explicado es doscientas cincuenta veces mayor que la del residuo; si \(H_0\) fuese cierta esa razón debería rondar \(1\). Frente a \(F_c(3,502)=2{,}62\) al \(5\,\%\), se rechaza que los tres coeficientes sean cero a la vez. No dice: cuáles importan, ni cuánto.
El \(F\) en una tabla de resultados
Bajo los coeficientes, toda tabla de regresión de Gretl imprime un bloque de resumen. Dos de sus números ya los conocemos: el \(R^2\) y la ``D.T. de la regresión'', que es la \(\mathfrak s\) de la lección 11 (la raíz de la cuasivarianza de los residuos). Debajo del \(R^2\) hay un tercero, ``\(F(k-1,\,n-k)\)'', con su valor \(p\). Ese \(F\) es el estadístico de significación conjunta de esta lección: contrasta, automáticamente y para cualquier modelo que se estime, la hipótesis de que todos los coeficientes de los regresores no constantes son cero a la vez. Los dos números entre paréntesis se denominan grados de libertad y son las dimensiones de los subespacios donde viven los catetos del triángulo.
Ese \(F\) también lo vio en Estadística, al pie de la salida de Excel, en una tabla rotulada ``Análisis de varianza'' con tres filas, ``Regresión'', ``Residuos'' y ``Total'', y las columnas ``Grados de libertad'', ``Suma de cuadrados'', ``Promedio de los cuadrados'', ``F'' y ``Valor crítico de F''. Es el triángulo de esta lección puesto en filas: las sumas de cuadrados son \(\mathrm{SEC}\), \(\mathrm{SRC}\) y \(\mathrm{STC}\); los grados de libertad, \(k-1\), \(n-k\) y \(n-1\); el ``promedio de los cuadrados'' es cada suma dividida por sus grados de libertad, \(\mathrm{SEC}/(k-1)\) y \(\mathrm{SRC}/(n-k)\); y la ``F'' es su cociente. La última columna, pese a su rótulo, no es el valor crítico \(F_c\): es el valor \(p\) del contraste. Lo que allí era una tabla sin explicación es la fórmula de la transparencia ``El estadístico \(F\)''.
Tomemos el modelo de la actividad 3 (html) de la práctica B de la sesión 14, el precio mediano de la vivienda sobre el número de habitaciones, la contaminación y la ratio alumnos/profesor del distrito. Con \(n=506\) y \(k=4\) (tres regresores más la constante), los grados de libertad son \(k-1=3\) (ajuste) y \(n-k=502\) (residuo). Todo lo que hace falta para reconstruir el \(F\) está en la tabla o sale de ella con la lección 8: \(\mathrm{SRC}\) lo imprime Gretl (redondeada, \(1{,}71\cdot10^{10}\); con una cifra más es \(1{,}711\cdot10^{10}\)); \(\mathrm{STC}\) se obtiene de \(R^2=1-\mathrm{SRC}/\mathrm{STC}\), y \(\mathrm{SEC}=\mathrm{STC}-\mathrm{SRC}=2{,}572\cdot10^{10}\). Dividiendo la longitud al cuadrado de cada cateto por sus grados de libertad, el numerador vale \(8{,}573\cdot10^9\) y el denominador \(3{,}408\cdot10^7\). El denominador tiene que coincidir con \(\mathfrak s^2\), la cuasivarianza de los residuos, y coincide: \(5837{,}8^2=3{,}408\cdot10^7\). El cociente es \(251{,}5\), el \(F\) de la tabla. Por la otra vía, \(\frac{502}{3}\cdot\frac{0{,}6005}{0{,}3995}=251{,}5\), el mismo número.
El valor crítico de la \(F_{3,502}\) al \(5\,\%\) es \(2{,}62\), y al \(1\,\%\), \(3{,}82\); el estadístico observado es cien veces mayor y el valor \(p\) es del orden de \(10^{-99}\). Se rechaza \(H_0\): datos como estos serían muy raros si rooms, nox y stratio tuvieran coeficiente nulo a la vez. La magnitud también se lee: \(F=251{,}5\) dice que la longitud al cuadrado por grado de libertad del cateto explicado es doscientas cincuenta veces mayor que la del residuo; si \(H_0\) fuese cierta esa razón debería rondar \(1\).
Y lo que el \(F\) no dice, que la sección ``Qué dice y qué no dice el \(F\)'' desarrollará. Rechazar \(H_0\!:\beta_2=\beta_3=\beta_4=0\) es rechazar que los tres sean nulos a la vez; no excluye que dos de ellos lo sean. El \(F\) conjunto no señala a ningún regresor en particular, ni dice nada de la magnitud de los efectos: para eso están las columnas de la tabla y los intervalos de confianza de la lección 12.
Para profundizar: Wooldridge, J. M. (2020), cap. 4, sección 4.5, apartado ``The \(F\) statistic for overall significance of a regression''; y sección 4.6 (cómo se presentan los resultados, incluido el \(F\)).
6. Restricciones lineales: modelos anidados
Imponer \(q\) restricciones lineales sobre los \(\beta\) (excluir, igualar, fijar) obliga al ajuste a vivir en un subespacio menor del de los regresores. Proyectar sobre él aleja el ajuste de \(\boldsymbol y\): ajuste restringido \({\boldsymbol{\mathop{\widehat y}}}_r\), con \(\mathrm{SRC}_r\geq\mathrm{SRC}\). Los dos modelos están anidados: el restringido es un caso particular del completo.
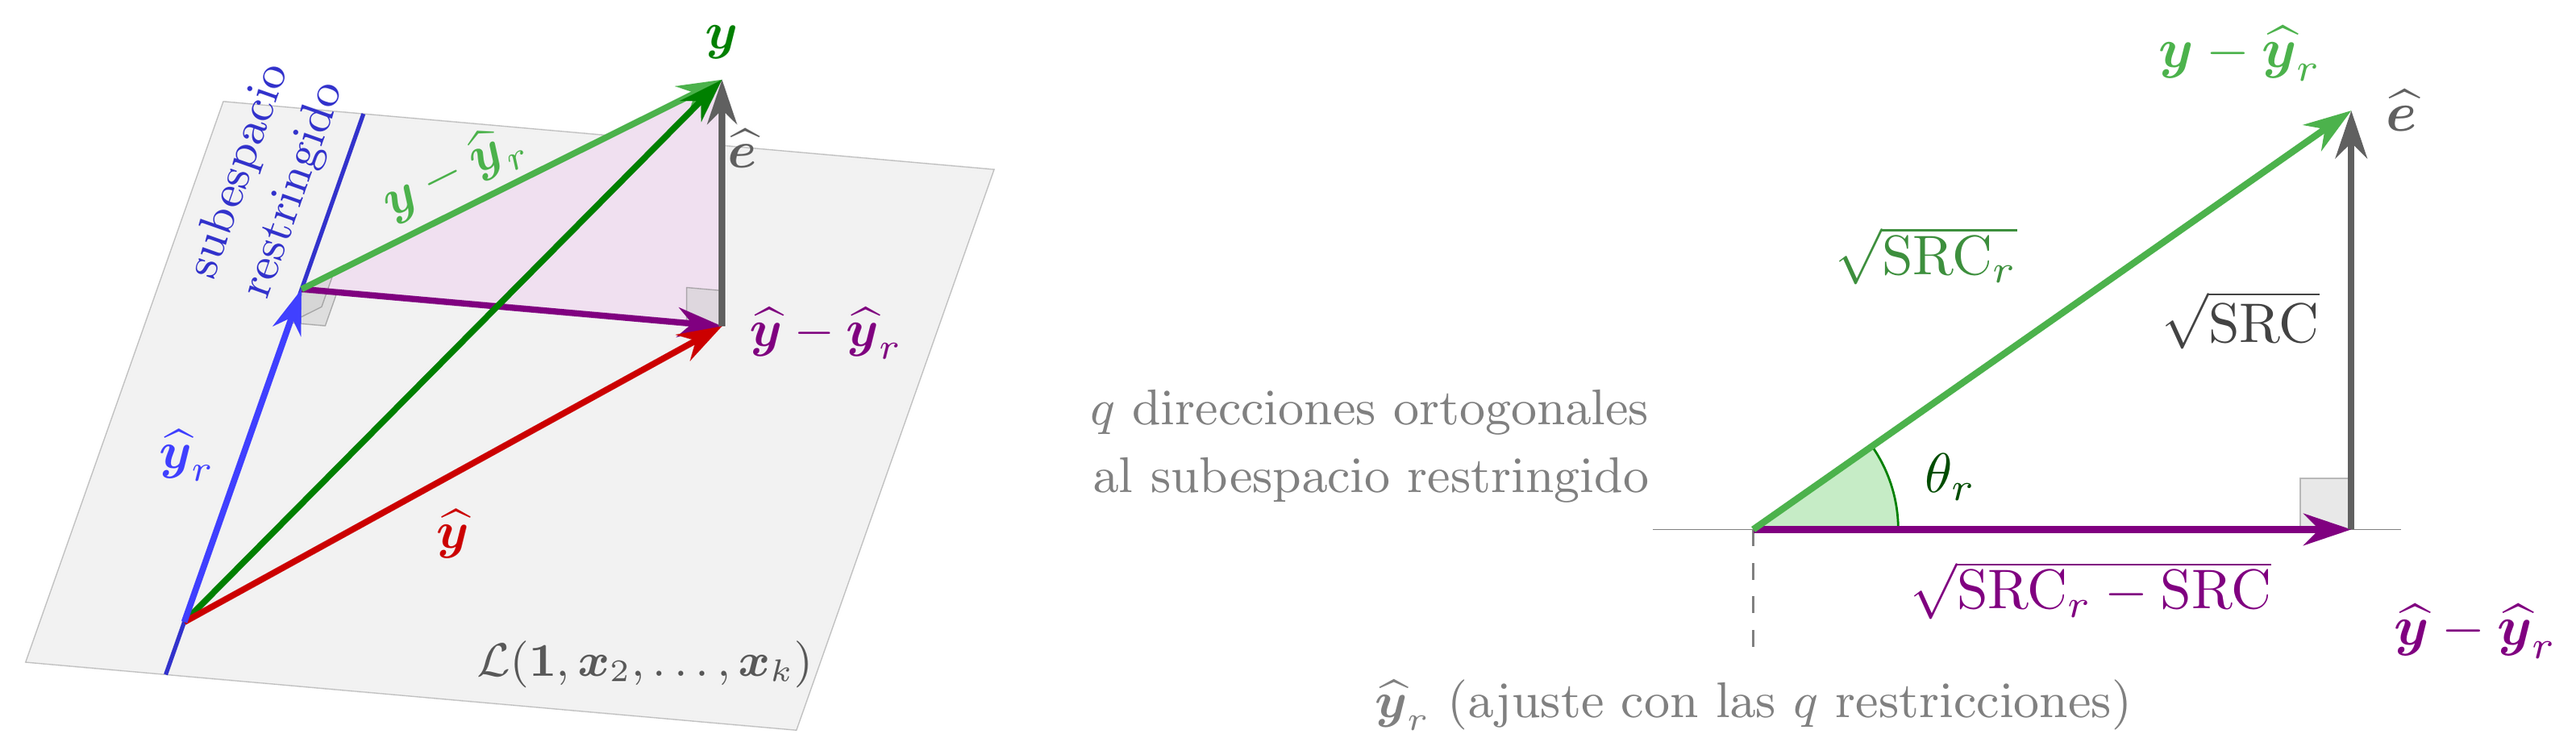
Figura 2: Izquierda: el subespacio de los regresores y, dentro de él, el subespacio restringido (recta azul) y la recta perpendicular a él que pasa por el origen (gris); \(\boldsymbol{\mathop{\widehat y}}\) es la ``sombra'' de \(\boldsymbol y\) sobre el plano y \({\boldsymbol{\mathop{\widehat y}}}_r\) su ``sombra'' sobre el subespacio restringido, más lejos de \(\boldsymbol y\). Derecha: el triángulo sombreado visto de frente, con el ajuste restringido \({\boldsymbol{\mathop{\widehat y}}}_r\) en el papel del vector de medias \(\boldsymbol{\mathop{\overline y}}\): hipotenusa \(\sqrt{\mathrm{SRC}_r}\), catetos \(\sqrt{\mathrm{SRC}_r-\mathrm{SRC}}\) (en las \(q\) direcciones del plano de los regresores que la restricción suprime) y \(\sqrt{\mathrm{SRC}}\). El ángulo recto es \(\boldsymbol{\mathop{\widehat y}}-{\boldsymbol{\mathop{\widehat y}}}_r\perp\boldsymbol{\mathop{\widehat e}}\), de donde \(\mathrm{SRC}_r=\mathrm{SRC}+\Vert\boldsymbol{\mathop{\widehat y}}-{\boldsymbol{\mathop{\widehat y}}}_r\Vert_e^2\). El ángulo \(\theta_r\) es el que forman la hipotenusa y el cateto \(\boldsymbol{\mathop{\widehat y}}-{\boldsymbol{\mathop{\widehat y}}}_r\), y hace el papel del \(\theta\) de la figura anterior: \(F\) es una función de \(\theta_r\) y de los grados de libertad \(q\) y \(n-k\). La significación conjunta es el caso en que el subespacio restringido es la recta de \(\boldsymbol 1\): entonces \({\boldsymbol{\mathop{\widehat y}}}_r=\boldsymbol{\mathop{\overline y}}\), \(q=k-1\), y el triángulo es el de la figura anterior.
\[ \boxed{\;F=\frac{(\mathrm{SRC}_r-\mathrm{SRC})/q}{\mathrm{SRC}/(n-k)}\;\sim\;F_{q,\,n-k}\ \text{ bajo }H_0\;} \;\;\begin{array}{l}\text{Significación conjunta:}\\ {\boldsymbol{\mathop{\widehat y}}}_r=\boldsymbol{\mathop{\overline y}},\ \ q=k-1.\end{array} \]
Restricciones lineales: modelos anidados
Empecemos por la geometría, porque es lo que permite tratar con una única herramienta todas las hipótesis de esta sección. Imponer \(q\) restricciones lineales sobre los coeficientes (excluir un regresor, igualar dos coeficientes, fijar un valor) equivale a exigir que el ajuste sea una combinación lineal de los regresores de un tipo particular. El conjunto de esas combinaciones es un subespacio menor que \(\mathcal L(\boldsymbol 1,\boldsymbol x_2,\ldots,\boldsymbol x_k)\), contenido en él, con \(q\) dimensiones menos.10
El ajuste restringido \({\boldsymbol{\mathop{\widehat y}}}_r\) es la proyección de \(\boldsymbol y\) sobre ese subespacio menor (lo que Gretl calcula al estimar el modelo sin nox ni stratio, por ejemplo), y su suma de cuadrados residual, \(\mathrm{SRC}_r=\Vert\boldsymbol y-{\boldsymbol{\mathop{\widehat y}}}_r\Vert_e^2\), es necesariamente mayor o igual que la del modelo completo: proyectar sobre un subespacio más pequeño nunca queda más cerca de \(\boldsymbol y\) que proyectar sobre un subespacio que contiene al pequeño. Es la propiedad que la lección 8 anunció como ``\(R^2\) nunca empeora al añadir regresores'' y que la práctica del \(R^2\) ajustado hizo explícita (actividad 4 (html)): quitar regresores nunca reduce la suma de cuadrados del residuo. La figura de la izquierda en la transparencia, repetida aquí más grande, lo muestra: el plano es el subespacio de los regresores; la recta dentro de él representa el subespacio restringido; \(\boldsymbol{\mathop{\widehat y}}\) es la ``sombra'' de \(\boldsymbol y\) sobre el plano y \({\boldsymbol{\mathop{\widehat y}}}_r\) su ``sombra'' sobre la recta, más lejos de \(\boldsymbol y\).
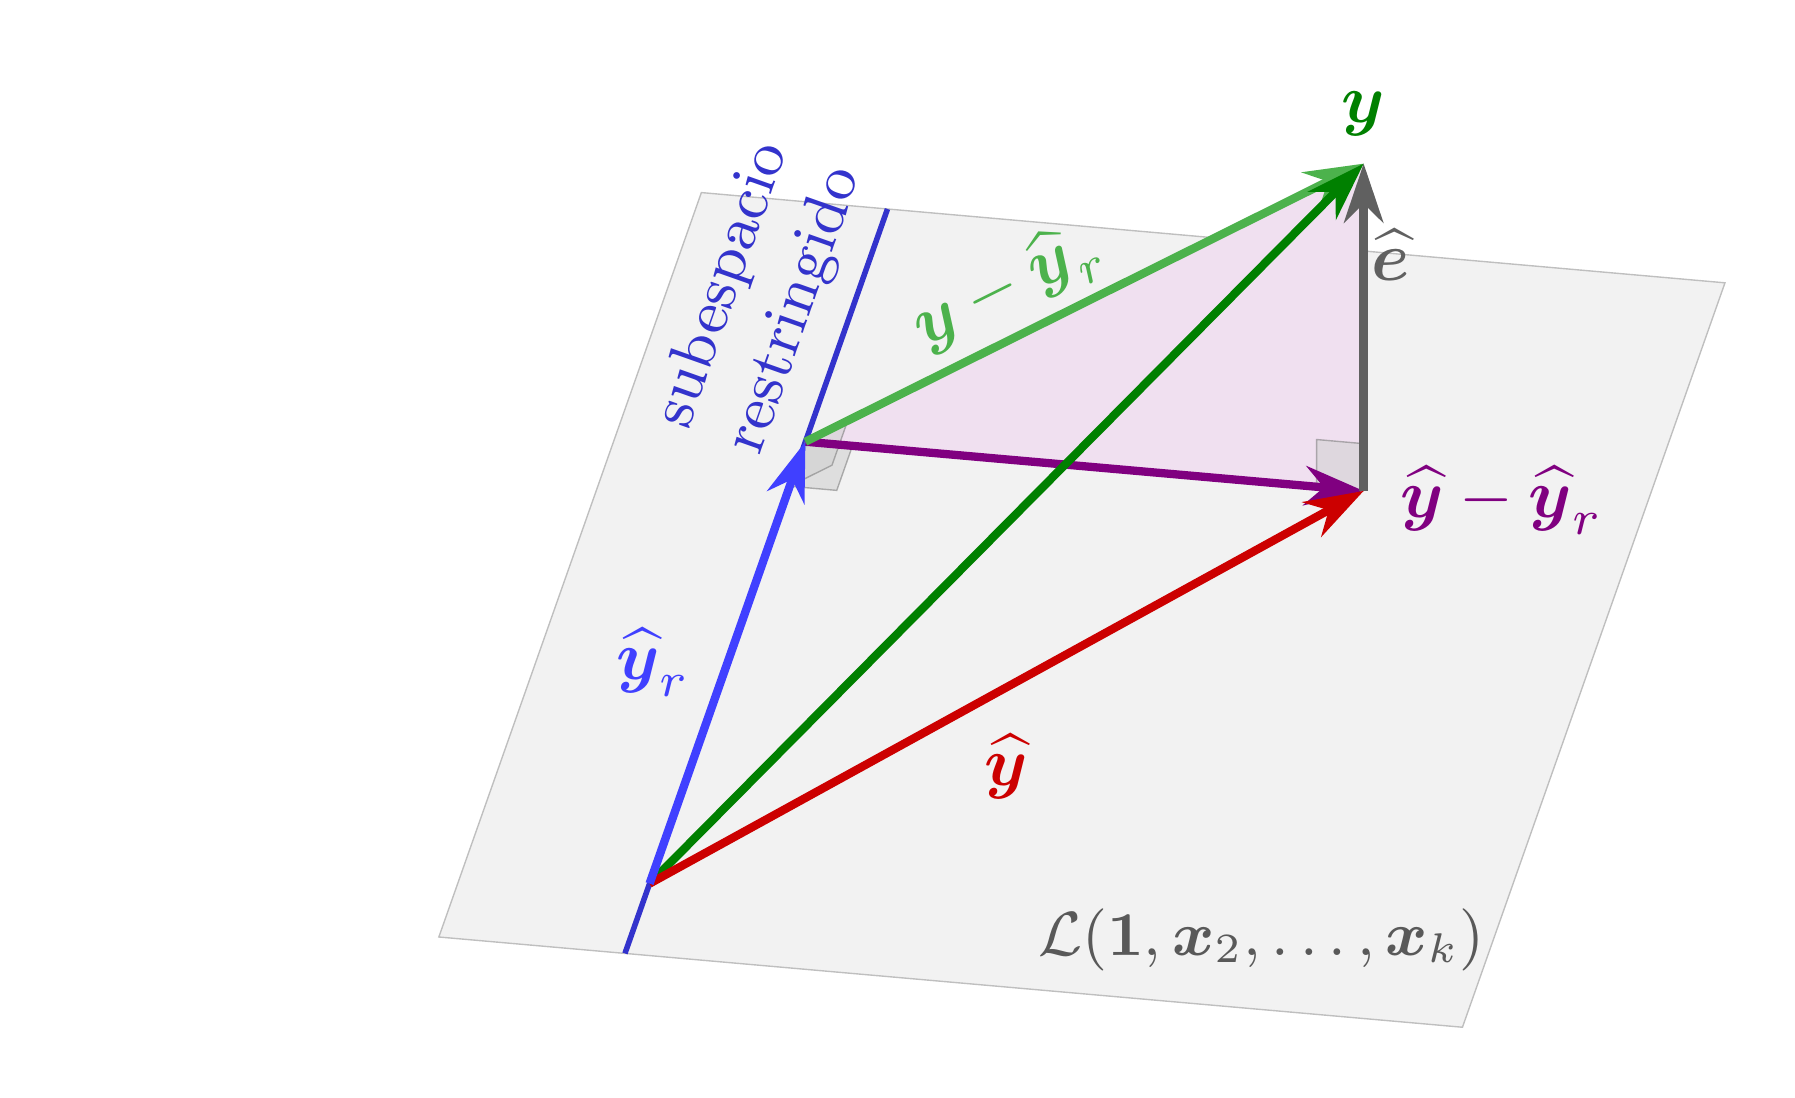
Figura 3: Los dos subespacios. El plano es \(\mathcal L(\boldsymbol 1,\boldsymbol x_2,\ldots,\boldsymbol x_k)\); la recta azul, dentro de él, es el subespacio restringido, y la recta gris que parte del origen es la perpendicular a él dentro del plano: la dirección del plano que la restricción suprime, a la que es paralelo el cateto \(\boldsymbol{\mathop{\widehat y}}-{\boldsymbol{\mathop{\widehat y}}}_r\). \(\boldsymbol y\) está fuera del plano; \(\boldsymbol{\mathop{\widehat y}}\) es su ``sombra'' sobre el plano y \({\boldsymbol{\mathop{\widehat y}}}_r\) su ``sombra'' sobre la recta. El triángulo sombreado es el de la transparencia, visto desde fuera del plano.
Con esa imagen delante, la definición general. Una hipótesis lineal es un sistema de \(q\) ecuaciones lineales sobre los coeficientes del modelo poblacional, ninguna de las cuales se deduce de las demás, y el ajuste pierde una dimensión por cada ecuación. El modelo que cumple esas ecuaciones y el modelo completo están anidados: el restringido es un caso particular del completo, porque cada combinación lineal de los regresores que el restringido admite la admite también el completo. Geométricamente, el subespacio restringido está contenido en el de los regresores, como la recta dentro del plano de la figura. Tres ejemplos que reaparecerán con números en ``Tres restricciones sobre hprice2'': excluir dos regresores a la vez, \(\beta_3=\beta_4=0\) (\(q=2\)); excluir uno solo, \(\beta_4=0\) (\(q=1\), el contraste \(t\) de siempre); y una hipótesis que no excluye ningún regresor, sino que relaciona dos coeficientes, \(\beta_3=\beta_4\) (\(q=1\)). Otras fijan un valor (una elasticidad unitaria, \(\beta_2=1\)) o una suma (rendimientos constantes a escala, \(\beta_2+\beta_3=1\), que veremos al hablar de la función de producción). Las que fijan un valor también tienen su modelo restringido, y se estima como una regresión más: con \(\beta_2=1\) el término \(1\cdot\boldsymbol x_2\) ya no tiene coeficiente que estimar y pasa al lado de \(\boldsymbol y\), de modo que el modelo restringido regresa \(\boldsymbol y-\boldsymbol x_2\) sobre \(\boldsymbol 1,\boldsymbol x_3,\ldots,\boldsymbol x_k\) (\(q=1\)); en general, con \(\beta_j=c\) se regresa \(\boldsymbol y-c\,\boldsymbol x_j\) sobre los demás regresores. La significación conjunta de ``La hipótesis conjunta'' es solo una de ellas, y no siempre la más interesante: su subespacio restringido es \(\mathcal L(\boldsymbol 1)\).
En términos de este esquema geométrico, la pregunta del contraste es cuánto aumenta la suma de cuadrados del residuo al imponer las restricciones, es decir, cuánto mayor es \(\mathrm{SRC}_r\) que \(\mathrm{SRC}\). Si \(H_0\) es cierta, el modelo restringido es el verdadero y el aumento \(\mathrm{SRC}_r-\mathrm{SRC}\) es solo la parte de la perturbación realizada que recogían por azar las \(q\) direcciones del plano de los regresores ortogonales al subespacio restringido, las que el modelo completo tiene y el restringido no. En adelante las llamaremos las \(q\) direcciones que la restricción suprime (apéndice, sección 6.4 (html): bajo \(H_0\), el efecto de los regresores no constantes, la parte sistemática, no tiene coordenadas en esas \(q\) direcciones). Si \(H_0\) es falsa, las restricciones suprimen direcciones en las que el ajuste completo sí se acercaba a \(\boldsymbol y\), y el aumento es grande. Para medirlo hace falta el resultado que hoy demostramos:
Proposición (Pitágoras anidado). Los dos ajustes cumplen \(\boldsymbol{\mathop{\widehat y}}-{\boldsymbol{\mathop{\widehat y}}}_r\perp\boldsymbol{\mathop{\widehat e}}\), y por tanto \[ \mathrm{SRC}_r=\mathrm{SRC}+\Vert\boldsymbol{\mathop{\widehat y}}-{\boldsymbol{\mathop{\widehat y}}}_r\Vert_e^2. \]
Demostración. El ajuste restringido \({\boldsymbol{\mathop{\widehat y}}}_r\) es una combinación lineal de los regresores (de un tipo particular), luego pertenece a \(\mathcal L(\boldsymbol 1,\boldsymbol x_2,\ldots,\boldsymbol x_k)\); y \(\boldsymbol{\mathop{\widehat y}}\) también. Por tanto, su diferencia está en ese subespacio, y el residuo del modelo completo es ortogonal a todo él (lección 10: \(\boldsymbol{\mathop{\widehat e}}\boldsymbol{\mathsf X}=\boldsymbol 0\)). Así que \(\boldsymbol{\mathop{\widehat y}}-{\boldsymbol{\mathop{\widehat y}}}_r\perp\boldsymbol{\mathop{\widehat e}}\). Ahora escribimos el residuo restringido como suma de dos vectores ortogonales: \[ \boldsymbol y-{\boldsymbol{\mathop{\widehat y}}}_r=(\boldsymbol{\mathop{\widehat y}}-{\boldsymbol{\mathop{\widehat y}}}_r)+(\boldsymbol y-\boldsymbol{\mathop{\widehat y}})=(\boldsymbol{\mathop{\widehat y}}-{\boldsymbol{\mathop{\widehat y}}}_r)+\boldsymbol{\mathop{\widehat e}}. \] Aplicando el teorema de Pitágoras de la lección 3, \(\Vert\boldsymbol y-{\boldsymbol{\mathop{\widehat y}}}_r\Vert_e^2=\Vert\boldsymbol{\mathop{\widehat y}}-{\boldsymbol{\mathop{\widehat y}}}_r\Vert_e^2+\Vert\boldsymbol{\mathop{\widehat e}}\Vert_e^2\), que es la igualdad anunciada. \(\blacksquare\)
La figura hace visible un hecho más: \({\boldsymbol{\mathop{\widehat y}}}_r\) es también la proyección de \(\boldsymbol{\mathop{\widehat y}}\) sobre el subespacio restringido. Llamemos \(\boldsymbol v_r\) a la ``sombra'' de \(\boldsymbol{\mathop{\widehat y}}\) sobre ese subespacio: es el vector del subespacio restringido tal que \(\boldsymbol{\mathop{\widehat y}}-\boldsymbol v_r\) es ortogonal a dicho subespacio (la condición de ortogonalidad que caracteriza la proyección, lecciones 6 y 10). Ahora bien, \(\boldsymbol y-\boldsymbol v_r=(\boldsymbol y-\boldsymbol{\mathop{\widehat y}})+(\boldsymbol{\mathop{\widehat y}}-\boldsymbol v_r)\), y los dos sumandos son ortogonales al subespacio restringido: el primero porque \(\boldsymbol{\mathop{\widehat e}}\) es ortogonal a todo el plano y el subespacio restringido es una parte del plano; el segundo por la definición de \(\boldsymbol v_r\). Luego \(\boldsymbol y-\boldsymbol v_r\) es ortogonal al subespacio restringido, y como \(\boldsymbol v_r\) está en él, \(\boldsymbol v_r\) es la ``sombra'' de \(\boldsymbol y\): es decir, \(\boldsymbol v_r={\boldsymbol{\mathop{\widehat y}}}_r\). Así que \(\boldsymbol y\) y \(\boldsymbol{\mathop{\widehat y}}\) tienen la misma ``sombra'' sobre el subespacio restringido. La proyección puede hacerse en dos pasos, primero sobre el plano y después sobre la recta.
Fíjese que la figura marca tres ángulos rectos, y cada uno tiene su lectura. Uno está en el punto donde termina el vector \(\boldsymbol{\mathop{\widehat y}}\), que es donde acaba el cateto \(\boldsymbol{\mathop{\widehat y}}-{\boldsymbol{\mathop{\widehat y}}}_r\) y empieza el cateto \(\boldsymbol{\mathop{\widehat e}}\): es el ángulo recto del triángulo sombreado, y es recto porque el primer cateto está en el plano y el segundo es ortogonal a todo el plano. Los otros dos están en el punto donde termina el vector \({\boldsymbol{\mathop{\widehat y}}}_r\), y en ambos uno de los catetos está sobre la recta del subespacio restringido. El que forma con \(\boldsymbol{\mathop{\widehat y}}-{\boldsymbol{\mathop{\widehat y}}}_r\) es la condición de ortogonalidad que define a \({\boldsymbol{\mathop{\widehat y}}}_r\) como ``sombra'' de \(\boldsymbol{\mathop{\widehat y}}\); el que forma con \(\boldsymbol y-{\boldsymbol{\mathop{\widehat y}}}_r\) es lo que acabamos de demostrar, que \({\boldsymbol{\mathop{\widehat y}}}_r\) es también la ``sombra'' de \(\boldsymbol y\). El primero de esos dos dice además en qué subespacio está \(\boldsymbol{\mathop{\widehat y}}-{\boldsymbol{\mathop{\widehat y}}}_r\): en el de las \(q\) direcciones que la restricción suprime, porque está en el plano de los regresores y es ortogonal al subespacio restringido. Ese subespacio es el eje horizontal del triángulo de la derecha de la transparencia.
Volvamos al Pitágoras anidado. La proposición es la de la lección 8 (\(\mathrm{STC}=\mathrm{SEC}+\mathrm{SRC}\)) con el vector de medias sustituido por el ajuste restringido, y la figura de la transparencia es la de la lección 8 con esa sustitución: hipotenusa \(\boldsymbol y-{\boldsymbol{\mathop{\widehat y}}}_r\), catetos \(\boldsymbol{\mathop{\widehat y}}-{\boldsymbol{\mathop{\widehat y}}}_r\) y \(\boldsymbol{\mathop{\widehat e}}\). El aumento de la suma de cuadrados residual al imponer las restricciones es la longitud al cuadrado del cateto \(\boldsymbol{\mathop{\widehat y}}-{\boldsymbol{\mathop{\widehat y}}}_r\): \(\mathrm{SRC}_r-\mathrm{SRC}=\Vert\boldsymbol{\mathop{\widehat y}}-{\boldsymbol{\mathop{\widehat y}}}_r\Vert_e^2\). Ese cateto es lo que el ajuste completo añade al restringido, porque \(\boldsymbol{\mathop{\widehat y}}={\boldsymbol{\mathop{\widehat y}}}_r+(\boldsymbol{\mathop{\widehat y}}-{\boldsymbol{\mathop{\widehat y}}}_r)\), y pertenece al subespacio de las \(q\) direcciones que la restricción suprime: la parte de \(\mathcal L(\boldsymbol 1,\boldsymbol x_2,\ldots,\boldsymbol x_k)\), de dimensión \(k\), que es ortogonal al subespacio restringido, de dimensión \(k-q\). Así que ese cateto tiene \(q\) grados de libertad, igual que el residuo tiene \(n-k\). Con esto, el estadístico se construye igual que el de significación conjunta, cada cateto dividido por sus grados de libertad: \[ F=\frac{(\mathrm{SRC}_r-\mathrm{SRC})/q}{\mathrm{SRC}/(n-k)}=\frac{\Vert\boldsymbol{\mathop{\widehat y}}-{\boldsymbol{\mathop{\widehat y}}}_r\Vert_e^2/q}{\mathfrak s^2}. \] El mismo reparto por grado de libertad de la sección ``El estadístico \(F\)'' hace que numerador y denominador estimen ambos \(\sigma^2\) bajo \(H_0\). Su distribución bajo \(H_0\) es la \(F_{q,\,n-k}\) (la demostración está en el apéndice, sección 10 (html)), y la regla es la de siempre: rechazar si \(F>F_c\).
El estadístico de significación conjunta de las secciones ``La hipótesis conjunta'' a ``El \(F\) en una tabla de resultados'' es este mismo estadístico con una hipótesis lineal concreta, \(\beta_2=\cdots=\beta_k=0\). Son \(q=k-1\) restricciones, y el modelo restringido solo tiene la constante: su subespacio es \(\mathcal L(\boldsymbol 1)\), su ajuste es el vector de medias, \({\boldsymbol{\mathop{\widehat y}}}_r=\boldsymbol{\mathop{\overline y}}\), y su suma de cuadrados residual es \(\mathrm{SRC}_r=\Vert\boldsymbol y-\boldsymbol{\mathop{\overline y}}\Vert_e^2=\mathrm{STC}\). El aumento de la suma de cuadrados residual es \(\mathrm{SRC}_r-\mathrm{SRC}=\mathrm{STC}-\mathrm{SRC}=\mathrm{SEC}\) (lección 8). Sustituyendo, \[ F=\frac{(\mathrm{SRC}_r-\mathrm{SRC})/q}{\mathrm{SRC}/(n-k)}=\frac{(\mathrm{STC}-\mathrm{SRC})/(k-1)}{\mathrm{SRC}/(n-k)}=\frac{\mathrm{SEC}/(k-1)}{\mathrm{SRC}/(n-k)}, \] que es la fórmula de la sección ``El estadístico \(F\)''. El triángulo de la transparencia es entonces el de la sección ``Lectura geométrica: la misma figura'': hipotenusa \(\boldsymbol y-\boldsymbol{\mathop{\overline y}}\) y catetos \(\boldsymbol{\mathop{\widehat y}}-\boldsymbol{\mathop{\overline y}}\) y \(\boldsymbol{\mathop{\widehat e}}\).
Cualquier par de modelos anidados, es decir, cualquier hipótesis lineal, se contrasta con la misma receta: estimar los dos, leer las dos sumas de cuadrados residuales, contar \(q\) y \(n-k\).
Para profundizar: Wooldridge, J. M. (2020), cap. 4, sección 4.5 (``Testing exclusion restrictions'' y ``Testing general linear restrictions''); y sección 4.4 (contraste de una única combinación lineal de coeficientes, el caso \(q=1\)).
7. Tres restricciones sobre hprice2
Modelo completo (actividad 3 de la práctica B de la sesión 14): price sobre rooms, nox y stratio, \(n=506\). En Gretl, menú Contrastes -> Restricciones lineales (o el comando restrict): devuelve el \(F\), sus grados de libertad y el valor \(p\).
| \(H_0\) | \(q\) | \(F\) | \(F_c\) al \(5\,\%\) | Lectura |
|---|---|---|---|---|
| \(\beta_{\text{nox}}=\beta_{\text{stratio}}=0\) | 2 | 73,1 | 3,01 | se rechaza: juntas, contaminación y ratio alumnos/profesor acortan el residuo más de lo esperable por azar |
| \(\beta_{\text{stratio}}=0\) | 1 | 82,1 | 3,86 | se rechaza; es el \(t=-9{,}06\) de la tabla, al cuadrado |
| \(\beta_{\text{nox}}=\beta_{\text{stratio}}\) | 1 | 3,56 | 3,86 | no se rechaza al \(5\,\%\) la igualdad de los dos coeficientes, por poco (\(p=0{,}060\)) |
La tercera fila no excluye ningún regresor: con \(\beta_{\text{nox}}=\beta_{\text{stratio}}\), los dos términos se funden en \(\beta_{\text{nox}}(\boldsymbol x_{\text{nox}}+\boldsymbol x_{\text{stratio}})\), y el modelo restringido regresa price sobre rooms y la suma nox \(+\) stratio. La restricción cambia el subespacio del ajuste (una dimensión menos) sin quitar ninguna columna de datos.
Tres restricciones sobre hprice2
Los tres contrastes de la tabla se hacen sobre el mismo modelo completo de la sección ``El \(F\) en una tabla de resultados'', de modo que el denominador es siempre el mismo: \(\mathrm{SRC}/(n-k)=\mathfrak s^2=3{,}408\cdot10^7\), la cuasivarianza de los residuos de la lección 11, cuya raíz, \(\mathfrak s=5837{,}8\), es la ``D.T. de la regresión'' de Gretl. Lo que cambia de fila a fila es el numerador, es decir, el modelo restringido que se compara.
Primera fila: dos exclusiones a la vez, \(H_0\!:\beta_{\text{nox}}=\beta_{\text{stratio}}=0\). El modelo restringido es la regresión simple de price sobre rooms que arrastramos desde la práctica B de la sesión 11 (actividad 2 (html)), con \(\mathrm{SRC}_r=2{,}209\cdot10^{10}\). El aumento al quitar los dos regresores es \(4{,}985\cdot10^9\), que dividido por los \(q=2\) grados de libertad y por \(\mathfrak s^2\) da \(F=73{,}1\), frente a un valor crítico \(F_c(2,502)=3{,}01\), con un valor \(p\) del orden de \(10^{-28}\). Se rechaza: la contaminación y la ratio alumnos/profesor acortan el residuo mucho más de lo que lo acortarían si sus dos coeficientes fuesen cero, caso en que solo recogerían por azar la parte de la perturbación que cae en las dos direcciones que añaden al subespacio del ajuste. Es la respuesta a la pregunta ``¿sobran estas dos variables?'', que ningún \(t\) individual formula.
Segunda fila: una exclusión, \(H_0\!:\beta_{\text{stratio}}=0\). Ahora el modelo restringido es price sobre rooms y nox, con \(\mathrm{SRC}_r=1{,}991\cdot10^{10}\); el aumento es \(2{,}799\cdot10^9\), \(q=1\), y \(F=82{,}1\). Compárese con la tabla de esa sección: el \(t\) de stratio era \(-9{,}06\), y \((-9{,}06)^2=82{,}1\). Es la identidad \(F=t^2\) con \(q=1\), ahora en un modelo con varios regresores: el contraste \(t\) de un coeficiente es el contraste \(F\) de una única restricción de exclusión, y el valor crítico \(F_c(1,502)=3{,}86\) es el cuadrado del \(t_c=1{,}965\) de la \(t_{502}\).11 Gretl lo confirma si se le pide la restricción con restrict o desde el menú: devuelve un \(F(1,502)\) idéntico al \(t^2\), con el mismo valor \(p\).
Tercera fila: una igualdad, \(H_0\!:\beta_{\text{nox}}=\beta_{\text{stratio}}\) (``una unidad más de concentración de óxidos de nitrógeno reduce el precio mediano tanto como un alumno más por profesor''). La igualdad depende de las unidades: nox se mide en partes por cien millones y stratio en alumnos por profesor, y con otras unidades la hipótesis sería otra. Aquí sirve para mostrar cómo se contrasta una igualdad, no como hipótesis económica. Esta hipótesis no excluye ningún regresor, así que hay que decir cuál es su modelo restringido. Bajo \(H_0\) los dos coeficientes son el mismo número, \(\beta_{\text{nox}}\), y sacando factor común la combinación \(\beta_{\text{nox}}\boldsymbol x_{\text{nox}}+\beta_{\text{stratio}}\boldsymbol x_{\text{stratio}}\) se convierte en \(\beta_{\text{nox}}(\boldsymbol x_{\text{nox}}+\boldsymbol x_{\text{stratio}})\): los dos regresores se funden en uno, la suma, y el modelo restringido es la regresión de price sobre rooms y nox \(+\) stratio. Su \(\mathrm{SRC}_r\) es \(1{,}723\cdot10^{10}\), apenas por encima del completo: el aumento es \(1{,}213\cdot10^8\) y \(F=3{,}56\), ligeramente por debajo del valor crítico \(3{,}86\). No se rechaza al \(5\,\%\), con un valor \(p\) de \(0{,}060\) que conviene informar tal cual: datos como estos serían algo raros si los dos efectos fuesen iguales, pero no lo bastante para rechazar al \(5\,\%\), y la lección 12 ya advirtió que ``no rechazar'' no es ``aceptar''. Esta fila muestra que imponer una restricción es cambiar de subespacio, no necesariamente recortar regresores: el subespacio \(\mathcal L(\boldsymbol 1,\boldsymbol x_{\text{rooms}},\boldsymbol x_{\text{nox}}+\boldsymbol x_{\text{stratio}})\) tiene una dimensión menos que el completo, pero no se obtiene quitando ninguna columna de \(\boldsymbol{\mathsf X}\).12
Esta tercera fila permite enunciar un hecho general sobre el \(R^2\) ajustado de la actividad 5 (html) de la práctica B de la sesión 14 (el que Gretl imprime como ``R-cuadrado corregido''). Ese coeficiente se puede escribir \(\bar R^2=1-\frac{\mathrm{SRC}/(n-k)}{\mathrm{STC}/(n-1)}\): a igual \(\mathrm{STC}\), es mayor en el modelo cuyo residuo tiene menor longitud al cuadrado por grado de libertad, \(\mathfrak s^2=\mathrm{SRC}/(n-k)\). En el modelo restringido el residuo tiene \(n-k+q\) grados de libertad y su suma de cuadrados es \(\mathrm{SRC}+(\mathrm{SRC}_r-\mathrm{SRC})\) por el Pitágoras anidado. Así que
\[
\bar R^2_r>\bar R^2 \iff \frac{\mathrm{SRC}_r}{n-k+q}<\frac{\mathrm{SRC}}{n-k}
\iff (\mathrm{SRC}_r-\mathrm{SRC})(n-k)
En la tabla, la tercera fila tiene \(F=3{,}56\), entre \(1\) y \(F_c=3{,}86\), y los dos criterios responden a preguntas distintas. El contraste pregunta si datos como estos serían demasiado raros con \(\beta_{\text{nox}}=\beta_{\text{stratio}}\); como \(3{,}56<3{,}86\), no lo son, y \(H_0\) no se rechaza. El \(R^2\) ajustado pregunta cuál de los dos modelos tiene menor suma de cuadrados del residuo por grado de libertad. La del cateto \(\boldsymbol{\mathop{\widehat y}}-{\boldsymbol{\mathop{\widehat y}}}_r\), \((\mathrm{SRC}_r-\mathrm{SRC})/q=1{,}213\cdot10^8\), es \(3{,}56\) veces la del residuo completo, \(\mathfrak s^2=3{,}408\cdot10^7\); como el residuo restringido es la suma de los dos, su suma de cuadrados por grado de libertad es mayor que la del completo, y el \(R^2\) ajustado del modelo con la suma
En Gretl, las tres filas se obtienen sin construir ni estimar el modelo restringido: en la ventana del modelo completo, el menú
Para profundizar: Wooldridge, J. M. (2020), cap. 4, sección 4.4 (contrastar \(\beta_j=\beta_h\) como un \(t\) con la covarianza de los estimadores, y por qué la vía del modelo restringido es más cómoda); manual de Gretl, comando nox \(+\) stratio es menor que el del modelo completo. Para que fuese mayor haría falta \(F<1\). Así que ``no se rechaza \(H_0\)'' y ``el \(R^2\) ajustado prefiere el modelo restringido'' son cosas distintas, con umbrales distintos: \(F_c\) para la primera y \(1\) para la segunda. Cuando \(F\) cae entre \(1\) y \(F_c\), como aquí, el contraste no rechaza la restricción, porque solo la rechaza cuando los datos son muy raros bajo ella, y el \(R^2\) ajustado no la impone, porque solo compara residuos por grado de libertad.
Contrastes -> Restricciones lineales (o el bloque restrict que la práctica A de la sesión 18 usó con b[2]=0, actividad 3 (html)) acepta cualquier sistema de ecuaciones lineales sobre los coeficientes y devuelve el \(F\) con sus dos grados de libertad y su valor \(p\). Un laboratorio posterior lo aplicará con varias restricciones a la vez y comprobará, estimando los dos modelos, que el \(F\) que imprime es el cociente de sumas de cuadrados de esta lección.
restrict.
8. Conjunto \(\neq\) individual: el caso de la apertura
Regresores, además de rooms |
\(t\) de nox |
\(t\) de lnox |
\(R^2\) | \(F\) de excluir ambos |
|---|---|---|---|---|
nox |
-7,43 | 0,5352 | ||
lnox |
-7,51 | 0,5361 | ||
nox y lnox |
0,18 | -1,05 | 0,5362 | 28,2 (\(F_c=3{,}01\)) |
\(\rho_{\text{nox},\text{lnox}}=0{,}994\): los dos regresores en desviaciones apuntan casi en la misma dirección. El coeficiente de cada uno, sin el otro en el modelo, es muy significativo; juntos, el ajuste no puede repartir el efecto entre ellos: a cada uno le queda muy poca longitud propia (enunciada en la lección 12, definida en la 14), su error estándar se multiplica y su \(t\) se acerca a cero. Pero el subespacio que generan juntos sí acerca \(\boldsymbol{\mathop{\widehat y}}\) a \(\boldsymbol y\), y el \(F\) lo mide.
Un \(F\) conjunto alto con \(t\) individuales pequeños es la firma de la colinealidad (lección 14). La conclusión correcta no es ``sobran los dos'', sino ``no se puede separar el efecto de uno del efecto del otro''.
Conjunto \(\neq\) individual: el caso de la apertura
Volvamos a la tabla con la que abrimos la sesión, ahora con la herramienta para leerla. Las tres filas de la transparencia son tres regresiones del precio mediano de la vivienda: sobre rooms y la concentración de óxidos de nitrógeno nox; sobre rooms y el logaritmo de esa concentración, lnox; y sobre rooms y las dos medidas a la vez. Las dos primeras dicen lo mismo: el \(t\) de la contaminación, \(-7{,}4\) o \(-7{,}5\), tiene el signo de su coeficiente, así que el coeficiente es negativo, y está muy lejos del valor crítico \(\pm1{,}96\), así que se separa con claridad de cero; el \(R^2\) es \(0{,}535\) o \(0{,}536\). Medirla en niveles o en logaritmos apenas cambia el resultado, porque la correlación entre nox y lnox es \(0{,}994\); en el lenguaje de la lección 5, sus vectores en desviaciones forman un ángulo de unos \(6^\circ\), prácticamente la misma dirección.
La tercera fila, leída fila a fila, dice otra cosa. Con las dos medidas en el modelo, el \(t\) de nox cae a \(0{,}18\) y el de lnox a \(-1{,}05\); los valores \(p\) son \(0{,}854\) y \(0{,}295\), y la lectura fila a fila de la lección 12 podría llevar a asumir que ninguna de las dos interviene. Pero el \(R^2\) apenas ha cambiado (\(0{,}5362\)) y el \(F\) de excluir las dos a la vez vale \(F(2,502)=28{,}2\) frente a un crítico de \(3{,}01\): quitar del modelo las dos medidas de la contaminación a la vez alarga el residuo mucho más de lo que cabe esperar por azar. Los dos coeficientes juntos son significativos; cada uno no lo es en presencia del otro.
La lección 12 dio la clave en su recapitulación: con varios regresores, el error estándar de \(\hat\beta_j\) es \(\mathfrak s/\Vert\tilde{\boldsymbol x}_j\Vert_e\), donde \(\tilde{\boldsymbol x}_j\) es lo que le queda de propio al regresor \(j\) tras descontar lo que comparte con los demás. Cuando nox y lnox están los dos en el modelo, casi toda la variación de cada uno la comparte con el otro. La parte propia de cada uno es un vector muy corto, el error estándar de cada coeficiente se multiplica y el \(t\) se acerca a cero: compárense los errores estándar de nox y lnox en la tabla de la apertura, \(2198{,}85\) y \(12655{,}7\), con los \(253{,}6\) que tiene nox en el modelo de la primera fila, con rooms y sin lnox.
El contraste \(t\) de nox pregunta si nox aporta algo que lnox no aporte ya (con la constante y rooms en el modelo), y su hipótesis \(\beta_{\text{nox}}=0\) no se rechaza; y lo mismo al revés. Pero esa es una pregunta sobre la parte propia de cada regresor, no sobre el subespacio que generan entre los dos. Ese subespacio, un plano dentro de \(\mathcal L(\boldsymbol 1)^\perp\), sí acerca el ajuste a \(\boldsymbol y\): la dirección que nox y lnox comparten recoge una parte grande de la variación del precio, aunque no se rechace que el coeficiente de cada uno sea cero en presencia del otro. El \(F\) de excluir ambas mide eso: cuánto se alarga el residuo si se suprimen las dos direcciones que nox y lnox añaden a la constante y rooms. Por eso el \(F\) es grande mientras los dos \(t\) son pequeños.
Esta situación tiene nombre, colinealidad, y le dedicaremos la lección 14. La lectura correcta de la tabla importa porque el error contrario es frecuente en informes y artículos: ante dos regresores con \(t\) pequeños, eliminar los dos ``porque no son significativos''. El contraste conjunto dice que eso es un error: los datos no permiten separar el efecto de uno del efecto del otro, pero el \(F\) rechaza que sus dos coeficientes sean cero a la vez.
Qué hacer depende de para qué se quiere el modelo. Si el objetivo es solo predecir el precio, no hay nada que arreglar: el modelo con las dos medidas ajusta al menos tan bien como cualquiera de los otros dos y puede dejarse como está. Si la pregunta económica exige distinguir el efecto de una medida del efecto de la otra, hay que reconocer que estos datos no lo permiten; y quitar una de las dos no lo resuelve, porque el coeficiente de la que queda recoge lo que ambas comparten. La lección 14 vuelve sobre ello. Es la moraleja de la lección 12, que con un solo regresor no constante decía que para medir un efecto hace falta que la variable varíe, trasladada a más regresores: para medir el efecto de cada uno hace falta que cada uno varíe por su cuenta.
Para profundizar: Wooldridge, J. M. (2020), cap. 4, sección 4.5, apartado ``Relationship between \(F\) and \(t\) statistics'' (el ejemplo en que ningún \(t\) es significativo y el \(F\) sí lo es); y cap. 3, sección 3.4, apartado sobre multicolinealidad.
9. Qué dice y qué no dice el \(F\)
\(F=\frac{n-k}{k-1}\cdot\frac{R^2}{1-R^2}\) combina, como el \(t\), fuerza de la relación (el ángulo) con grados de libertad (\(n-k\) y \(k-1\)). Tres casos inventados, calculados con la fórmula para \(k=4\):
| \(n\) | \(R^2\) | \(\theta\) | \(F\) | Veredicto al \(5\,\%\) |
|---|---|---|---|---|
| 6 | 0,90 | \(18{,}4^\circ\) | 6,00 | no significativo (\(F_c=19{,}16\)) |
| 10 | 0,90 | \(18{,}4^\circ\) | 18,00 | significativo (\(F_c=4{,}76\)) |
| 1003 | 0,01 | \(84{,}3^\circ\) | 3,36 | significativo (\(F_c=2{,}61\)) |
El \(F\) del pie de cada tabla de Gretl contrasta la significación conjunta de todos los regresores no constantes: una prueba de mínimos, superada casi siempre con muestras grandes. Los \(F\) interesantes nacen de preguntas concretas (¿sobran estas dos variables? ¿tienen el mismo efecto?)
Un \(F\) de significación conjunta que rechaza \(H_0\) dice que los regresores en conjunto acortan el residuo más de lo esperable por azar; no dice cuáles ni de qué tamaño es su efecto: eso lo dicen los coeficientes y sus intervalos. Y nada de esto establece causalidad.
Qué dice y qué no dice el \(F\)
Todo lo que la lección 12 dijo sobre la lectura del \(t\) vale para el \(F\), y la forma \(F=\frac{n-k}{k-1}\cdot\frac{R^2}{1-R^2}\) lo muestra: el estadístico es el producto de un factor que mide la fuerza de la relación en la muestra (el ángulo, el \(R^2\)) y otro que solo depende de los grados de libertad. La tabla de la transparencia repite el experimento de la lección 12 con \(k=4\): tres casos inventados, no procedentes de datos, con el \(F\) calculado con la fórmula a partir de \(n\) y \(R^2\). Las dos primeras filas tienen el mismo \(R^2\) de \(0{,}90\), el mismo ángulo de \(18{,}4^\circ\), y veredictos opuestos: con \(n=6\) el residuo tiene solo \(n-k=2\) grados de libertad, el valor crítico de la \(F_{3,2}\) es \(19{,}16\) y un \(F\) de \(6\) no basta; con \(n=10\) el valor crítico baja a \(4{,}76\) y \(F=18\) rechaza la \(H_0\) con holgura. La tercera fila hace el camino inverso: un \(R^2\) del \(1\,\%\) (un ángulo de \(84^\circ\), casi ortogonalidad) resulta conjuntamente significativo con mil observaciones.
La comparación con la tabla análoga de la lección 12 muestra lo que el \(F\) añade al \(t\): el número de regresores también cuenta. Allí, con \(k=2\), bastaban \(n=5\) observaciones para que un \(R^2=0{,}90\) llevase a rechazar \(H_0\); aquí, con \(k=4\), hacen falta más datos (en la tabla, \(n=10\)), porque un mismo valor del \(R^2\) alcanzado con tres regresores no constantes es más fácil de obtener por azar que con uno solo: hay más direcciones sobre las que proyectar, y el azar produce, en promedio, \(1/(n-1)\) de \(R^2\) por cada una de ellas, \((k-1)/(n-1)\) en total. Dividir el numerador de \(F\) entre \(k-1\) compensa ese \(R^2\) producido por azar, porque lo que \(F\) compara no son las longitudes de los dos catetos, sino lo que cada uno mide por grado de libertad: la suma de cuadrados del cateto explicado dividida por sus \(k-1\) grados de libertad y la del residuo dividida por sus \(n-k\) (sección ``El estadístico \(F\)''). Bajo \(H_0\) los dos cocientes estiman lo mismo, \(\sigma^2\), sea cual sea \(k\): con más regresores el cateto explicado crece por azar en proporción, y el divisor lo descuenta. Es la misma idea que motivó el \(R^2\) ajustado.
Hay una segunda advertencia, propia del \(F\). El \(F\) que Gretl imprime al pie de cada tabla contrasta la significación conjunta de todos los regresores no constantes: la hipótesis de que todos sus coeficientes sean cero, es decir, de que lo que el ajuste añade al vector de medias sea solo lo que cabe esperar por azar. Es una prueba de mínimos: si no se rechaza, los datos no permiten afirmar que alguno de esos coeficientes sea distinto de cero. Pero superar ese mínimo dice muy poco del modelo, porque nadie estima un modelo con regresores elegidos al azar; y con muestras grandes se supera casi sin excepción, como muestra la tercera fila de la tabla. En un contraste de significación conjunta, un \(F\) grande no dice nada nuevo; uno pequeño en una muestra grande es una señal de alarma. Los contrastes \(F\) que responden a una pregunta del investigador son los de la transparencia ``Tres restricciones sobre hprice2'': ¿sobran estas dos variables?, ¿tienen el mismo efecto?, ¿vale uno la elasticidad?, ¿son constantes los rendimientos a escala?; preguntas cuya respuesta decide cómo se especifica el modelo o qué se concluye de él. El contraste de significación conjunta conviene mirarlo una vez y no volver sobre él.
La tercera advertencia es la que la práctica A de la sesión 18 ilustró con doce viviendas para el \(t\) (actividad 5 (html)), y que vale igual para el \(F\). El rechazo de \(H_0\) dice que alguna combinación de los regresores acerca el ajuste al regresando más de lo que cabe esperar por azar; no dice cuál, ni cuánto, ni con qué precisión. Como en la lección 12, lo que informa es el coeficiente en las unidades del problema y su intervalo, y un \(F\), como un \(t\), solo dice si la desviación respecto a la hipótesis es distinguible del azar. Un \(F\) que no rechaza \(H_0\) tampoco prueba que las restricciones sean ciertas: es la ausencia de evidencia en su contra, y con pocas observaciones esa ausencia es frecuente aunque \(H_0\) sea falsa, porque con pocas observaciones el efecto de las restricciones incumplidas alarga poco el cateto \(\boldsymbol{\mathop{\widehat y}}-{\boldsymbol{\mathop{\widehat y}}}_r\) y el valor crítico es mayor.
Y, como siempre, nada de esto establece causalidad. Un \(F\) conjunto significativo dice que la proyección de \(\boldsymbol y\) sobre el subespacio de los regresores es más larga de lo que el azar produciría; de si alguno de esos regresores causa el regresando no dice nada, por las mismas razones de las lecciones 8, 9 y 12. Las correlaciones espurias producen \(F\) grandes igual que producen \(t\) grandes.
Para profundizar: Wooldridge, J. M. (2020), cap. 4, sección 4.2f (significación económica frente a estadística, que se aplica sin cambios al \(F\)) y sección 4.5, apartado sobre el valor \(p\) del contraste \(F\).
10. Recapitulación y guiño a las sesiones siguientes
| Pieza | Fórmula | Lectura geométrica |
|---|---|---|
| \(F\) de significación conjunta | \(\frac{\mathrm{SEC}/(k-1)}{\mathrm{SRC}/(n-k)}=\frac{n-k}{k-1}\frac{R^2}{1-R^2}\) | razón de longitudes al cuadrado de los catetos, por grado de libertad |
| \(F\) de \(q\) restricciones | \(\frac{(\mathrm{SRC}_r-\mathrm{SRC})/q}{\mathrm{SRC}/(n-k)}\) | el mismo triángulo, con \({\boldsymbol{\mathop{\widehat y}}}_r\) en el papel de \(\boldsymbol{\mathop{\overline y}}\) |
| Caso \(q=1\) | \(F=t^2\), \(F_c=t_c^2\) | el contraste \(t\) es un \(F\) de una restricción |
| Grados de libertad | \(k-1\) (o \(q\)) y \(n-k\) | dimensiones de los subespacios de los dos catetos |
| Región crítica | \(F>F_c\) (una cola) | cono alrededor del subespacio de los regresores |
Un único ingrediente nuevo: dividir cada cateto por sus grados de libertad. Demostrado: Pitágoras anidado y \(F=t^2\) (con \(k=2\)). Enunciado (demostración en el apéndice): la distribución \(F_{q,\,n-k}\).
Lección 14: colinealidad. La longitud propia \(\Vert\tilde{\boldsymbol x}_j\Vert_e\) de cada regresor y el factor de inflación de la varianza explican con números el caso de nox y lnox. En un laboratorio posterior: restrict con varias restricciones a la vez, y la distribución del \(F\) bajo \(H_0\) con datos simulados.
Recapitulación y guiño a las sesiones siguientes
La sesión tiene un solo ingrediente nuevo. Todo el aparato (el triángulo, las sumas de cuadrados, el \(R^2\), la cuasivarianza \(\mathfrak s^2\), la isotropía de las coordenadas de la perturbación bajo normalidad) estaba ya disponible desde las lecciones 8, 11 y 12. Lo único que hoy hemos añadido es una idea: comparar los dos catetos por grado de libertad, dividiendo cada suma de cuadrados por la dimensión del subespacio donde vive. Con ella, el contraste \(t\) de la lección 12 resulta ser el caso de una sola dirección, y el contraste de cualquier hipótesis lineal sobre los coeficientes (excluir, igualar, fijar) se reduce a una única receta: estimar el modelo con y sin la hipótesis, leer las dos sumas de cuadrados residuales y contar grados de libertad.
La tabla resume las piezas. Como en la lección 12, distingamos lo demostrado de lo enunciado. Se ha demostrado con material del propio curso el Pitágoras anidado (el aumento de la suma de cuadrados residual al imponer restricciones es la longitud al cuadrado de un cateto ortogonal al residuo) y las identidades \(F=\frac{n-k}{k-1}\frac{R^2}{1-R^2}\) y, con \(k=2\), \(F=t^2\). La distribución \(F_{q,\,n-k}\) del estadístico bajo \(H_0\) se ha enunciado en la sesión, igual que la \(t\) de Student en la lección 12; el apéndice (html) la demuestra (sección 10) a partir de una única propiedad de la normal que queda enunciada. Que numerador y denominador estimen los dos \(\sigma^2\) bajo \(H_0\) solo usa homocedasticidad e incorrelación, y está demostrado (apéndice, sección 7 (html)). La parte geométrica está demostrada en la sesión; la probabilística, en el apéndice (html).
Quedan dos hilos abiertos. El primero es el caso de nox y lnox, que hoy hemos sabido leer pero no medir. La lección 12 enunció que con varios regresores \(\mathrm{ee}(\hat\beta_j)=\mathfrak s/\Vert\tilde{\boldsymbol x}_j\Vert_e\), con \(\tilde{\boldsymbol x}_j\) la parte propia del regresor \(j\); hoy hemos visto qué pasa cuando esa parte propia es casi nula: el \(t\) individual se acerca a cero mientras el conjunto sigue siendo significativo. La lección 14 pondrá números a \(\Vert\tilde{\boldsymbol x}_j\Vert_e\), mostrará que se calcula con una regresión auxiliar de \(\boldsymbol x_j\) sobre los demás regresores, y de ahí se deducirá el factor de inflación de la varianza, la medida habitual de cuánto aumenta la colinealidad cada error estándar. El segundo hilo es de laboratorio. En una práctica posterior se aplicará restrict con varias restricciones simultáneas sobre datos reales, comprobando estimación a estimación que el \(F\) de Gretl es el cociente de sumas de cuadrados de hoy. Y se simulará, con el loop de la práctica A de la sesión 16 (actividad 3 (html)), la distribución del \(F\) bajo una \(H_0\) cierta: los histogramas mostrarán que ronda \(1\) y que la cola derecha es la que Gretl tabula.
Para profundizar: Wooldridge, J. M. (2020), cap. 4, sección 4.5 (resumen del contraste \(F\)); cap. 3, sección 3.4, apartado ``Multicollinearity'' (con el que arranca la lección siguiente).
11. Preguntas de repaso (sesión 19) htmlonly
Le propongo 12 preguntas. Las marco con un nivel orientativo: [B] básica, [M] media, [D] discriminadora.
Comentario
Las preguntas que más le conviene trabajar son la 3 (fija la idea que vertebra la sesión: bajo \(H_0\) las longitudes al cuadrado de los dos catetos, divididas por sus grados de libertad, estiman lo mismo, y por eso \(F\) ronda \(1\)), la 6 (exige el argumento geométrico exacto del Pitágoras anidado) y la 8 (la lectura correcta de \(t\) individuales pequeños con \(F\) conjunto alto, el error de interpretación más frecuente de la regresión múltiple y el enlace con la lección 14). Repase también la 7: muestra restricciones que no consisten en quitar regresores. La 12 le pide distinguir, como en las lecciones anteriores, qué está demostrado y qué solo enunciado.
Pregunta 1 [B] — Qué contrasta el \(F\) del pie de la tabla
El estadístico \(F(k-1,\,n-k)\) que Gretl imprime al pie de toda tabla de regresión contrasta la hipótesis de que:
- El coeficiente de la constante es cero, sean cuales sean los demás.
- Todos los coeficientes de los regresores no constantes son cero a la vez.
- Al menos uno de los coeficientes de los regresores no constantes es cero.
- El \(R^2\) del modelo es igual a uno y el residuo es nulo.
Pregunta 2 [B] — Los dos divisores
En \(F=\dfrac{\mathrm{SEC}/(k-1)}{\mathrm{SRC}/(n-k)}\), los números \(k-1\) y \(n-k\) son:
- El número de regresores y el número de observaciones.
- Las dimensiones de los subespacios donde viven, respectivamente, el cateto explicado (los regresores en desviaciones) y el residuo.
- Dos constantes de normalización sin significado geométrico, elegidas para que \(F\) esté siempre entre \(0\) y \(1\) sea cual sea la muestra.
- El número de restricciones y el número de coeficientes.
Pregunta 3 [M] — Por qué \(F\) ronda \(1\) bajo \(H_0\)
Si \(H_0\!:\beta_2=\cdots=\beta_k=0\) es cierta, ¿por qué cabe esperar que el estadístico \(F\) esté cerca de \(1\)?
- Porque bajo \(H_0\) los regresores no intervienen, el cateto explicado es nulo y \(\mathrm{SEC}=0\) en cualquier muestra.
- Porque bajo \(H_0\) la suma de cuadrados de cada cateto tiene esperanza \(\sigma^2\) por grado de libertad: \(\mathrm{SEC}/(k-1)\) y \(\mathrm{SRC}/(n-k)\) estiman ambos \(\sigma^2\).
- Porque \(F\) es siempre igual a \(R^2/(1-R^2)\) y bajo \(H_0\) el \(R^2\) vale \(0{,}5\) en promedio, de modo que el cociente vale \(1\).
- Porque la distribución \(F\) es simétrica alrededor de \(1\), como la \(t\) lo es alrededor de \(0\).
Pregunta 4 [M] — El caso \(k=2\)
En la regresión simple (\(k=2\)), la relación entre el \(F\) de significación conjunta y el \(t\) del regresor es:
- \(F=t\), y las dos reglas de decisión son distintas.
- \(F=t^2\) y \(F_c=t_c^2\): los dos contrastes rechazan en los mismos casos.
- \(F=t^2\) pero \(F_c=t_c\), así que el \(F\) es más exigente.
- No hay relación: \(F\) depende de \(R^2\) y \(t\) no.
Pregunta 5 [M] — Por qué la región crítica tiene una sola cola
El contraste \(F\) rechaza \(H_0\) solo cuando \(F\) es grande, nunca cuando es pequeño. La razón es que:
- La distribución \(F\) solo toma valores positivos y por eso no tiene cola izquierda en la que rechazar.
- Un \(F\) pequeño indica que las restricciones son falsas, pero eso no se puede contrastar con una distribución de una sola cola como la \(F\).
- \(F\) compara longitudes al cuadrado y no tiene signo: un \(F\) pequeño es lo que \(H_0\) predice, y nunca es evidencia contra ella.
- Es una convención de los programas: se podría usar igualmente la cola izquierda con el mismo nivel de significación.
Pregunta 6 [D] — Pitágoras anidado
¿Por qué se cumple \(\mathrm{SRC}_r=\mathrm{SRC}+\Vert\boldsymbol{\mathop{\widehat y}}-{\boldsymbol{\mathop{\widehat y}}}_r\Vert_e^2\) para cualquier hipótesis lineal?
- Porque \(\boldsymbol{\mathop{\widehat y}}-{\boldsymbol{\mathop{\widehat y}}}_r\) está en el subespacio de los regresores y \(\boldsymbol{\mathop{\widehat e}}\) es ortogonal a todo él: \(\boldsymbol y-{\boldsymbol{\mathop{\widehat y}}}_r\) es la suma de dos vectores ortogonales.
- Porque el residuo restringido \(\boldsymbol y-{\boldsymbol{\mathop{\widehat y}}}_r\) es ortogonal a \(\boldsymbol{\mathop{\widehat e}}\), y el teorema de Pitágoras se aplica a esos dos vectores.
- Porque \(\mathrm{SRC}_r\geq\mathrm{SRC}\) siempre, y la diferencia entre dos sumas de cuadrados es siempre la suma de cuadrados de algún vector, sin necesidad de ninguna ortogonalidad.
- No se cumple siempre: solo cuando las restricciones son de exclusión, porque solo entonces el modelo restringido quita columnas.
Pregunta 7 [M] — Qué modelo impone \(\beta_3=\beta_4\)
Para contrastar \(H_0\!:\beta_3=\beta_4\) en el modelo con regresores \(\boldsymbol 1,\boldsymbol x_2,\boldsymbol x_3,\boldsymbol x_4\), el modelo restringido es:
- El que excluye \(\boldsymbol x_3\) y \(\boldsymbol x_4\): si sus coeficientes son iguales, sus efectos se cancelan.
- El que excluye solo \(\boldsymbol x_4\): su efecto queda recogido por el coeficiente de \(\boldsymbol x_3\).
- La regresión sobre \(\boldsymbol 1\), \(\boldsymbol x_2\) y la suma \(\boldsymbol x_3+\boldsymbol x_4\): se pierde una dimensión sin quitar ninguna columna.
- No existe: una igualdad entre coeficientes no se puede contrastar con un \(F\), que solo compara modelos con distinto número de regresores.
Pregunta 8 [D] — \(t\) individuales pequeños, \(F\) conjunto alto
En un modelo, dos regresores tienen valores \(p\) individuales de \(0{,}85\) y \(0{,}30\), pero el \(F\) de excluirlos a la vez tiene un valor \(p\) de \(10^{-12}\). La lectura correcta es:
- Los dos regresores sobran, porque ninguno es significativo: se eliminan ambos y se reestima el modelo sin ellos.
- Hay un error de cálculo, porque un \(F\) conjunto no puede ser significativo si ningún \(t\) lo es: el \(F\) resume los \(t\) individuales, y si todos son pequeños el \(F\) también debe serlo.
- Es colinealidad: juntos acortan el residuo más de lo esperable por azar, pero a cada uno le queda tan poca longitud propia que no se pueden separar sus efectos. No autoriza a eliminar los dos.
- El \(F\) es más fiable que el \(t\) porque usa más grados de libertad, luego los dos coeficientes son individualmente significativos.
Pregunta 9 [B] — Lo que el \(F\) no dice
Se rechaza \(H_0\!:\beta_2=\beta_3=\beta_4=0\) con un \(F\) muy grande. ¿Qué puede concluirse?
- Que los tres coeficientes son distintos de cero, puesto que se ha rechazado que valgan cero.
- Que los tres coeficientes son grandes en términos económicos, tanto más cuanto mayor es el \(F\).
- Que datos como estos serían muy raros si los tres fuesen cero a la vez; cuáles importan y cuánto se lee en los coeficientes y sus intervalos.
- Que el modelo está bien especificado y que los regresores causan las variaciones del regresando, porque un \(F\) tan grande no puede deberse al azar.
Pregunta 10 [D] — Mismo \(R^2\), veredicto opuesto
Dos regresiones con \(k=4\) tienen el mismo \(R^2=0{,}90\); la primera con \(n=6\) no es conjuntamente significativa y la segunda con \(n=10\) sí. ¿Cómo se explica?
- Con \(n=6\) el \(R^2\) está mal calculado: con tan pocas observaciones no puede llegar a \(0{,}90\).
- \(F=\frac{n-k}{k-1}\frac{R^2}{1-R^2}\) combina el ángulo con los grados de libertad: con solo \(n-k=2\) grados de libertad del residuo, ese \(R^2\) es fácil de obtener por azar; con \(n-k=6\) ya no.
- La distribución \(F\) solo es válida para \(n\geq10\); con menos observaciones el contraste no puede hacerse.
- Con \(n=6\) el modelo tiene más grados de libertad y por eso el contraste es más exigente: el valor crítico crece con los grados de libertad del residuo.
Pregunta 11 [M] — Cuando las restricciones no cuestan nada
Al imponer \(q\) restricciones se obtiene \(\mathrm{SRC}_r\) igual a \(\mathrm{SRC}\). Entonces:
- \(F=0\): el ajuste sin restringir ya cumplía las restricciones, \({\boldsymbol{\mathop{\widehat y}}}_r=\boldsymbol{\mathop{\widehat y}}\), y no hay ninguna evidencia contra \(H_0\).
- \(F\) no está definido y el contraste no se puede hacer.
- \(F=1\): es lo que \(H_0\) predice cuando las restricciones se cumplen.
- Las restricciones son falsas: si fuesen ciertas, imponerlas habría cambiado el ajuste y la suma de cuadrados del residuo.
Pregunta 12 [D] — Qué se ha demostrado hoy y qué se ha enunciado
De los siguientes resultados de la sesión, ¿cuál se ha demostrado y cuál se ha enunciado sin demostrar?
- Se ha demostrado que \(F\sim F_{q,\,n-k}\) bajo \(H_0\), y se ha enunciado sin demostrar que \(\mathrm{SRC}_r=\mathrm{SRC}+\Vert\boldsymbol{\mathop{\widehat y}}-{\boldsymbol{\mathop{\widehat y}}}_r\Vert_e^2\), que el apéndice deja también sin demostrar.
- Se ha demostrado el Pitágoras anidado y las identidades \(F=\frac{n-k}{k-1}\frac{R^2}{1-R^2}\) y \(F=t^2\) con \(k=2\); la distribución \(F_{q,\,n-k}\) se ha enunciado, y el apéndice (html) la demuestra.
- Se ha demostrado todo con material del curso, incluida la distribución \(F_{q,\,n-k}\) del estadístico bajo \(H_0\).
- No se ha demostrado nada: la sesión entera se apoya en resultados externos que el apéndice tampoco demuestra.
12. Respuestas htmlonly
- Pregunta 1 [B] — Qué contrasta el \(F\) del pie de la tabla
Respuesta correcta: 2. Evalúa: la formulación exacta de la hipótesis de significación conjunta. La opción 3 confunde \(H_0\) con su negación parcial; la 1 olvida que la constante nunca entra en ese contraste.
- Pregunta 2 [B] — Los dos divisores
Respuesta correcta: 2. Evalúa: la lectura geométrica de los grados de libertad como dimensiones, que es lo que da sentido a ``longitud al cuadrado por grado de libertad''. La opción 3 es falsa además porque \(F\) no está acotado por \(1\). La opción 4 acierta en \(k-1\), que es también el número de restricciones de \(H_0\), y falla en \(n-k\), que no es el número de coeficientes (\(k\)).
- Pregunta 3 [M] — Por qué \(F\) ronda \(1\) bajo \(H_0\)
Respuesta correcta: 2. Evalúa: la idea central de la sesión. La opción 1 es falsa: bajo \(H_0\) el cateto explicado es, para cada realización de las perturbaciones centradas, su proyección sobre \(k-1\) direcciones; su suma de cuadrados, evaluada sobre la muestra aleatoria, tiene esperanza \((k-1)\sigma^2\), no \(0\).
- Pregunta 4 [M] — El caso \(k=2\)
Respuesta correcta: 2. Evalúa: la coherencia entre las dos lecciones: no solo los estadísticos coinciden (\(F=t^2\)), también las distribuciones (\(F_{1,\nu}\) es la de una \(t_\nu\) al cuadrado) y por tanto los valores críticos y las decisiones.
- Pregunta 5 [M] — Por qué la región crítica tiene una sola cola
Respuesta correcta: 3. Evalúa: que la forma de la región crítica se deduce de lo que mide el estadístico, no de una convención. La opción 1 es falsa: la distribución \(F\) tiene cola izquierda, la de los valores cercanos a cero, y no se rechaza en ella por lo que dice la opción 3.
- Pregunta 6 [D] — Pitágoras anidado
Respuesta correcta: 1. Evalúa: el resultado demostrado en la sesión (junto con las identidades \(F=\frac{n-k}{k-1}\frac{R^2}{1-R^2}\) y \(F=t^2\)), y el paso exacto en que se usa la ortogonalidad de la lección 10. La opción 2 afirma una ortogonalidad falsa (el residuo restringido es la hipotenusa, no un cateto), el mismo error que la lección 8 señalaba con el vector de medias.
- Pregunta 7 [M] — Qué modelo impone \(\beta_3=\beta_4\)
Respuesta correcta: 3. Evalúa: que imponer una restricción es cambiar de subespacio, no necesariamente eliminar regresores. Es la fila tercera del ejemplo de
hprice2, y la construcción del modelo restringido que el laboratorio del contraste \(F\) pedirá hacer al alumno. - Pregunta 8 [D] — \(t\) individuales pequeños, \(F\) conjunto alto
Respuesta correcta: 3. Evalúa: la lectura correcta del caso de la apertura, con su mecanismo (longitud propia casi nula) y su consecuencia práctica (no eliminar los dos). La opción 1 es el error habitual en informes; la 2 olvida que \(t\) y \(F\) responden a preguntas distintas.
- Pregunta 9 [B] — Lo que el \(F\) no dice
Respuesta correcta: 3. Evalúa: la lógica de la negación de una hipótesis conjunta (rechazar ``todos nulos'' no es afirmar ``ninguno nulo'') y el reenvío a los coeficientes e intervalos, como en la lección 12.
- Pregunta 10 [D] — Mismo \(R^2\), veredicto opuesto
Respuesta correcta: 2. Evalúa: la descomposición del \(F\) en fuerza de la relación y grados de libertad, con el matiz nuevo de esta lección respecto a la 12: el descuento por el número de regresores \(k-1\). La opción 4 invierte el papel de los grados de libertad.
- Pregunta 11 [M] — Cuando las restricciones no cuestan nada
Respuesta correcta: 1. Evalúa: la lectura del numerador como longitud del cateto añadido: si es cero, los dos ajustes coinciden y las restricciones se cumplían ya en la muestra. Como \(F<1\), si las restricciones no cambian el regresando, el \(R^2\) ajustado del modelo restringido es mayor que el del completo (sección ``Tres restricciones sobre
hprice2''). La opción 3 confunde ``lo que \(H_0\) predice en promedio'' con lo que ocurre en una muestra concreta. - Pregunta 12 [D] — Qué se ha demostrado hoy y qué se ha enunciado
Respuesta correcta: 2. Evalúa: el alcance de la sesión, con el mismo criterio que las lecciones 11 y 12: lo geométrico se demuestra con material del curso; lo distribucional se enuncia.
Notas al pie de página:
Práctica A de la sesión 18, actividad 3 (html): tres printf comparan \(t^2\) con \((n-k)\,\mathrm{SEC}/\mathrm{SRC}\) y con el $Fstat del modelo, y el bloque restrict devuelve el mismo \(F(1,504)\).
Y la hipotenusa igual al cateto del error: \(\boldsymbol y-\boldsymbol{\mathop{\overline y}}=\boldsymbol{\mathop{\widehat e}}\).
Hay una segunda razón, de probabilidad. Si se rechazara \(H_0\) conjunta en cuanto alguno de los \(k-1\) contrastes \(t\) rechace, la probabilidad de rechazar una \(H_0\) cierta no sería menor que el \(5\,\%\), y en la práctica es mayor: el suceso ``alguno rechaza'' contiene al suceso ``el primero rechaza'', que ya tiene probabilidad \(0{,}05\), y lo que añade (que rechace algún otro sin rechazar el primero) tiene probabilidad mayor o igual que cero. Un contraste conjunto es un único contraste sobre la hipótesis que interesa, con un único nivel de significación.
Los dos divisores son grados de libertad: \(k-1\) los del ajuste y \(n-k\) los del residuo. Suman \((k-1)+(n-k)=n-1\), los grados de libertad del vector de datos en desviaciones (lección 11): la dimensión de \(\mathcal L(\boldsymbol 1)^\perp\) (lección 4), donde vive el triángulo entero. La misma lectura, longitud al cuadrado por grado de libertad, explica el divisor \(n\) del producto escalar estadístico: un vector de \(\mathbb R^n\) sin ninguna condición de ortogonalidad tiene \(n\) grados de libertad, y \(\Vert\boldsymbol v\Vert_s^2=\frac1n\sum_iv_i^2\) es la media de las \(n\) coordenadas al cuadrado de \(\boldsymbol v\) en \(\mathbb R^n\), y el vector \(\boldsymbol 1\) mide \(1\) porque todas sus coordenadas valen \(1\). La diferencia está en el espacio donde se cuenta: el producto escalar estadístico divide siempre por \(n\), la dimensión de \(\mathbb R^n\); \(\mathfrak s^2\) y el \(F\) dividen por la dimensión del subespacio donde vive cada vector. Por eso la varianza de \(\boldsymbol y\) divide por \(n\) y la cuasivarianza \(\mathrm{STC}/(n-1)\) por los \(n-1\) grados de libertad del vector de datos en desviaciones (nota de la tabla de resultados, lección 12).
Las palabras ``en promedio'' esconden el mismo abuso de notación de la lección 11: \(\mathrm{SEC}\) y \(\mathrm{SRC}\) son aquí las fórmulas de la lección 8 evaluadas sobre la muestra aleatoria, variables aleatorias y no los números de una tabla, y lo que se afirma es \(\mathrm{E}(\mathrm{SEC})=(k-1)\sigma^2\) bajo \(H_0\) y \(\mathrm{E}(\mathrm{SRC})=(n-k)\sigma^2\). La segunda igualdad es, dicho de otro modo, la insesgadez de \(\mathfrak s^2\) que la lección 11 enunció; y vale con o sin \(H_0\), porque el residuo no cambia por que los regresores aporten algo o no.
La versión más elemental de este resultado: la suma de los cuadrados de \(n\) variables aleatorias independientes de esperanza cero y varianza \(\sigma^2\) tiene esperanza \(n\sigma^2\), porque cada una aporta \(\sigma^2\) y la esperanza de una suma es la suma de las esperanzas (regla 1 del apéndice, sección 1.6 (html)). Aquí las \(n-1\) coordenadas de la perturbación hacen ese papel: cada cuadrado aporta \(\sigma^2\), los \(k-1\) primeros a \(\mathrm{SEC}\) y los otros \(n-k\) a \(\mathrm{SRC}\).
La demostración está en el apéndice (sección 10) (html); aquí basta con la idea, la misma que para la \(t\): numerador y denominador son sumas de cuadrados de dos grupos distintos de coordenadas de la perturbación, \(k-1\) y \(n-k\), y con el supuesto de normalidad de la lección 12, esas coordenadas son independientes. De hecho, la \(t_{n-k}\) y la \(F_{1,\,n-k}\) son la misma distribución mirada de dos maneras: si \(T\sim t_{n-k}\), entonces \(T^2\sim F_{1,\,n-k}\). Es la versión distribucional de \(F=t^2\) que veremos en ``Lectura geométrica: la misma figura''.
Dividiendo numerador y denominador por \(\mathrm{STC}\) y usando Pitágoras (lección 8).
Ese es aquí el papel de la normalidad: la ortogonalidad de las coordenadas basta para las esperanzas de \(\mathrm{SEC}\) y \(\mathrm{SRC}\) por separado, pero no para la esperanza de su cociente; para que \(R^2\) tenga esperanza \((k-1)/(n-1)\) hace falta que las \(n-1\) coordenadas sean intercambiables (que su distribución conjunta no cambie al reordenarlas, de modo que el cuadrado de cada una dividido por la suma de los \(n-1\) cuadrados tenga la misma esperanza para todas), y eso es lo que da la normalidad (apéndice, sección 8 (html)).
Con \(\beta_3=\beta_4=0\), el subespacio restringido es \(\mathcal L(\boldsymbol 1,\boldsymbol x_2)\): hemos perdido dos generadores. Con \(\beta_3=\beta_4\), es \(\mathcal L(\boldsymbol 1,\boldsymbol x_2,\boldsymbol x_3+\boldsymbol x_4)\): la combinación \(\beta_3\boldsymbol x_3+\beta_4\boldsymbol x_4\) con \(\beta_3=\beta_4\) es \(\beta_3(\boldsymbol x_3+\boldsymbol x_4)\), así que los dos regresores se funden en uno y se pierde una dimensión. Las restricciones que fijan un valor, como \(\beta_2=1\), dan un conjunto que no pasa por el origen (un subespacio trasladado por \(\boldsymbol x_2\)); el argumento que sigue vale igual, porque lo único que usa es que los dos ajustes están en \(\mathcal L(\boldsymbol 1,\boldsymbol x_2,\ldots,\boldsymbol x_k)\).
Con \(k=2\) lo demostró la transparencia ``Lectura geométrica: la misma figura''; con varios regresores lo comprobamos aquí con números. La demostración general usa la fórmula de \(\mathrm{ee}(\hat\beta_j)\) que la lección 12 enunció y que la lección 14 leerá con la parte propia del regresor; el apéndice (sección 10) (html) la demuestra con \(q=1\) para cualquier número de regresores, a partir de la fórmula del error estándar de su sección 5.4.
Este contraste puede hacerse también con un estadístico \(t\), como los de la lección 12. El estimador \(\hat\beta_{\text{nox}}-\hat\beta_{\text{stratio}}\) estima \(\beta_{\text{nox}}-\beta_{\text{stratio}}\), que bajo \(H_0\) vale cero; su estimación con estos datos es \(-1693{,}33-(-1166{,}96)=-526{,}4\). Para formar el \(t\) hay que dividirla por su error estándar, y eso exige la varianza del estimador, que no es la suma de las varianzas de los dos coeficientes (reglas 2 y 3 del apéndice, sección 1.6 (html), con la esperanza condicional en lugar de la esperanza): \(Var[\hat\beta_{\text{nox}}-\hat\beta_{\text{stratio}}\mid\boldsymbol X]=Var[\hat\beta_{\text{nox}}\mid\boldsymbol X]+Var[\hat\beta_{\text{stratio}}\mid\boldsymbol X]-2\,Cov[\hat\beta_{\text{nox}},\hat\beta_{\text{stratio}}\mid\boldsymbol X]\). Las dos varianzas están en la diagonal de la matriz \(Var[\boldsymbol{\mathop{\widehat{\beta}}}\mid\boldsymbol X]=\sigma^2(\boldsymbol X^\top\boldsymbol X)^{-1}\) de la lección 11, y la covarianza fuera de la diagonal, \(Cov[\hat\beta_{\text{nox}},\hat\beta_{\text{stratio}}\mid\boldsymbol X]=E[(\hat\beta_{\text{nox}}-\beta_{\text{nox}}\,\mathit1)(\hat\beta_{\text{stratio}}-\beta_{\text{stratio}}\,\mathit1)\mid\boldsymbol X]\); la tabla de resultados muestra las primeras (los cuadrados de los errores estándar), pero no la segunda. Sustituyendo \(\sigma^2\) por \(\mathfrak s^2\), las varianzas estimadas son \(236{,}25^2=55\,814\) y \(128{,}76^2=16\,579\), la covarianza estimada es \(-2\,719\), y el error estándar de la diferencia es \(\sqrt{55\,814+16\,579+2\cdot2\,719}=279{,}0\). El estadístico es \(t=-526{,}4/279{,}0=-1{,}887\), que bajo \(H_0\) sigue la distribución \(t\) con \(502\) grados de libertad, y su cuadrado, \(3{,}56\), es el \(F\) de la tabla: \(F=t^2\) también aquí, porque la restricción es una sola (\(q=1\)). La vía de las sumas de cuadrados da el mismo resultado sin necesitar la covarianza.