Sesión 18 (C) — ¿Cubre de verdad el 95 por ciento? La cobertura del intervalo y la frecuencia de detección
Índice
- Descripción de la práctica
- Actividad 1 - ¿Cubre el 95 por ciento?
- Actividad 2 - El precio de estimar \(\sigma\)
- Actividad 3 - Una hipótesis falsa por poco, con \(n=12\) y con \(n=120\)
- Apéndice - ¿Y si las perturbaciones no son normales?
- Preguntas de interpretación para la clase
- Para profundizar
- Código completo de la práctica
- Respuestas
Descripción de la práctica
La lección 12 (html) distinguió lo que el intervalo de confianza dice y lo que no dice: dice que el suceso ``el intervalo contiene a \(\beta_2\)'' tiene probabilidad \(0{,}95\), con los extremos del intervalo como variables aleatorias; no dice que \(\beta_2\) esté en este intervalo con probabilidad \(0{,}95\). Una probabilidad se observa como frecuencia cuando el experimento se repite muchas veces, y eso hace esta práctica.
Tomamos de la práctica B (actividad 2 (html)) el regresor disperso de la lección 12 (doce valores de \(22{,}5\) a \(77{,}5\)) y los parámetros \(\beta_1=10\) y \(\beta_2=0{,}5\). Las perturbaciones, que allí eran doce números dados, se sortean aquí de una distribución normal con \(\sigma=1{,}1\), el valor de \(\mathfrak s\) en aquella práctica. La mecánica es la del loop de la práctica A de la sesión 16 (actividad 3 (html)). En cada réplica sorteamos doce perturbaciones nuevas, estimamos, construimos el intervalo y anotamos si contiene al \(0{,}5\) verdadero. Después contamos.
Los datos son simulados porque solo conociendo \(\beta_2\) se puede saber si el intervalo lo contiene.
Objetivos
- Comprobar que el intervalo al \(95\%\) contiene al verdadero \(\beta_2\) en (aproximadamente) el \(95\%\) de las réplicas, y ver, réplica a réplica, cuáles fallan.
- Medir el precio de estimar \(\sigma\): qué cobertura se obtiene si se usa \(1{,}96\) en lugar del valor crítico de la \(t_{10}\).
- Contrastar una hipótesis falsa por poco con \(n=12\) y con \(n=120\): el mismo desvío, medido con un regresor en desviaciones \(\sqrt{10}\) veces más largo.
- (Apéndice) Ver qué ocurre con la cobertura cuando las perturbaciones no son normales.
Comandos nuevos de esta práctica. La mecánica de loop R --progressive --quiet con store, y la reapertura del fichero de réplicas con open, son las de la práctica A de la sesión 16 (actividad 3 y actividad 4 (html)); $coeff, el de la práctica A de la sesión 11 (actividad 3 (html)); critical y $stderr, los de las prácticas A (actividad 2 (html)) y B de hoy; randgen(X, 1), la de la práctica C de la sesión 16 (actividad 1 (html)); smpl full, que devuelve la muestra entera, el de la práctica A de la sesión 14 (actividad 6 (html)). Lo nuevo:
quantile(x, p)- el cuantil de orden
pde la serie: el valor que deja por debajo una fracciónpde los datos. %- resto de la división entera:
(index - 1) % 12toma los valores \(0,1,\ldots,11\) y vuelve a empezar. contador +expresión=- suma la expresión al escalar
contadory guarda el resultado en él; es la forma abreviada decontador = contador + expresión. Como aquí la expresión vale \(1\) o \(0\), el escalar cuenta las réplicas que cumplen la condición. smpl 1 100ysmpl 1 12- restringen la muestra a las observaciones 1 a 100 y 1 a 12.
gnuplot ... --time-series --with-lines- dibuja las series frente al número de observación y con líneas en lugar de puntos.
Actividad 1 - ¿Cubre el 95 por ciento?
Construimos el mundo, fijamos el valor crítico de la \(t\) con \(n-k=10\) grados de libertad, y repetimos el experimento \(4\,000\) veces guardando, en cada réplica, la estimación, su error estándar, los dos extremos del intervalo, un indicador de si contiene al verdadero \(\beta_2\) y el estadístico \(t\) para la hipótesis cierta \(H_0\!:\beta_2=0{,}5\).
El código tiene tres bloques. El primero construye el mundo (doce observaciones, el regresor disperso de la práctica B, actividad 2 (html), los parámetros y el número de réplicas R) y guarda los dos valores críticos: el de la \(t_{10}\) y el \(1{,}96\) de la normal. Sigue el bucle: en cada vuelta sortea doce perturbaciones, forma y, estima con --quiet y guarda en escalares la estimación, su error estándar, los dos extremos del intervalo, el indicador contiene_beta2 (vale \(1\) si el verdadero \(\beta_2\) está entre los dos extremos; && une las dos desigualdades), el estadístico \(t\) de la hipótesis cierta y el indicador análogo construido con \(1{,}96\); store añade al fichero de réplicas una fila con esos siete valores. El segundo bloque abre ese fichero, que tiene una observación por réplica, y vuelve a definir tc y zc, porque al abrir un fichero Gretl descarta los escalares definidos (como en la práctica A de la sesión 16, actividad 4 (html)). El tercero imprime el número de réplicas y dos medias: la de contiene_beta2, que es la fracción de intervalos que contienen a \(\beta_2\), y la de la condición \(|t|>t_c\), que es la fracción de rechazos.
en línea de comandos:
nulldata 12
setobs 1 1 --cross-section
series x = 22.5 + 5*(index - 1)               # el regresor disperso de la leccion 12
scalar beta1_verdadero = 10
scalar beta2_verdadero = 0.5
scalar sigma = 1.1
scalar R  = 4000
scalar tc = critical(t, 10, 0.025)            # valor critico de la t_10 al 5%
scalar zc = 1.96                              # el de la normal, para la Actividad 2

set seed 20261113
loop R --progressive --quiet
    series u = normal(0, sigma)
    series y = beta1_verdadero + beta2_verdadero*x + u
    ols y const x --quiet
    scalar beta2_estimado = $coeff(x)
    scalar error_estandar = $stderr(x)
    # extremos del intervalo al 95%
    scalar extremo_inferior = beta2_estimado - tc*error_estandar
    scalar extremo_superior = beta2_estimado + tc*error_estandar
    # 1 si el intervalo contiene al verdadero beta_2, 0 si no
    scalar contiene_beta2 = (extremo_inferior <= beta2_verdadero && beta2_verdadero <= extremo_superior)
    # estadistico t para la H0 CIERTA beta_2 = 0,5
    scalar t_H0_cierta = (beta2_estimado - beta2_verdadero)/error_estandar
    # el mismo indicador con 1,96 en vez de t_c
    scalar contiene_beta2_con_196 = (beta2_estimado - zc*error_estandar <= beta2_verdadero && \
                                     beta2_verdadero <= beta2_estimado + zc*error_estandar)
    store "@workdir/replicasIC.gdt" beta2_estimado error_estandar extremo_inferior extremo_superior \
                                    contiene_beta2 t_H0_cierta contiene_beta2_con_196
endloop
open "@workdir/replicasIC.gdt" --quiet
scalar tc = critical(t, 10, 0.025)            # al abrir otro fichero, Gretl descarta los escalares
scalar zc = 1.96
printf "Replicas                                    : %d\n", $nobs
printf "Intervalos que contienen al verdadero beta_2: %.4f   (objetivo: 0,95)\n", mean(contiene_beta2)
printf "Rechazos de la H0 cierta al 5%%              : %.4f   (objetivo: 0,05)\n", mean(abs(t_H0_cierta) > tc)
Replicas                                    : 4000
Intervalos que contienen al verdadero beta_2: 0,9520   (objetivo: 0,95)
Rechazos de la H0 cierta al 5%              : 0,0480   (objetivo: 0,05)
Los intervalos, uno a uno
Un porcentaje es un resumen. Para ver qué significa, dibujamos los cien primeros intervalos: sus dos extremos como dos líneas, y el verdadero \(\beta_2\) como una línea horizontal. Cada valor del eje horizontal es una réplica: su intervalo no contiene a \(\beta_2\) si en ese punto la línea del extremo inferior está por encima de \(0{,}5\) o la del extremo superior está por debajo.
smpl 1 100 se queda con las cien primeras réplicas. beta2_constante es una serie constante igual a \(0{,}5\), para dibujarla como línea horizontal. gnuplot dibuja los dos extremos y esa constante frente al número de réplica, con líneas. 100 - sum(contiene_beta2) cuenta los intervalos que fallan entre esos cien, y smpl full recupera las \(4\,000\) réplicas.
en línea de comandos:
smpl 1 100
series beta2_constante = 0.5
gnuplot extremo_inferior extremo_superior beta2_constante --time-series --with-lines
printf "Intervalos que fallan entre los 100 primeros: %d\n", 100 - sum(contiene_beta2)
smpl full
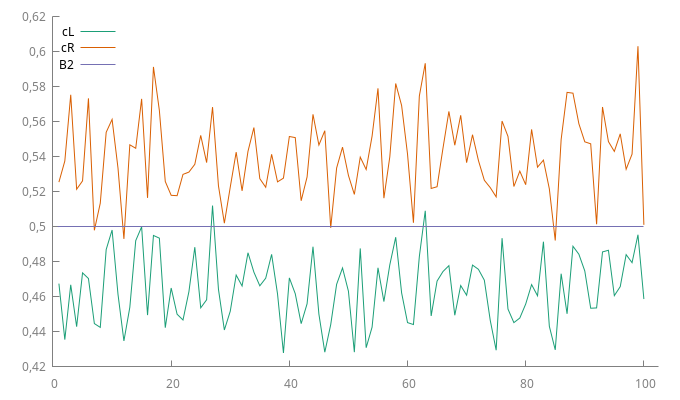
Figura 1: Los cien primeros intervalos de confianza al \(95\%\): extremo inferior y superior de cada uno, frente al verdadero \(\beta_2=0{,}5\) (línea horizontal). Cada valor del eje horizontal es una réplica; su intervalo no contiene a \(0{,}5\) si en ese punto la línea del extremo superior queda por debajo de la horizontal o la del extremo inferior por encima.
Intervalos que fallan entre los 100 primeros: 7
Lo que debe observar
La fracción de intervalos que contienen a \(\beta_2\) es \(0{,}9520\) y la de rechazos de la hipótesis cierta, \(0{,}0480\). Suman \(1\) porque el intervalo deja fuera a \(0{,}5\) en las mismas réplicas en que el contraste rechaza \(H_0\!:\beta_2=0{,}5\). Con \(4\,000\) réplicas no cabe esperar exactamente \(0{,}9500\), porque la frecuencia observada es a su vez una variable aleatoria, pero sí una distancia pequeña.
Entre los cien primeros intervalos fallan \(7\), no \(5\). Cinco se ven en la figura (réplicas 7, 12, 27, 63 y 85); en los otros dos (réplicas 15 y 47) el extremo queda a menos de una milésima de \(0{,}5\) y no se distinguen a esa escala. Con solo cien réplicas esa diferencia es corriente: si cada intervalo falla con probabilidad \(0{,}05\), siete o más fallos entre cien ocurren casi una de cada cuatro veces.
Cada réplica es un bloque de \(n\) filas de la matriz de copias, evaluado en el único \(\omega\) que la semilla fija (apéndice, sección 3 (html)). La cobertura \(0{,}95\) es la probabilidad del suceso ``el intervalo contiene a \(\beta_2\)'': la fracción de columnas de esa matriz en las que ocurre. Los bloques, por ser copias independientes, la reproducen como frecuencia. El apéndice (sección 9) (html) muestra que ese suceso tiene probabilidad \(1-\alpha\) sea cual sea el regresor.
La figura muestra de dónde sale esa frecuencia. El intervalo cambia de una réplica a otra: sus extremos son variables aleatorias, funciones de la muestra aleatoria. El \(\beta_2\) verdadero, en cambio, no cambia. Esa es la razón de la lectura correcta de la lección 12 (html): lo aleatorio es el intervalo, no el parámetro, y el \(0{,}95\) es la probabilidad de que el intervalo aleatorio contenga al parámetro fijo, que aquí vemos como frecuencia. Mirando un solo intervalo, cualquiera de los cien, no hay forma de saber si contiene a \(\beta_2\).
Actividad 2 - El precio de estimar \(\sigma\)
La lección 12 (html) explicó por qué el estadístico sigue una \(t_{n-k}\) y no una normal: en el denominador va \(\mathfrak s\), que fluctúa de muestra en muestra, y eso ensancha las colas (la demostración está en el apéndice, sección 9 (html)). Con \(n-k=10\) la diferencia entre \(t_c=2{,}228\) y \(1{,}96\) es del \(14\%\). Ya hemos guardado, en cada réplica, si el intervalo construido con \(1{,}96\) contenía al verdadero \(\beta_2\); y tenemos los \(4\,000\) estadísticos \(t\) bajo la hipótesis cierta, cuya distribución podemos mirar directamente.
El código tiene seis printf. Los dos primeros comparan la cobertura con tc y con \(1{,}96\) (medias de contiene_beta2 y de contiene_beta2_con_196). El tercero es la cabecera de los cuantiles; el cuarto y el quinto imprimen los cuantiles empíricos del \(2{,}5\%\) y del \(97{,}5\%\) de los \(4\,000\) estadísticos, calculados con quantile, junto a los valores que predicen la \(t_{10}\) y la normal. El sexto calcula la fracción de \(|t|\) mayores que \(1{,}96\). freq t_H0_cierta imprime la tabla de frecuencias de los estadísticos, que aquí no se comenta, y dibuja su histograma.
en línea de comandos:
printf "Cobertura del intervalo con t_c = %.3f : %.4f\n", tc, mean(contiene_beta2)
printf "Cobertura del intervalo con 1,96       : %.4f\n", mean(contiene_beta2_con_196)
printf "\nCuantiles empiricos del estadistico t bajo la H0 cierta:\n"
printf "   2,5%%  -> %.3f      (la t_10 predice %.3f; la normal, %.3f)\n", quantile(t_H0_cierta, 0.025), -tc, -zc
printf "  97,5%%  -> %.3f      (la t_10 predice  %.3f; la normal,  %.3f)\n", quantile(t_H0_cierta, 0.975), tc, zc
printf "Fraccion de |t| > 1,96                 : %.4f   (con 1,96 se rechazaria la H0 cierta mas del 5%%)\n", mean(abs(t_H0_cierta) > zc)
freq t_H0_cierta
Cobertura del intervalo con t_c = 2,228 : 0,9520
Cobertura del intervalo con 1,96       : 0,9188

Cuantiles empiricos del estadistico t bajo la H0 cierta:
   2,5%  -> -2,176      (la t_10 predice -2,228; la normal, -1,960)
  97,5%  -> 2,236      (la t_10 predice  2,228; la normal,  1,960)
Fraccion de |t| > 1,96                 : 0,0812   (con 1,96 se rechazaria la H0 cierta mas del 5%)
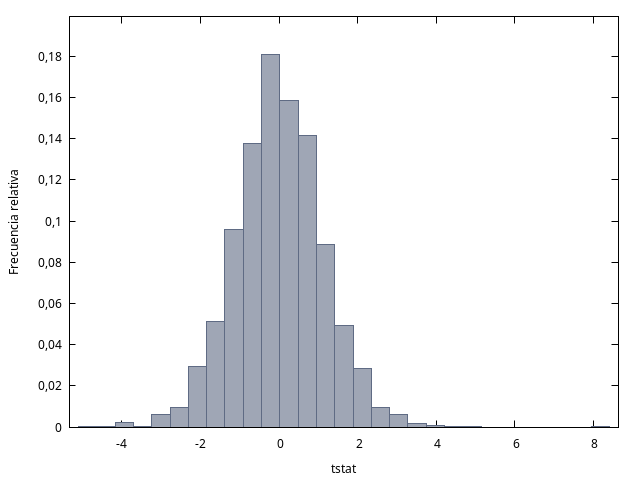
Figura 2: Histograma de los \(4\,000\) estadísticos \(t=(\hat\beta_2-0{,}5)/\mathrm{ee}(\hat\beta_2)\), calculados bajo la hipótesis cierta. Sus cuantiles del \(2{,}5\%\) y del \(97{,}5\%\) caen donde los sitúa la \(t_{10}\), no donde los sitúa la normal.
Lo que debe observar
Con \(1{,}96\) el intervalo contiene a \(\beta_2\) en el \(91{,}9\%\) de las réplicas, no en el \(95\%\), y el contraste rechaza la hipótesis cierta en el \(8{,}1\%\), no en el \(5\%\). Los cuantiles empíricos del estadístico lo confirman: se sitúan en \(-2{,}18\) y \(2{,}24\), no en \(\pm1{,}96\). Esa diferencia es lo que la lección 12 llamó ``el precio de estimar \(\sigma\)'': el \(\mathfrak s\) del denominador fluctúa, el cociente se dispersa más que una normal, y la \(t_{n-k}\) lo tiene en cuenta. Con diez grados de libertad la diferencia entre los dos valores críticos es la que muestra la salida; con \(504\), como en la práctica A (actividad 2 (html)), \(t_c\) vale \(1{,}965\) y usar \(1{,}96\) no cambia casi nada.
Actividad 3 - Una hipótesis falsa por poco, con \(n=12\) y con \(n=120\)
Hasta aquí hemos contrastado una hipótesis cierta. Ahora contrastamos una falsa por poco: \(H_0\!:\beta_2=0{,}47\), cuando el verdadero es \(0{,}5\). ¿Con qué frecuencia la detecta el contraste? Lo hacemos dos veces: con las doce observaciones de las actividades anteriores y con ciento veinte, que repiten diez veces el mismo patrón del regresor. La \(\sigma\) y la hipótesis son las mismas. Cambian el tamaño de la muestra y, con él, los grados de libertad y el valor crítico.
El código tiene tres bloques. El primero crea un conjunto de 120 observaciones con el patrón del regresor repetido diez veces gracias al resto % 12, y define de nuevo los parámetros, que se perdieron al abrir el fichero de réplicas en la Actividad 1, y el valor falso valor_falso. El segundo restringe la muestra a las doce primeras, calcula el valor crítico con los grados de libertad $nobs - 2, fija la semilla, pone a cero dos contadores y repite R veces: sortear, estimar, calcular los dos extremos del intervalo, y sumar a rechazos_H0_falsa un \(1\) si el estadístico de la hipótesis falsa supera el valor crítico y a intervalos_que_contienen un \(1\) si el intervalo contiene al verdadero \(\beta_2\). Este bucle no lleva --progressive ni store: solo acumula en los dos escalares, y el printf final los divide por R. El tercero repite lo mismo con smpl full, es decir, con las 120 observaciones.
en línea de comandos:
nulldata 120 --preserve
setobs 1 1 --cross-section
series x = 22.5 + 5*((index - 1) % 12)       # el mismo patron, diez veces
scalar beta1_verdadero = 10                  # los parametros, de nuevo
scalar beta2_verdadero = 0.5
scalar sigma = 1.1
scalar R = 4000
scalar valor_falso = 0.47
smpl 1 12                                    # una sola vuelta del patron: n = 12
scalar tc = critical(t, $nobs - 2, 0.025)
set seed 20261113
scalar rechazos_H0_falsa = 0
scalar intervalos_que_contienen = 0
loop R --quiet
    series u = normal(0, sigma)
    series y = beta1_verdadero + beta2_verdadero*x + u
    ols y const x --quiet
    scalar extremo_inferior = $coeff(x) - tc*$stderr(x)
    scalar extremo_superior = $coeff(x) + tc*$stderr(x)
    rechazos_H0_falsa        += (abs(($coeff(x) - valor_falso)/$stderr(x)) > tc)
    intervalos_que_contienen += (extremo_inferior <= beta2_verdadero && beta2_verdadero <= extremo_superior)
endloop
printf "n = %3d:  t_c = %.3f   rechazos de la H0 falsa (0,47) = %.3f   cobertura del IC = %.3f\n", \
       $nobs, tc, rechazos_H0_falsa/R, intervalos_que_contienen/R
n = 12: t_c = 2,228 rechazos de la H0 falsa (0,47) = 0,319 cobertura del IC = 0,952
en línea de comandos:
smpl full                                    # las diez vueltas: n = 120
scalar tc = critical(t, $nobs - 2, 0.025)
set seed 20261113
scalar rechazos_H0_falsa = 0
scalar intervalos_que_contienen = 0
loop R --quiet
    series u = normal(0, sigma)
    series y = beta1_verdadero + beta2_verdadero*x + u
    ols y const x --quiet
    scalar extremo_inferior = $coeff(x) - tc*$stderr(x)
    scalar extremo_superior = $coeff(x) + tc*$stderr(x)
    rechazos_H0_falsa        += (abs(($coeff(x) - valor_falso)/$stderr(x)) > tc)
    intervalos_que_contienen += (extremo_inferior <= beta2_verdadero && beta2_verdadero <= extremo_superior)
endloop
printf "n = %3d:  t_c = %.3f   rechazos de la H0 falsa (0,47) = %.3f   cobertura del IC = %.3f\n", \
       $nobs, tc, rechazos_H0_falsa/R, intervalos_que_contienen/R
n = 120: t_c = 1,980 rechazos de la H0 falsa (0,47) = 0,999 cobertura del IC = 0,946
Lo que debe observar
La fracción de intervalos que contienen a \(\beta_2\) es la misma en los dos casos, en torno al \(95\%\) (\(0{,}952\) y \(0{,}946\); el bloque de \(n=12\), con la misma semilla, repite las réplicas de la Actividad 1, y por eso su cobertura vuelve a ser \(0{,}952\)): el intervalo tiene la cobertura anunciada con doce datos y con ciento veinte. Lo que cambia es la detección: con \(n=12\) la hipótesis falsa se rechaza en el \(31{,}9\%\) de las réplicas, menos de una de cada tres; con \(n=120\), en el \(99{,}9\%\).
Es el mecanismo de la lección 12: con diez copias del patrón, el regresor en desviaciones es \(\sqrt{10}\) veces más largo y el error estándar, \(\sqrt{10}\) veces menor. La desviación típica del estimador es \(\sigma/\|\boldsymbol x-\boldsymbol{\mathop{\overline x}}\|_e=1{,}1/59{,}79=0{,}0184\) con \(n=12\) y \(0{,}0058\) con \(n=120\). El mismo desvío de \(0{,}03\) equivale a \(1{,}6\) desviaciones típicas en el primer caso, menos que el valor crítico \(2{,}228\), y a \(5{,}2\) en el segundo, mucho más que \(1{,}980\). La relación entre \(x\) e \(y\) es la misma en los dos casos, la \(\sigma\) es la misma y la hipótesis es igual de falsa; lo que ha crecido es la longitud del regresor en desviaciones, y con ella la frecuencia con la que el contraste rechaza una hipótesis falsa. (Los manuales llaman potencia del contraste a la probabilidad de rechazar una hipótesis falsa; esa frecuencia la aproxima.)
En la práctica A (actividad 5 (html)) ocurrió algo parecido con datos reales: al repetir el sorteo de doce viviendas, una de cada cuatro ejecuciones no rechazaba \(H_0\!:\beta_2=0\). Allí \(\beta_2\) no se conoce, pero con las \(506\) viviendas esa hipótesis se rechaza con \(t=21{,}75\). Con pocas observaciones, ``no rechazar'' es muchas veces no tener evidencia suficiente para decidir; no equivale a ``aceptar''.
Apéndice - ¿Y si las perturbaciones no son normales?
Material complementario, con el mismo estatus que el apéndice matricial (html) de la práctica A de la sesión 16: va más allá de lo que da tiempo en clase y queda aquí para quien quiera completarlo.
Según la lección 12 (html), la normalidad es el único supuesto nuevo, y su cometido es dar forma a la distribución de \(\hat\beta_2\). La práctica C de la sesión 16 (actividad 1 (html)) mostró que insesgadez y varianza no la necesitan; la pregunta ahora es si la cobertura del intervalo, que sí depende de la forma, la necesita. Repetimos la Actividad 3 con perturbaciones \(\chi^2\) de un grado de libertad, centradas y reescaladas a la misma \(\sigma\): una distribución muy asimétrica, la misma que usó la práctica C de la sesión 16 (actividad 2 (html)). Allí, con \(n=12\), el histograma de las \(4\,000\) estimaciones \(\hat\beta_2\) salía casi simétrico, pero con colas más pesadas que las de la normal, y el contraste rechazaba la hipótesis de normalidad.
El código tiene dos bloques con la misma estructura que los dos últimos bloques de la Actividad 3, cambiando la perturbación: randgen(X, 1) sortea una \(\chi^2\) con un grado de libertad, que tiene esperanza \(1\) y varianza \(2\); restar \(1\) y dividir por \(\sqrt2\) la centra y le da desviación típica \(1\), y multiplicar por sigma le da la \(\sigma\) de esta práctica. Los contadores son ahora la cobertura y los rechazos de la hipótesis cierta. Los dos bloques usan el conjunto de 120 observaciones y los escalares que creó el primer bloque de la Actividad 3: ejecute antes ese bloque si ha cerrado Gretl.
en línea de comandos:
smpl 1 12
scalar tc = critical(t, $nobs - 2, 0.025)
set seed 20261113
scalar intervalos_que_contienen = 0
scalar rechazos_H0_cierta = 0
loop R --quiet
    series u = (randgen(X, 1) - 1)/sqrt(2) * sigma     # chi2(1) centrada, con desviacion tipica sigma
    series y = beta1_verdadero + beta2_verdadero*x + u
    ols y const x --quiet
    scalar extremo_inferior = $coeff(x) - tc*$stderr(x)
    scalar extremo_superior = $coeff(x) + tc*$stderr(x)
    intervalos_que_contienen += (extremo_inferior <= beta2_verdadero && beta2_verdadero <= extremo_superior)
    rechazos_H0_cierta       += (abs(($coeff(x) - beta2_verdadero)/$stderr(x)) > tc)
endloop
printf "chi2(1) centrada, n = %3d:  cobertura del IC = %.4f   rechazos de la H0 cierta = %.4f\n", \
       $nobs, intervalos_que_contienen/R, rechazos_H0_cierta/R
chi2(1) centrada, n = 12: cobertura del IC = 0,9620 rechazos de la H0 cierta = 0,0380
en línea de comandos:
smpl full
scalar tc = critical(t, $nobs - 2, 0.025)
set seed 20261113
scalar intervalos_que_contienen = 0
scalar rechazos_H0_cierta = 0
loop R --quiet
    series u = (randgen(X, 1) - 1)/sqrt(2) * sigma
    series y = beta1_verdadero + beta2_verdadero*x + u
    ols y const x --quiet
    scalar extremo_inferior = $coeff(x) - tc*$stderr(x)
    scalar extremo_superior = $coeff(x) + tc*$stderr(x)
    intervalos_que_contienen += (extremo_inferior <= beta2_verdadero && beta2_verdadero <= extremo_superior)
    rechazos_H0_cierta       += (abs(($coeff(x) - beta2_verdadero)/$stderr(x)) > tc)
endloop
printf "chi2(1) centrada, n = %3d:  cobertura del IC = %.4f   rechazos de la H0 cierta = %.4f\n", \
       $nobs, intervalos_que_contienen/R, rechazos_H0_cierta/R
chi2(1) centrada, n = 120: cobertura del IC = 0,9478 rechazos de la H0 cierta = 0,0523
Lo que debe observar
Con \(n=12\) la cobertura y la tasa de rechazo se apartan de sus valores nominales, y lo hacen hacia el lado conservador: el intervalo contiene a \(\beta_2\) en el \(96{,}2\%\) de las réplicas, más del \(95\%\), y el contraste rechaza la hipótesis cierta en el \(3{,}8\%\), menos del \(5\%\). El aparato de la lección 12, construido bajo normalidad, se vuelve conservador con estas perturbaciones y esta muestra. El nivel del \(5\%\) que se ha fijado ya no es la frecuencia real de rechazo.
Con \(n=120\) la desviación prácticamente desaparece (\(94{,}8\%\) y \(5{,}2\%\)). Lo dijo el final de la lección 12 (html): en muestras grandes, por el teorema central del límite, \(\hat\beta_2\) tiene una distribución aproximadamente normal aunque \(U\) no la tenga, y los contrastes e intervalos vuelven a ser aproximadamente válidos sin el supuesto. En muestras pequeñas, la normalidad es el supuesto del que depende el resultado exacto; cuando no se cumple, el nivel real del contraste deja de ser el nominal.
Preguntas de interpretación para la clase
- En la Actividad 1, la frecuencia de cobertura no ha salido exactamente \(0{,}95\). ¿Qué esperaría que ocurriese con la diferencia si el experimento se repitiera con \(400\,000\) réplicas en lugar de \(4\,000\)? ¿Y si se repitiera con otras \(4\,000\), cambiando la semilla?
- Escoja uno de los intervalos de la figura que no contiene a \(0{,}5\). Si ese fuera el único que tuviera, como ocurre siempre con datos reales, ¿qué diría de él? ¿Habría alguna forma de saber que es de los que fallan?
- En la Actividad 2, ¿por qué usar \(1{,}96\) con \(n-k=10\) hace que el contraste rechace la hipótesis cierta más del \(5\%\) de las veces, y no menos?
- En la Actividad 3, la cobertura es la misma con doce y con ciento veinte observaciones, pero la detección no. ¿Qué propiedad del intervalo se conserva al cambiar \(n\), y cuál cambia? Relaciónelo con la anchura de los intervalos de la práctica A (actividad 5 (html)).
- Tras el Apéndice: si en un estudio con muestra pequeña las perturbaciones fueran claramente asimétricas, ¿en qué sentido habría que tomar con cautela un valor \(p\) de \(0{,}04\)? ¿Y uno de \(0{,}0001\)?
Para profundizar
- Lección 12 (lección 12), secciones ``El intervalo de confianza'' (html) y ``Por qué el valor crítico depende de \(n-k\)'' (html).
- Wooldridge, J. M. (2020). Introductory Econometrics, cap. 4, sección 4.3 (intervalos de confianza) y cap. 5, sección 5.2 (validez aproximada de los contrastes en muestras grandes sin normalidad).
- Manual de Gretl, capítulo sobre loop constructs; funciones
quantileyrandgen.
Código completo de la práctica
| Enlace al guión: | S18-Prct-C-cobertura.inp |
Respuestas
- Más réplicas, otra semilla. La frecuencia de cobertura observada es la media de \(R\) indicadores \(0/1\) independientes, cada uno con probabilidad \(0{,}95\) de valer \(1\); su desviación típica es \(\sqrt{0{,}95\cdot0{,}05/R}\), unos \(0{,}0034\) con \(R=4\,000\) y diez veces menos con \(R=400\,000\). Cabe esperar, por tanto, que la distancia a \(0{,}95\) se reduzca a la décima parte. Con otra semilla y las mismas \(4\,000\) réplicas, la frecuencia sería otra, a unas milésimas de la obtenida: la frecuencia empírica es una variable aleatoria con esa desviación típica.
- Un intervalo que falla, visto en solitario. Nada lo distingue de los que aciertan: tiene el mismo aspecto, la misma anchura aproximada, se ha construido con el mismo procedimiento. Con datos reales no hay forma de saber si el intervalo que tenemos delante es uno de los del \(5\%\). Eso es lo que significa que la garantía sea sobre el procedimiento y no sobre el intervalo concreto: sabemos cuántas veces acierta el método, no si ha acertado esta vez.
- Por qué \(1{,}96\) rechaza de más. Porque \(1{,}96<2{,}228\): la región crítica ``\(\vert t\vert>1{,}96\)'' es más grande que ``\(\vert t\vert>2{,}228\)'', y el estadístico, que sigue una \(t_{10}\), con colas más gruesas que la normal, cae en ella con más frecuencia que el \(5\%\). Usar el valor crítico de la normal es actuar como si \(\sigma\) fuese conocida; como no lo es y se estima, el estadístico se dispersa más de lo que la normal supone, y el contraste, calibrado para una normal, rechaza con más frecuencia que el nivel anunciado.
- Lo que se conserva y lo que cambia con \(n\). Se conserva la cobertura: sea cual sea \(n\), el intervalo al \(95\%\) contiene al parámetro el \(95\%\) de las veces, porque su valor crítico se ajusta a los grados de libertad. Cambia la anchura: con más observaciones el error estándar es menor (el regresor en desviaciones es más largo) y el intervalo, más estrecho; por eso un valor falso por poco queda fuera de él con más frecuencia. Es lo que se veía en la práctica A (actividad 5 (html)) al pasar de doce viviendas a \(506\): la misma garantía del \(95\%\), con un intervalo once veces más estrecho y, en consecuencia, mucho más informativo.
- Valores \(p\) con muestra pequeña y perturbaciones asimétricas. El Apéndice muestra que, en ese caso, el nivel real del contraste no coincide con el nominal: aquí el contraste resultó conservador, pero con otras distribuciones podría ser lo contrario, y en cualquier caso el \(0{,}05\) elegido deja de ser una cifra fiable. Un valor \(p\) de \(0{,}04\) está tan cerca del umbral que esa descalibración puede cambiar el veredicto: hay que tomarlo como ``en el límite'', no como ``significativo''. Uno de \(0{,}0001\) está tan lejos del umbral que ninguna descalibración razonable lo convierte en no significativo: la decisión de rechazar no depende de esa descalibración, aunque la cifra exacta sí. La regla práctica es que la cautela hace falta cerca del umbral, y que con muestras grandes el problema desaparece.