Sesión 20 (C) — La distribución del \(F\) cuando \(H_0\) es cierta
Índice
Descripción de la práctica
La lección 13 dijo que, si \(H_0\) es cierta y las perturbaciones son normales, el \(F\) sigue una distribución \(F\) de Fisher con \(q\) y \(n-k\) grados de libertad: numerador y denominador estiman los dos \(\sigma^2\), así que el cociente oscila en torno a \(1\), y el valor crítico deja un \(5\%\) de probabilidad a su derecha. Esta práctica lo comprueba repitiendo, como la práctica C de la sesión 18 comprobó la cobertura del intervalo (actividad 1 (html)).
El mundo artificial usa los regresores reales de hprice2 (rooms, nox y stratio) y una variable dependiente simulada en la que ninguno de los tres interviene: \(y=20\,000+u\), con \(u\) normal de desviación típica \(5\,000\). La hipótesis \(H_0\!:\beta_{\text{rooms}}=\beta_{\text{nox}}=\beta_{\text{stratio}}=0\) es cierta por construcción. Después la hacemos falsa por poco y miramos cuántas veces el \(F\) lo detecta, con \(n=20\) y con \(n=506\).
Objetivos
- Ver que bajo \(H_0\) cierta el numerador y el denominador del \(F\) tienen media \(\sigma^2\), que el \(F\) oscila en torno a \(1\) con cola derecha, y que rechaza en (aproximadamente) el \(5\%\) de las réplicas.
- Repetir con \(n=20\) para ver que la distribución depende de \(n-k\) y que usar el valor crítico equivocado cambia la frecuencia de rechazo.
- Con una \(H_0\) falsa por poco, comparar la frecuencia de rechazo con \(n=20\) y con \(n=506\).
Comandos nuevos de esta práctica. La mecánica es la de la práctica A de la sesión 16 (actividad 3 (html)): loop R --progressive --quiet, store para acumular una fila por réplica en un fichero .gdt, y open de ese fichero al terminar el bucle; smpl 20 --random y smpl full (sesiones 16 y 18); critical y quantile (sesión 18); $Fstat, el \(F\) del pie de la tabla de ols, el contraste de que todos los coeficientes salvo la constante son cero (práctica A de la sesión 18, actividad 3 (html)), que es el \(F\) de hoy porque \(H_0\) excluye los tres regresores; y $rsq, el \(R^2\) del último modelo (sesión 11), que junto con $ess permite recuperar la \(\mathrm{SEC}\), que Gretl no devuelve directamente. Lo nuevo:
mean(Fst > Fc)- la comparación produce una serie de ceros y unos (práctica C de la sesión 7, actividad 1 (html)), y su media es la fracción de réplicas en que el \(F\) supera el valor crítico (práctica C de la sesión 18, actividad 1 (html)).
rech +(…)=- suma al escalar
rechel valor entre paréntesis, uno o cero: el contador de rechazos de la práctica C de la sesión 18 (actividad 3 (html)). openy los escalares- al abrir un conjunto de datos,
openborra los escalares definidos antes, salvo con la opción--preserve. Por eso los bloques de las Actividades 2 y 3 vuelven a definirb1,sigyRjusto después deopen, yBajoH0ResultadosyN20Resultadosredefinen, tras elopende las réplicas, los escalares que usan (sig,Fc506,Fc20).
Actividad 1 - Dos mil réplicas bajo \(H_0\) cierta, \(n=506\)
Abra hprice2, fije la semilla y repita \(2\,000\) veces: sortee las perturbaciones, construya \(y\), estime el modelo con los tres regresores y guarde el \(F\) del pie de la tabla junto con su numerador \(\mathrm{SEC}/(k-1)\) y su denominador \(\mathrm{SRC}/(n-k)\). Gretl no da la \(\mathrm{SEC}\) directamente, pero \(\mathrm{STC}=\mathrm{SRC}/(1-R^2)\).
Tras abrir hprice2, tres escalares fijan la constante b1, la desviación típica del ruido sig y el número de réplicas R. En cada vuelta del bucle se sortea u, se construye y sin ningún regresor, se estima el modelo con los tres y se guardan cinco escalares: el \(F\) del pie de la tabla, la \(\mathrm{SRC}\), la \(\mathrm{SEC}\) recuperada de $ess y $rsq, y el numerador y el denominador del \(F\), cada uno dividido por sus grados de libertad, \(3\) y \(502\). store añade una fila por réplica al fichero replicasF.gdt. Al salir del bucle, open carga ese fichero: ahora cada observación es una réplica, y Fst, numer y denom son series de \(2\,000\) valores. El bloque BajoH0Resultados vuelve a definir sig y Fc506, porque el open de las réplicas ha borrado los escalares, y seis printf imprimen la cabecera con \(\sigma^2\), la media del numerador, la media del denominador, la media y la mediana del \(F\), la fracción de réplicas que superan el valor crítico y el cuantil empírico del \(95\%\) junto a \(F_c\). freq dibuja el histograma del \(F\).
en línea de comandos:
open hprice2.gdt --quiet
scalar b1  = 20000
scalar sig = 5000
scalar R   = 2000
set seed 20261119
loop R --progressive --quiet
    series u = normal(0, sig)
    series y = b1 + u                       # H0 cierta: rooms, nox y stratio no intervienen
    ols y const rooms nox stratio --quiet
    scalar Fst   = $Fstat
    scalar SRC   = $ess
    scalar SEC   = $ess*$rsq/(1-$rsq)      # SEC = STC - SRC, con STC = SRC/(1-R^2)
    scalar numer = SEC/3
    scalar denom = SRC/502
    store "@workdir/replicasF.gdt" Fst numer denom
endloop
open "@workdir/replicasF.gdt" --quiet
scalar sig = 5000
scalar Fc506 = critical(F, 3, 502, 0.05)
printf "H0 cierta, n = 506, k = 4, %d replicas, sigma^2 = %.3e\n", $nobs, sig^2
printf "media de SEC/(k-1) = %.4e\n", mean(numer)
printf "media de SRC/(n-k) = %.4e\n", mean(denom)
printf "media de F         = %.3f    mediana = %.3f\n", mean(Fst), median(Fst)
printf "fraccion de F > F_c(3,502) = %.4f\n", mean(Fst > critical(F, 3, 502, 0.05))
printf "cuantil empirico 95%% de F  = %.3f   (F_c = %.3f)\n", quantile(Fst, 0.95), Fc506
H0 cierta, n = 506, k = 4, 2000 replicas, sigma^2 = 2,500e+07
media de SEC/(k-1) = 2,5391e+07
media de SRC/(n-k) = 2,4954e+07
media de F         = 1,022    mediana = 0,814
fraccion de F > F_c(3,502) = 0,0555
cuantil empirico 95% de F  = 2,697   (F_c = 2,623)
freq Fst
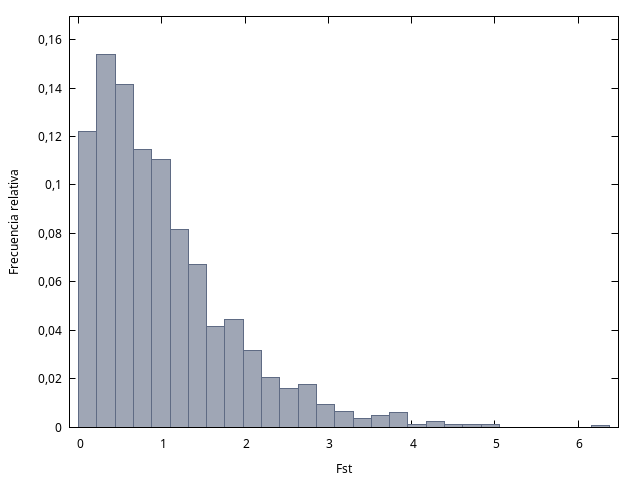
Figura 1: Los \(2\,000\) valores del \(F\) bajo \(H_0\) cierta con \(n=506\). La masa está entre \(0\) y \(2\); la cola derecha llega más allá de \(5\). El valor crítico \(F_c(3,502)=2{,}62\) deja a su derecha el \(5{,}5\%\) de las réplicas.
Lo que debe observar
Las dos medias, la del numerador y la del denominador, están junto a \(\sigma^2=2{,}5\cdot10^7\): bajo \(H_0\) cierta las dos son estimaciones del mismo ruido, y esa es la razón de que el \(F\) se mueva alrededor de \(1\) (apéndice, Resultado 2 (html); que su forma exacta sea la \(F_{q,n-k}\) es el Resultado 3, y el histograma es esa distribución vista columna a columna de la matriz de copias de la lección 11, una columna por réplica). La media del \(F\) es \(1{,}02\); la mediana, \(0{,}81\): la distribución es asimétrica, con muchos valores pequeños y una cola larga a la derecha, y el histograma lo muestra. El \(5{,}5\%\) de las réplicas supera \(F_c\), frente al \(5\%\) nominal; con \(2\,000\) réplicas la frecuencia observada tiene su propia oscilación, igual que en la práctica C de la sesión 18 (actividad 1 (html)).
Actividad 2 - Lo mismo con \(n=20\)
Tome veinte viviendas al azar y repita. El valor crítico ya no es \(F_c(3,502)\) sino \(F_c(3,16)\), y esa diferencia importa.
Igual que en la Actividad 1, con dos cambios. smpl 20 --random reduce la muestra a veinte viviendas elegidas al azar; la semilla se fija antes, para que sean las mismas para todos, y se vuelve a fijar antes del bucle. Y el valor crítico se calcula con \(16\) grados de libertad en el denominador. Los escalares R, sig y b1 se definen de nuevo después de open, que los había borrado (véase la lista de comandos nuevos). Tras abrir las réplicas, N20Resultados recalcula Fc20 (el open lo ha borrado) e imprime la media, la mediana y el cuantil del \(95\%\) del \(F\) junto a \(F_c(3,16)\), y la fracción de rechazos con el valor crítico correcto y con el de \(n=506\).
en línea de comandos:
open hprice2.gdt --quiet
scalar b1  = 20000
scalar sig = 5000
scalar R   = 2000
set seed 20261119
smpl 20 --random
set seed 20261119
loop R --progressive --quiet
    series u = normal(0, sig)
    series y = b1 + u
    ols y const rooms nox stratio --quiet
    scalar F20 = $Fstat
    store "@workdir/replicasF20.gdt" F20
endloop
open "@workdir/replicasF20.gdt" --quiet
scalar Fc20 = critical(F, 3, 16, 0.05)
printf "H0 cierta, n = 20 (n-k = 16), %d replicas\n", $nobs
printf "media de F = %.3f    mediana = %.3f    cuantil 95%% = %.3f   (F_c(3,16) = %.3f)\n", mean(F20), median(F20), quantile(F20, 0.95), Fc20
printf "fraccion de F > F_c(3,16)  = %.4f\n", mean(F20 > Fc20)
printf "fraccion de F > F_c(3,502) = %.4f\n", mean(F20 > critical(F, 3, 502, 0.05))
H0 cierta, n = 20 (n-k = 16), 2000 replicas
media de F = 1,132    mediana = 0,798    cuantil 95% = 3,275   (F_c(3,16) = 3,239)
fraccion de F > F_c(3,16)  = 0,0505
fraccion de F > F_c(3,502) = 0,0875
freq F20
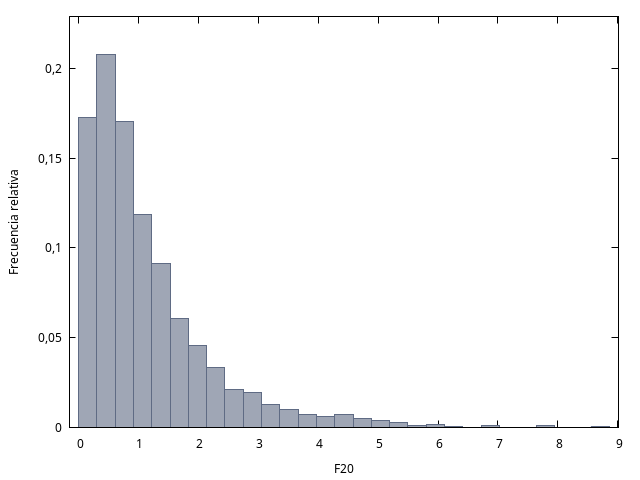
Figura 2: Los \(2\,000\) valores del \(F\) bajo \(H_0\) cierta con \(n=20\). La cola derecha es más pesada que con \(n=506\): llega casi hasta \(9\), y el valor crítico al \(5\%\) es \(3{,}24\) en lugar de \(2{,}62\) (el cuantil empírico del \(95\%\) está en \(3{,}28\)).
Lo que debe observar
Con dieciséis grados de libertad en el denominador, el \(F\) sigue oscilando en torno a \(1\) pero se dispersa más: el denominador, \(\mathrm{SRC}/16\), es una estimación de \(\sigma^2\) mucho peor que \(\mathrm{SRC}/502\), y cuando sale pequeño el cociente se dispara. Por eso \(F_c(3,16)=3{,}24\) es mayor que \(F_c(3,502)=2{,}62\). Con el valor crítico correcto se rechaza el \(5{,}05\%\) de las veces; con el de \(n=506\), el \(8{,}75\%\): un contraste que dice ``\(5\%\)'' y rechaza casi el \(9\%\) de las hipótesis ciertas. Es el mismo precio de estimar \(\sigma\) que la práctica C de la sesión 18 midió con la \(t\) (actividad 2 (html)).
Actividad 3 - Una hipótesis falsa por poco, con \(n=20\) y con \(n=506\)
Haga que nox intervenga con un coeficiente pequeño frente al ruido, \(\beta_{\text{nox}}=-800\) (nox recorre unas cinco unidades en la muestra, así que su efecto máximo es de unos \(4\,000\) dólares, menos que la desviación típica de \(u\)), y mantenga los otros dos en cero. \(H_0\) es ahora falsa. Cuente cuántas veces se rechaza con \(n=20\) y con \(n=506\).
Ahora y se construye con nox dentro, con el coeficiente bn, y el bucle ya no acumula réplicas: es un loop sin --progressive que solo cuenta. En cada vuelta, rech + ($Fstat > Fc)= suma uno si el \(F\) supera el valor crítico, y al terminar rech/R es la fracción de rechazos. Fc se calcula con los grados de libertad de la muestra activa, $nobs-4. Primero con la submuestra de veinte viviendas; después smpl full recupera las \(506\) y se repiten, en el mismo bloque, las líneas desde la de Fc.
en línea de comandos:
open hprice2.gdt --quiet
scalar b1  = 20000
scalar sig = 5000
scalar R   = 2000
scalar bn = -800                         # efecto pequeno de nox; rooms y stratio siguen sin intervenir
set seed 20261119
smpl 20 --random
scalar Fc = critical(F, 3, $nobs-4, 0.05)
set seed 20261119
scalar rech = 0
loop R --quiet
    series u = normal(0, sig)
    series y = b1 + bn*nox + u
    ols y const rooms nox stratio --quiet
    rech += ($Fstat > Fc)
endloop
printf "H0 falsa, n = %d: rechazos = %.3f\n", $nobs, rech/R
smpl full                                # y lo mismo con n = 506
scalar Fc = critical(F, 3, $nobs-4, 0.05)
set seed 20261119
scalar rech = 0
loop R --quiet
    series u = normal(0, sig)
    series y = b1 + bn*nox + u
    ols y const rooms nox stratio --quiet
    rech += ($Fstat > Fc)
endloop
printf "H0 falsa, n = %d: rechazos = %.3f\n", $nobs, rech/R
H0 falsa, n = 20: rechazos = 0,077
H0 falsa, n = 506: rechazos = 0,944
Lo que debe observar
Con veinte viviendas, la hipótesis falsa se rechaza el \(7{,}7\%\) de las veces: apenas por encima del \(5\%\) con que se rechaza una hipótesis cierta. El contraste casi no distingue. Con quinientas seis, el \(94{,}4\%\). El efecto es el mismo, \(-800\) por unidad de nox; lo que cambia es la longitud de la parte propia de nox, que con \(n=506\) es unas siete veces mayor, y con ella la subida de la \(\mathrm{SRC}\) que la restricción falsa provoca. El denominador, en cambio, sigue estimando \(\sigma^2\). Un \(F\) grande necesita un efecto, o muchos datos, o las dos cosas; con pocos datos, no rechazar dice poco.
Preguntas de interpretación para la clase
- En la Actividad 1, el numerador y el denominador tienen media \(\sigma^2\) y aun así la mediana del \(F\) es \(0{,}81\), no \(1\). ¿Cómo puede el cociente de dos cantidades de media \(\sigma^2\) estar por debajo de \(1\) más de la mitad de las veces?
- ¿Por qué bajo \(H_0\) cierta \(\mathrm{SEC}/(k-1)\) estima \(\sigma^2\)? Diga qué son los \(k-1\) del denominador en la geometría de la lección 13.
- Si en la Actividad 2 se usara \(F_c(3,502)\) con \(n=20\), el contraste rechazaría casi el \(9\%\) de las hipótesis ciertas. ¿Se equivocaría de más o de menos quien usara \(F_c(3,16)\) con \(n=506\)?
- En la Actividad 3 la \(\mathrm{SRC}\) del modelo restringido incluye lo que
noxaportaría al ajuste y no se le deja aportar. ¿Cuál de los dos términos del \(F\) crece con \(n\) y cuál no? - Un investigador con \(n=20\) obtiene \(F=1{,}9\) y concluye que ``los tres regresores son irrelevantes''. Con los resultados de la Actividad 3, ¿qué le respondería?
Para profundizar
- Lección 13 (lección 13), secciones ``El estadístico \(F\)'' y ``Lectura geométrica: la misma figura''.
- Práctica C de la sesión 18 (html), con la misma lógica aplicada al intervalo y al \(t\).
- Wooldridge, J. M. (2020). Introductory Econometrics, cap. 4, sección 4.5, y apéndice C.6 (contrastes y tamaño muestral).
- Manual de Gretl:
loopcon la opción--progressivey comandostore; funcionescritical,quantileyfreq.
Código completo de la práctica
| Enlace al guión: | S20-Prct-C-distribucion-F.inp |
Respuestas
- Mediana menor que uno. El cociente de dos variables no tiene por media el cociente de las medias, y la distribución del numerador es muy asimétrica: \(\mathrm{SEC}/3\) es una suma de tres cuadrados, con muchos valores pequeños y pocos grandes que tiran de la media hacia arriba. Más de la mitad de las veces el numerador queda por debajo de su media, y el \(F\) por debajo de \(1\); las réplicas en que sale grande compensan en la media pero no en la mediana.
- Por qué \(\mathrm{SEC}/(k-1)\) estima \(\sigma^2\). Bajo \(H_0\) cierta, cada realización de \(\boldsymbol y\) es una constante más la realización de las perturbaciones, y la parte de \(\boldsymbol{\mathop{\widehat y}}\) que se aparta de \(\boldsymbol{\mathop{\overline y}}\) es la proyección de esa realización sobre las \(k-1\) direcciones de los regresores no constantes. Por el reparto por igual de la lección 13, la suma de cuadrados de esa proyección, evaluada sobre la muestra aleatoria, tiene esperanza \(\sigma^2\) por dimensión; \(\mathrm{SEC}\) suma las \(k-1\) dimensiones del cateto explicado, y dividida por \(k-1\) estima \(\sigma^2\). Los \(k-1\) son las dimensiones del subespacio de los regresores una vez descontada la constante.
- El error contrario. De menos: \(F_c(3,16)=3{,}24\) es mayor que el \(2{,}62\) que corresponde a \(n=506\), así que rechazaría menos del \(5\%\) de las hipótesis ciertas. Un contraste más conservador de lo que anuncia. Rechaza de menos y, a cambio, deja pasar hipótesis falsas que el valor crítico correcto habría rechazado.
- Qué crece con \(n\). El numerador. Con \(H_0\) falsa, \(\mathrm{SRC}_r-\mathrm{SRC}\) contiene la longitud al cuadrado de \(\beta_{\text{nox}}\tilde{\boldsymbol x}_{\text{nox}}\), y la parte propia de
noxse alarga con el número de observaciones; el ruido añade lo de siempre, del orden de \(q\sigma^2\). El denominador estima \(\sigma^2\) y no crece. Por eso el mismo efecto, invisible con \(n=20\), se detecta con \(n=506\): no porque el efecto sea mayor, sino porque la parte propia denoxes más larga. - ``Irrelevantes'' con \(n=20\). Que \(F=1{,}9\) no rechaza, pero que con veinte observaciones un efecto del tamaño del de la Actividad 3 solo se rechaza el \(8\%\) de las veces: no rechazar es casi lo esperable, haya o no efecto. Lo que puede decir es que los datos no permiten afirmar que los regresores intervengan, que es distinto de afirmar que no lo hacen. Los intervalos de los tres coeficientes dirán cuán grande podría ser lo que no se ha detectado.